前面的文章已经分别讨论了模型 API、Structured Outputs、Function Calling、多轮对话、Token 和 RAG。这些能力组合起来后,应用可以理解请求、维护状态、检索知识并调用业务系统。
但有些任务需要根据中间结果动态决定下一步。例如:
查询项目当前版本,检查近期相关故障,
整理故障原因,并给出处理建议。
系统可能需要查询版本、搜索日志、读取发布记录、检索技术文档,再根据每一步结果决定是否继续调查。这已经不只是一次模型调用或一次 Tool Call,而是一个包含目标、状态、工具、循环和终止条件的执行系统。
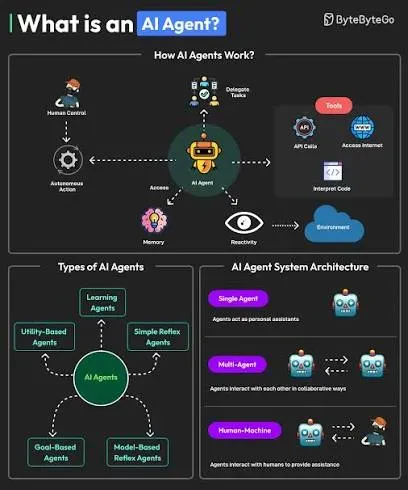
Agent 负责围绕目标组织多步骤执行;MCP(Model Context Protocol)负责用统一协议向 AI 应用暴露工具和上下文。二者解决不同问题,却经常共同构成工具型 AI 应用的核心。
Agent 的运行模型
Agent 不是一种新模型
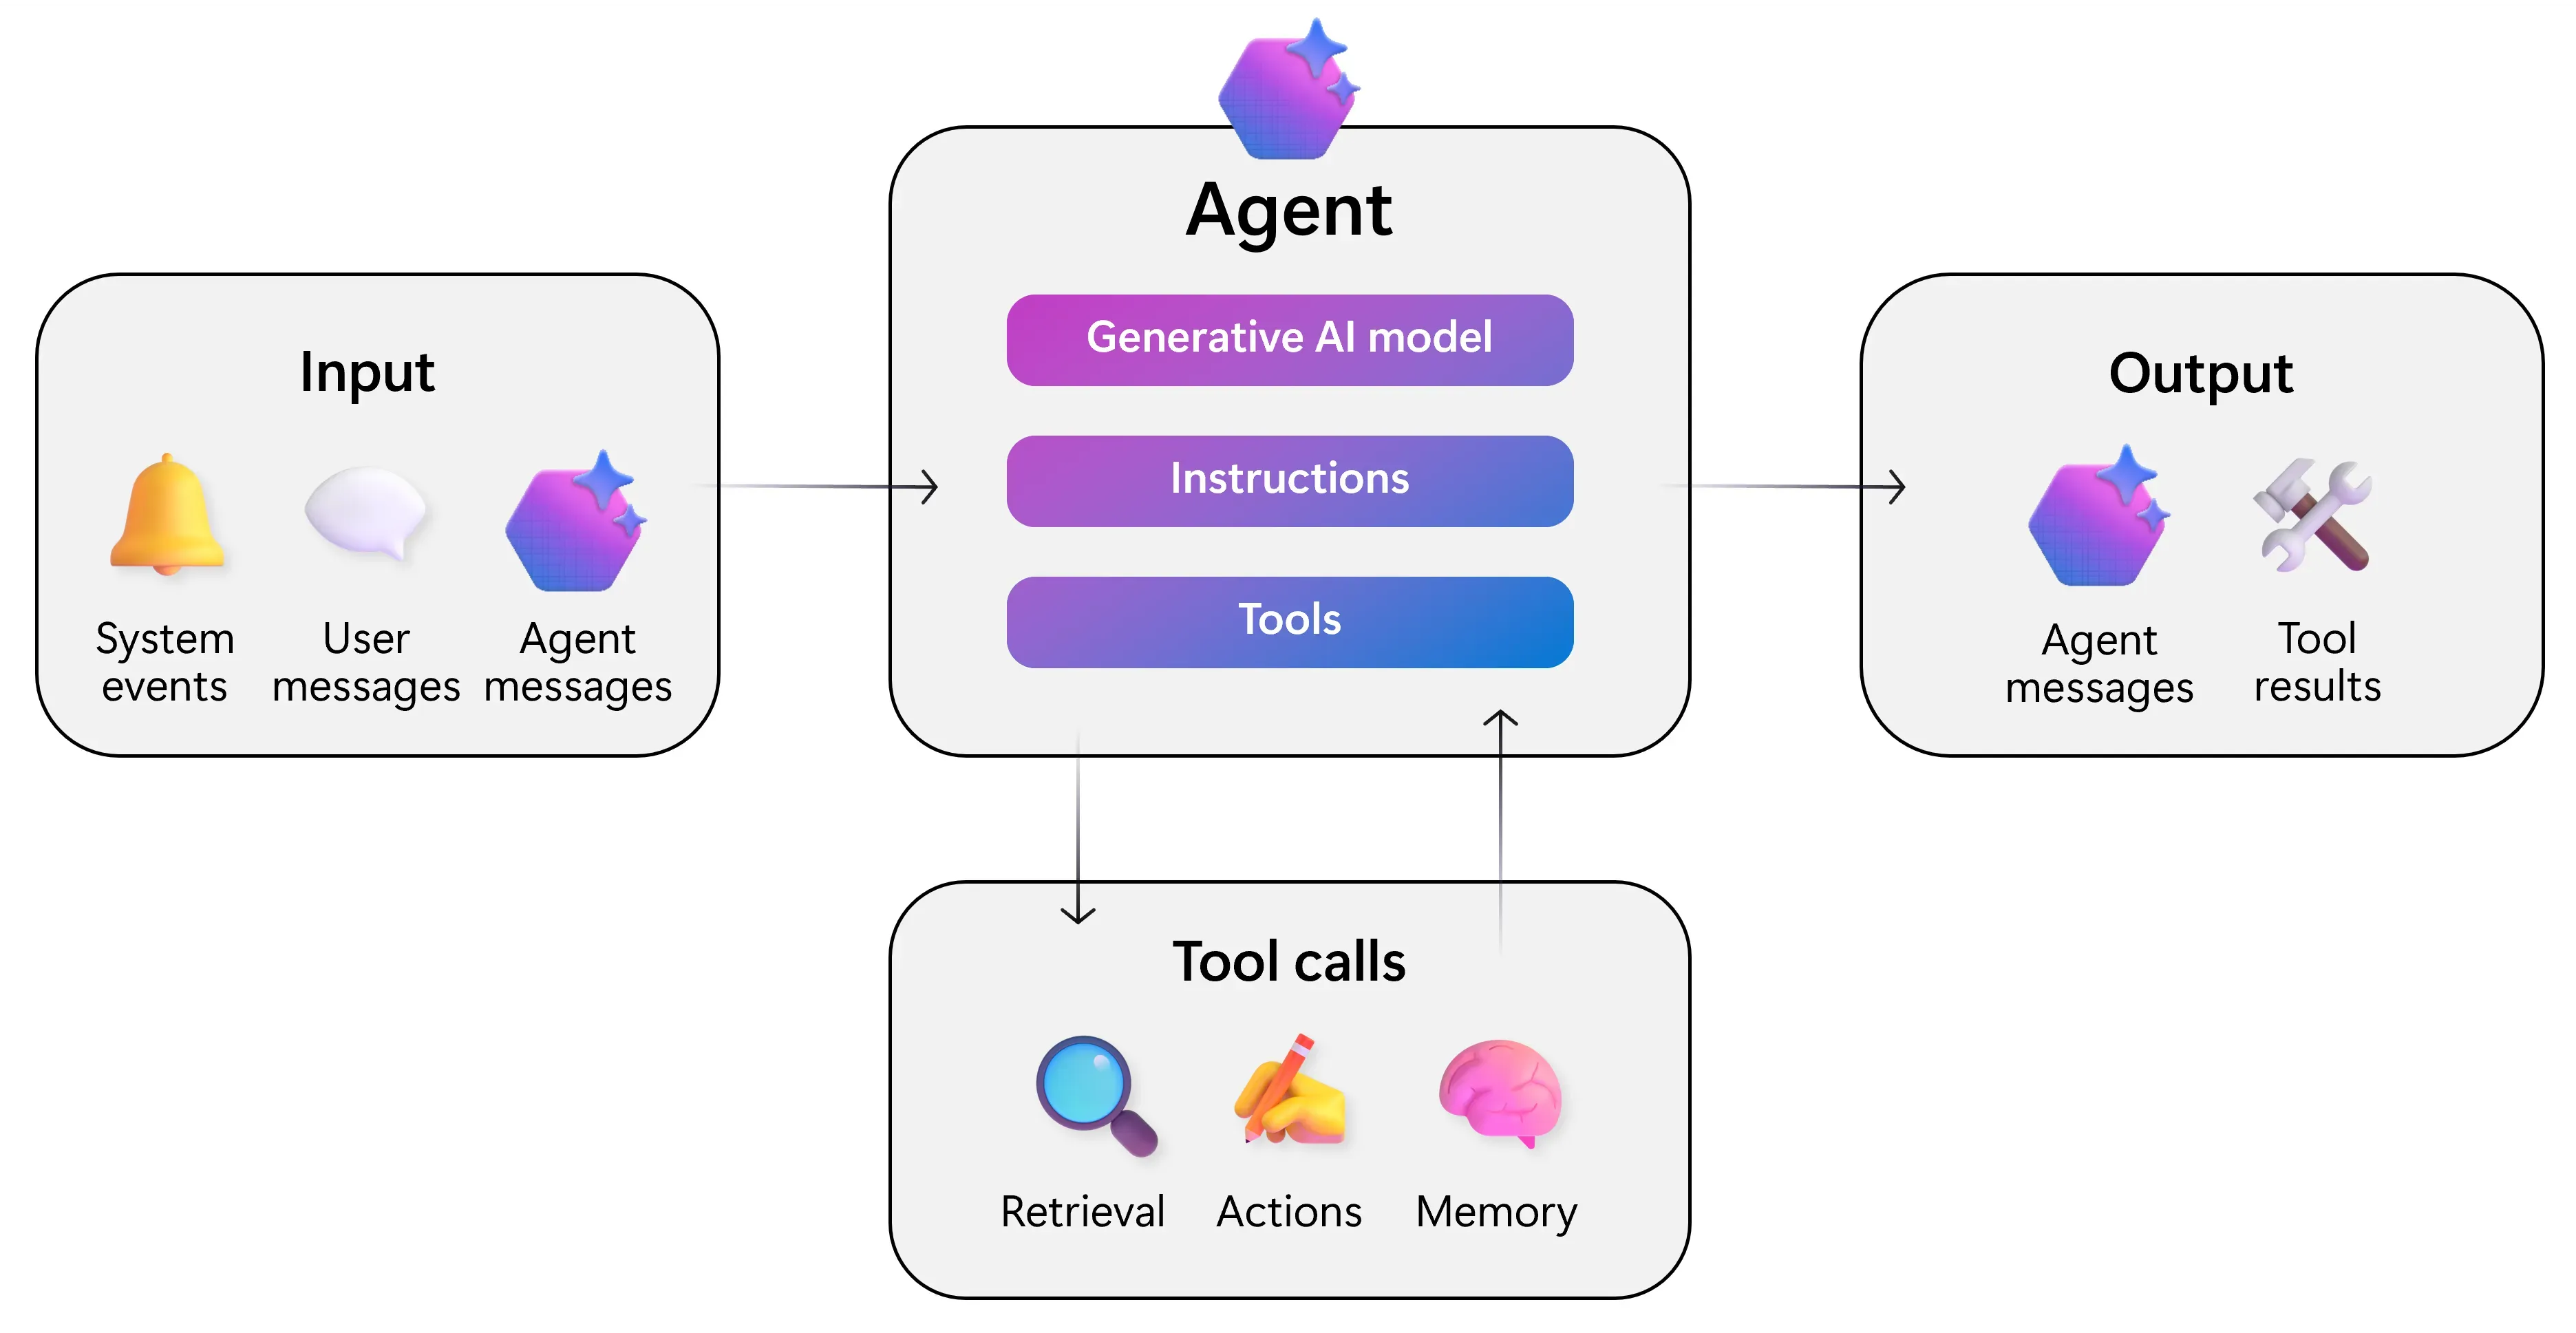
从工程角度看,Agent 是由模型驱动的运行系统。它持续读取目标和状态、选择工具、处理结果,并决定下一步动作,直到任务完成或触发终止条件。
可以把它概括为:
Goal + Model + Tools + State + Execution Loop普通模型调用主要完成输入到输出的映射;Agent 则在模型之外增加了工具执行、状态更新和流程控制。模型并没有突然获得不同类型的智能,改变的是应用的运行方式。
Agent Loop
Function Calling 已经提供了 Agent Loop 的基础。模型产生 Tool Call,应用执行工具,再把 Tool Output 返回模型;只要任务尚未结束,这个过程就可以继续。
%3btext-align:center%3b%7d%23mermaid-0 .edgeLabel p%7bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3b%7d%23mermaid-0 .edgeLabel rect%7bopacity:0.5%3bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bfill:rgba(232%2c232%2c232%2c 0.8)%3b%7d%23mermaid-0 .labelBkg%7bbackground-color:rgba(232%2c 232%2c 232%2c 0.5)%3b%7d%23mermaid-0 .cluster rect%7bfill:%23ffffde%3bstroke:%23aaaa33%3bstroke-width:1px%3b%7d%23mermaid-0 .cluster text%7bfill:%23333%3b%7d%23mermaid-0 .cluster span%7bcolor:%23333%3b%7d%23mermaid-0 .node .collapsed-indicator%7bfill:%23aaaa33%3bstroke:none%3bopacity:0.6%3b%7d%23mermaid-0 .node .collapsed-separator%7bstroke:%23aaaa33%3bstroke-width:0.75px%3b%7d%23mermaid-0 div.mermaidTooltip%7bposition:absolute%3btext-align:center%3bmax-width:200px%3bpadding:2px%3bfont-family:arial%2csans-serif%3bfont-size:12px%3bbackground:hsl(80%2c 100%25%2c 96.2745098039%25)%3bborder:1px solid %23aaaa33%3bborder-radius:2px%3bpointer-events:none%3bz-index:100%3b%7d%23mermaid-0 .flowchartTitleText%7btext-anchor:middle%3bfont-size:18px%3bfill:%23333%3b%7d%23mermaid-0 rect.text%7bfill:none%3bstroke-width:0%3b%7d%23mermaid-0 .icon-shape%2c%23mermaid-0 .image-shape%7bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3btext-align:center%3b%7d%23mermaid-0 .icon-shape p%2c%23mermaid-0 .image-shape p%7bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bpadding:2px%3b%7d%23mermaid-0 .icon-shape .label rect%2c%23mermaid-0 .image-shape .label rect%7bopacity:0.5%3bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bfill:rgba(232%2c232%2c232%2c 0.8)%3b%7d%23mermaid-0 .label-icon%7bdisplay:inline-block%3bheight:1em%3boverflow:visible%3bvertical-align:-0.125em%3b%7d%23mermaid-0 .node .label-icon path%7bfill:currentColor%3bstroke:revert%3bstroke-width:revert%3b%7d%23mermaid-0 .node .neo-node%7bstroke:%239370DB%3b%7d%23mermaid-0 %5bdata-look='neo'%5d.node rect%2c%23mermaid-0 %5bdata-look='neo'%5d.cluster rect%2c%23mermaid-0 %5bdata-look='neo'%5d.node polygon%7bstroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-0 %5bdata-look='neo'%5d.swimlane.cluster rect%7bfilter:none%3b%7d%23mermaid-0 %5bdata-look='neo'%5d.node path%7bstroke:%239370DB%3bstroke-width:1px%3b%7d%23mermaid-0 %5bdata-look='neo'%5d.node .outer-path%7bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-0 %5bdata-look='neo'%5d.node .neo-line path%7bstroke:%239370DB%3bfilter:none%3b%7d%23mermaid-0 %5bdata-look='neo'%5d.node circle%7bstroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-0 %5bdata-look='neo'%5d.node circle .state-start%7bfill:black%3b%7d%23mermaid-0 %5bdata-look='neo'%5d.icon-shape .icon%7bfill:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-0 %5bdata-look='neo'%5d.icon-shape .icon-neo path%7bstroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-0 :root%7b--mermaid-font-family:arial%2csans-serif%3b%7d%3c/style%3e%3cg%3e%3cmarker id='mermaid-0_flowchart-v2-pointEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'%3e%3cpath d='M 0 0 L 10 5 L 0 10 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-pointStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='4.5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'%3e%3cpath d='M 0 5 L 10 10 L 10 0 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-pointEnd-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='11.5' refY='7' markerUnits='userSpaceOnUse' markerWidth='10.5' markerHeight='14' orient='auto'%3e%3cpath d='M 0 0 L 11.5 7 L 0 14 z' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-pointStart-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='1' refY='7' markerUnits='userSpaceOnUse' markerWidth='11.5' markerHeight='14' orient='auto'%3e%3cpolygon points='0%2c7 11.5%2c14 11.5%2c0' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-circleEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='11' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-circleStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-1' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-circleEnd-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refY='5' refX='12.25' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-circleStart-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-2' refY='5' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-crossEnd' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='12' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3cpath d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-crossStart' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='-1' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3cpath d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-crossEnd-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='17.7' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'%3e%3cpath d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-crossStart-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='-3.5' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'%3e%3cpath d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cg class='root'%3e%3cg class='clusters'/%3e%3cg class='edgePaths'%3e%3cpath d='M240.023%2c62L240.023%2c66.167C240.023%2c70.333%2c240.023%2c78.667%2c240.023%2c86.333C240.023%2c94%2c240.023%2c101%2c240.023%2c104.5L240.023%2c108' id='mermaid-0-L_A_B_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_A_B_0' data-points='W3sieCI6MjQwLjAyMzQzNzUsInkiOjYyfSx7IngiOjI0MC4wMjM0Mzc1LCJ5Ijo4N30seyJ4IjoyNDAuMDIzNDM3NSwieSI6MTEyfV0=' data-look='classic' marker-end='url(%23mermaid-0_flowchart-v2-pointEnd)'/%3e%3cpath d='M211.867%2c166L207.522%2c170.167C203.177%2c174.333%2c194.487%2c182.667%2c190.142%2c190.333C185.797%2c198%2c185.797%2c205%2c185.797%2c208.5L185.797%2c212' id='mermaid-0-L_B_C_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_B_C_0' data-points='W3sieCI6MjExLjg2NzMzNzc0MDM4NDYsInkiOjE2Nn0seyJ4IjoxODUuNzk2ODc1LCJ5IjoxOTF9LHsieCI6MTg1Ljc5Njg3NSwieSI6MjE2fV0=' data-look='classic' marker-end='url(%23mermaid-0_flowchart-v2-pointEnd)'/%3e%3cpath d='M152.026%2c329.135L141.988%2c340.93C131.95%2c352.726%2c111.873%2c376.316%2c101.835%2c393.611C91.797%2c410.906%2c91.797%2c421.906%2c91.797%2c427.406L91.797%2c432.906' id='mermaid-0-L_C_D_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_C_D_0' data-points='W3sieCI6MTUyLjAyNTgzOTQ2MzEyNTcyLCJ5IjozMjkuMTM1MjE0NDYzMTI1N30seyJ4Ijo5MS43OTY4NzUsInkiOjM5OS45MDYyNX0seyJ4Ijo5MS43OTY4NzUsInkiOjQzNi45MDYyNX1d' data-look='classic' marker-end='url(%23mermaid-0_flowchart-v2-pointEnd)'/%3e%3cpath d='M91.797%2c490.906L91.797%2c497.073C91.797%2c503.24%2c91.797%2c515.573%2c91.797%2c527.24C91.797%2c538.906%2c91.797%2c549.906%2c91.797%2c555.406L91.797%2c560.906' id='mermaid-0-L_D_E_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_D_E_0' data-points='W3sieCI6OTEuNzk2ODc1LCJ5Ijo0OTAuOTA2MjV9LHsieCI6OTEuNzk2ODc1LCJ5Ijo1MjcuOTA2MjV9LHsieCI6OTEuNzk2ODc1LCJ5Ijo1NjQuOTA2MjV9XQ==' data-look='classic' marker-end='url(%23mermaid-0_flowchart-v2-pointEnd)'/%3e%3cpath d='M91.797%2c618.906L91.797%2c623.073C91.797%2c627.24%2c91.797%2c635.573%2c91.797%2c643.24C91.797%2c650.906%2c91.797%2c657.906%2c91.797%2c661.406L91.797%2c664.906' id='mermaid-0-L_E_F_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_E_F_0' data-points='W3sieCI6OTEuNzk2ODc1LCJ5Ijo2MTguOTA2MjV9LHsieCI6OTEuNzk2ODc1LCJ5Ijo2NDMuOTA2MjV9LHsieCI6OTEuNzk2ODc1LCJ5Ijo2NjguOTA2MjV9XQ==' data-look='classic' marker-end='url(%23mermaid-0_flowchart-v2-pointEnd)'/%3e%3cpath d='M91.797%2c722.906L91.797%2c727.073C91.797%2c731.24%2c91.797%2c739.573%2c108.59%2c754.894C125.383%2c770.214%2c158.969%2c792.522%2c175.762%2c803.676L192.554%2c814.83' id='mermaid-0-L_F_G_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_F_G_0' data-points='W3sieCI6OTEuNzk2ODc1LCJ5Ijo3MjIuOTA2MjV9LHsieCI6OTEuNzk2ODc1LCJ5Ijo3NDcuOTA2MjV9LHsieCI6MTk1Ljg4NjQyNTkyMDQyNzU0LCJ5Ijo4MTcuMDQzMjYxNTc5NTcyNX1d' data-look='classic' marker-end='url(%23mermaid-0_flowchart-v2-pointEnd)'/%3e%3cpath d='M283.711%2c816.594L300.513%2c805.146C317.315%2c793.698%2c350.919%2c770.802%2c367.721%2c750.687C384.523%2c730.573%2c384.523%2c713.24%2c384.523%2c695.906C384.523%2c678.573%2c384.523%2c661.24%2c384.523%2c643.906C384.523%2c626.573%2c384.523%2c609.24%2c384.523%2c589.906C384.523%2c570.573%2c384.523%2c549.24%2c384.523%2c527.906C384.523%2c506.573%2c384.523%2c485.24%2c384.523%2c463.906C384.523%2c442.573%2c384.523%2c421.24%2c384.523%2c392.164C384.523%2c363.089%2c384.523%2c326.271%2c384.523%2c291.453C384.523%2c256.635%2c384.523%2c223.818%2c373.067%2c203.286C361.611%2c182.755%2c338.699%2c174.51%2c327.243%2c170.387L315.787%2c166.264' id='mermaid-0-L_G_B_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_G_B_0' data-points='W3sieCI6MjgzLjcxMDc4MDczNzUwNzIsInkiOjgxNi41OTM1OTMyMzc1MDcyfSx7IngiOjM4NC41MjM0Mzc1LCJ5Ijo3NDcuOTA2MjV9LHsieCI6Mzg0LjUyMzQzNzUsInkiOjY5NS45MDYyNX0seyJ4IjozODQuNTIzNDM3NSwieSI6NjQzLjkwNjI1fSx7IngiOjM4NC41MjM0Mzc1LCJ5Ijo1OTEuOTA2MjV9LHsieCI6Mzg0LjUyMzQzNzUsInkiOjUyNy45MDYyNX0seyJ4IjozODQuNTIzNDM3NSwieSI6NDYzLjkwNjI1fSx7IngiOjM4NC41MjM0Mzc1LCJ5IjozOTkuOTA2MjV9LHsieCI6Mzg0LjUyMzQzNzUsInkiOjI4OS40NTMxMjV9LHsieCI6Mzg0LjUyMzQzNzUsInkiOjE5MX0seyJ4IjozMTIuMDIzNDM3NSwieSI6MTY0LjkxMDAzNDYwMjA3NjF9XQ==' data-look='classic' marker-end='url(%23mermaid-0_flowchart-v2-pointEnd)'/%3e%3cpath d='M240.023%2c919.813L240.023%2c925.979C240.023%2c932.146%2c240.023%2c944.479%2c240.023%2c956.146C240.023%2c967.813%2c240.023%2c978.813%2c240.023%2c984.313L240.023%2c989.813' id='mermaid-0-L_G_H_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_G_H_0' data-points='W3sieCI6MjQwLjAyMzQzNzUsInkiOjkxOS44MTI1fSx7IngiOjI0MC4wMjM0Mzc1LCJ5Ijo5NTYuODEyNX0seyJ4IjoyNDAuMDIzNDM3NSwieSI6OTkzLjgxMjV9XQ==' data-look='classic' marker-end='url(%23mermaid-0_flowchart-v2-pointEnd)'/%3e%3cpath d='M219.568%2c329.135L229.606%2c340.93C239.644%2c352.726%2c259.721%2c376.316%2c269.759%2c393.611C279.797%2c410.906%2c279.797%2c421.906%2c279.797%2c427.406L279.797%2c432.906' id='mermaid-0-L_C_I_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_C_I_0' data-points='W3sieCI6MjE5LjU2NzkxMDUzNjg3NDI4LCJ5IjozMjkuMTM1MjE0NDYzMTI1N30seyJ4IjoyNzkuNzk2ODc1LCJ5IjozOTkuOTA2MjV9LHsieCI6Mjc5Ljc5Njg3NSwieSI6NDM2LjkwNjI1fV0=' data-look='classic' marker-end='url(%23mermaid-0_flowchart-v2-pointEnd)'/%3e%3c/g%3e%3cg class='edgeLabels'%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_A_B_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_B_C_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel' transform='translate(91.796875%2c 399.90625)'%3e%3cg class='label' data-id='L_C_D_0' transform='translate(-6%2c -12)'%3e%3cforeignObject width='12' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3cp%3e%e6%98%af%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_D_E_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_E_F_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_F_G_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel' transform='translate(384.5234375%2c 527.90625)'%3e%3cg class='label' data-id='L_G_B_0' transform='translate(-6%2c -12)'%3e%3cforeignObject width='12' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3cp%3e%e5%90%a6%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel' transform='translate(240.0234375%2c 956.8125)'%3e%3cg class='label' data-id='L_G_H_0' transform='translate(-6%2c -12)'%3e%3cforeignObject width='12' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3cp%3e%e6%98%af%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel' transform='translate(279.796875%2c 399.90625)'%3e%3cg class='label' data-id='L_C_I_0' transform='translate(-6%2c -12)'%3e%3cforeignObject width='12' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3cp%3e%e5%90%a6%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cg class='nodes'%3e%3cg class='node default' id='mermaid-0-flowchart-A-0' data-look='classic' transform='translate(240.0234375%2c 35)'%3e%3crect class='basic label-container' style='' x='-84' y='-27' width='168' height='54'/%3e%3cg class='label' style='' transform='translate(-54%2c -12)'%3e%3crect/%3e%3cforeignObject width='108' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3e%e6%8e%a5%e6%94%b6%e7%9b%ae%e6%a0%87%e5%92%8c%e5%bd%93%e5%89%8d%e7%8a%b6%e6%80%81%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-0-flowchart-B-1' data-look='classic' transform='translate(240.0234375%2c 139)'%3e%3crect class='basic label-container' style='' x='-72' y='-27' width='144' height='54'/%3e%3cg class='label' style='' transform='translate(-42%2c -12)'%3e%3crect/%3e%3cforeignObject width='84' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3e%e6%a8%a1%e5%9e%8b%e5%88%a4%e6%96%ad%e4%b8%8b%e4%b8%80%e6%ad%a5%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-0-flowchart-C-3' data-look='classic' transform='translate(185.796875%2c 289.453125)'%3e%3cpolygon points='73.453125%2c0 146.90625%2c-73.453125 73.453125%2c-146.90625 0%2c-73.453125' class='label-container' transform='translate(-72.953125%2c 73.453125)'/%3e%3cg class='label' style='' transform='translate(-46.453125%2c -12)'%3e%3crect/%3e%3cforeignObject width='92.90625' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3e%e9%9c%80%e8%a6%81%e8%b0%83%e7%94%a8%e5%b7%a5%e5%85%b7%e5%90%97%3f%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-0-flowchart-D-5' data-look='classic' transform='translate(91.796875%2c 463.90625)'%3e%3crect class='basic label-container' style='' x='-72' y='-27' width='144' height='54'/%3e%3cg class='label' style='' transform='translate(-42%2c -12)'%3e%3crect/%3e%3cforeignObject width='84' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3e%e6%a0%a1%e9%aa%8c%e5%8f%82%e6%95%b0%e4%b8%8e%e6%9d%83%e9%99%90%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-0-flowchart-E-7' data-look='classic' transform='translate(91.796875%2c 591.90625)'%3e%3crect class='basic label-container' style='' x='-54' y='-27' width='108' height='54'/%3e%3cg class='label' style='' transform='translate(-24%2c -12)'%3e%3crect/%3e%3cforeignObject width='48' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3e%e6%89%a7%e8%a1%8c%e5%b7%a5%e5%85%b7%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-0-flowchart-F-9' data-look='classic' transform='translate(91.796875%2c 695.90625)'%3e%3crect class='basic label-container' style='' x='-83.796875' y='-27' width='167.59375' height='54'/%3e%3cg class='label' style='' transform='translate(-53.796875%2c -12)'%3e%3crect/%3e%3cforeignObject width='107.59375' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3e%e4%bf%9d%e5%ad%98 Tool Result%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-0-flowchart-G-11' data-look='classic' transform='translate(240.0234375%2c 846.359375)'%3e%3cpolygon points='73.453125%2c0 146.90625%2c-73.453125 73.453125%2c-146.90625 0%2c-73.453125' class='label-container' transform='translate(-72.953125%2c 73.453125)'/%3e%3cg class='label' style='' transform='translate(-46.453125%2c -12)'%3e%3crect/%3e%3cforeignObject width='92.90625' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3e%e8%be%be%e5%88%b0%e7%bb%88%e6%ad%a2%e8%be%b9%e7%95%8c%e5%90%97%3f%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-0-flowchart-H-15' data-look='classic' transform='translate(240.0234375%2c 1020.8125)'%3e%3crect class='basic label-container' style='' x='-72' y='-27' width='144' height='54'/%3e%3cg class='label' style='' transform='translate(-42%2c -12)'%3e%3crect/%3e%3cforeignObject width='84' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3e%e7%bb%88%e6%ad%a2%e5%b9%b6%e8%bf%94%e5%9b%9e%e7%8a%b6%e6%80%81%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-0-flowchart-I-17' data-look='classic' transform='translate(279.796875%2c 463.90625)'%3e%3crect class='basic label-container' style='' x='-66' y='-27' width='132' height='54'/%3e%3cg class='label' style='' transform='translate(-36%2c -12)'%3e%3crect/%3e%3cforeignObject width='72' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3e%e7%94%9f%e6%88%90%e6%9c%80%e7%bb%88%e5%9b%9e%e7%ad%94%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cdefs%3e%3cfilter id='mermaid-0-drop-shadow' height='130%25' width='130%25'%3e%3cfeDropShadow dx='4' dy='4' stdDeviation='0' flood-opacity='0.06' flood-color='black'/%3e%3c/filter%3e%3c/defs%3e%3cdefs%3e%3cfilter id='mermaid-0-drop-shadow-small' height='150%25' width='150%25'%3e%3cfeDropShadow dx='2' dy='2' stdDeviation='0' flood-opacity='0.06' flood-color='black'/%3e%3c/filter%3e%3c/defs%3e%3c/svg%3e)
%3btext-align:center%3b%7d%23mermaid-dark-0%20.edgeLabel%20p%7bbackground-color:hsl(0%2c%200%25%2c%2034.4117647059%25)%3b%7d%23mermaid-dark-0%20.edgeLabel%20rect%7bopacity:0.5%3bbackground-color:hsl(0%2c%200%25%2c%2034.4117647059%25)%3bfill:hsl(0%2c%200%25%2c%2034.4117647059%25)%3b%7d%23mermaid-dark-0%20.labelBkg%7bbackground-color:rgba(87.75%2c%2087.75%2c%2087.75%2c%200.5)%3b%7d%23mermaid-dark-0%20.cluster%20rect%7bfill:hsl(180%2c%201.5873015873%25%2c%2028.3529411765%25)%3bstroke:rgba(255%2c%20255%2c%20255%2c%200.25)%3bstroke-width:1px%3b%7d%23mermaid-dark-0%20.cluster%20text%7bfill:%23F9FFFE%3b%7d%23mermaid-dark-0%20.cluster%20span%7bcolor:%23F9FFFE%3b%7d%23mermaid-dark-0%20.node%20.collapsed-indicator%7bfill:rgba(255%2c%20255%2c%20255%2c%200.25)%3bstroke:none%3bopacity:0.6%3b%7d%23mermaid-dark-0%20.node%20.collapsed-separator%7bstroke:rgba(255%2c%20255%2c%20255%2c%200.25)%3bstroke-width:0.75px%3b%7d%23mermaid-dark-0%20div.mermaidTooltip%7bposition:absolute%3btext-align:center%3bmax-width:200px%3bpadding:2px%3bfont-family:arial%2csans-serif%3bfont-size:12px%3bbackground:hsl(20%2c%201.5873015873%25%2c%2012.3529411765%25)%3bborder:1px%20solid%20rgba(255%2c%20255%2c%20255%2c%200.25)%3bborder-radius:2px%3bpointer-events:none%3bz-index:100%3b%7d%23mermaid-dark-0%20.flowchartTitleText%7btext-anchor:middle%3bfont-size:18px%3bfill:%23ccc%3b%7d%23mermaid-dark-0%20rect.text%7bfill:none%3bstroke-width:0%3b%7d%23mermaid-dark-0%20.icon-shape%2c%23mermaid-dark-0%20.image-shape%7bbackground-color:hsl(0%2c%200%25%2c%2034.4117647059%25)%3btext-align:center%3b%7d%23mermaid-dark-0%20.icon-shape%20p%2c%23mermaid-dark-0%20.image-shape%20p%7bbackground-color:hsl(0%2c%200%25%2c%2034.4117647059%25)%3bpadding:2px%3b%7d%23mermaid-dark-0%20.icon-shape%20.label%20rect%2c%23mermaid-dark-0%20.image-shape%20.label%20rect%7bopacity:0.5%3bbackground-color:hsl(0%2c%200%25%2c%2034.4117647059%25)%3bfill:hsl(0%2c%200%25%2c%2034.4117647059%25)%3b%7d%23mermaid-dark-0%20.label-icon%7bdisplay:inline-block%3bheight:1em%3boverflow:visible%3bvertical-align:-0.125em%3b%7d%23mermaid-dark-0%20.node%20.label-icon%20path%7bfill:currentColor%3bstroke:revert%3bstroke-width:revert%3b%7d%23mermaid-dark-0%20.node%20.neo-node%7bstroke:%23ccc%3b%7d%23mermaid-dark-0%20%5bdata-look='neo'%5d.node%20rect%2c%23mermaid-dark-0%20%5bdata-look='neo'%5d.cluster%20rect%2c%23mermaid-dark-0%20%5bdata-look='neo'%5d.node%20polygon%7bstroke:url(%23mermaid-dark-0-gradient)%3bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-0%20%5bdata-look='neo'%5d.swimlane.cluster%20rect%7bfilter:none%3b%7d%23mermaid-dark-0%20%5bdata-look='neo'%5d.node%20path%7bstroke:url(%23mermaid-dark-0-gradient)%3bstroke-width:1px%3b%7d%23mermaid-dark-0%20%5bdata-look='neo'%5d.node%20.outer-path%7bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-0%20%5bdata-look='neo'%5d.node%20.neo-line%20path%7bstroke:%23ccc%3bfilter:none%3b%7d%23mermaid-dark-0%20%5bdata-look='neo'%5d.node%20circle%7bstroke:url(%23mermaid-dark-0-gradient)%3bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-0%20%5bdata-look='neo'%5d.node%20circle%20.state-start%7bfill:black%3b%7d%23mermaid-dark-0%20%5bdata-look='neo'%5d.icon-shape%20.icon%7bfill:url(%23mermaid-dark-0-gradient)%3bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-0%20%5bdata-look='neo'%5d.icon-shape%20.icon-neo%20path%7bstroke:url(%23mermaid-dark-0-gradient)%3bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-0%20:root%7b--mermaid-font-family:arial%2csans-serif%3b%7d%3c/style%3e%3cg%3e%3cmarker%20id='mermaid-dark-0_flowchart-v2-pointEnd'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='5'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='8'%20markerHeight='8'%20orient='auto'%3e%3cpath%20d='M%200%200%20L%2010%205%20L%200%2010%20z'%20class='arrowMarkerPath'%20style='stroke-width:%201%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-0_flowchart-v2-pointStart'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='4.5'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='8'%20markerHeight='8'%20orient='auto'%3e%3cpath%20d='M%200%205%20L%2010%2010%20L%2010%200%20z'%20class='arrowMarkerPath'%20style='stroke-width:%201%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-0_flowchart-v2-pointEnd-margin'%20class='marker%20flowchart-v2'%20viewBox='0%200%2011.5%2014'%20refX='11.5'%20refY='7'%20markerUnits='userSpaceOnUse'%20markerWidth='10.5'%20markerHeight='14'%20orient='auto'%3e%3cpath%20d='M%200%200%20L%2011.5%207%20L%200%2014%20z'%20class='arrowMarkerPath'%20style='stroke-width:%200%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-0_flowchart-v2-pointStart-margin'%20class='marker%20flowchart-v2'%20viewBox='0%200%2011.5%2014'%20refX='1'%20refY='7'%20markerUnits='userSpaceOnUse'%20markerWidth='11.5'%20markerHeight='14'%20orient='auto'%3e%3cpolygon%20points='0%2c7%2011.5%2c14%2011.5%2c0'%20class='arrowMarkerPath'%20style='stroke-width:%200%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-0_flowchart-v2-circleEnd'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='11'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='11'%20markerHeight='11'%20orient='auto'%3e%3ccircle%20cx='5'%20cy='5'%20r='5'%20class='arrowMarkerPath'%20style='stroke-width:%201%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-0_flowchart-v2-circleStart'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='-1'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='11'%20markerHeight='11'%20orient='auto'%3e%3ccircle%20cx='5'%20cy='5'%20r='5'%20class='arrowMarkerPath'%20style='stroke-width:%201%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-0_flowchart-v2-circleEnd-margin'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refY='5'%20refX='12.25'%20markerUnits='userSpaceOnUse'%20markerWidth='14'%20markerHeight='14'%20orient='auto'%3e%3ccircle%20cx='5'%20cy='5'%20r='5'%20class='arrowMarkerPath'%20style='stroke-width:%200%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-0_flowchart-v2-circleStart-margin'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='-2'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='14'%20markerHeight='14'%20orient='auto'%3e%3ccircle%20cx='5'%20cy='5'%20r='5'%20class='arrowMarkerPath'%20style='stroke-width:%200%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-0_flowchart-v2-crossEnd'%20class='marker%20cross%20flowchart-v2'%20viewBox='0%200%2011%2011'%20refX='12'%20refY='5.2'%20markerUnits='userSpaceOnUse'%20markerWidth='11'%20markerHeight='11'%20orient='auto'%3e%3cpath%20d='M%201%2c1%20l%209%2c9%20M%2010%2c1%20l%20-9%2c9'%20class='arrowMarkerPath'%20style='stroke-width:%202%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-0_flowchart-v2-crossStart'%20class='marker%20cross%20flowchart-v2'%20viewBox='0%200%2011%2011'%20refX='-1'%20refY='5.2'%20markerUnits='userSpaceOnUse'%20markerWidth='11'%20markerHeight='11'%20orient='auto'%3e%3cpath%20d='M%201%2c1%20l%209%2c9%20M%2010%2c1%20l%20-9%2c9'%20class='arrowMarkerPath'%20style='stroke-width:%202%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-0_flowchart-v2-crossEnd-margin'%20class='marker%20cross%20flowchart-v2'%20viewBox='0%200%2015%2015'%20refX='17.7'%20refY='7.5'%20markerUnits='userSpaceOnUse'%20markerWidth='12'%20markerHeight='12'%20orient='auto'%3e%3cpath%20d='M%201%2c1%20L%2014%2c14%20M%201%2c14%20L%2014%2c1'%20class='arrowMarkerPath'%20style='stroke-width:%202.5%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-0_flowchart-v2-crossStart-margin'%20class='marker%20cross%20flowchart-v2'%20viewBox='0%200%2015%2015'%20refX='-3.5'%20refY='7.5'%20markerUnits='userSpaceOnUse'%20markerWidth='12'%20markerHeight='12'%20orient='auto'%3e%3cpath%20d='M%201%2c1%20L%2014%2c14%20M%201%2c14%20L%2014%2c1'%20class='arrowMarkerPath'%20style='stroke-width:%202.5%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cg%20class='root'%3e%3cg%20class='clusters'/%3e%3cg%20class='edgePaths'%3e%3cpath%20d='M240.023%2c62L240.023%2c66.167C240.023%2c70.333%2c240.023%2c78.667%2c240.023%2c86.333C240.023%2c94%2c240.023%2c101%2c240.023%2c104.5L240.023%2c108'%20id='mermaid-dark-0-L_A_B_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_A_B_0'%20data-points='W3sieCI6MjQwLjAyMzQzNzUsInkiOjYyfSx7IngiOjI0MC4wMjM0Mzc1LCJ5Ijo4N30seyJ4IjoyNDAuMDIzNDM3NSwieSI6MTEyfV0='%20data-look='classic'%20marker-end='url(%23mermaid-dark-0_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M211.867%2c166L207.522%2c170.167C203.177%2c174.333%2c194.487%2c182.667%2c190.142%2c190.333C185.797%2c198%2c185.797%2c205%2c185.797%2c208.5L185.797%2c212'%20id='mermaid-dark-0-L_B_C_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_B_C_0'%20data-points='W3sieCI6MjExLjg2NzMzNzc0MDM4NDYsInkiOjE2Nn0seyJ4IjoxODUuNzk2ODc1LCJ5IjoxOTF9LHsieCI6MTg1Ljc5Njg3NSwieSI6MjE2fV0='%20data-look='classic'%20marker-end='url(%23mermaid-dark-0_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M152.026%2c329.135L141.988%2c340.93C131.95%2c352.726%2c111.873%2c376.316%2c101.835%2c393.611C91.797%2c410.906%2c91.797%2c421.906%2c91.797%2c427.406L91.797%2c432.906'%20id='mermaid-dark-0-L_C_D_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_C_D_0'%20data-points='W3sieCI6MTUyLjAyNTgzOTQ2MzEyNTcyLCJ5IjozMjkuMTM1MjE0NDYzMTI1N30seyJ4Ijo5MS43OTY4NzUsInkiOjM5OS45MDYyNX0seyJ4Ijo5MS43OTY4NzUsInkiOjQzNi45MDYyNX1d'%20data-look='classic'%20marker-end='url(%23mermaid-dark-0_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M91.797%2c490.906L91.797%2c497.073C91.797%2c503.24%2c91.797%2c515.573%2c91.797%2c527.24C91.797%2c538.906%2c91.797%2c549.906%2c91.797%2c555.406L91.797%2c560.906'%20id='mermaid-dark-0-L_D_E_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_D_E_0'%20data-points='W3sieCI6OTEuNzk2ODc1LCJ5Ijo0OTAuOTA2MjV9LHsieCI6OTEuNzk2ODc1LCJ5Ijo1MjcuOTA2MjV9LHsieCI6OTEuNzk2ODc1LCJ5Ijo1NjQuOTA2MjV9XQ=='%20data-look='classic'%20marker-end='url(%23mermaid-dark-0_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M91.797%2c618.906L91.797%2c623.073C91.797%2c627.24%2c91.797%2c635.573%2c91.797%2c643.24C91.797%2c650.906%2c91.797%2c657.906%2c91.797%2c661.406L91.797%2c664.906'%20id='mermaid-dark-0-L_E_F_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_E_F_0'%20data-points='W3sieCI6OTEuNzk2ODc1LCJ5Ijo2MTguOTA2MjV9LHsieCI6OTEuNzk2ODc1LCJ5Ijo2NDMuOTA2MjV9LHsieCI6OTEuNzk2ODc1LCJ5Ijo2NjguOTA2MjV9XQ=='%20data-look='classic'%20marker-end='url(%23mermaid-dark-0_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M91.797%2c722.906L91.797%2c727.073C91.797%2c731.24%2c91.797%2c739.573%2c108.59%2c754.894C125.383%2c770.214%2c158.969%2c792.522%2c175.762%2c803.676L192.554%2c814.83'%20id='mermaid-dark-0-L_F_G_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_F_G_0'%20data-points='W3sieCI6OTEuNzk2ODc1LCJ5Ijo3MjIuOTA2MjV9LHsieCI6OTEuNzk2ODc1LCJ5Ijo3NDcuOTA2MjV9LHsieCI6MTk1Ljg4NjQyNTkyMDQyNzU0LCJ5Ijo4MTcuMDQzMjYxNTc5NTcyNX1d'%20data-look='classic'%20marker-end='url(%23mermaid-dark-0_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M283.711%2c816.594L300.513%2c805.146C317.315%2c793.698%2c350.919%2c770.802%2c367.721%2c750.687C384.523%2c730.573%2c384.523%2c713.24%2c384.523%2c695.906C384.523%2c678.573%2c384.523%2c661.24%2c384.523%2c643.906C384.523%2c626.573%2c384.523%2c609.24%2c384.523%2c589.906C384.523%2c570.573%2c384.523%2c549.24%2c384.523%2c527.906C384.523%2c506.573%2c384.523%2c485.24%2c384.523%2c463.906C384.523%2c442.573%2c384.523%2c421.24%2c384.523%2c392.164C384.523%2c363.089%2c384.523%2c326.271%2c384.523%2c291.453C384.523%2c256.635%2c384.523%2c223.818%2c373.067%2c203.286C361.611%2c182.755%2c338.699%2c174.51%2c327.243%2c170.387L315.787%2c166.264'%20id='mermaid-dark-0-L_G_B_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_G_B_0'%20data-points='W3sieCI6MjgzLjcxMDc4MDczNzUwNzIsInkiOjgxNi41OTM1OTMyMzc1MDcyfSx7IngiOjM4NC41MjM0Mzc1LCJ5Ijo3NDcuOTA2MjV9LHsieCI6Mzg0LjUyMzQzNzUsInkiOjY5NS45MDYyNX0seyJ4IjozODQuNTIzNDM3NSwieSI6NjQzLjkwNjI1fSx7IngiOjM4NC41MjM0Mzc1LCJ5Ijo1OTEuOTA2MjV9LHsieCI6Mzg0LjUyMzQzNzUsInkiOjUyNy45MDYyNX0seyJ4IjozODQuNTIzNDM3NSwieSI6NDYzLjkwNjI1fSx7IngiOjM4NC41MjM0Mzc1LCJ5IjozOTkuOTA2MjV9LHsieCI6Mzg0LjUyMzQzNzUsInkiOjI4OS40NTMxMjV9LHsieCI6Mzg0LjUyMzQzNzUsInkiOjE5MX0seyJ4IjozMTIuMDIzNDM3NSwieSI6MTY0LjkxMDAzNDYwMjA3NjF9XQ=='%20data-look='classic'%20marker-end='url(%23mermaid-dark-0_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M240.023%2c919.813L240.023%2c925.979C240.023%2c932.146%2c240.023%2c944.479%2c240.023%2c956.146C240.023%2c967.813%2c240.023%2c978.813%2c240.023%2c984.313L240.023%2c989.813'%20id='mermaid-dark-0-L_G_H_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_G_H_0'%20data-points='W3sieCI6MjQwLjAyMzQzNzUsInkiOjkxOS44MTI1fSx7IngiOjI0MC4wMjM0Mzc1LCJ5Ijo5NTYuODEyNX0seyJ4IjoyNDAuMDIzNDM3NSwieSI6OTkzLjgxMjV9XQ=='%20data-look='classic'%20marker-end='url(%23mermaid-dark-0_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M219.568%2c329.135L229.606%2c340.93C239.644%2c352.726%2c259.721%2c376.316%2c269.759%2c393.611C279.797%2c410.906%2c279.797%2c421.906%2c279.797%2c427.406L279.797%2c432.906'%20id='mermaid-dark-0-L_C_I_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_C_I_0'%20data-points='W3sieCI6MjE5LjU2NzkxMDUzNjg3NDI4LCJ5IjozMjkuMTM1MjE0NDYzMTI1N30seyJ4IjoyNzkuNzk2ODc1LCJ5IjozOTkuOTA2MjV9LHsieCI6Mjc5Ljc5Njg3NSwieSI6NDM2LjkwNjI1fV0='%20data-look='classic'%20marker-end='url(%23mermaid-dark-0_flowchart-v2-pointEnd)'/%3e%3c/g%3e%3cg%20class='edgeLabels'%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_A_B_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_B_C_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%20transform='translate(91.796875%2c%20399.90625)'%3e%3cg%20class='label'%20data-id='L_C_D_0'%20transform='translate(-6%2c%20-12)'%3e%3cforeignObject%20width='12'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3cp%3e%e6%98%af%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_D_E_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_E_F_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_F_G_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%20transform='translate(384.5234375%2c%20527.90625)'%3e%3cg%20class='label'%20data-id='L_G_B_0'%20transform='translate(-6%2c%20-12)'%3e%3cforeignObject%20width='12'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3cp%3e%e5%90%a6%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%20transform='translate(240.0234375%2c%20956.8125)'%3e%3cg%20class='label'%20data-id='L_G_H_0'%20transform='translate(-6%2c%20-12)'%3e%3cforeignObject%20width='12'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3cp%3e%e6%98%af%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%20transform='translate(279.796875%2c%20399.90625)'%3e%3cg%20class='label'%20data-id='L_C_I_0'%20transform='translate(-6%2c%20-12)'%3e%3cforeignObject%20width='12'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3cp%3e%e5%90%a6%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cg%20class='nodes'%3e%3cg%20class='node%20default'%20id='mermaid-dark-0-flowchart-A-0'%20data-look='classic'%20transform='translate(240.0234375%2c%2035)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-84'%20y='-27'%20width='168'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-54%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='108'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3e%e6%8e%a5%e6%94%b6%e7%9b%ae%e6%a0%87%e5%92%8c%e5%bd%93%e5%89%8d%e7%8a%b6%e6%80%81%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-0-flowchart-B-1'%20data-look='classic'%20transform='translate(240.0234375%2c%20139)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-72'%20y='-27'%20width='144'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-42%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='84'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3e%e6%a8%a1%e5%9e%8b%e5%88%a4%e6%96%ad%e4%b8%8b%e4%b8%80%e6%ad%a5%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-0-flowchart-C-3'%20data-look='classic'%20transform='translate(185.796875%2c%20289.453125)'%3e%3cpolygon%20points='73.453125%2c0%20146.90625%2c-73.453125%2073.453125%2c-146.90625%200%2c-73.453125'%20class='label-container'%20transform='translate(-72.953125%2c%2073.453125)'/%3e%3cg%20class='label'%20style=''%20transform='translate(-46.453125%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='92.90625'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3e%e9%9c%80%e8%a6%81%e8%b0%83%e7%94%a8%e5%b7%a5%e5%85%b7%e5%90%97%3f%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-0-flowchart-D-5'%20data-look='classic'%20transform='translate(91.796875%2c%20463.90625)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-72'%20y='-27'%20width='144'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-42%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='84'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3e%e6%a0%a1%e9%aa%8c%e5%8f%82%e6%95%b0%e4%b8%8e%e6%9d%83%e9%99%90%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-0-flowchart-E-7'%20data-look='classic'%20transform='translate(91.796875%2c%20591.90625)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-54'%20y='-27'%20width='108'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-24%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='48'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3e%e6%89%a7%e8%a1%8c%e5%b7%a5%e5%85%b7%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-0-flowchart-F-9'%20data-look='classic'%20transform='translate(91.796875%2c%20695.90625)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-83.796875'%20y='-27'%20width='167.59375'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-53.796875%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='107.59375'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3e%e4%bf%9d%e5%ad%98%20Tool%20Result%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-0-flowchart-G-11'%20data-look='classic'%20transform='translate(240.0234375%2c%20846.359375)'%3e%3cpolygon%20points='73.453125%2c0%20146.90625%2c-73.453125%2073.453125%2c-146.90625%200%2c-73.453125'%20class='label-container'%20transform='translate(-72.953125%2c%2073.453125)'/%3e%3cg%20class='label'%20style=''%20transform='translate(-46.453125%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='92.90625'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3e%e8%be%be%e5%88%b0%e7%bb%88%e6%ad%a2%e8%be%b9%e7%95%8c%e5%90%97%3f%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-0-flowchart-H-15'%20data-look='classic'%20transform='translate(240.0234375%2c%201020.8125)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-72'%20y='-27'%20width='144'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-42%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='84'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3e%e7%bb%88%e6%ad%a2%e5%b9%b6%e8%bf%94%e5%9b%9e%e7%8a%b6%e6%80%81%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-0-flowchart-I-17'%20data-look='classic'%20transform='translate(279.796875%2c%20463.90625)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-66'%20y='-27'%20width='132'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-36%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='72'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3e%e7%94%9f%e6%88%90%e6%9c%80%e7%bb%88%e5%9b%9e%e7%ad%94%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cdefs%3e%3cfilter%20id='mermaid-dark-0-drop-shadow'%20height='130%25'%20width='130%25'%3e%3cfeDropShadow%20dx='4'%20dy='4'%20stdDeviation='0'%20flood-opacity='0.06'%20flood-color='white'/%3e%3c/filter%3e%3c/defs%3e%3cdefs%3e%3cfilter%20id='mermaid-dark-0-drop-shadow-small'%20height='150%25'%20width='150%25'%3e%3cfeDropShadow%20dx='2'%20dy='2'%20stdDeviation='0'%20flood-opacity='0.06'%20flood-color='white'/%3e%3c/filter%3e%3c/defs%3e%3clinearGradient%20id='mermaid-dark-0-gradient'%20gradientUnits='objectBoundingBox'%20x1='0%25'%20y1='0%25'%20x2='100%25'%20y2='0%25'%3e%3cstop%20offset='0%25'%20stop-color='%23cccccc'%20stop-opacity='1'/%3e%3cstop%20offset='100%25'%20stop-color='hsl(180%2c%200%25%2c%2018.3529411765%25)'%20stop-opacity='1'/%3e%3c/linearGradient%3e%3c/svg%3e)
最小实现可以直接建立在 Responses API 上:
import json

from openai import OpenAI

client = OpenAI()


def run_agent(
    user_input: str,
    tools: list,
    functions: dict,
    max_turns: int = 10,
) -> str:
    response = client.responses.create(
        model='gpt-5.6',
        input=user_input,
        tools=tools,
    )

    for _ in range(max_turns):
        calls = [
            item
            for item in response.output
            if item.type == 'function_call'
        ]

        if not calls:
            return response.output_text

        outputs = []

        for call in calls:
            function = functions.get(call.name)
            if function is None:
                raise ValueError(f'Unknown tool: {call.name}')

            arguments = json.loads(call.arguments)
            result = function(**arguments)

            outputs.append(
                {
                    'type': 'function_call_output',
                    'call_id': call.call_id,
                    'output': json.dumps(
                        result,
                        ensure_ascii=False,
                    ),
                }
            )

        response = client.responses.create(
            model='gpt-5.6',
            previous_response_id=response.id,
            input=outputs,
            tools=tools,
        )

    raise RuntimeError('Agent exceeded maximum turns')
这段代码只展示核心循环。生产系统还要处理超时、并发、重试、幂等、审批、预算和 Trace。
State 与终止条件
假设任务是“订单发货后继续查询物流”,订单工具返回的状态必须进入 Agent State,模型下一轮才能判断是否调用物流工具。
State 可能包含:
- 用户目标与 Conversation;
- Tool Call 和 Tool Result;
- 中间结构化数据;
- 已完成步骤和待办步骤;
- Token、费用和时间预算。
Agent 不能依赖无限 while True。应用应设置最大推理轮次、最大工具调用数、超时、Token 或费用预算,以及明确的业务终止条件。模型负责提出下一步,Runtime 负责决定这一步是否允许继续。
工具与执行边界
工具数量和职责
把企业全部 API 同时暴露给一个 Agent,会增加 Tool Definition Token、选择难度和权限风险。更合理的方式是根据职责提供较小的工具集合:
| Agent | 典型工具 |
|---|---|
| Order Agent | get_order、query_logistics、cancel_order |
| DevOps Agent | query_service、search_logs、restart_service |
| Documentation Agent | search_document、read_document |
工具应优先表达高层业务能力,例如 cancel_order,而不是暴露 execute_any_sql、run_any_shell 之类的万能接口。参数 Schema、返回结构和错误语义也应稳定明确。
工具库很大时,可以通过 Tool Search 按需加载相关定义,避免一次把所有工具放入模型上下文。工具发现降低了静态注册成本,但不代表 Agent 应拥有无限能力。
Read Tool 与 Action Tool
工具可以按风险分为两类:
| 类型 | 示例 | 主要控制 |
|---|---|---|
| Read Tool | 查询订单、搜索文档、读取日志 | 数据范围、脱敏、访问审计 |
| Action Tool | 退款、重启服务、发送邮件、删除文件 | 鉴权、审批、幂等、事务、回滚 |
高风险操作适合采用 Human in the Loop。Agent 生成操作建议和参数,用户或审批系统确认后,再由应用执行。批准的应是具体动作,而不是给 Agent 一次永久的宽泛授权。
Agent 与 Workflow
Workflow 的步骤主要由程序员预先确定,Agent 则允许模型根据中间状态选择下一步。固定流程如“上传、解析、摘要、保存”通常直接编写 Workflow 更可靠;线上故障调查等下一步高度依赖现场信息的任务,才更能体现 Agent 的价值。
判断标准不是“能不能使用 Agent”,而是动态决策带来的收益是否超过额外的成本、延迟和不确定性。
MCP 的角色
MCP 解决标准化接入
没有 MCP 时,每个 AI 应用通常要为 GitHub、工单、数据库、文件系统和内部服务分别实现工具适配。MCP 让外部能力通过统一协议被发现和调用,从而降低 Tool Provider 与 AI Application 的耦合。
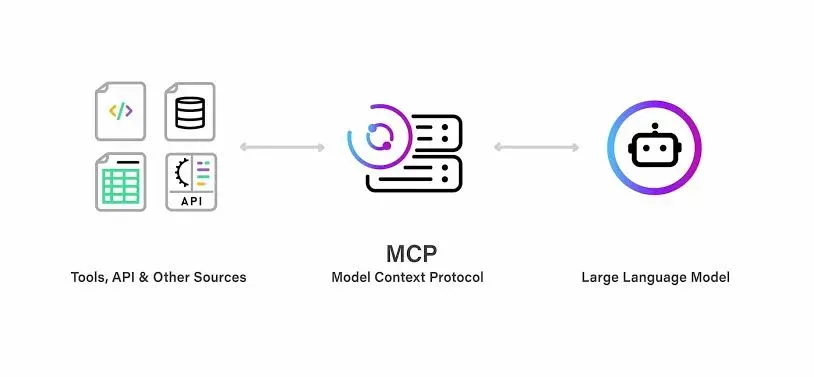
MCP 不替代 REST、gRPC、数据库协议或 API Gateway。MCP Server 内部通常仍然通过这些传统接口访问业务系统,它处于面向 AI 的集成层。
Host、Client 与 Server
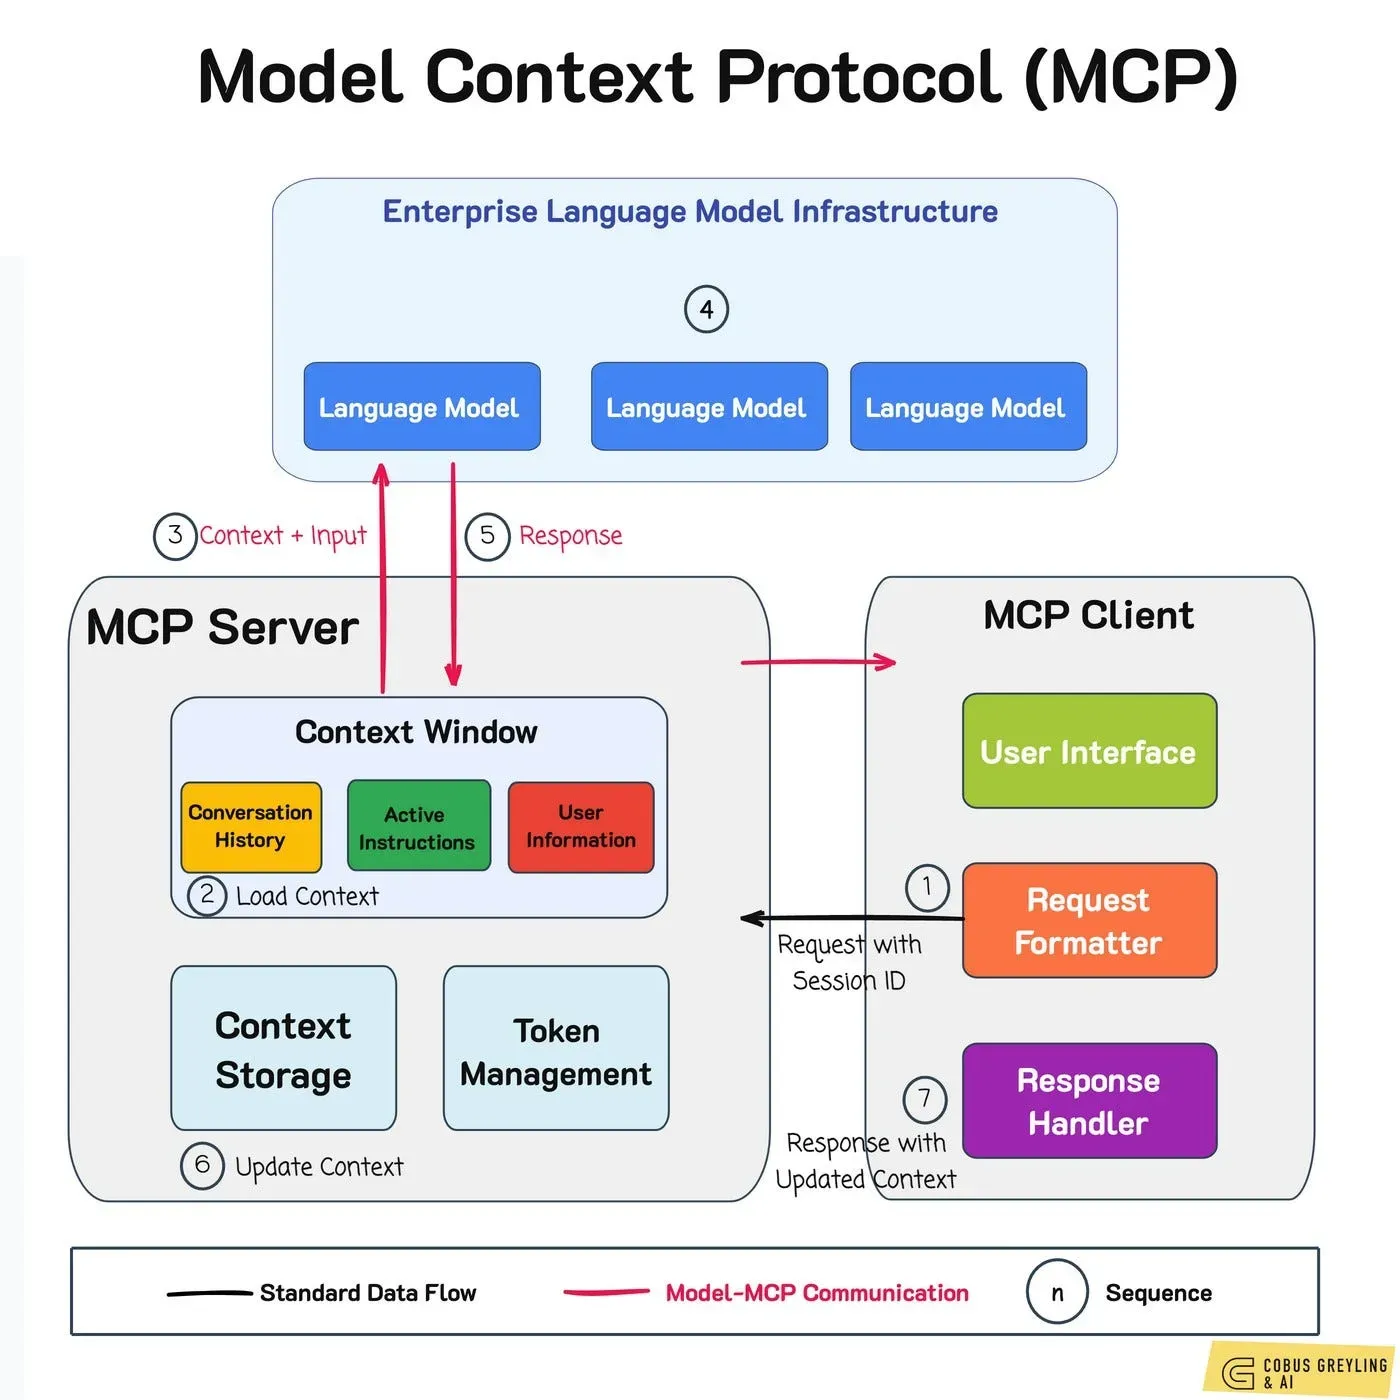
MCP 系统可以用三个角色理解:
| 角色 | 职责 |
|---|---|
| Host | 运行 AI 应用,例如 IDE、助手或 Agent Runtime |
| Client | Host 内负责与 MCP Server 通信的组件 |
| Server | 暴露工具、资源或其他上下文能力 |
MCP Server 可以封装 GitHub、数据库、文件系统或企业知识库。一个受控的 DevOps MCP Server 可以提供 query_service_status、search_logs 和 get_deployment,供多个 Agent 或 AI 客户端复用。
MCP 与相邻概念
| 概念 | 解决的问题 |
|---|---|
| Agent | 如何围绕目标组织多步骤执行 |
| Function Calling | 模型如何请求应用执行某个函数 |
| MCP | 工具提供方如何标准化暴露和执行能力 |
| RAG | 如何检索外部知识并加入上下文 |
| API Gateway | 路由、认证、限流和流量治理 |
Agent 可以只使用普通 Function Tools,也可以连接多个 MCP Server;MCP Tool 也可以被普通模型调用,而不一定存在复杂的 Agent Loop。MCP 还可以把内部 RAG 服务包装成 search_internal_docs 工具,但它并不替代 RAG 本身。
连接 MCP Server
Remote MCP
Responses API 可以通过 mcp Tool 连接远程 MCP Server:
response = client.responses.create(
    model='gpt-5.6',
    input='查询与故障 E10023 相关的内部资料。',
    tools=[
        {
            'type': 'mcp',
            'server_label': 'internal_docs',
            'server_description': (
                'Search approved internal technical documents.'
            ),
            'server_url': 'https://example.com/mcp',
            'allowed_tools': ['search_documents'],
            'require_approval': 'always',
        }
    ],
)
API 会先发现 Server 暴露的工具,产生 mcp_list_tools 输出项;模型决定调用时会产生 mcp_call。allowed_tools 可以限制导入范围,减少 Token、延迟和不必要的权限暴露。
公网可访问的 MCP Server 可以通过 Remote MCP 连接。私有网络或防火墙后的 Server 可以通过 Secure MCP Tunnel 接入,避免直接暴露到公网。
本地与环境内连接
开发工具经常需要访问本机代码仓库、Git、文件和构建命令。这些能力不适合部署为公网服务,因此 stdio 或运行环境内的 HTTP MCP 更合适。
不同 Runtime 支持的连接位置和传输方式并不完全相同。选择 Remote MCP、Secure MCP Tunnel、环境内 HTTP 或 stdio 时,需要同时考虑 Server 可达性、凭证位置、执行环境和信任边界。
Tool Discovery 也有成本
MCP Server 暴露的工具定义需要进入模型上下文。一个 Server 如果发布数百个工具,会增加 Token、延迟和选择难度。
应使用 allowed_tools、职责拆分和延迟加载控制工具范围,并在多轮流程中复用已经获得的工具列表。标准化协议解决的是接入问题,不会自动解决上下文预算和工具治理。
安全与审批
MCP 不是安全边界
MCP 只定义连接和能力暴露方式,不负责替业务系统完成 Authentication、Authorization、ACL、审计和事务控制。即使工具通过 MCP 提供,服务端仍必须验证当前身份是否能够执行该操作。
最小权限原则同样适用:只读任务使用只读数据库账号;仓库查询使用只读 Token;不同租户和项目使用明确的资源范围。优先使用服务提供方运营的官方 MCP Server,并审查第三方 Server 的实现和数据处理方式。
Prompt Injection 与不可信结果
MCP Tool 返回的 Issue、网页、日志或数据库字段都可能包含恶意内容,例如诱导模型忽略规则并调用高风险工具。这些内容属于不可信数据,而不是 Developer Instructions。
应用应保证:
- Tool Result 不能提升自身指令权限;
- 敏感动作由服务端重新鉴权和校验;
- 从 Tool Result 得到的 URL 不被盲目加载或展示;
- 外发到 MCP Server 的数据经过最小化和审计;
- Prompt Injection 不能绕过审批或资源权限。
连接不可信 MCP Server 可能导致上下文数据泄漏或未授权操作,因此 Server 信任本身就是安全决策。
Approval
Remote MCP 默认可以要求工具调用审批。审批请求应向用户展示 Server、Tool、参数、将要共享的数据和预期影响。
只读且范围明确的工具可以按策略自动允许;删除、支付、部署和权限修改等操作应逐次批准。审批不能替代服务端鉴权,也不应把敏感凭证暴露给模型。
Agent Runtime 的选择
Responses API、Agents SDK 与 Agents API
OpenAI 当前提供不同层级的 Agent 构建方式:
| 方案 | 控制边界 | 更适合 |
|---|---|---|
| Responses API | 应用自行管理循环、状态与本地工具 | 定制 Runtime、学习核心机制 |
| Agents SDK | SDK 管理 Runner、Tools、Handoff 与 Tracing | 在应用内构建可组合 Agent |
| Agents API | 托管 Agent Harness、Session 与运行基础设施 | 长任务和托管执行环境 |
选择哪一层取决于状态存储、部署、审批、沙箱和可观测性由谁负责。Agent Session、Responses Conversation 和 Sandbox 是不同资源,生命周期不能混为一谈。
Handoff 与 Multi-Agent
Handoff 可以把任务交给更专业的 Agent,例如客服 Agent 将退款问题转给 Billing Agent。但 Multi-Agent 会增加 Token、延迟、状态和调试复杂度。
一个 Agent 能清晰完成的任务,不应为了架构形式强行拆分。只有当专业工具集、权限边界或任务所有权确实不同,Handoff 才有明显价值。
Guardrail 的边界
Guardrail 可以检查输入、输出或部分运行条件,但不能代替数据库权限、参数校验和业务规则。可靠系统应同时具备模型层约束与传统软件控制,而不是把安全责任全部交给 Prompt 或分类模型。
可观测性与成本
Trace 执行过程
Agent 可能经历多次模型和工具调用。只记录最终回答无法解释失败原因,至少应追踪:
trace_id / conversation_id
每轮模型响应
Tool 名称、参数与结果摘要
审批与权限判断
执行时间和错误
输入、输出及缓存 Token
终止原因
最终结果
敏感参数和 Tool Result 应脱敏,不应为了排查问题把凭证或完整私密数据写入日志。
分层分析错误
| 错误层级 | 典型表现 |
|---|---|
| Planning | 选择错误工具或步骤 |
| Parameters | Tool Arguments 不正确 |
| Tool | 外部系统超时或执行失败 |
| Retrieval | RAG 找到错误资料 |
| State | 中间结果没有正确保存 |
| Permission | 凭证或资源范围不匹配 |
| Loop | 重复调用或无法终止 |
| Generation | 最终总结与事实不一致 |
Agent Evaluation 不应只看最终答案,还要评估工具选择、参数正确性、多余调用、高风险动作和执行轨迹。
控制 Token 与 Tool Result
每轮 Agent 都会增加历史 Context、工具定义、Tool Result 和模型输出。日志工具一次返回上万行内容,如果之后每轮都继续携带,Token 会迅速增长。
Runtime 应对结果进行字段筛选、截断、摘要或持久化后引用,并设置最大轮次、最大 Tool Call、Token、费用和时间预算。Streaming 改善的是用户感知延迟,不会消除这些成本。
生产架构原则
推荐的模块边界
一个可维护的 Agent 系统通常包含:
API Layer
Agent Runtime
Context Manager
Tool Registry
MCP Clients
Guardrails
Business Services
Approval Service
Observability
Agent 不应直接承载核心业务逻辑。工具调用最终仍应进入具备鉴权、校验、事务、幂等、限流和审计的业务服务。
自主程度按风险分级
| 等级 | 能力 | 适用范围 |
|---|---|---|
| Read Only | 搜索、读取、分析和总结 | 默认起点 |
| Proposal | 生成操作方案或草稿 | 需要人工执行 |
| Approved Action | 获批后执行具体动作 | 中高风险操作 |
| Autonomous Action | 自动执行 | 低风险、可回滚、可审计任务 |
Agent 的可靠性主要来自清晰工具、最小权限、可控状态、失败恢复和完整审计,而不是单纯依赖更强的模型。一个好的执行环境应该让模型即使判断失误,也难以造成不可恢复的后果。
总结
Agent 解决的是如何围绕目标持续判断、选择工具、更新状态并完成多步骤任务;MCP 解决的是外部能力如何以统一协议被 AI 应用发现和调用。
两者结合后,可以构建连接代码、文档、工单、监控和业务服务的工具型 AI 系统。但能力越多,越需要坚持最小权限、明确工具边界、执行预算、敏感操作审批、完整 Trace 和服务端鉴权。
Agent Engineering 的目标不是让模型获得尽可能多的权限,而是在严格的软件工程边界内,为模型提供完成任务所需的最小能力。
本文 API 行为参考: