2017 年的《Attention Is All You Need》提出了 Transformer:在机器翻译中,以注意力机制构建编码器与解码器。这篇论文给后来的语言模型和视觉模型提供了一套影响深远的架构。理解它的价值,可以从序列位置如何交换信息开始,再看多头注意力、位置编码与编码器–解码器如何组合成完整模型。
从循环计算走向并行的序列表示
在 RNN 中,位置 的状态依赖上一个位置:
此前的机器翻译模型常用循环结构表示序列,并用 Attention 让解码器动态选择源语言中的相关位置。Transformer 将 **Self-Attention(自注意力)**提升为序列表示的核心:同一序列内的任意位置可以直接交换信息,各位置的表示也更适合通过矩阵运算并行计算。
论文特别关注序列层的顺序计算步数和远距离位置之间的信息传递路径。自注意力让两个位置在单层中直接建立联系,这为学习跨越多个词的关系提供了简洁的计算路径。
先看完整的编码器与解码器
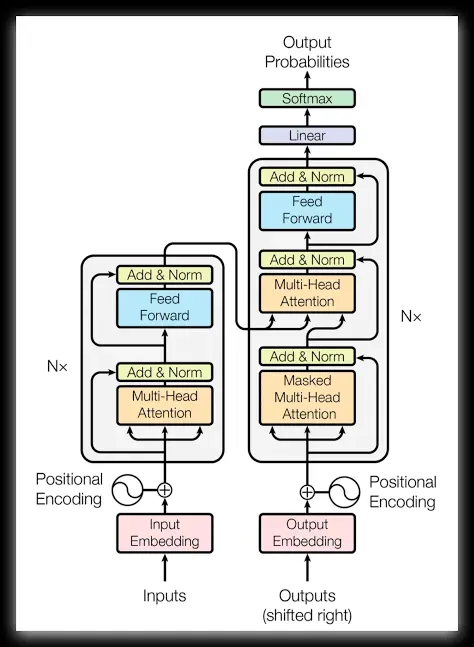
原始 Transformer 服务于序列到序列的机器翻译。编码器读取源语言,解码器根据编码结果和已知目标词预测下一个词。Base 配置中,两侧各堆叠 6 层,模型维度为 512,注意力头数为 8。
下面是依据论文 Figure 1 重绘的简化数据流;每个子层外还有残差连接与层归一化。
%3btext-align:center%3b%7d%23mermaid-0 .edgeLabel p%7bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3b%7d%23mermaid-0 .edgeLabel rect%7bopacity:0.5%3bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bfill:rgba(232%2c232%2c232%2c 0.8)%3b%7d%23mermaid-0 .labelBkg%7bbackground-color:rgba(232%2c 232%2c 232%2c 0.5)%3b%7d%23mermaid-0 .cluster rect%7bfill:%23ffffde%3bstroke:%23aaaa33%3bstroke-width:1px%3b%7d%23mermaid-0 .cluster text%7bfill:%23333%3b%7d%23mermaid-0 .cluster span%7bcolor:%23333%3b%7d%23mermaid-0 .node .collapsed-indicator%7bfill:%23aaaa33%3bstroke:none%3bopacity:0.6%3b%7d%23mermaid-0 .node .collapsed-separator%7bstroke:%23aaaa33%3bstroke-width:0.75px%3b%7d%23mermaid-0 div.mermaidTooltip%7bposition:absolute%3btext-align:center%3bmax-width:200px%3bpadding:2px%3bfont-family:arial%2csans-serif%3bfont-size:12px%3bbackground:hsl(80%2c 100%25%2c 96.2745098039%25)%3bborder:1px solid %23aaaa33%3bborder-radius:2px%3bpointer-events:none%3bz-index:100%3b%7d%23mermaid-0 .flowchartTitleText%7btext-anchor:middle%3bfont-size:18px%3bfill:%23333%3b%7d%23mermaid-0 rect.text%7bfill:none%3bstroke-width:0%3b%7d%23mermaid-0 .icon-shape%2c%23mermaid-0 .image-shape%7bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3btext-align:center%3b%7d%23mermaid-0 .icon-shape p%2c%23mermaid-0 .image-shape p%7bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bpadding:2px%3b%7d%23mermaid-0 .icon-shape .label rect%2c%23mermaid-0 .image-shape .label rect%7bopacity:0.5%3bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bfill:rgba(232%2c232%2c232%2c 0.8)%3b%7d%23mermaid-0 .label-icon%7bdisplay:inline-block%3bheight:1em%3boverflow:visible%3bvertical-align:-0.125em%3b%7d%23mermaid-0 .node .label-icon path%7bfill:currentColor%3bstroke:revert%3bstroke-width:revert%3b%7d%23mermaid-0 .node .neo-node%7bstroke:%239370DB%3b%7d%23mermaid-0 %5bdata-look='neo'%5d.node rect%2c%23mermaid-0 %5bdata-look='neo'%5d.cluster rect%2c%23mermaid-0 %5bdata-look='neo'%5d.node polygon%7bstroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-0 %5bdata-look='neo'%5d.swimlane.cluster rect%7bfilter:none%3b%7d%23mermaid-0 %5bdata-look='neo'%5d.node path%7bstroke:%239370DB%3bstroke-width:1px%3b%7d%23mermaid-0 %5bdata-look='neo'%5d.node .outer-path%7bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-0 %5bdata-look='neo'%5d.node .neo-line path%7bstroke:%239370DB%3bfilter:none%3b%7d%23mermaid-0 %5bdata-look='neo'%5d.node circle%7bstroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-0 %5bdata-look='neo'%5d.node circle .state-start%7bfill:black%3b%7d%23mermaid-0 %5bdata-look='neo'%5d.icon-shape .icon%7bfill:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-0 %5bdata-look='neo'%5d.icon-shape .icon-neo path%7bstroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-0 :root%7b--mermaid-font-family:arial%2csans-serif%3b%7d%3c/style%3e%3cg%3e%3cmarker id='mermaid-0_flowchart-v2-pointEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'%3e%3cpath d='M 0 0 L 10 5 L 0 10 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-pointStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='4.5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'%3e%3cpath d='M 0 5 L 10 10 L 10 0 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-pointEnd-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='11.5' refY='7' markerUnits='userSpaceOnUse' markerWidth='10.5' markerHeight='14' orient='auto'%3e%3cpath d='M 0 0 L 11.5 7 L 0 14 z' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-pointStart-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='1' refY='7' markerUnits='userSpaceOnUse' markerWidth='11.5' markerHeight='14' orient='auto'%3e%3cpolygon points='0%2c7 11.5%2c14 11.5%2c0' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-circleEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='11' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-circleStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-1' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-circleEnd-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refY='5' refX='12.25' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-circleStart-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-2' refY='5' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-crossEnd' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='12' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3cpath d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-crossStart' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='-1' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3cpath d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-crossEnd-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='17.7' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'%3e%3cpath d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-crossStart-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='-3.5' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'%3e%3cpath d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cg class='root'%3e%3cg class='clusters'/%3e%3cg class='edgePaths'%3e%3cpath d='M182.234%2c139L186.401%2c139C190.568%2c139%2c198.901%2c139%2c206.568%2c139C214.234%2c139%2c221.234%2c139%2c224.734%2c139L228.234%2c139' id='mermaid-0-L_S_E_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_S_E_0' data-points='W3sieCI6MTgyLjIzNDM3NSwieSI6MTM5fSx7IngiOjIwNy4yMzQzNzUsInkiOjEzOX0seyJ4IjoyMzIuMjM0Mzc1LCJ5IjoxMzl9XQ==' data-look='classic' marker-end='url(%23mermaid-0_flowchart-v2-pointEnd)'/%3e%3cpath d='M367.375%2c139L371.542%2c139C375.708%2c139%2c384.042%2c139%2c400.228%2c139C416.414%2c139%2c440.453%2c139%2c452.473%2c139L464.492%2c139' id='mermaid-0-L_E_M_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_E_M_0' data-points='W3sieCI6MzY3LjM3NSwieSI6MTM5fSx7IngiOjM5Mi4zNzUsInkiOjEzOX0seyJ4Ijo0NjguNDkyMTg3NSwieSI6MTM5fV0=' data-look='classic' marker-end='url(%23mermaid-0_flowchart-v2-pointEnd)'/%3e%3cpath d='M639.609%2c35L643.776%2c35C647.943%2c35%2c656.276%2c35%2c667.279%2c38.84C678.282%2c42.68%2c691.954%2c50.361%2c698.791%2c54.201L705.627%2c58.041' id='mermaid-0-L_T_D_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_T_D_0' data-points='W3sieCI6NjM5LjYwOTM3NSwieSI6MzV9LHsieCI6NjY0LjYwOTM3NSwieSI6MzV9LHsieCI6NzA5LjExNDMzMjkzMjY5MjMsInkiOjYwfV0=' data-look='classic' marker-end='url(%23mermaid-0_flowchart-v2-pointEnd)'/%3e%3cpath d='M588.492%2c139L601.178%2c139C613.865%2c139%2c639.237%2c139%2c658.759%2c135.16C678.282%2c131.32%2c691.954%2c123.639%2c698.791%2c119.799L705.627%2c115.959' id='mermaid-0-L_M_D_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_M_D_0' data-points='W3sieCI6NTg4LjQ5MjE4NzUsInkiOjEzOX0seyJ4Ijo2NjQuNjA5Mzc1LCJ5IjoxMzl9LHsieCI6NzA5LjExNDMzMjkzMjY5MjMsInkiOjExNH1d' data-look='classic' marker-end='url(%23mermaid-0_flowchart-v2-pointEnd)'/%3e%3cpath d='M824.75%2c87L828.917%2c87C833.083%2c87%2c841.417%2c87%2c849.083%2c87C856.75%2c87%2c863.75%2c87%2c867.25%2c87L870.75%2c87' id='mermaid-0-L_D_O_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_D_O_0' data-points='W3sieCI6ODI0Ljc1LCJ5Ijo4N30seyJ4Ijo4NDkuNzUsInkiOjg3fSx7IngiOjg3NC43NSwieSI6ODd9XQ==' data-look='classic' marker-end='url(%23mermaid-0_flowchart-v2-pointEnd)'/%3e%3cpath d='M1059.672%2c87L1063.839%2c87C1068.005%2c87%2c1076.339%2c87%2c1084.005%2c87C1091.672%2c87%2c1098.672%2c87%2c1102.172%2c87L1105.672%2c87' id='mermaid-0-L_O_Y_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_O_Y_0' data-points='W3sieCI6MTA1OS42NzE4NzUsInkiOjg3fSx7IngiOjEwODQuNjcxODc1LCJ5Ijo4N30seyJ4IjoxMTA5LjY3MTg3NSwieSI6ODd9XQ==' data-look='classic' marker-end='url(%23mermaid-0_flowchart-v2-pointEnd)'/%3e%3c/g%3e%3cg class='edgeLabels'%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_S_E_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_E_M_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_T_D_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_M_D_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_D_O_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_O_Y_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cg class='nodes'%3e%3cg class='node default' id='mermaid-0-flowchart-S-0' data-look='classic' transform='translate(95.1171875%2c 139)'%3e%3crect class='basic label-container' style='' x='-87.1171875' y='-27' width='174.234375' height='54'/%3e%3cg class='label' style='' transform='translate(-57.1171875%2c -12)'%3e%3crect/%3e%3cforeignObject width='114.234375' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3e%e6%ba%90%e8%af%8d%e5%b5%8c%e5%85%a5 %2b %e4%bd%8d%e7%bd%ae%e7%bc%96%e7%a0%81%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-0-flowchart-E-1' data-look='classic' transform='translate(299.8046875%2c 139)'%3e%3crect class='basic label-container' style='' x='-67.5703125' y='-27' width='135.140625' height='54'/%3e%3cg class='label' style='' transform='translate(-37.5703125%2c -12)'%3e%3crect/%3e%3cforeignObject width='75.140625' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3e%e7%bc%96%e7%a0%81%e5%99%a8%e5%b1%82 %c3%97 6%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-0-flowchart-M-3' data-look='classic' transform='translate(528.4921875%2c 139)'%3e%3crect class='basic label-container' style='' x='-60' y='-27' width='120' height='54'/%3e%3cg class='label' style='' transform='translate(-30%2c -12)'%3e%3crect/%3e%3cforeignObject width='60' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3e%e6%ba%90%e5%ba%8f%e5%88%97%e8%a1%a8%e7%a4%ba%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-0-flowchart-T-4' data-look='classic' transform='translate(528.4921875%2c 35)'%3e%3crect class='basic label-container' style='' x='-111.1171875' y='-27' width='222.234375' height='54'/%3e%3cg class='label' style='' transform='translate(-81.1171875%2c -12)'%3e%3crect/%3e%3cforeignObject width='162.234375' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3e%e5%8f%b3%e7%a7%bb%e7%9a%84%e7%9b%ae%e6%a0%87%e8%af%8d%e5%b5%8c%e5%85%a5 %2b %e4%bd%8d%e7%bd%ae%e7%bc%96%e7%a0%81%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-0-flowchart-D-5' data-look='classic' transform='translate(757.1796875%2c 87)'%3e%3crect class='basic label-container' style='' x='-67.5703125' y='-27' width='135.140625' height='54'/%3e%3cg class='label' style='' transform='translate(-37.5703125%2c -12)'%3e%3crect/%3e%3cforeignObject width='75.140625' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3e%e8%a7%a3%e7%a0%81%e5%99%a8%e5%b1%82 %c3%97 6%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-0-flowchart-O-9' data-look='classic' transform='translate(967.2109375%2c 87)'%3e%3crect class='basic label-container' style='' x='-92.4609375' y='-27' width='184.921875' height='54'/%3e%3cg class='label' style='' transform='translate(-62.4609375%2c -12)'%3e%3crect/%3e%3cforeignObject width='124.921875' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3e%e7%ba%bf%e6%80%a7%e6%98%a0%e5%b0%84 %2b Softmax%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-0-flowchart-Y-11' data-look='classic' transform='translate(1181.671875%2c 87)'%3e%3crect class='basic label-container' style='' x='-72' y='-27' width='144' height='54'/%3e%3cg class='label' style='' transform='translate(-42%2c -12)'%3e%3crect/%3e%3cforeignObject width='84' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3e%e4%b8%8b%e4%b8%80%e4%b8%aa%e8%af%8d%e7%9a%84%e6%a6%82%e7%8e%87%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cdefs%3e%3cfilter id='mermaid-0-drop-shadow' height='130%25' width='130%25'%3e%3cfeDropShadow dx='4' dy='4' stdDeviation='0' flood-opacity='0.06' flood-color='black'/%3e%3c/filter%3e%3c/defs%3e%3cdefs%3e%3cfilter id='mermaid-0-drop-shadow-small' height='150%25' width='150%25'%3e%3cfeDropShadow dx='2' dy='2' stdDeviation='0' flood-opacity='0.06' flood-color='black'/%3e%3c/filter%3e%3c/defs%3e%3c/svg%3e)
%3btext-align:center%3b%7d%23mermaid-dark-0%20.edgeLabel%20p%7bbackground-color:hsl(0%2c%200%25%2c%2034.4117647059%25)%3b%7d%23mermaid-dark-0%20.edgeLabel%20rect%7bopacity:0.5%3bbackground-color:hsl(0%2c%200%25%2c%2034.4117647059%25)%3bfill:hsl(0%2c%200%25%2c%2034.4117647059%25)%3b%7d%23mermaid-dark-0%20.labelBkg%7bbackground-color:rgba(87.75%2c%2087.75%2c%2087.75%2c%200.5)%3b%7d%23mermaid-dark-0%20.cluster%20rect%7bfill:hsl(180%2c%201.5873015873%25%2c%2028.3529411765%25)%3bstroke:rgba(255%2c%20255%2c%20255%2c%200.25)%3bstroke-width:1px%3b%7d%23mermaid-dark-0%20.cluster%20text%7bfill:%23F9FFFE%3b%7d%23mermaid-dark-0%20.cluster%20span%7bcolor:%23F9FFFE%3b%7d%23mermaid-dark-0%20.node%20.collapsed-indicator%7bfill:rgba(255%2c%20255%2c%20255%2c%200.25)%3bstroke:none%3bopacity:0.6%3b%7d%23mermaid-dark-0%20.node%20.collapsed-separator%7bstroke:rgba(255%2c%20255%2c%20255%2c%200.25)%3bstroke-width:0.75px%3b%7d%23mermaid-dark-0%20div.mermaidTooltip%7bposition:absolute%3btext-align:center%3bmax-width:200px%3bpadding:2px%3bfont-family:arial%2csans-serif%3bfont-size:12px%3bbackground:hsl(20%2c%201.5873015873%25%2c%2012.3529411765%25)%3bborder:1px%20solid%20rgba(255%2c%20255%2c%20255%2c%200.25)%3bborder-radius:2px%3bpointer-events:none%3bz-index:100%3b%7d%23mermaid-dark-0%20.flowchartTitleText%7btext-anchor:middle%3bfont-size:18px%3bfill:%23ccc%3b%7d%23mermaid-dark-0%20rect.text%7bfill:none%3bstroke-width:0%3b%7d%23mermaid-dark-0%20.icon-shape%2c%23mermaid-dark-0%20.image-shape%7bbackground-color:hsl(0%2c%200%25%2c%2034.4117647059%25)%3btext-align:center%3b%7d%23mermaid-dark-0%20.icon-shape%20p%2c%23mermaid-dark-0%20.image-shape%20p%7bbackground-color:hsl(0%2c%200%25%2c%2034.4117647059%25)%3bpadding:2px%3b%7d%23mermaid-dark-0%20.icon-shape%20.label%20rect%2c%23mermaid-dark-0%20.image-shape%20.label%20rect%7bopacity:0.5%3bbackground-color:hsl(0%2c%200%25%2c%2034.4117647059%25)%3bfill:hsl(0%2c%200%25%2c%2034.4117647059%25)%3b%7d%23mermaid-dark-0%20.label-icon%7bdisplay:inline-block%3bheight:1em%3boverflow:visible%3bvertical-align:-0.125em%3b%7d%23mermaid-dark-0%20.node%20.label-icon%20path%7bfill:currentColor%3bstroke:revert%3bstroke-width:revert%3b%7d%23mermaid-dark-0%20.node%20.neo-node%7bstroke:%23ccc%3b%7d%23mermaid-dark-0%20%5bdata-look='neo'%5d.node%20rect%2c%23mermaid-dark-0%20%5bdata-look='neo'%5d.cluster%20rect%2c%23mermaid-dark-0%20%5bdata-look='neo'%5d.node%20polygon%7bstroke:url(%23mermaid-dark-0-gradient)%3bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-0%20%5bdata-look='neo'%5d.swimlane.cluster%20rect%7bfilter:none%3b%7d%23mermaid-dark-0%20%5bdata-look='neo'%5d.node%20path%7bstroke:url(%23mermaid-dark-0-gradient)%3bstroke-width:1px%3b%7d%23mermaid-dark-0%20%5bdata-look='neo'%5d.node%20.outer-path%7bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-0%20%5bdata-look='neo'%5d.node%20.neo-line%20path%7bstroke:%23ccc%3bfilter:none%3b%7d%23mermaid-dark-0%20%5bdata-look='neo'%5d.node%20circle%7bstroke:url(%23mermaid-dark-0-gradient)%3bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-0%20%5bdata-look='neo'%5d.node%20circle%20.state-start%7bfill:black%3b%7d%23mermaid-dark-0%20%5bdata-look='neo'%5d.icon-shape%20.icon%7bfill:url(%23mermaid-dark-0-gradient)%3bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-0%20%5bdata-look='neo'%5d.icon-shape%20.icon-neo%20path%7bstroke:url(%23mermaid-dark-0-gradient)%3bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-0%20:root%7b--mermaid-font-family:arial%2csans-serif%3b%7d%3c/style%3e%3cg%3e%3cmarker%20id='mermaid-dark-0_flowchart-v2-pointEnd'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='5'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='8'%20markerHeight='8'%20orient='auto'%3e%3cpath%20d='M%200%200%20L%2010%205%20L%200%2010%20z'%20class='arrowMarkerPath'%20style='stroke-width:%201%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-0_flowchart-v2-pointStart'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='4.5'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='8'%20markerHeight='8'%20orient='auto'%3e%3cpath%20d='M%200%205%20L%2010%2010%20L%2010%200%20z'%20class='arrowMarkerPath'%20style='stroke-width:%201%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-0_flowchart-v2-pointEnd-margin'%20class='marker%20flowchart-v2'%20viewBox='0%200%2011.5%2014'%20refX='11.5'%20refY='7'%20markerUnits='userSpaceOnUse'%20markerWidth='10.5'%20markerHeight='14'%20orient='auto'%3e%3cpath%20d='M%200%200%20L%2011.5%207%20L%200%2014%20z'%20class='arrowMarkerPath'%20style='stroke-width:%200%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-0_flowchart-v2-pointStart-margin'%20class='marker%20flowchart-v2'%20viewBox='0%200%2011.5%2014'%20refX='1'%20refY='7'%20markerUnits='userSpaceOnUse'%20markerWidth='11.5'%20markerHeight='14'%20orient='auto'%3e%3cpolygon%20points='0%2c7%2011.5%2c14%2011.5%2c0'%20class='arrowMarkerPath'%20style='stroke-width:%200%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-0_flowchart-v2-circleEnd'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='11'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='11'%20markerHeight='11'%20orient='auto'%3e%3ccircle%20cx='5'%20cy='5'%20r='5'%20class='arrowMarkerPath'%20style='stroke-width:%201%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-0_flowchart-v2-circleStart'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='-1'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='11'%20markerHeight='11'%20orient='auto'%3e%3ccircle%20cx='5'%20cy='5'%20r='5'%20class='arrowMarkerPath'%20style='stroke-width:%201%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-0_flowchart-v2-circleEnd-margin'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refY='5'%20refX='12.25'%20markerUnits='userSpaceOnUse'%20markerWidth='14'%20markerHeight='14'%20orient='auto'%3e%3ccircle%20cx='5'%20cy='5'%20r='5'%20class='arrowMarkerPath'%20style='stroke-width:%200%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-0_flowchart-v2-circleStart-margin'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='-2'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='14'%20markerHeight='14'%20orient='auto'%3e%3ccircle%20cx='5'%20cy='5'%20r='5'%20class='arrowMarkerPath'%20style='stroke-width:%200%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-0_flowchart-v2-crossEnd'%20class='marker%20cross%20flowchart-v2'%20viewBox='0%200%2011%2011'%20refX='12'%20refY='5.2'%20markerUnits='userSpaceOnUse'%20markerWidth='11'%20markerHeight='11'%20orient='auto'%3e%3cpath%20d='M%201%2c1%20l%209%2c9%20M%2010%2c1%20l%20-9%2c9'%20class='arrowMarkerPath'%20style='stroke-width:%202%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-0_flowchart-v2-crossStart'%20class='marker%20cross%20flowchart-v2'%20viewBox='0%200%2011%2011'%20refX='-1'%20refY='5.2'%20markerUnits='userSpaceOnUse'%20markerWidth='11'%20markerHeight='11'%20orient='auto'%3e%3cpath%20d='M%201%2c1%20l%209%2c9%20M%2010%2c1%20l%20-9%2c9'%20class='arrowMarkerPath'%20style='stroke-width:%202%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-0_flowchart-v2-crossEnd-margin'%20class='marker%20cross%20flowchart-v2'%20viewBox='0%200%2015%2015'%20refX='17.7'%20refY='7.5'%20markerUnits='userSpaceOnUse'%20markerWidth='12'%20markerHeight='12'%20orient='auto'%3e%3cpath%20d='M%201%2c1%20L%2014%2c14%20M%201%2c14%20L%2014%2c1'%20class='arrowMarkerPath'%20style='stroke-width:%202.5%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-0_flowchart-v2-crossStart-margin'%20class='marker%20cross%20flowchart-v2'%20viewBox='0%200%2015%2015'%20refX='-3.5'%20refY='7.5'%20markerUnits='userSpaceOnUse'%20markerWidth='12'%20markerHeight='12'%20orient='auto'%3e%3cpath%20d='M%201%2c1%20L%2014%2c14%20M%201%2c14%20L%2014%2c1'%20class='arrowMarkerPath'%20style='stroke-width:%202.5%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cg%20class='root'%3e%3cg%20class='clusters'/%3e%3cg%20class='edgePaths'%3e%3cpath%20d='M182.234%2c139L186.401%2c139C190.568%2c139%2c198.901%2c139%2c206.568%2c139C214.234%2c139%2c221.234%2c139%2c224.734%2c139L228.234%2c139'%20id='mermaid-dark-0-L_S_E_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_S_E_0'%20data-points='W3sieCI6MTgyLjIzNDM3NSwieSI6MTM5fSx7IngiOjIwNy4yMzQzNzUsInkiOjEzOX0seyJ4IjoyMzIuMjM0Mzc1LCJ5IjoxMzl9XQ=='%20data-look='classic'%20marker-end='url(%23mermaid-dark-0_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M367.375%2c139L371.542%2c139C375.708%2c139%2c384.042%2c139%2c400.228%2c139C416.414%2c139%2c440.453%2c139%2c452.473%2c139L464.492%2c139'%20id='mermaid-dark-0-L_E_M_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_E_M_0'%20data-points='W3sieCI6MzY3LjM3NSwieSI6MTM5fSx7IngiOjM5Mi4zNzUsInkiOjEzOX0seyJ4Ijo0NjguNDkyMTg3NSwieSI6MTM5fV0='%20data-look='classic'%20marker-end='url(%23mermaid-dark-0_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M639.609%2c35L643.776%2c35C647.943%2c35%2c656.276%2c35%2c667.279%2c38.84C678.282%2c42.68%2c691.954%2c50.361%2c698.791%2c54.201L705.627%2c58.041'%20id='mermaid-dark-0-L_T_D_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_T_D_0'%20data-points='W3sieCI6NjM5LjYwOTM3NSwieSI6MzV9LHsieCI6NjY0LjYwOTM3NSwieSI6MzV9LHsieCI6NzA5LjExNDMzMjkzMjY5MjMsInkiOjYwfV0='%20data-look='classic'%20marker-end='url(%23mermaid-dark-0_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M588.492%2c139L601.178%2c139C613.865%2c139%2c639.237%2c139%2c658.759%2c135.16C678.282%2c131.32%2c691.954%2c123.639%2c698.791%2c119.799L705.627%2c115.959'%20id='mermaid-dark-0-L_M_D_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_M_D_0'%20data-points='W3sieCI6NTg4LjQ5MjE4NzUsInkiOjEzOX0seyJ4Ijo2NjQuNjA5Mzc1LCJ5IjoxMzl9LHsieCI6NzA5LjExNDMzMjkzMjY5MjMsInkiOjExNH1d'%20data-look='classic'%20marker-end='url(%23mermaid-dark-0_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M824.75%2c87L828.917%2c87C833.083%2c87%2c841.417%2c87%2c849.083%2c87C856.75%2c87%2c863.75%2c87%2c867.25%2c87L870.75%2c87'%20id='mermaid-dark-0-L_D_O_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_D_O_0'%20data-points='W3sieCI6ODI0Ljc1LCJ5Ijo4N30seyJ4Ijo4NDkuNzUsInkiOjg3fSx7IngiOjg3NC43NSwieSI6ODd9XQ=='%20data-look='classic'%20marker-end='url(%23mermaid-dark-0_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M1059.672%2c87L1063.839%2c87C1068.005%2c87%2c1076.339%2c87%2c1084.005%2c87C1091.672%2c87%2c1098.672%2c87%2c1102.172%2c87L1105.672%2c87'%20id='mermaid-dark-0-L_O_Y_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_O_Y_0'%20data-points='W3sieCI6MTA1OS42NzE4NzUsInkiOjg3fSx7IngiOjEwODQuNjcxODc1LCJ5Ijo4N30seyJ4IjoxMTA5LjY3MTg3NSwieSI6ODd9XQ=='%20data-look='classic'%20marker-end='url(%23mermaid-dark-0_flowchart-v2-pointEnd)'/%3e%3c/g%3e%3cg%20class='edgeLabels'%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_S_E_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_E_M_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_T_D_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_M_D_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_D_O_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_O_Y_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cg%20class='nodes'%3e%3cg%20class='node%20default'%20id='mermaid-dark-0-flowchart-S-0'%20data-look='classic'%20transform='translate(95.1171875%2c%20139)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-87.1171875'%20y='-27'%20width='174.234375'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-57.1171875%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='114.234375'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3e%e6%ba%90%e8%af%8d%e5%b5%8c%e5%85%a5%20%2b%20%e4%bd%8d%e7%bd%ae%e7%bc%96%e7%a0%81%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-0-flowchart-E-1'%20data-look='classic'%20transform='translate(299.8046875%2c%20139)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-67.5703125'%20y='-27'%20width='135.140625'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-37.5703125%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='75.140625'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3e%e7%bc%96%e7%a0%81%e5%99%a8%e5%b1%82%20%c3%97%206%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-0-flowchart-M-3'%20data-look='classic'%20transform='translate(528.4921875%2c%20139)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-60'%20y='-27'%20width='120'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-30%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='60'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3e%e6%ba%90%e5%ba%8f%e5%88%97%e8%a1%a8%e7%a4%ba%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-0-flowchart-T-4'%20data-look='classic'%20transform='translate(528.4921875%2c%2035)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-111.1171875'%20y='-27'%20width='222.234375'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-81.1171875%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='162.234375'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3e%e5%8f%b3%e7%a7%bb%e7%9a%84%e7%9b%ae%e6%a0%87%e8%af%8d%e5%b5%8c%e5%85%a5%20%2b%20%e4%bd%8d%e7%bd%ae%e7%bc%96%e7%a0%81%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-0-flowchart-D-5'%20data-look='classic'%20transform='translate(757.1796875%2c%2087)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-67.5703125'%20y='-27'%20width='135.140625'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-37.5703125%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='75.140625'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3e%e8%a7%a3%e7%a0%81%e5%99%a8%e5%b1%82%20%c3%97%206%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-0-flowchart-O-9'%20data-look='classic'%20transform='translate(967.2109375%2c%2087)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-92.4609375'%20y='-27'%20width='184.921875'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-62.4609375%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='124.921875'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3e%e7%ba%bf%e6%80%a7%e6%98%a0%e5%b0%84%20%2b%20Softmax%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-0-flowchart-Y-11'%20data-look='classic'%20transform='translate(1181.671875%2c%2087)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-72'%20y='-27'%20width='144'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-42%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='84'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3e%e4%b8%8b%e4%b8%80%e4%b8%aa%e8%af%8d%e7%9a%84%e6%a6%82%e7%8e%87%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cdefs%3e%3cfilter%20id='mermaid-dark-0-drop-shadow'%20height='130%25'%20width='130%25'%3e%3cfeDropShadow%20dx='4'%20dy='4'%20stdDeviation='0'%20flood-opacity='0.06'%20flood-color='white'/%3e%3c/filter%3e%3c/defs%3e%3cdefs%3e%3cfilter%20id='mermaid-dark-0-drop-shadow-small'%20height='150%25'%20width='150%25'%3e%3cfeDropShadow%20dx='2'%20dy='2'%20stdDeviation='0'%20flood-opacity='0.06'%20flood-color='white'/%3e%3c/filter%3e%3c/defs%3e%3clinearGradient%20id='mermaid-dark-0-gradient'%20gradientUnits='objectBoundingBox'%20x1='0%25'%20y1='0%25'%20x2='100%25'%20y2='0%25'%3e%3cstop%20offset='0%25'%20stop-color='%23cccccc'%20stop-opacity='1'/%3e%3cstop%20offset='100%25'%20stop-color='hsl(180%2c%200%25%2c%2018.3529411765%25)'%20stop-opacity='1'/%3e%3c/linearGradient%3e%3c/svg%3e)
每个编码器层依次执行多头自注意力和逐位置前馈网络(FFN)。每个解码器层先执行带因果掩码的自注意力,再用编码器输出做交叉注意力,最后执行 FFN。
| 模块 | Query 来自 | Key、Value 来自 | 作用 |
|---|---|---|---|
| 编码器自注意力 | 源序列当前表示 | 同一源序列 | 融合源语言上下文 |
| 解码器自注意力 | 目标序列当前表示 | 同一目标序列 | 利用已知目标词 |
| 编码器–解码器注意力 | 解码器当前表示 | 编码器输出 | 从源语言中提取相关信息 |
交叉注意力和自注意力使用同一个计算公式;区别在于 Q、K、V 的来源。
自注意力到底计算了什么
设输入序列表示 。模型用三个可学习矩阵把它投影为查询、键和值:
可以把 Query 理解为“当前位置想找什么”,Key 理解为“各位置供匹配的特征”,Value 理解为“匹配后实际取出的内容”。三者都由可学习的投影产生,使模型能够从训练数据中形成适合任务的信息检索方式。
论文的缩放点积注意力为:
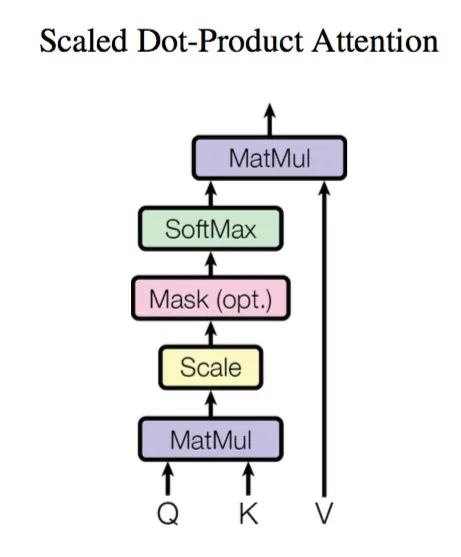
按矩阵形状看,、、。 产生 个匹配分数;Softmax 沿每个 Query 对应的 Key 维度计算权重;最后乘 ,输出形状为 。
一个只有一个 Query、两个 Key 的小例子:若缩放后的分数是 ,Softmax 权重就是 。当两个 Value 分别是 和 时,输出为 。这种加权聚合让每个位置都能形成融合上下文的新表示。
为什么除以 ?若 Query 和 Key 的各维近似独立、均值为 0、方差为 1,点积的方差随 增长。分数过大容易让 Softmax 饱和,梯度变小;缩放有助于控制分数尺度。
下面是公式的 PyTorch 教学复现,并非论文提供的源码。mask=True 表示该位置允许被关注。
import math

import torch


def scaled_dot_product_attention(q, k, v, mask=None):
    scores = q @ k.transpose(-2, -1) / math.sqrt(q.size(-1))
    if mask is not None:
        scores = scores.masked_fill(~mask, torch.finfo(scores.dtype).min)
    weights = torch.softmax(scores, dim=-1)
    return weights @ v, weights
输入可为 (batch, heads, query_len, head_dim) 等形状;矩阵乘法和 Mask 会在批次、头维度上广播。每行至少要有一个可关注位置。
多头注意力为什么有用
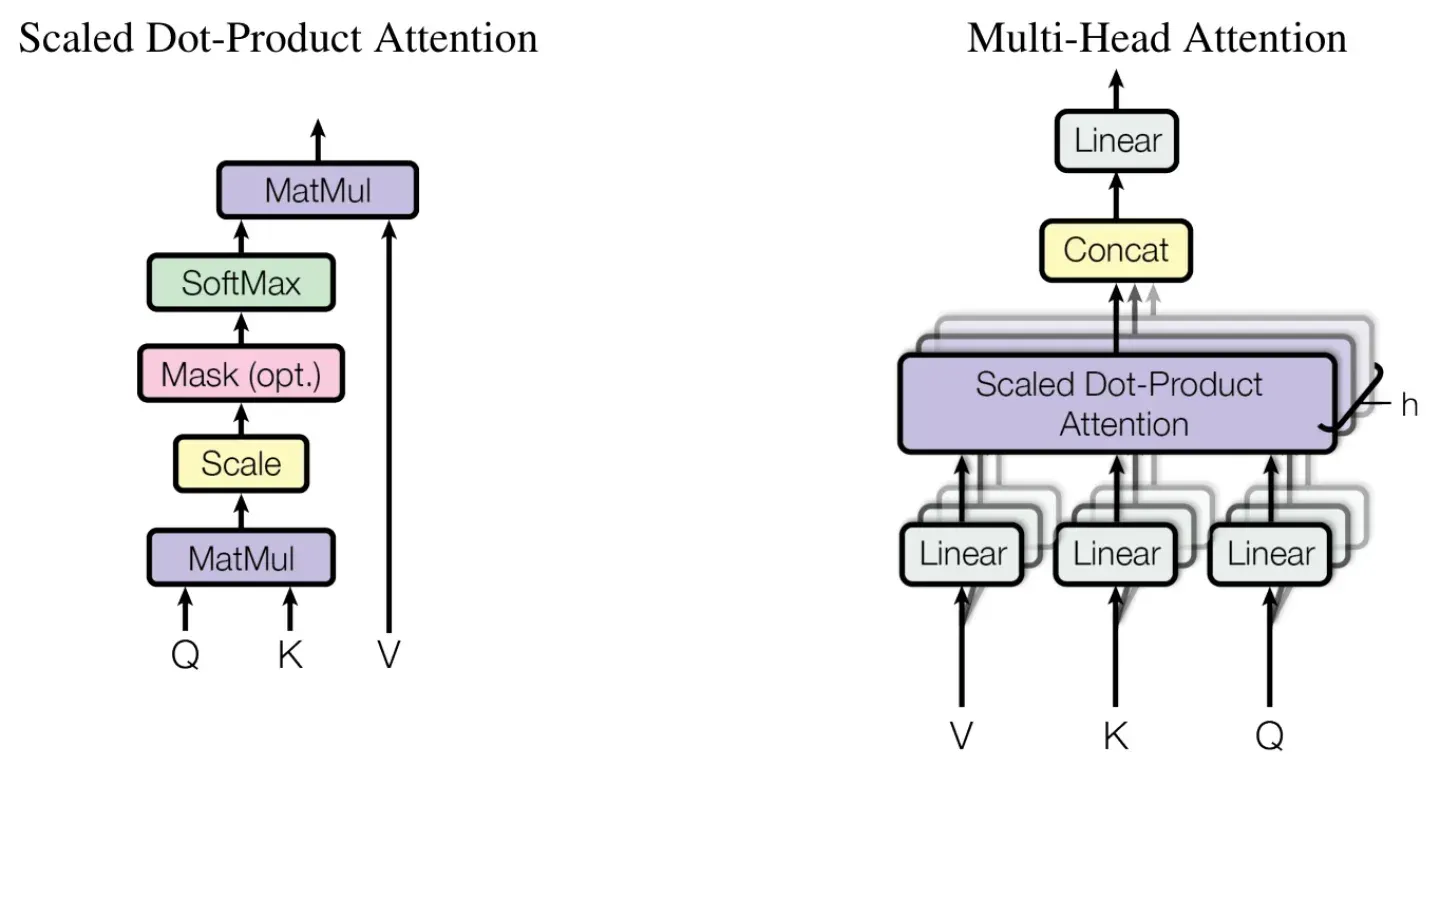
一个头只生成一套投影和注意力权重。多头机制使用多组独立参数,在不同表示子空间中并行计算,再拼接并投影回模型维度:
Base 模型使用 、;8 个头拼接后的宽度为 。多组可学习的投影让模型能同时从不同表示子空间聚合信息,成为后来 Transformer 架构中极有代表性的设计。
位置编码怎样表达顺序
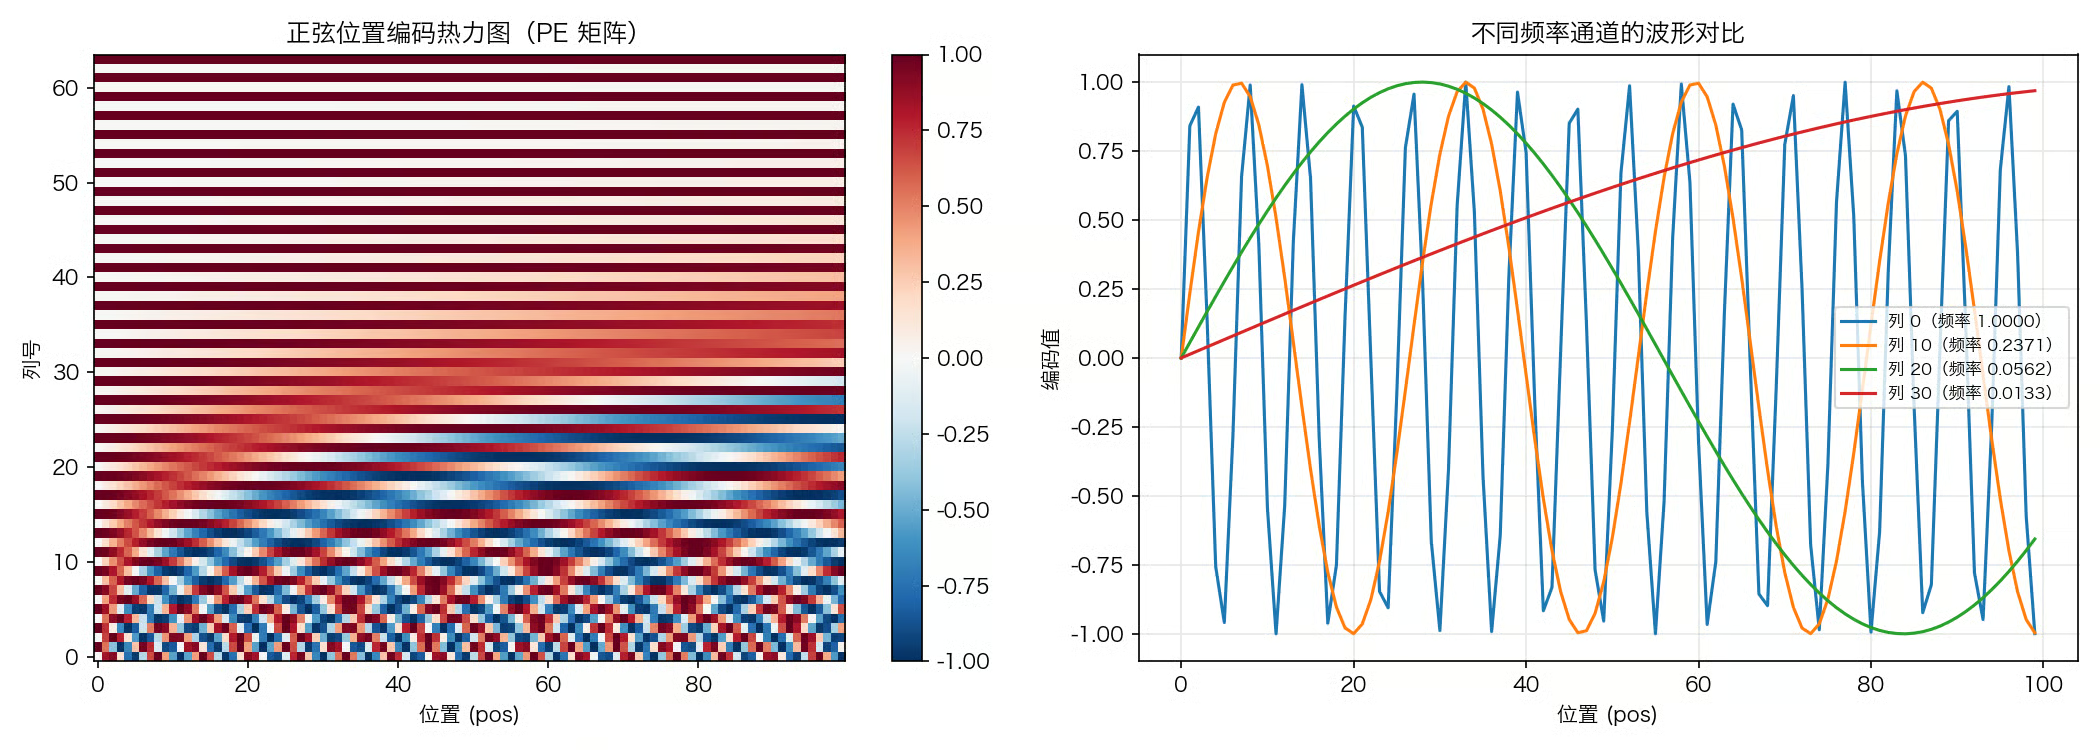
单纯的自注意力无法凭自身区分同一组词的不同排列。原论文把位置编码加到词嵌入上:
固定正弦位置编码对偶数、奇数维度分别使用正弦和余弦:
各维频率不同,因此每个位置得到一组有规律变化的数值。作者希望模型由此学习位置之间的相对关系。将位置信息与词嵌入相加,也让“内容表示”和“顺序表示”成为可以分别设计的模块;论文还比较了可学习的位置嵌入,报告两种方法表现接近。
因果掩码与逐词生成
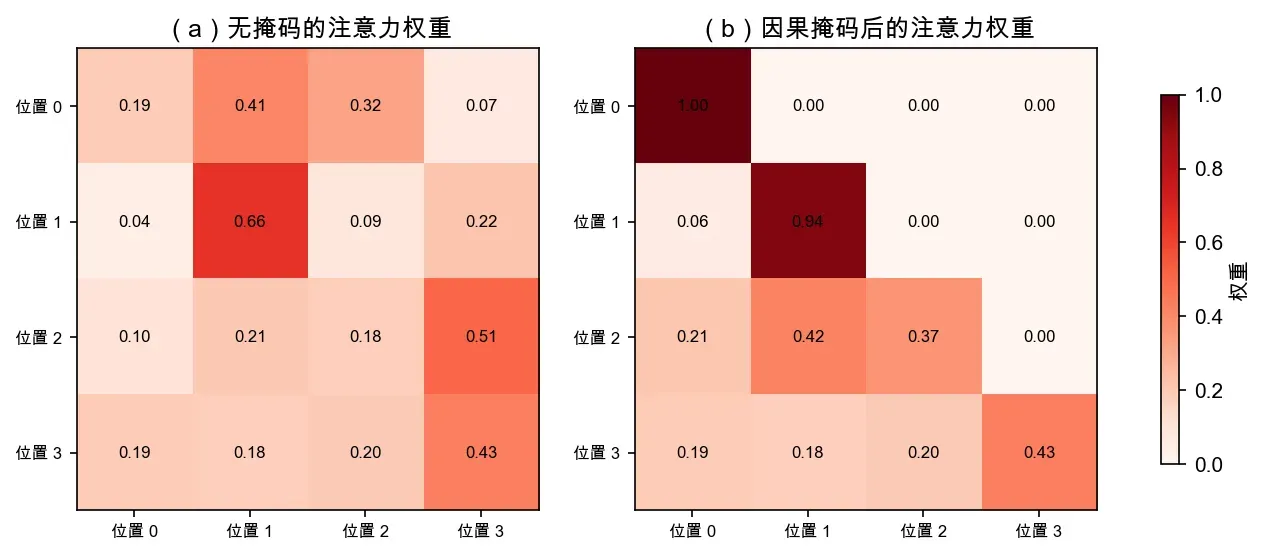
翻译训练时,解码器读入右移后的目标序列。例如目标是“我 爱 你”,预测“爱”的位置只能使用起始符和“我”,不能偷看“爱”或“你”。因果掩码在 Softmax 前把未来位置的分数设为负无穷:
其中 表示允许, 表示屏蔽。以 4 个位置为例:
       key 1   2   3   4
query 1    ✓   ×   ×   ×
      2    ✓   ✓   ×   ×
      3    ✓   ✓   ✓   ×
      4    ✓   ✓   ✓   ✓
训练时已知完整目标句,因果掩码让所有位置可以在一次前向计算中并行学习“根据前文预测下一个词”。生成时,模型根据已经生成的词依次预测后续词。这种设计后来也成为自回归语言模型的重要基础。Padding Mask 则用于屏蔽补齐的无效位置。
FFN、残差和归一化同样重要
注意力负责位置之间的信息混合;每层的 FFN 对每个位置独立应用相同参数,完成特征的非线性变换:
Base 模型中,FFN 从 512 维扩展到 2048 维,再映射回 512 维。原论文在每个子层外使用残差连接,并在相加后归一化:
这通常称为 Post-LN。注意力负责跨位置聚合,FFN 负责逐位置变换,残差与归一化帮助层与层之间传递信息;这些模块共同构成了可重复堆叠的 Transformer 层。
训练设置与实验结果
论文在 WMT 2014 英译德和英译法任务上评估。优化器为 Adam,学习率先经过 4000 步 warmup,再按步数的平方根倒数下降:
会议论文 Table 2 报告的 BLEU 分数如下。BLEU 是机器翻译输出与参考译文之间的自动评价指标;这里只比较论文报告的相同任务结果。
| 模型 | 英译德 BLEU | 英译法 BLEU |
|---|---|---|
| Transformer Base | 27.3 | 38.1 |
| Transformer Big | 28.4 | 41.0 |
Big 在英译德任务达到 28.4 BLEU;英译法的 41.0 是当时出色的单模型成绩。论文还报告,Base 在 8 张 P100 GPU 上约训练 12 小时,Big 约 3.5 天。翻译质量与训练并行性同时得到验证,使这套架构受到广泛关注。
从 Transformer 到后来的模型
Transformer 的深远影响,来自一套能够按任务重新组合的模块:自注意力负责按内容建立联系,多头机制提供不同的表示子空间,位置编码引入顺序信息,FFN 与残差结构支持逐层提炼表示。论文证明,这些模块可以组成有效的编码器–解码器系统,并在机器翻译任务中取得优秀成绩。
后续研究沿着这套架构走出了不同方向:
| 后续工作 | 继承和发展的思想 | 带来的积极影响 |
|---|---|---|
| GPT | 使用因果自注意力进行自回归预训练 | 让 Transformer 成为生成式语言模型的重要基础 |
| BERT | 使用编码器学习双向上下文表示 | 推动预训练模型在语言理解任务中的应用 |
| T5 | 延续编码器–解码器结构,将任务统一为文本到文本 | 展示同一架构处理多种语言任务的潜力 |
| ViT | 将图像切成 Patch 序列,用 Transformer 建模 | 将序列建模思想扩展到计算机视觉 |
这些工作各自调整了模型结构和训练目标,也共同说明了原论文最重要的启发:注意力可以成为构建通用表示模型的核心模块。
读完这篇论文,可以用三个问题串起整套架构:**Q、K、V 如何让位置交换信息?多头注意力与位置编码各自贡献了什么?编码器和解码器又怎样把这些模块组合成翻译模型?**理解这条主线,也就能看出后续模型为什么不断借鉴和发展 Transformer。