现代云上应用很少由单一服务器独立承载。一个典型的企业级后端系统, 往往同时涉及网络、计算、容器、流量治理、数据库、消息系统、对象存储、 身份认证和监控告警。
从应用开发者的视角看,一个 HTTP 请求可能只是进入 Controller 并返回结果; 但从基础设施视角看,它在到达应用容器之前,可能已经经过 DNS、WAF、 负载均衡、API 网关、Kubernetes Service 和服务网格代理。
因此,学习云服务不应从记忆某个产品的控制台开始,而应先回答三个问题:
- 它位于整个系统的哪一层?
- 它解决的是身份、网络、计算、流量、数据还是运维问题?
- 它的上下游是谁,请求或数据如何经过它?
本文是云服务系列的第一篇。我们先建立一张全局地图,后续文章再逐层深入。
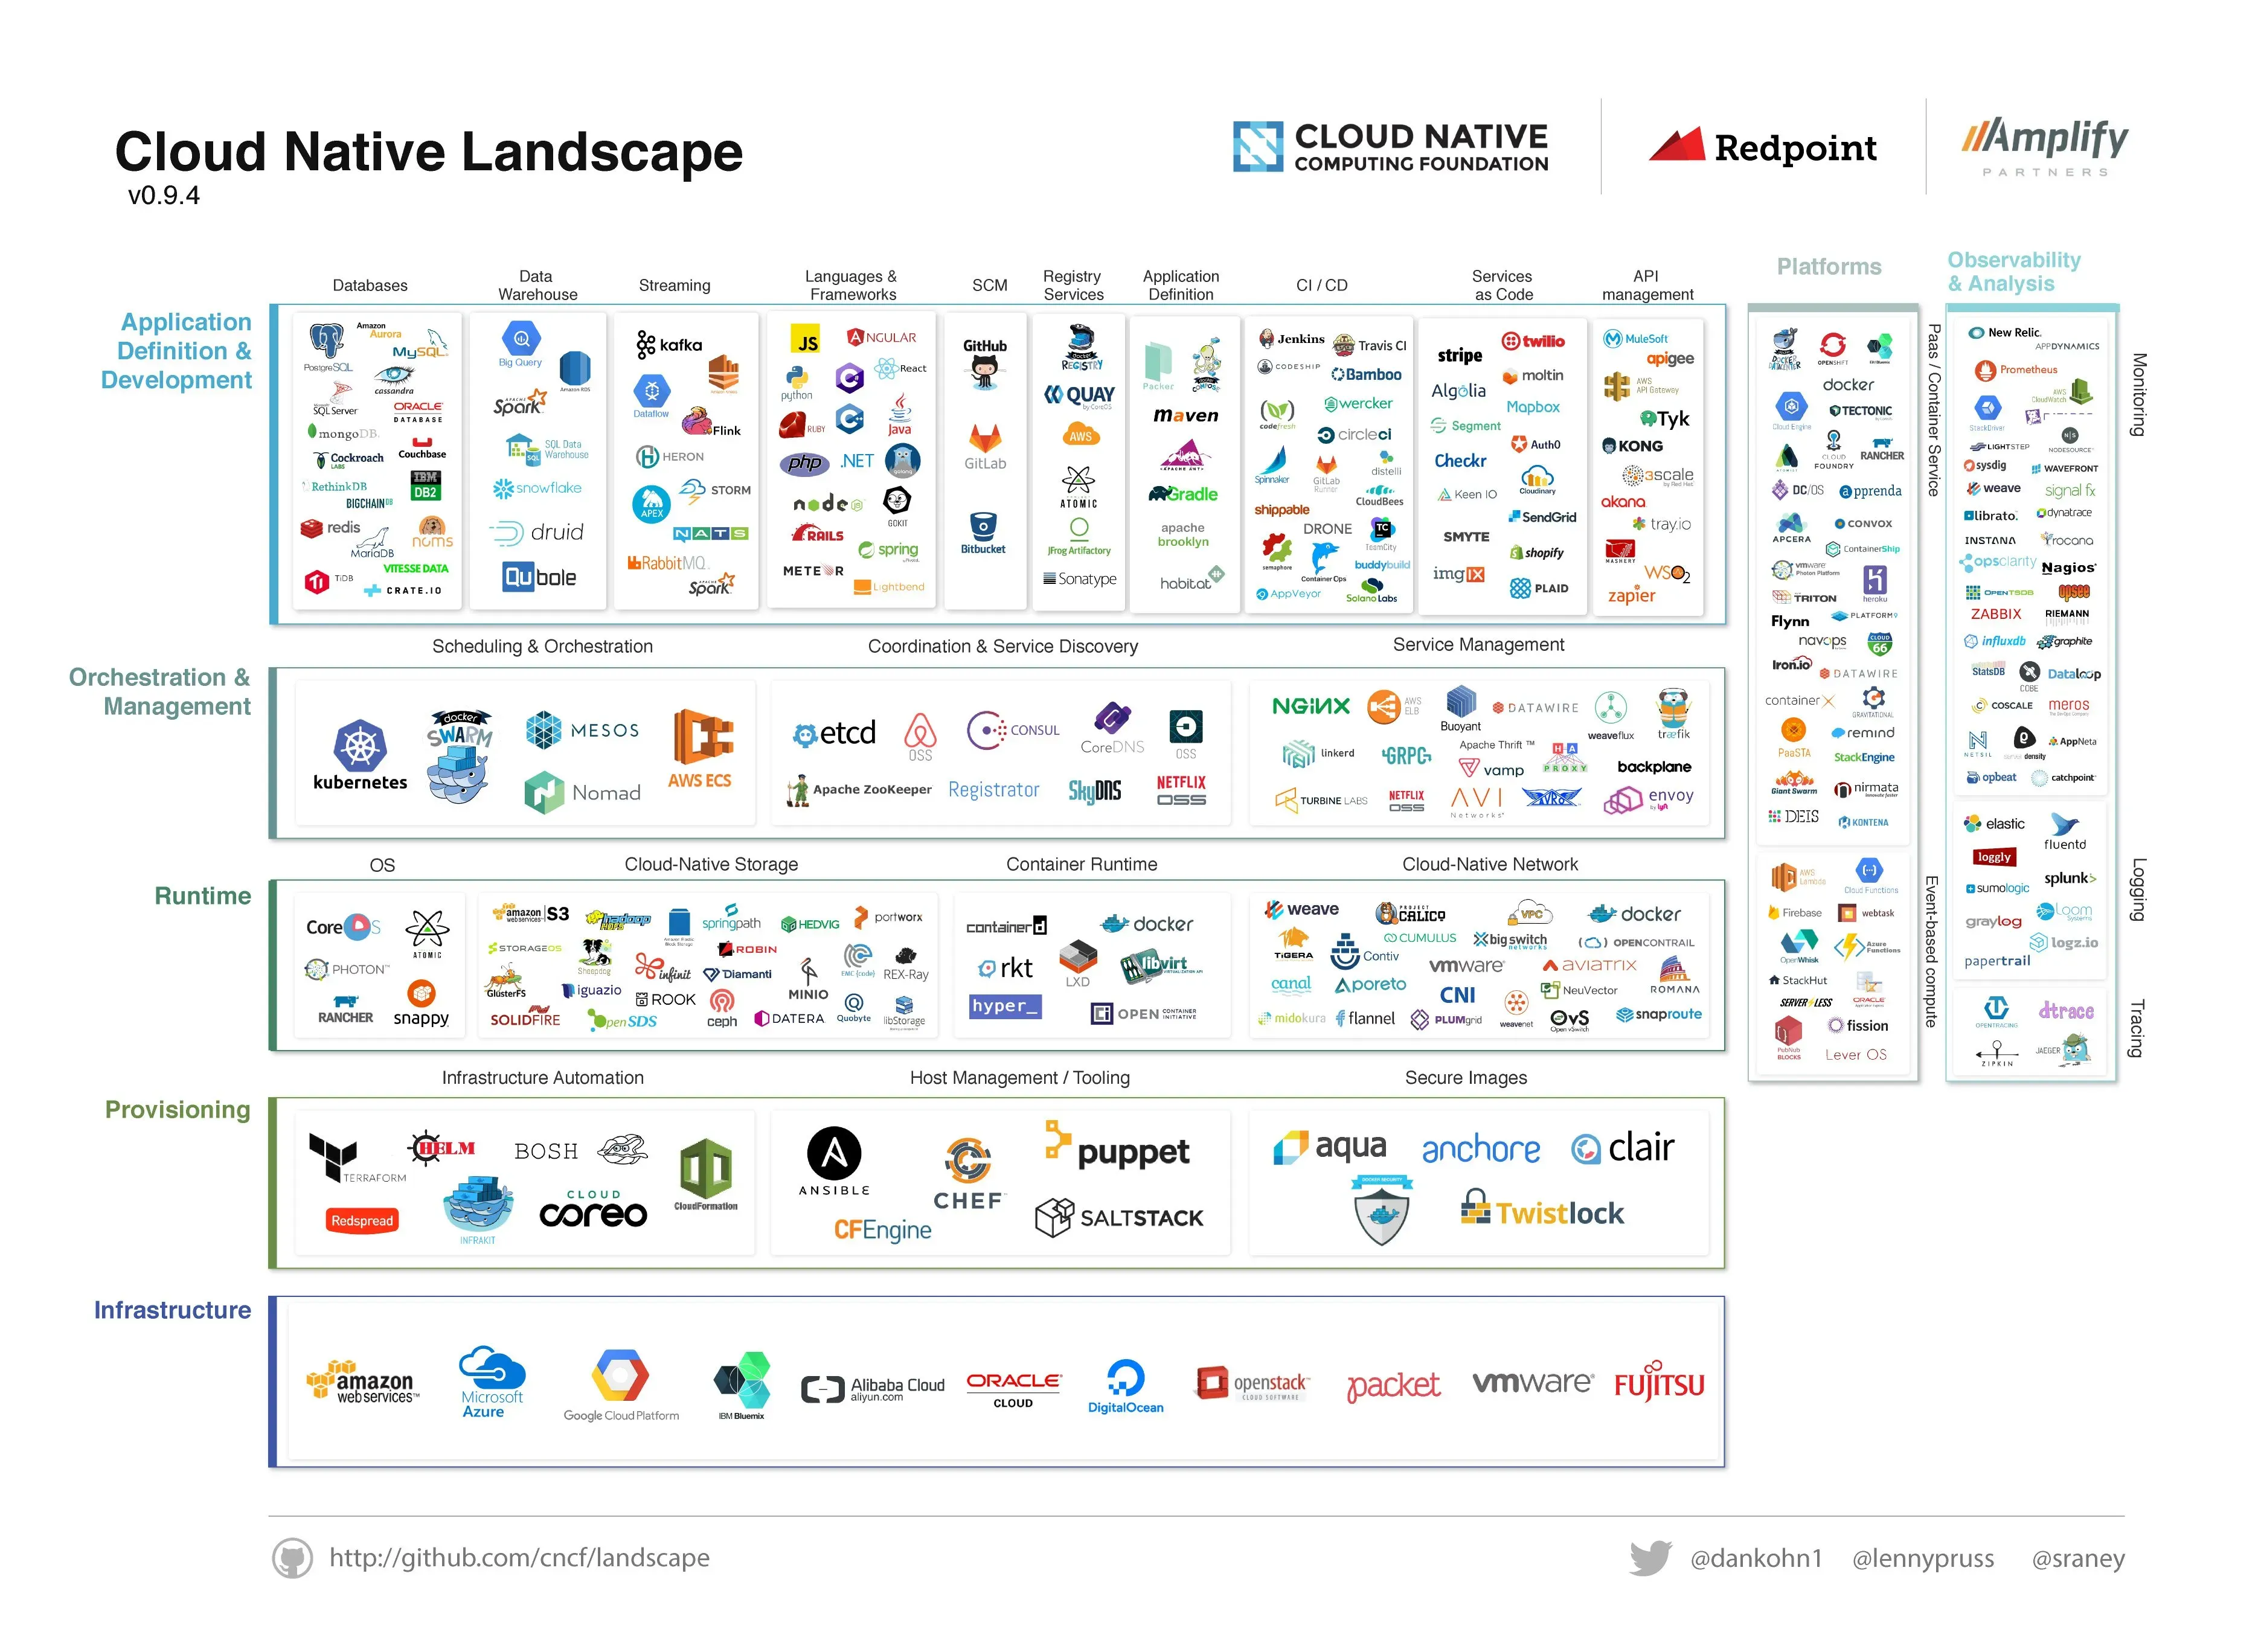
上图是 CNCF 早期发布的云原生生态版图,用于展示基础设施、运行时、编排、 应用开发与可观测性之间的分层关系。图中的项目版本和收录范围不代表当前状态, 本文关注的是其分类思路。
一、先建立分层模型
云原生基础设施可以归纳为六个相互协作的层面:
| 层面 | 核心问题 | 典型技术或服务 |
|---|---|---|
| 身份与权限 | 谁能操作哪些资源 | IAM、Role、Policy、临时凭证 |
| 网络与计算 | 资源在哪里运行、如何互通 | Region、AZ、VPC、Subnet、Security Group、ECS |
| 容器与交付 | 应用如何构建、部署和调度 | Image、Registry、Kubernetes、CCE、Helm |
| 流量治理 | 请求如何进入系统并在服务间流动 | DNS、WAF、ELB、APIG、Ingress、Service Mesh |
| 数据基础设施 | 业务状态保存在哪里 | RDS、Redis、Kafka、OBS |
| 可观测性 | 系统是否正常、异常发生在哪里 | Metrics、Logs、Traces、AOM、LTS、CES |
这些层面不是彼此独立的产品清单。Kubernetes 集群建立在计算和网络资源之上, 其中的应用会访问数据库、缓存和消息系统,同时向可观测性平台发送日志、指标 和链路数据。IAM 则贯穿所有层面,约束人和程序对资源的访问。
%3btext-align:center%3b%7d%23mermaid-0 .edgeLabel p%7bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3b%7d%23mermaid-0 .edgeLabel rect%7bopacity:0.5%3bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bfill:rgba(232%2c232%2c232%2c 0.8)%3b%7d%23mermaid-0 .labelBkg%7bbackground-color:rgba(232%2c 232%2c 232%2c 0.5)%3b%7d%23mermaid-0 .cluster rect%7bfill:%23ffffde%3bstroke:%23aaaa33%3bstroke-width:1px%3b%7d%23mermaid-0 .cluster text%7bfill:%23333%3b%7d%23mermaid-0 .cluster span%7bcolor:%23333%3b%7d%23mermaid-0 .node .collapsed-indicator%7bfill:%23aaaa33%3bstroke:none%3bopacity:0.6%3b%7d%23mermaid-0 .node .collapsed-separator%7bstroke:%23aaaa33%3bstroke-width:0.75px%3b%7d%23mermaid-0 div.mermaidTooltip%7bposition:absolute%3btext-align:center%3bmax-width:200px%3bpadding:2px%3bfont-family:arial%2csans-serif%3bfont-size:12px%3bbackground:hsl(80%2c 100%25%2c 96.2745098039%25)%3bborder:1px solid %23aaaa33%3bborder-radius:2px%3bpointer-events:none%3bz-index:100%3b%7d%23mermaid-0 .flowchartTitleText%7btext-anchor:middle%3bfont-size:18px%3bfill:%23333%3b%7d%23mermaid-0 rect.text%7bfill:none%3bstroke-width:0%3b%7d%23mermaid-0 .icon-shape%2c%23mermaid-0 .image-shape%7bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3btext-align:center%3b%7d%23mermaid-0 .icon-shape p%2c%23mermaid-0 .image-shape p%7bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bpadding:2px%3b%7d%23mermaid-0 .icon-shape .label rect%2c%23mermaid-0 .image-shape .label rect%7bopacity:0.5%3bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bfill:rgba(232%2c232%2c232%2c 0.8)%3b%7d%23mermaid-0 .label-icon%7bdisplay:inline-block%3bheight:1em%3boverflow:visible%3bvertical-align:-0.125em%3b%7d%23mermaid-0 .node .label-icon path%7bfill:currentColor%3bstroke:revert%3bstroke-width:revert%3b%7d%23mermaid-0 .node .neo-node%7bstroke:%239370DB%3b%7d%23mermaid-0 %5bdata-look='neo'%5d.node rect%2c%23mermaid-0 %5bdata-look='neo'%5d.cluster rect%2c%23mermaid-0 %5bdata-look='neo'%5d.node polygon%7bstroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-0 %5bdata-look='neo'%5d.swimlane.cluster rect%7bfilter:none%3b%7d%23mermaid-0 %5bdata-look='neo'%5d.node path%7bstroke:%239370DB%3bstroke-width:1px%3b%7d%23mermaid-0 %5bdata-look='neo'%5d.node .outer-path%7bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-0 %5bdata-look='neo'%5d.node .neo-line path%7bstroke:%239370DB%3bfilter:none%3b%7d%23mermaid-0 %5bdata-look='neo'%5d.node circle%7bstroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-0 %5bdata-look='neo'%5d.node circle .state-start%7bfill:black%3b%7d%23mermaid-0 %5bdata-look='neo'%5d.icon-shape .icon%7bfill:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-0 %5bdata-look='neo'%5d.icon-shape .icon-neo path%7bstroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-0 :root%7b--mermaid-font-family:arial%2csans-serif%3b%7d%3c/style%3e%3cg%3e%3cmarker id='mermaid-0_flowchart-v2-pointEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'%3e%3cpath d='M 0 0 L 10 5 L 0 10 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-pointStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='4.5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'%3e%3cpath d='M 0 5 L 10 10 L 10 0 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-pointEnd-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='11.5' refY='7' markerUnits='userSpaceOnUse' markerWidth='10.5' markerHeight='14' orient='auto'%3e%3cpath d='M 0 0 L 11.5 7 L 0 14 z' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-pointStart-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='1' refY='7' markerUnits='userSpaceOnUse' markerWidth='11.5' markerHeight='14' orient='auto'%3e%3cpolygon points='0%2c7 11.5%2c14 11.5%2c0' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-circleEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='11' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-circleStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-1' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-circleEnd-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refY='5' refX='12.25' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-circleStart-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-2' refY='5' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-crossEnd' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='12' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3cpath d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-crossStart' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='-1' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3cpath d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-crossEnd-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='17.7' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'%3e%3cpath d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-crossStart-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='-3.5' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'%3e%3cpath d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cg class='root'%3e%3cg class='clusters'%3e%3cg class='cluster' id='mermaid-0-Observe' data-look='classic'%3e%3crect style='' x='800.2265625' y='860' width='484.578125' height='137.1820526123047'/%3e%3cg class='cluster-label' transform='translate(1018.515625%2c 860)'%3e%3cforeignObject width='48' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3e%e5%8f%af%e8%a7%82%e6%b5%8b%e6%80%a7%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='cluster' id='mermaid-0-Cloud' data-look='classic'%3e%3crect style='' x='8' y='602' width='772.2265625' height='395.1820526123047'/%3e%3cg class='cluster-label' transform='translate(377.66015625%2c 602)'%3e%3cforeignObject width='32.90625' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eVPC%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='cluster' id='mermaid-0-Entry' data-look='classic'%3e%3crect style='' x='28.62109375' y='112' width='168.234375' height='416'/%3e%3cg class='cluster-label' transform='translate(88.73828125%2c 112)'%3e%3cforeignObject width='48' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3e%e6%b5%81%e9%87%8f%e5%85%a5%e5%8f%a3%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='cluster' id='mermaid-0-Runtime' data-look='classic'%3e%3crect style='' x='28' y='627' width='322.8203125' height='345.1820526123047'/%3e%3cg class='cluster-label' transform='translate(124.93359375%2c 627)'%3e%3cforeignObject width='128.953125' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eKubernetes / CCE%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cg class='edgePaths'%3e%3cpath d='M112.738%2c191L112.738%2c195.167C112.738%2c199.333%2c112.738%2c207.667%2c112.738%2c215.333C112.738%2c223%2c112.738%2c230%2c112.738%2c233.5L112.738%2c237' id='mermaid-0-L_DNS_WAF_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_DNS_WAF_0' data-points='W3sieCI6MTEyLjczODI4MTI1LCJ5IjoxOTF9LHsieCI6MTEyLjczODI4MTI1LCJ5IjoyMTZ9LHsieCI6MTEyLjczODI4MTI1LCJ5IjoyNDF9XQ==' data-look='classic' marker-end='url(%23mermaid-0_flowchart-v2-pointEnd)'/%3e%3cpath d='M112.738%2c295L112.738%2c299.167C112.738%2c303.333%2c112.738%2c311.667%2c112.738%2c319.333C112.738%2c327%2c112.738%2c334%2c112.738%2c337.5L112.738%2c341' id='mermaid-0-L_WAF_ELB_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_WAF_ELB_0' data-points='W3sieCI6MTEyLjczODI4MTI1LCJ5IjoyOTV9LHsieCI6MTEyLjczODI4MTI1LCJ5IjozMjB9LHsieCI6MTEyLjczODI4MTI1LCJ5IjozNDV9XQ==' data-look='classic' marker-end='url(%23mermaid-0_flowchart-v2-pointEnd)'/%3e%3cpath d='M112.738%2c399L112.738%2c403.167C112.738%2c407.333%2c112.738%2c415.667%2c112.738%2c423.333C112.738%2c431%2c112.738%2c438%2c112.738%2c441.5L112.738%2c445' id='mermaid-0-L_ELB_APIG_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_ELB_APIG_0' data-points='W3sieCI6MTEyLjczODI4MTI1LCJ5IjozOTl9LHsieCI6MTEyLjczODI4MTI1LCJ5Ijo0MjR9LHsieCI6MTEyLjczODI4MTI1LCJ5Ijo0NDl9XQ==' data-look='classic' marker-end='url(%23mermaid-0_flowchart-v2-pointEnd)'/%3e%3cpath d='M209.289%2c706L209.289%2c710.167C209.289%2c714.333%2c209.289%2c722.667%2c209.289%2c730.333C209.289%2c738%2c209.289%2c745%2c209.289%2c748.5L209.289%2c752' id='mermaid-0-L_Gateway_ServiceA_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_Gateway_ServiceA_0' data-points='W3sieCI6MjA5LjI4OTA2MjUsInkiOjcwNn0seyJ4IjoyMDkuMjg5MDYyNSwieSI6NzMxfSx7IngiOjIwOS4yODkwNjI1LCJ5Ijo3NTZ9XQ==' data-look='classic' marker-end='url(%23mermaid-0_flowchart-v2-pointEnd)'/%3e%3cpath d='M166.684%2c810L160.109%2c814.167C153.534%2c818.333%2c140.384%2c826.667%2c133.809%2c835C127.234%2c843.333%2c127.234%2c851.667%2c127.234%2c860.015C127.234%2c868.364%2c127.234%2c876.727%2c127.234%2c880.909L127.234%2c885.091' id='mermaid-0-L_ServiceA_ServiceB_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_ServiceA_ServiceB_0' data-points='W3sieCI6MTY2LjY4Mzc0Mzk5MDM4NDYsInkiOjgxMH0seyJ4IjoxMjcuMjM0Mzc1LCJ5Ijo4MzV9LHsieCI6MTI3LjIzNDM3NSwieSI6ODYwfSx7IngiOjEyNy4yMzQzNzUsInkiOjg4OS4wOTEwMjYzMDYxNTIzfV0=' data-look='classic' marker-end='url(%23mermaid-0_flowchart-v2-pointEnd)'/%3e%3cpath d='M112.738%2c62L112.738%2c66.167C112.738%2c70.333%2c112.738%2c78.667%2c112.738%2c87C112.738%2c95.333%2c112.738%2c103.667%2c112.738%2c111.333C112.738%2c119%2c112.738%2c126%2c112.738%2c129.5L112.738%2c133' id='mermaid-0-L_Client_DNS_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_Client_DNS_0' data-points='W3sieCI6MTEyLjczODI4MTI1LCJ5Ijo2Mn0seyJ4IjoxMTIuNzM4MjgxMjUsInkiOjg3fSx7IngiOjExMi43MzgyODEyNSwieSI6MTEyfSx7IngiOjExMi43MzgyODEyNSwieSI6MTM3fV0=' data-look='classic' marker-end='url(%23mermaid-0_flowchart-v2-pointEnd)'/%3e%3cpath d='M112.738%2c503L112.738%2c507.167C112.738%2c511.333%2c112.738%2c519.667%2c112.738%2c530C112.738%2c540.333%2c112.738%2c552.667%2c112.738%2c565C112.738%2c577.333%2c112.738%2c589.667%2c112.738%2c600C112.738%2c610.333%2c112.738%2c618.667%2c119.888%2c626.684C127.037%2c634.701%2c141.336%2c642.402%2c148.486%2c646.253L155.635%2c650.103' id='mermaid-0-L_APIG_Gateway_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_APIG_Gateway_0' data-points='W3sieCI6MTEyLjczODI4MTI1LCJ5Ijo1MDN9LHsieCI6MTEyLjczODI4MTI1LCJ5Ijo1Mjh9LHsieCI6MTEyLjczODI4MTI1LCJ5Ijo1NjV9LHsieCI6MTEyLjczODI4MTI1LCJ5Ijo2MDJ9LHsieCI6MTEyLjczODI4MTI1LCJ5Ijo2Mjd9LHsieCI6MTU5LjE1NjkyNjA4MTczMDc3LCJ5Ijo2NTJ9XQ==' data-look='classic' marker-end='url(%23mermaid-0_flowchart-v2-pointEnd)'/%3e%3cpath d='M177.068%2c810L172.096%2c814.167C167.124%2c818.333%2c157.179%2c826.667%2c152.207%2c835C147.234%2c843.333%2c147.234%2c851.667%2c186.347%2c864.176C225.459%2c876.685%2c303.684%2c893.37%2c342.796%2c901.712L381.908%2c910.054' id='mermaid-0-L_ServiceA_RDS_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_ServiceA_RDS_0' data-points='W3sieCI6MTc3LjA2ODM1OTM3NSwieSI6ODEwfSx7IngiOjE0Ny4yMzQzNzUsInkiOjgzNX0seyJ4IjoxNDcuMjM0Mzc1LCJ5Ijo4NjB9LHsieCI6Mzg1LjgyMDMxMjUsInkiOjkxMC44ODg2Nzk4NDgwMDE3fV0=' data-look='classic' marker-end='url(%23mermaid-0_flowchart-v2-pointEnd)'/%3e%3cpath d='M187.453%2c810L184.083%2c814.167C180.713%2c818.333%2c173.974%2c826.667%2c170.604%2c835C167.234%2c843.333%2c167.234%2c851.667%2c219.471%2c864.318C271.707%2c876.97%2c376.18%2c893.939%2c428.417%2c902.424L480.653%2c910.909' id='mermaid-0-L_ServiceA_Redis_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_ServiceA_Redis_0' data-points='W3sieCI6MTg3LjQ1Mjk3NDc1OTYxNTQsInkiOjgxMH0seyJ4IjoxNjcuMjM0Mzc1LCJ5Ijo4MzV9LHsieCI6MTY3LjIzNDM3NSwieSI6ODYwfSx7IngiOjQ4NC42MDE1NjI1LCJ5Ijo5MTEuNTUwNTQ3NzYyMTUwOH1d' data-look='classic' marker-end='url(%23mermaid-0_flowchart-v2-pointEnd)'/%3e%3cpath d='M197.838%2c810L196.07%2c814.167C194.303%2c818.333%2c190.769%2c826.667%2c189.002%2c835C187.234%2c843.333%2c187.234%2c851.667%2c253.786%2c864.49C320.337%2c877.313%2c453.439%2c894.625%2c519.99%2c903.282L586.541%2c911.938' id='mermaid-0-L_ServiceA_Kafka_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_ServiceA_Kafka_0' data-points='W3sieCI6MTk3LjgzNzU5MDE0NDIzMDc3LCJ5Ijo4MTB9LHsieCI6MTg3LjIzNDM3NSwieSI6ODM1fSx7IngiOjE4Ny4yMzQzNzUsInkiOjg2MH0seyJ4Ijo1OTAuNTA3ODEyNSwieSI6OTEyLjQ1NDEyMzEwMDQyNTR9XQ==' data-look='classic' marker-end='url(%23mermaid-0_flowchart-v2-pointEnd)'/%3e%3cpath d='M228.393%2c810L231.341%2c814.167C234.289%2c818.333%2c240.186%2c826.667%2c243.134%2c835C246.082%2c843.333%2c246.082%2c851.667%2c320.478%2c864.623C394.874%2c877.58%2c543.666%2c895.159%2c618.061%2c903.949L692.457%2c912.739' id='mermaid-0-L_ServiceA_OBS_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_ServiceA_OBS_0' data-points='W3sieCI6MjI4LjM5MzEwMzk2NjM0NjE2LCJ5Ijo4MTB9LHsieCI6MjQ2LjA4MjAzMTI1LCJ5Ijo4MzV9LHsieCI6MjQ2LjA4MjAzMTI1LCJ5Ijo4NjB9LHsieCI6Njk2LjQyOTY4NzUsInkiOjkxMy4yMDgzNjI0NjE5MjQ1fV0=' data-look='classic' marker-end='url(%23mermaid-0_flowchart-v2-pointEnd)'/%3e%3cpath d='M238.778%2c810L243.328%2c814.167C247.879%2c818.333%2c256.981%2c826.667%2c261.531%2c835C266.082%2c843.333%2c266.082%2c851.667%2c360.275%2c864.288C454.469%2c876.909%2c642.856%2c893.818%2c737.049%2c902.272L831.243%2c910.727' id='mermaid-0-L_ServiceA_Metrics_0' class='edge-thickness-normal edge-pattern-dotted edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_ServiceA_Metrics_0' data-points='W3sieCI6MjM4Ljc3NzcxOTM1MDk2MTU1LCJ5Ijo4MTB9LHsieCI6MjY2LjA4MjAzMTI1LCJ5Ijo4MzV9LHsieCI6MjY2LjA4MjAzMTI1LCJ5Ijo4NjB9LHsieCI6ODM1LjIyNjU2MjUsInkiOjkxMS4wODQzMDc2NjA0ODkxfV0=' data-look='classic' marker-end='url(%23mermaid-0_flowchart-v2-pointEnd)'/%3e%3cpath d='M249.162%2c810L255.316%2c814.167C261.469%2c818.333%2c273.775%2c826.667%2c279.929%2c835C286.082%2c843.333%2c286.082%2c851.667%2c403.868%2c864.549C521.655%2c877.431%2c757.227%2c894.861%2c875.014%2c903.577L992.8%2c912.292' id='mermaid-0-L_ServiceA_Logs_0' class='edge-thickness-normal edge-pattern-dotted edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_ServiceA_Logs_0' data-points='W3sieCI6MjQ5LjE2MjMzNDczNTU3NjksInkiOjgxMH0seyJ4IjoyODYuMDgyMDMxMjUsInkiOjgzNX0seyJ4IjoyODYuMDgyMDMxMjUsInkiOjg2MH0seyJ4Ijo5OTYuNzg5MDYyNSwieSI6OTEyLjU4NzM0MjM0MzI5OTJ9XQ==' data-look='classic' marker-end='url(%23mermaid-0_flowchart-v2-pointEnd)'/%3e%3cpath d='M259.547%2c810L267.303%2c814.167C275.059%2c818.333%2c290.57%2c826.667%2c298.326%2c835C306.082%2c843.333%2c306.082%2c851.667%2c444.652%2c864.571C583.221%2c877.475%2c860.361%2c894.95%2c998.93%2c903.687L1137.5%2c912.425' id='mermaid-0-L_ServiceA_Traces_0' class='edge-thickness-normal edge-pattern-dotted edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_ServiceA_Traces_0' data-points='W3sieCI6MjU5LjU0Njk1MDEyMDE5MjMsInkiOjgxMH0seyJ4IjozMDYuMDgyMDMxMjUsInkiOjgzNX0seyJ4IjozMDYuMDgyMDMxMjUsInkiOjg2MH0seyJ4IjoxMTQxLjQ5MjE4NzUsInkiOjkxMi42NzYyMzk0ODE4NjM0fV0=' data-look='classic' marker-end='url(%23mermaid-0_flowchart-v2-pointEnd)'/%3e%3cpath d='M276.082%2c503L276.082%2c507.167C276.082%2c511.333%2c276.082%2c519.667%2c276.082%2c530C276.082%2c540.333%2c276.082%2c552.667%2c276.082%2c564.333C276.082%2c576%2c276.082%2c587%2c276.082%2c592.5L276.082%2c598' id='mermaid-0-L_IAM_Cloud_0' class='edge-thickness-normal edge-pattern-dotted edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_IAM_Cloud_0' data-points='W3sieCI6Mjc2LjA4MjAzMTI1LCJ5Ijo1MDN9LHsieCI6Mjc2LjA4MjAzMTI1LCJ5Ijo1Mjh9LHsieCI6Mjc2LjA4MjAzMTI1LCJ5Ijo1NjV9LHsieCI6Mjc2LjA4MjAzMTI1LCJ5Ijo2MDJ9LHsieCI6Mjc2LjA4MjAzMTI1LCJ5Ijo2Mjd9LHsieCI6MjU4Ljk4NTA4MDA3NzkzNDEsInkiOjYwMi4wMDAwMDc2MjkzOTQ1fV0=' data-look='classic' marker-end='url(%23mermaid-0_flowchart-v2-pointEnd)'/%3e%3c/g%3e%3cg class='edgeLabels'%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_DNS_WAF_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_WAF_ELB_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_ELB_APIG_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_Gateway_ServiceA_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_ServiceA_ServiceB_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_Client_DNS_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_APIG_Gateway_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_ServiceA_RDS_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_ServiceA_Redis_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_ServiceA_Kafka_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_ServiceA_OBS_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_ServiceA_Metrics_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_ServiceA_Logs_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_ServiceA_Traces_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel' transform='translate(276.08203%2c 552.5)'%3e%3cg class='label' data-id='L_IAM_Cloud_0' transform='translate(-30%2c -12)'%3e%3cforeignObject width='60' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3cp%3e%e8%ba%ab%e4%bb%bd%e4%b8%8e%e6%8e%88%e6%9d%83%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cg class='nodes'%3e%3cg class='node default' id='mermaid-0-flowchart-Client-0' data-look='classic' transform='translate(112.73828125%2c 35)'%3e%3crect class='basic label-container' style='' x='-66.671875' y='-27' width='133.34375' height='54'/%3e%3cg class='label' style='' transform='translate(-36.671875%2c -12)'%3e%3crect/%3e%3cforeignObject width='73.34375' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3e%e7%94%a8%e6%88%b7 / %e5%ae%a2%e6%88%b7%e7%ab%af%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-0-flowchart-DNS-1' data-look='classic' transform='translate(112.73828125%2c 164)'%3e%3crect class='basic label-container' style='' x='-46.890625' y='-27' width='93.78125' height='54'/%3e%3cg class='label' style='' transform='translate(-16.890625%2c -12)'%3e%3crect/%3e%3cforeignObject width='33.78125' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eDNS%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-0-flowchart-WAF-2' data-look='classic' transform='translate(112.73828125%2c 268)'%3e%3crect class='basic label-container' style='' x='-47.4765625' y='-27' width='94.953125' height='54'/%3e%3cg class='label' style='' transform='translate(-17.4765625%2c -12)'%3e%3crect/%3e%3cforeignObject width='34.953125' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eWAF%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-0-flowchart-ELB-3' data-look='classic' transform='translate(112.73828125%2c 372)'%3e%3crect class='basic label-container' style='' x='-45.125' y='-27' width='90.25' height='54'/%3e%3cg class='label' style='' transform='translate(-15.125%2c -12)'%3e%3crect/%3e%3cforeignObject width='30.25' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eELB%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-0-flowchart-APIG-4' data-look='classic' transform='translate(112.73828125%2c 476)'%3e%3crect class='basic label-container' style='' x='-49.1171875' y='-27' width='98.234375' height='54'/%3e%3cg class='label' style='' transform='translate(-19.1171875%2c -12)'%3e%3crect/%3e%3cforeignObject width='38.234375' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eAPIG%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-0-flowchart-Gateway-5' data-look='classic' transform='translate(209.2890625%2c 679)'%3e%3crect class='basic label-container' style='' x='-94.4765625' y='-27' width='188.953125' height='54'/%3e%3cg class='label' style='' transform='translate(-64.4765625%2c -12)'%3e%3crect/%3e%3cforeignObject width='128.953125' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eIngress / Gateway%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-0-flowchart-ServiceA-6' data-look='classic' transform='translate(209.2890625%2c 783)'%3e%3crect class='basic label-container' style='' x='-63.796875' y='-27' width='127.59375' height='54'/%3e%3cg class='label' style='' transform='translate(-33.796875%2c -12)'%3e%3crect/%3e%3cforeignObject width='67.59375' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eService A%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-0-flowchart-ServiceB-7' data-look='classic' transform='translate(127.234375%2c 916.0910263061523)'%3e%3crect class='basic label-container' style='' x='-64.234375' y='-27' width='128.46875' height='54'/%3e%3cg class='label' style='' transform='translate(-34.234375%2c -12)'%3e%3crect/%3e%3cforeignObject width='68.46875' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eService B%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-0-flowchart-RDS-11' data-look='classic' transform='translate(410.2109375%2c 916.0910263061523)'%3e%3cpath d='M0%2c7.01762272972487 a24.390625%2c7.01762272972487 0%2c0%2c0 48.78125%2c0 a24.390625%2c7.01762272972487 0%2c0%2c0 -48.78125%2c0 l0%2c46.01762272972487 a24.390625%2c7.01762272972487 0%2c0%2c0 48.78125%2c0 l0%2c-46.01762272972487' class='basic label-container outer-path' style='' transform='translate(-24.390625%2c -30.026434094587305)'/%3e%3cg class='label' style='' transform='translate(-16.890625%2c -2)'%3e%3crect/%3e%3cforeignObject width='33.78125' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eRDS%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-0-flowchart-Redis-12' data-look='classic' transform='translate(512.5546875%2c 916.0910263061523)'%3e%3cpath d='M0%2c7.725859388495422 a27.953125%2c7.725859388495422 0%2c0%2c0 55.90625%2c0 a27.953125%2c7.725859388495422 0%2c0%2c0 -55.90625%2c0 l0%2c46.72585938849542 a27.953125%2c7.725859388495422 0%2c0%2c0 55.90625%2c0 l0%2c-46.72585938849542' class='basic label-container outer-path' style='' transform='translate(-27.953125%2c -31.088789082743133)'/%3e%3cg class='label' style='' transform='translate(-20.453125%2c -2)'%3e%3crect/%3e%3cforeignObject width='40.90625' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eRedis%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-0-flowchart-Kafka-13' data-look='classic' transform='translate(618.46875%2c 916.0910263061523)'%3e%3cpath d='M0%2c7.727351239312549 a27.9609375%2c7.727351239312549 0%2c0%2c0 55.921875%2c0 a27.9609375%2c7.727351239312549 0%2c0%2c0 -55.921875%2c0 l0%2c46.72735123931255 a27.9609375%2c7.727351239312549 0%2c0%2c0 55.921875%2c0 l0%2c-46.72735123931255' class='basic label-container outer-path' style='' transform='translate(-27.9609375%2c -31.091026858968824)'/%3e%3cg class='label' style='' transform='translate(-20.4609375%2c -2)'%3e%3crect/%3e%3cforeignObject width='40.921875' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eKafka%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-0-flowchart-OBS-14' data-look='classic' transform='translate(720.828125%2c 916.0910263061523)'%3e%3cpath d='M0%2c7.019239413827204 a24.3984375%2c7.019239413827204 0%2c0%2c0 48.796875%2c0 a24.3984375%2c7.019239413827204 0%2c0%2c0 -48.796875%2c0 l0%2c46.01923941382721 a24.3984375%2c7.019239413827204 0%2c0%2c0 48.796875%2c0 l0%2c-46.01923941382721' class='basic label-container outer-path' style='' transform='translate(-24.3984375%2c -30.028859120740808)'/%3e%3cg class='label' style='' transform='translate(-16.8984375%2c -2)'%3e%3crect/%3e%3cforeignObject width='33.796875' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eOBS%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-0-flowchart-Metrics-15' data-look='classic' transform='translate(891.0078125%2c 916.0910263061523)'%3e%3crect class='basic label-container' style='' x='-55.78125' y='-27' width='111.5625' height='54'/%3e%3cg class='label' style='' transform='translate(-25.78125%2c -12)'%3e%3crect/%3e%3cforeignObject width='51.5625' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eMetrics%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-0-flowchart-Logs-16' data-look='classic' transform='translate(1044.140625%2c 916.0910263061523)'%3e%3crect class='basic label-container' style='' x='-47.3515625' y='-27' width='94.703125' height='54'/%3e%3cg class='label' style='' transform='translate(-17.3515625%2c -12)'%3e%3crect/%3e%3cforeignObject width='34.703125' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eLogs%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-0-flowchart-Traces-17' data-look='classic' transform='translate(1195.6484375%2c 916.0910263061523)'%3e%3crect class='basic label-container' style='' x='-54.15625' y='-27' width='108.3125' height='54'/%3e%3cg class='label' style='' transform='translate(-24.15625%2c -12)'%3e%3crect/%3e%3cforeignObject width='48.3125' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eTraces%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-0-flowchart-IAM-18' data-look='classic' transform='translate(276.08203125%2c 476)'%3e%3crect class='basic label-container' style='' x='-44.2265625' y='-27' width='88.453125' height='54'/%3e%3cg class='label' style='' transform='translate(-14.2265625%2c -12)'%3e%3crect/%3e%3cforeignObject width='28.453125' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eIAM%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cdefs%3e%3cfilter id='mermaid-0-drop-shadow' height='130%25' width='130%25'%3e%3cfeDropShadow dx='4' dy='4' stdDeviation='0' flood-opacity='0.06' flood-color='black'/%3e%3c/filter%3e%3c/defs%3e%3cdefs%3e%3cfilter id='mermaid-0-drop-shadow-small' height='150%25' width='150%25'%3e%3cfeDropShadow dx='2' dy='2' stdDeviation='0' flood-opacity='0.06' flood-color='black'/%3e%3c/filter%3e%3c/defs%3e%3c/svg%3e)
%3btext-align:center%3b%7d%23mermaid-dark-0%20.edgeLabel%20p%7bbackground-color:hsl(0%2c%200%25%2c%2034.4117647059%25)%3b%7d%23mermaid-dark-0%20.edgeLabel%20rect%7bopacity:0.5%3bbackground-color:hsl(0%2c%200%25%2c%2034.4117647059%25)%3bfill:hsl(0%2c%200%25%2c%2034.4117647059%25)%3b%7d%23mermaid-dark-0%20.labelBkg%7bbackground-color:rgba(87.75%2c%2087.75%2c%2087.75%2c%200.5)%3b%7d%23mermaid-dark-0%20.cluster%20rect%7bfill:hsl(180%2c%201.5873015873%25%2c%2028.3529411765%25)%3bstroke:rgba(255%2c%20255%2c%20255%2c%200.25)%3bstroke-width:1px%3b%7d%23mermaid-dark-0%20.cluster%20text%7bfill:%23F9FFFE%3b%7d%23mermaid-dark-0%20.cluster%20span%7bcolor:%23F9FFFE%3b%7d%23mermaid-dark-0%20.node%20.collapsed-indicator%7bfill:rgba(255%2c%20255%2c%20255%2c%200.25)%3bstroke:none%3bopacity:0.6%3b%7d%23mermaid-dark-0%20.node%20.collapsed-separator%7bstroke:rgba(255%2c%20255%2c%20255%2c%200.25)%3bstroke-width:0.75px%3b%7d%23mermaid-dark-0%20div.mermaidTooltip%7bposition:absolute%3btext-align:center%3bmax-width:200px%3bpadding:2px%3bfont-family:arial%2csans-serif%3bfont-size:12px%3bbackground:hsl(20%2c%201.5873015873%25%2c%2012.3529411765%25)%3bborder:1px%20solid%20rgba(255%2c%20255%2c%20255%2c%200.25)%3bborder-radius:2px%3bpointer-events:none%3bz-index:100%3b%7d%23mermaid-dark-0%20.flowchartTitleText%7btext-anchor:middle%3bfont-size:18px%3bfill:%23ccc%3b%7d%23mermaid-dark-0%20rect.text%7bfill:none%3bstroke-width:0%3b%7d%23mermaid-dark-0%20.icon-shape%2c%23mermaid-dark-0%20.image-shape%7bbackground-color:hsl(0%2c%200%25%2c%2034.4117647059%25)%3btext-align:center%3b%7d%23mermaid-dark-0%20.icon-shape%20p%2c%23mermaid-dark-0%20.image-shape%20p%7bbackground-color:hsl(0%2c%200%25%2c%2034.4117647059%25)%3bpadding:2px%3b%7d%23mermaid-dark-0%20.icon-shape%20.label%20rect%2c%23mermaid-dark-0%20.image-shape%20.label%20rect%7bopacity:0.5%3bbackground-color:hsl(0%2c%200%25%2c%2034.4117647059%25)%3bfill:hsl(0%2c%200%25%2c%2034.4117647059%25)%3b%7d%23mermaid-dark-0%20.label-icon%7bdisplay:inline-block%3bheight:1em%3boverflow:visible%3bvertical-align:-0.125em%3b%7d%23mermaid-dark-0%20.node%20.label-icon%20path%7bfill:currentColor%3bstroke:revert%3bstroke-width:revert%3b%7d%23mermaid-dark-0%20.node%20.neo-node%7bstroke:%23ccc%3b%7d%23mermaid-dark-0%20%5bdata-look='neo'%5d.node%20rect%2c%23mermaid-dark-0%20%5bdata-look='neo'%5d.cluster%20rect%2c%23mermaid-dark-0%20%5bdata-look='neo'%5d.node%20polygon%7bstroke:url(%23mermaid-dark-0-gradient)%3bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-0%20%5bdata-look='neo'%5d.swimlane.cluster%20rect%7bfilter:none%3b%7d%23mermaid-dark-0%20%5bdata-look='neo'%5d.node%20path%7bstroke:url(%23mermaid-dark-0-gradient)%3bstroke-width:1px%3b%7d%23mermaid-dark-0%20%5bdata-look='neo'%5d.node%20.outer-path%7bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-0%20%5bdata-look='neo'%5d.node%20.neo-line%20path%7bstroke:%23ccc%3bfilter:none%3b%7d%23mermaid-dark-0%20%5bdata-look='neo'%5d.node%20circle%7bstroke:url(%23mermaid-dark-0-gradient)%3bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-0%20%5bdata-look='neo'%5d.node%20circle%20.state-start%7bfill:black%3b%7d%23mermaid-dark-0%20%5bdata-look='neo'%5d.icon-shape%20.icon%7bfill:url(%23mermaid-dark-0-gradient)%3bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-0%20%5bdata-look='neo'%5d.icon-shape%20.icon-neo%20path%7bstroke:url(%23mermaid-dark-0-gradient)%3bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-0%20:root%7b--mermaid-font-family:arial%2csans-serif%3b%7d%3c/style%3e%3cg%3e%3cmarker%20id='mermaid-dark-0_flowchart-v2-pointEnd'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='5'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='8'%20markerHeight='8'%20orient='auto'%3e%3cpath%20d='M%200%200%20L%2010%205%20L%200%2010%20z'%20class='arrowMarkerPath'%20style='stroke-width:%201%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-0_flowchart-v2-pointStart'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='4.5'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='8'%20markerHeight='8'%20orient='auto'%3e%3cpath%20d='M%200%205%20L%2010%2010%20L%2010%200%20z'%20class='arrowMarkerPath'%20style='stroke-width:%201%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-0_flowchart-v2-pointEnd-margin'%20class='marker%20flowchart-v2'%20viewBox='0%200%2011.5%2014'%20refX='11.5'%20refY='7'%20markerUnits='userSpaceOnUse'%20markerWidth='10.5'%20markerHeight='14'%20orient='auto'%3e%3cpath%20d='M%200%200%20L%2011.5%207%20L%200%2014%20z'%20class='arrowMarkerPath'%20style='stroke-width:%200%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-0_flowchart-v2-pointStart-margin'%20class='marker%20flowchart-v2'%20viewBox='0%200%2011.5%2014'%20refX='1'%20refY='7'%20markerUnits='userSpaceOnUse'%20markerWidth='11.5'%20markerHeight='14'%20orient='auto'%3e%3cpolygon%20points='0%2c7%2011.5%2c14%2011.5%2c0'%20class='arrowMarkerPath'%20style='stroke-width:%200%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-0_flowchart-v2-circleEnd'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='11'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='11'%20markerHeight='11'%20orient='auto'%3e%3ccircle%20cx='5'%20cy='5'%20r='5'%20class='arrowMarkerPath'%20style='stroke-width:%201%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-0_flowchart-v2-circleStart'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='-1'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='11'%20markerHeight='11'%20orient='auto'%3e%3ccircle%20cx='5'%20cy='5'%20r='5'%20class='arrowMarkerPath'%20style='stroke-width:%201%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-0_flowchart-v2-circleEnd-margin'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refY='5'%20refX='12.25'%20markerUnits='userSpaceOnUse'%20markerWidth='14'%20markerHeight='14'%20orient='auto'%3e%3ccircle%20cx='5'%20cy='5'%20r='5'%20class='arrowMarkerPath'%20style='stroke-width:%200%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-0_flowchart-v2-circleStart-margin'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='-2'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='14'%20markerHeight='14'%20orient='auto'%3e%3ccircle%20cx='5'%20cy='5'%20r='5'%20class='arrowMarkerPath'%20style='stroke-width:%200%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-0_flowchart-v2-crossEnd'%20class='marker%20cross%20flowchart-v2'%20viewBox='0%200%2011%2011'%20refX='12'%20refY='5.2'%20markerUnits='userSpaceOnUse'%20markerWidth='11'%20markerHeight='11'%20orient='auto'%3e%3cpath%20d='M%201%2c1%20l%209%2c9%20M%2010%2c1%20l%20-9%2c9'%20class='arrowMarkerPath'%20style='stroke-width:%202%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-0_flowchart-v2-crossStart'%20class='marker%20cross%20flowchart-v2'%20viewBox='0%200%2011%2011'%20refX='-1'%20refY='5.2'%20markerUnits='userSpaceOnUse'%20markerWidth='11'%20markerHeight='11'%20orient='auto'%3e%3cpath%20d='M%201%2c1%20l%209%2c9%20M%2010%2c1%20l%20-9%2c9'%20class='arrowMarkerPath'%20style='stroke-width:%202%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-0_flowchart-v2-crossEnd-margin'%20class='marker%20cross%20flowchart-v2'%20viewBox='0%200%2015%2015'%20refX='17.7'%20refY='7.5'%20markerUnits='userSpaceOnUse'%20markerWidth='12'%20markerHeight='12'%20orient='auto'%3e%3cpath%20d='M%201%2c1%20L%2014%2c14%20M%201%2c14%20L%2014%2c1'%20class='arrowMarkerPath'%20style='stroke-width:%202.5%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-0_flowchart-v2-crossStart-margin'%20class='marker%20cross%20flowchart-v2'%20viewBox='0%200%2015%2015'%20refX='-3.5'%20refY='7.5'%20markerUnits='userSpaceOnUse'%20markerWidth='12'%20markerHeight='12'%20orient='auto'%3e%3cpath%20d='M%201%2c1%20L%2014%2c14%20M%201%2c14%20L%2014%2c1'%20class='arrowMarkerPath'%20style='stroke-width:%202.5%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cg%20class='root'%3e%3cg%20class='clusters'%3e%3cg%20class='cluster'%20id='mermaid-dark-0-Observe'%20data-look='classic'%3e%3crect%20style=''%20x='800.2265625'%20y='860'%20width='484.578125'%20height='137.1820526123047'/%3e%3cg%20class='cluster-label'%20transform='translate(1018.515625%2c%20860)'%3e%3cforeignObject%20width='48'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3e%e5%8f%af%e8%a7%82%e6%b5%8b%e6%80%a7%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='cluster'%20id='mermaid-dark-0-Cloud'%20data-look='classic'%3e%3crect%20style=''%20x='8'%20y='602'%20width='772.2265625'%20height='395.1820526123047'/%3e%3cg%20class='cluster-label'%20transform='translate(377.66015625%2c%20602)'%3e%3cforeignObject%20width='32.90625'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3eVPC%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='cluster'%20id='mermaid-dark-0-Entry'%20data-look='classic'%3e%3crect%20style=''%20x='28.62109375'%20y='112'%20width='168.234375'%20height='416'/%3e%3cg%20class='cluster-label'%20transform='translate(88.73828125%2c%20112)'%3e%3cforeignObject%20width='48'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3e%e6%b5%81%e9%87%8f%e5%85%a5%e5%8f%a3%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='cluster'%20id='mermaid-dark-0-Runtime'%20data-look='classic'%3e%3crect%20style=''%20x='28'%20y='627'%20width='322.8203125'%20height='345.1820526123047'/%3e%3cg%20class='cluster-label'%20transform='translate(124.93359375%2c%20627)'%3e%3cforeignObject%20width='128.953125'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3eKubernetes%20/%20CCE%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cg%20class='edgePaths'%3e%3cpath%20d='M112.738%2c191L112.738%2c195.167C112.738%2c199.333%2c112.738%2c207.667%2c112.738%2c215.333C112.738%2c223%2c112.738%2c230%2c112.738%2c233.5L112.738%2c237'%20id='mermaid-dark-0-L_DNS_WAF_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_DNS_WAF_0'%20data-points='W3sieCI6MTEyLjczODI4MTI1LCJ5IjoxOTF9LHsieCI6MTEyLjczODI4MTI1LCJ5IjoyMTZ9LHsieCI6MTEyLjczODI4MTI1LCJ5IjoyNDF9XQ=='%20data-look='classic'%20marker-end='url(%23mermaid-dark-0_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M112.738%2c295L112.738%2c299.167C112.738%2c303.333%2c112.738%2c311.667%2c112.738%2c319.333C112.738%2c327%2c112.738%2c334%2c112.738%2c337.5L112.738%2c341'%20id='mermaid-dark-0-L_WAF_ELB_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_WAF_ELB_0'%20data-points='W3sieCI6MTEyLjczODI4MTI1LCJ5IjoyOTV9LHsieCI6MTEyLjczODI4MTI1LCJ5IjozMjB9LHsieCI6MTEyLjczODI4MTI1LCJ5IjozNDV9XQ=='%20data-look='classic'%20marker-end='url(%23mermaid-dark-0_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M112.738%2c399L112.738%2c403.167C112.738%2c407.333%2c112.738%2c415.667%2c112.738%2c423.333C112.738%2c431%2c112.738%2c438%2c112.738%2c441.5L112.738%2c445'%20id='mermaid-dark-0-L_ELB_APIG_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_ELB_APIG_0'%20data-points='W3sieCI6MTEyLjczODI4MTI1LCJ5IjozOTl9LHsieCI6MTEyLjczODI4MTI1LCJ5Ijo0MjR9LHsieCI6MTEyLjczODI4MTI1LCJ5Ijo0NDl9XQ=='%20data-look='classic'%20marker-end='url(%23mermaid-dark-0_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M209.289%2c706L209.289%2c710.167C209.289%2c714.333%2c209.289%2c722.667%2c209.289%2c730.333C209.289%2c738%2c209.289%2c745%2c209.289%2c748.5L209.289%2c752'%20id='mermaid-dark-0-L_Gateway_ServiceA_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_Gateway_ServiceA_0'%20data-points='W3sieCI6MjA5LjI4OTA2MjUsInkiOjcwNn0seyJ4IjoyMDkuMjg5MDYyNSwieSI6NzMxfSx7IngiOjIwOS4yODkwNjI1LCJ5Ijo3NTZ9XQ=='%20data-look='classic'%20marker-end='url(%23mermaid-dark-0_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M166.684%2c810L160.109%2c814.167C153.534%2c818.333%2c140.384%2c826.667%2c133.809%2c835C127.234%2c843.333%2c127.234%2c851.667%2c127.234%2c860.015C127.234%2c868.364%2c127.234%2c876.727%2c127.234%2c880.909L127.234%2c885.091'%20id='mermaid-dark-0-L_ServiceA_ServiceB_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_ServiceA_ServiceB_0'%20data-points='W3sieCI6MTY2LjY4Mzc0Mzk5MDM4NDYsInkiOjgxMH0seyJ4IjoxMjcuMjM0Mzc1LCJ5Ijo4MzV9LHsieCI6MTI3LjIzNDM3NSwieSI6ODYwfSx7IngiOjEyNy4yMzQzNzUsInkiOjg4OS4wOTEwMjYzMDYxNTIzfV0='%20data-look='classic'%20marker-end='url(%23mermaid-dark-0_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M112.738%2c62L112.738%2c66.167C112.738%2c70.333%2c112.738%2c78.667%2c112.738%2c87C112.738%2c95.333%2c112.738%2c103.667%2c112.738%2c111.333C112.738%2c119%2c112.738%2c126%2c112.738%2c129.5L112.738%2c133'%20id='mermaid-dark-0-L_Client_DNS_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_Client_DNS_0'%20data-points='W3sieCI6MTEyLjczODI4MTI1LCJ5Ijo2Mn0seyJ4IjoxMTIuNzM4MjgxMjUsInkiOjg3fSx7IngiOjExMi43MzgyODEyNSwieSI6MTEyfSx7IngiOjExMi43MzgyODEyNSwieSI6MTM3fV0='%20data-look='classic'%20marker-end='url(%23mermaid-dark-0_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M112.738%2c503L112.738%2c507.167C112.738%2c511.333%2c112.738%2c519.667%2c112.738%2c530C112.738%2c540.333%2c112.738%2c552.667%2c112.738%2c565C112.738%2c577.333%2c112.738%2c589.667%2c112.738%2c600C112.738%2c610.333%2c112.738%2c618.667%2c119.888%2c626.684C127.037%2c634.701%2c141.336%2c642.402%2c148.486%2c646.253L155.635%2c650.103'%20id='mermaid-dark-0-L_APIG_Gateway_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_APIG_Gateway_0'%20data-points='W3sieCI6MTEyLjczODI4MTI1LCJ5Ijo1MDN9LHsieCI6MTEyLjczODI4MTI1LCJ5Ijo1Mjh9LHsieCI6MTEyLjczODI4MTI1LCJ5Ijo1NjV9LHsieCI6MTEyLjczODI4MTI1LCJ5Ijo2MDJ9LHsieCI6MTEyLjczODI4MTI1LCJ5Ijo2Mjd9LHsieCI6MTU5LjE1NjkyNjA4MTczMDc3LCJ5Ijo2NTJ9XQ=='%20data-look='classic'%20marker-end='url(%23mermaid-dark-0_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M177.068%2c810L172.096%2c814.167C167.124%2c818.333%2c157.179%2c826.667%2c152.207%2c835C147.234%2c843.333%2c147.234%2c851.667%2c186.347%2c864.176C225.459%2c876.685%2c303.684%2c893.37%2c342.796%2c901.712L381.908%2c910.054'%20id='mermaid-dark-0-L_ServiceA_RDS_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_ServiceA_RDS_0'%20data-points='W3sieCI6MTc3LjA2ODM1OTM3NSwieSI6ODEwfSx7IngiOjE0Ny4yMzQzNzUsInkiOjgzNX0seyJ4IjoxNDcuMjM0Mzc1LCJ5Ijo4NjB9LHsieCI6Mzg1LjgyMDMxMjUsInkiOjkxMC44ODg2Nzk4NDgwMDE3fV0='%20data-look='classic'%20marker-end='url(%23mermaid-dark-0_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M187.453%2c810L184.083%2c814.167C180.713%2c818.333%2c173.974%2c826.667%2c170.604%2c835C167.234%2c843.333%2c167.234%2c851.667%2c219.471%2c864.318C271.707%2c876.97%2c376.18%2c893.939%2c428.417%2c902.424L480.653%2c910.909'%20id='mermaid-dark-0-L_ServiceA_Redis_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_ServiceA_Redis_0'%20data-points='W3sieCI6MTg3LjQ1Mjk3NDc1OTYxNTQsInkiOjgxMH0seyJ4IjoxNjcuMjM0Mzc1LCJ5Ijo4MzV9LHsieCI6MTY3LjIzNDM3NSwieSI6ODYwfSx7IngiOjQ4NC42MDE1NjI1LCJ5Ijo5MTEuNTUwNTQ3NzYyMTUwOH1d'%20data-look='classic'%20marker-end='url(%23mermaid-dark-0_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M197.838%2c810L196.07%2c814.167C194.303%2c818.333%2c190.769%2c826.667%2c189.002%2c835C187.234%2c843.333%2c187.234%2c851.667%2c253.786%2c864.49C320.337%2c877.313%2c453.439%2c894.625%2c519.99%2c903.282L586.541%2c911.938'%20id='mermaid-dark-0-L_ServiceA_Kafka_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_ServiceA_Kafka_0'%20data-points='W3sieCI6MTk3LjgzNzU5MDE0NDIzMDc3LCJ5Ijo4MTB9LHsieCI6MTg3LjIzNDM3NSwieSI6ODM1fSx7IngiOjE4Ny4yMzQzNzUsInkiOjg2MH0seyJ4Ijo1OTAuNTA3ODEyNSwieSI6OTEyLjQ1NDEyMzEwMDQyNTR9XQ=='%20data-look='classic'%20marker-end='url(%23mermaid-dark-0_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M228.393%2c810L231.341%2c814.167C234.289%2c818.333%2c240.186%2c826.667%2c243.134%2c835C246.082%2c843.333%2c246.082%2c851.667%2c320.478%2c864.623C394.874%2c877.58%2c543.666%2c895.159%2c618.061%2c903.949L692.457%2c912.739'%20id='mermaid-dark-0-L_ServiceA_OBS_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_ServiceA_OBS_0'%20data-points='W3sieCI6MjI4LjM5MzEwMzk2NjM0NjE2LCJ5Ijo4MTB9LHsieCI6MjQ2LjA4MjAzMTI1LCJ5Ijo4MzV9LHsieCI6MjQ2LjA4MjAzMTI1LCJ5Ijo4NjB9LHsieCI6Njk2LjQyOTY4NzUsInkiOjkxMy4yMDgzNjI0NjE5MjQ1fV0='%20data-look='classic'%20marker-end='url(%23mermaid-dark-0_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M238.778%2c810L243.328%2c814.167C247.879%2c818.333%2c256.981%2c826.667%2c261.531%2c835C266.082%2c843.333%2c266.082%2c851.667%2c360.275%2c864.288C454.469%2c876.909%2c642.856%2c893.818%2c737.049%2c902.272L831.243%2c910.727'%20id='mermaid-dark-0-L_ServiceA_Metrics_0'%20class='edge-thickness-normal%20edge-pattern-dotted%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_ServiceA_Metrics_0'%20data-points='W3sieCI6MjM4Ljc3NzcxOTM1MDk2MTU1LCJ5Ijo4MTB9LHsieCI6MjY2LjA4MjAzMTI1LCJ5Ijo4MzV9LHsieCI6MjY2LjA4MjAzMTI1LCJ5Ijo4NjB9LHsieCI6ODM1LjIyNjU2MjUsInkiOjkxMS4wODQzMDc2NjA0ODkxfV0='%20data-look='classic'%20marker-end='url(%23mermaid-dark-0_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M249.162%2c810L255.316%2c814.167C261.469%2c818.333%2c273.775%2c826.667%2c279.929%2c835C286.082%2c843.333%2c286.082%2c851.667%2c403.868%2c864.549C521.655%2c877.431%2c757.227%2c894.861%2c875.014%2c903.577L992.8%2c912.292'%20id='mermaid-dark-0-L_ServiceA_Logs_0'%20class='edge-thickness-normal%20edge-pattern-dotted%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_ServiceA_Logs_0'%20data-points='W3sieCI6MjQ5LjE2MjMzNDczNTU3NjksInkiOjgxMH0seyJ4IjoyODYuMDgyMDMxMjUsInkiOjgzNX0seyJ4IjoyODYuMDgyMDMxMjUsInkiOjg2MH0seyJ4Ijo5OTYuNzg5MDYyNSwieSI6OTEyLjU4NzM0MjM0MzI5OTJ9XQ=='%20data-look='classic'%20marker-end='url(%23mermaid-dark-0_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M259.547%2c810L267.303%2c814.167C275.059%2c818.333%2c290.57%2c826.667%2c298.326%2c835C306.082%2c843.333%2c306.082%2c851.667%2c444.652%2c864.571C583.221%2c877.475%2c860.361%2c894.95%2c998.93%2c903.687L1137.5%2c912.425'%20id='mermaid-dark-0-L_ServiceA_Traces_0'%20class='edge-thickness-normal%20edge-pattern-dotted%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_ServiceA_Traces_0'%20data-points='W3sieCI6MjU5LjU0Njk1MDEyMDE5MjMsInkiOjgxMH0seyJ4IjozMDYuMDgyMDMxMjUsInkiOjgzNX0seyJ4IjozMDYuMDgyMDMxMjUsInkiOjg2MH0seyJ4IjoxMTQxLjQ5MjE4NzUsInkiOjkxMi42NzYyMzk0ODE4NjM0fV0='%20data-look='classic'%20marker-end='url(%23mermaid-dark-0_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M276.082%2c503L276.082%2c507.167C276.082%2c511.333%2c276.082%2c519.667%2c276.082%2c530C276.082%2c540.333%2c276.082%2c552.667%2c276.082%2c564.333C276.082%2c576%2c276.082%2c587%2c276.082%2c592.5L276.082%2c598'%20id='mermaid-dark-0-L_IAM_Cloud_0'%20class='edge-thickness-normal%20edge-pattern-dotted%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_IAM_Cloud_0'%20data-points='W3sieCI6Mjc2LjA4MjAzMTI1LCJ5Ijo1MDN9LHsieCI6Mjc2LjA4MjAzMTI1LCJ5Ijo1Mjh9LHsieCI6Mjc2LjA4MjAzMTI1LCJ5Ijo1NjV9LHsieCI6Mjc2LjA4MjAzMTI1LCJ5Ijo2MDJ9LHsieCI6Mjc2LjA4MjAzMTI1LCJ5Ijo2Mjd9LHsieCI6MjU4Ljk4NTA4MDA3NzkzNDEsInkiOjYwMi4wMDAwMDc2MjkzOTQ1fV0='%20data-look='classic'%20marker-end='url(%23mermaid-dark-0_flowchart-v2-pointEnd)'/%3e%3c/g%3e%3cg%20class='edgeLabels'%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_DNS_WAF_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_WAF_ELB_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_ELB_APIG_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_Gateway_ServiceA_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_ServiceA_ServiceB_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_Client_DNS_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_APIG_Gateway_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_ServiceA_RDS_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_ServiceA_Redis_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_ServiceA_Kafka_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_ServiceA_OBS_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_ServiceA_Metrics_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_ServiceA_Logs_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_ServiceA_Traces_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%20transform='translate(276.08203%2c%20552.5)'%3e%3cg%20class='label'%20data-id='L_IAM_Cloud_0'%20transform='translate(-30%2c%20-12)'%3e%3cforeignObject%20width='60'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3cp%3e%e8%ba%ab%e4%bb%bd%e4%b8%8e%e6%8e%88%e6%9d%83%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cg%20class='nodes'%3e%3cg%20class='node%20default'%20id='mermaid-dark-0-flowchart-Client-0'%20data-look='classic'%20transform='translate(112.73828125%2c%2035)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-66.671875'%20y='-27'%20width='133.34375'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-36.671875%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='73.34375'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3e%e7%94%a8%e6%88%b7%20/%20%e5%ae%a2%e6%88%b7%e7%ab%af%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-0-flowchart-DNS-1'%20data-look='classic'%20transform='translate(112.73828125%2c%20164)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-46.890625'%20y='-27'%20width='93.78125'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-16.890625%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='33.78125'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3eDNS%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-0-flowchart-WAF-2'%20data-look='classic'%20transform='translate(112.73828125%2c%20268)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-47.4765625'%20y='-27'%20width='94.953125'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-17.4765625%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='34.953125'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3eWAF%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-0-flowchart-ELB-3'%20data-look='classic'%20transform='translate(112.73828125%2c%20372)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-45.125'%20y='-27'%20width='90.25'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-15.125%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='30.25'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3eELB%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-0-flowchart-APIG-4'%20data-look='classic'%20transform='translate(112.73828125%2c%20476)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-49.1171875'%20y='-27'%20width='98.234375'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-19.1171875%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='38.234375'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3eAPIG%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-0-flowchart-Gateway-5'%20data-look='classic'%20transform='translate(209.2890625%2c%20679)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-94.4765625'%20y='-27'%20width='188.953125'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-64.4765625%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='128.953125'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3eIngress%20/%20Gateway%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-0-flowchart-ServiceA-6'%20data-look='classic'%20transform='translate(209.2890625%2c%20783)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-63.796875'%20y='-27'%20width='127.59375'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-33.796875%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='67.59375'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3eService%20A%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-0-flowchart-ServiceB-7'%20data-look='classic'%20transform='translate(127.234375%2c%20916.0910263061523)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-64.234375'%20y='-27'%20width='128.46875'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-34.234375%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='68.46875'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3eService%20B%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-0-flowchart-RDS-11'%20data-look='classic'%20transform='translate(410.2109375%2c%20916.0910263061523)'%3e%3cpath%20d='M0%2c7.01762272972487%20a24.390625%2c7.01762272972487%200%2c0%2c0%2048.78125%2c0%20a24.390625%2c7.01762272972487%200%2c0%2c0%20-48.78125%2c0%20l0%2c46.01762272972487%20a24.390625%2c7.01762272972487%200%2c0%2c0%2048.78125%2c0%20l0%2c-46.01762272972487'%20class='basic%20label-container%20outer-path'%20style=''%20transform='translate(-24.390625%2c%20-30.026434094587305)'/%3e%3cg%20class='label'%20style=''%20transform='translate(-16.890625%2c%20-2)'%3e%3crect/%3e%3cforeignObject%20width='33.78125'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3eRDS%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-0-flowchart-Redis-12'%20data-look='classic'%20transform='translate(512.5546875%2c%20916.0910263061523)'%3e%3cpath%20d='M0%2c7.725859388495422%20a27.953125%2c7.725859388495422%200%2c0%2c0%2055.90625%2c0%20a27.953125%2c7.725859388495422%200%2c0%2c0%20-55.90625%2c0%20l0%2c46.72585938849542%20a27.953125%2c7.725859388495422%200%2c0%2c0%2055.90625%2c0%20l0%2c-46.72585938849542'%20class='basic%20label-container%20outer-path'%20style=''%20transform='translate(-27.953125%2c%20-31.088789082743133)'/%3e%3cg%20class='label'%20style=''%20transform='translate(-20.453125%2c%20-2)'%3e%3crect/%3e%3cforeignObject%20width='40.90625'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3eRedis%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-0-flowchart-Kafka-13'%20data-look='classic'%20transform='translate(618.46875%2c%20916.0910263061523)'%3e%3cpath%20d='M0%2c7.727351239312549%20a27.9609375%2c7.727351239312549%200%2c0%2c0%2055.921875%2c0%20a27.9609375%2c7.727351239312549%200%2c0%2c0%20-55.921875%2c0%20l0%2c46.72735123931255%20a27.9609375%2c7.727351239312549%200%2c0%2c0%2055.921875%2c0%20l0%2c-46.72735123931255'%20class='basic%20label-container%20outer-path'%20style=''%20transform='translate(-27.9609375%2c%20-31.091026858968824)'/%3e%3cg%20class='label'%20style=''%20transform='translate(-20.4609375%2c%20-2)'%3e%3crect/%3e%3cforeignObject%20width='40.921875'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3eKafka%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-0-flowchart-OBS-14'%20data-look='classic'%20transform='translate(720.828125%2c%20916.0910263061523)'%3e%3cpath%20d='M0%2c7.019239413827204%20a24.3984375%2c7.019239413827204%200%2c0%2c0%2048.796875%2c0%20a24.3984375%2c7.019239413827204%200%2c0%2c0%20-48.796875%2c0%20l0%2c46.01923941382721%20a24.3984375%2c7.019239413827204%200%2c0%2c0%2048.796875%2c0%20l0%2c-46.01923941382721'%20class='basic%20label-container%20outer-path'%20style=''%20transform='translate(-24.3984375%2c%20-30.028859120740808)'/%3e%3cg%20class='label'%20style=''%20transform='translate(-16.8984375%2c%20-2)'%3e%3crect/%3e%3cforeignObject%20width='33.796875'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3eOBS%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-0-flowchart-Metrics-15'%20data-look='classic'%20transform='translate(891.0078125%2c%20916.0910263061523)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-55.78125'%20y='-27'%20width='111.5625'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-25.78125%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='51.5625'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3eMetrics%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-0-flowchart-Logs-16'%20data-look='classic'%20transform='translate(1044.140625%2c%20916.0910263061523)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-47.3515625'%20y='-27'%20width='94.703125'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-17.3515625%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='34.703125'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3eLogs%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-0-flowchart-Traces-17'%20data-look='classic'%20transform='translate(1195.6484375%2c%20916.0910263061523)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-54.15625'%20y='-27'%20width='108.3125'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-24.15625%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='48.3125'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3eTraces%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-0-flowchart-IAM-18'%20data-look='classic'%20transform='translate(276.08203125%2c%20476)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-44.2265625'%20y='-27'%20width='88.453125'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-14.2265625%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='28.453125'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3eIAM%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cdefs%3e%3cfilter%20id='mermaid-dark-0-drop-shadow'%20height='130%25'%20width='130%25'%3e%3cfeDropShadow%20dx='4'%20dy='4'%20stdDeviation='0'%20flood-opacity='0.06'%20flood-color='white'/%3e%3c/filter%3e%3c/defs%3e%3cdefs%3e%3cfilter%20id='mermaid-dark-0-drop-shadow-small'%20height='150%25'%20width='150%25'%3e%3cfeDropShadow%20dx='2'%20dy='2'%20stdDeviation='0'%20flood-opacity='0.06'%20flood-color='white'/%3e%3c/filter%3e%3c/defs%3e%3clinearGradient%20id='mermaid-dark-0-gradient'%20gradientUnits='objectBoundingBox'%20x1='0%25'%20y1='0%25'%20x2='100%25'%20y2='0%25'%3e%3cstop%20offset='0%25'%20stop-color='%23cccccc'%20stop-opacity='1'/%3e%3cstop%20offset='100%25'%20stop-color='hsl(180%2c%200%25%2c%2018.3529411765%25)'%20stop-opacity='1'/%3e%3c/linearGradient%3e%3c/svg%3e)
这张图不是某个系统的固定方案,而是一张定位技术的地图。例如,Helm 位于 交付流程与 Kubernetes 之间;ELB 位于外部流量入口;Service Mesh 处理集群内 服务通信;Kafka 连接事件生产者和异步消费者。
二、物理边界、身份与网络基础
Region 与 AZ:资源部署在哪里
Region(区域)是云厂商在某个地理区域建设的一组数据中心基础设施,通常构成 资源规划、网络时延、数据合规和计费的重要边界。选择 Region 时需要考虑用户 位置、服务可用性、合规要求、跨区域传输成本和容灾目标。
AZ(Availability Zone,可用区)是 Region 内相对独立的故障域,通常具有独立 的供电和网络设施。生产系统常采用“同 Region、多 AZ”的部署方式,在控制时延 和成本的同时,降低单个数据中心故障的影响。
%3btext-align:center%3b%7d%23mermaid-1 .edgeLabel p%7bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3b%7d%23mermaid-1 .edgeLabel rect%7bopacity:0.5%3bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bfill:rgba(232%2c232%2c232%2c 0.8)%3b%7d%23mermaid-1 .labelBkg%7bbackground-color:rgba(232%2c 232%2c 232%2c 0.5)%3b%7d%23mermaid-1 .cluster rect%7bfill:%23ffffde%3bstroke:%23aaaa33%3bstroke-width:1px%3b%7d%23mermaid-1 .cluster text%7bfill:%23333%3b%7d%23mermaid-1 .cluster span%7bcolor:%23333%3b%7d%23mermaid-1 .node .collapsed-indicator%7bfill:%23aaaa33%3bstroke:none%3bopacity:0.6%3b%7d%23mermaid-1 .node .collapsed-separator%7bstroke:%23aaaa33%3bstroke-width:0.75px%3b%7d%23mermaid-1 div.mermaidTooltip%7bposition:absolute%3btext-align:center%3bmax-width:200px%3bpadding:2px%3bfont-family:arial%2csans-serif%3bfont-size:12px%3bbackground:hsl(80%2c 100%25%2c 96.2745098039%25)%3bborder:1px solid %23aaaa33%3bborder-radius:2px%3bpointer-events:none%3bz-index:100%3b%7d%23mermaid-1 .flowchartTitleText%7btext-anchor:middle%3bfont-size:18px%3bfill:%23333%3b%7d%23mermaid-1 rect.text%7bfill:none%3bstroke-width:0%3b%7d%23mermaid-1 .icon-shape%2c%23mermaid-1 .image-shape%7bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3btext-align:center%3b%7d%23mermaid-1 .icon-shape p%2c%23mermaid-1 .image-shape p%7bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bpadding:2px%3b%7d%23mermaid-1 .icon-shape .label rect%2c%23mermaid-1 .image-shape .label rect%7bopacity:0.5%3bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bfill:rgba(232%2c232%2c232%2c 0.8)%3b%7d%23mermaid-1 .label-icon%7bdisplay:inline-block%3bheight:1em%3boverflow:visible%3bvertical-align:-0.125em%3b%7d%23mermaid-1 .node .label-icon path%7bfill:currentColor%3bstroke:revert%3bstroke-width:revert%3b%7d%23mermaid-1 .node .neo-node%7bstroke:%239370DB%3b%7d%23mermaid-1 %5bdata-look='neo'%5d.node rect%2c%23mermaid-1 %5bdata-look='neo'%5d.cluster rect%2c%23mermaid-1 %5bdata-look='neo'%5d.node polygon%7bstroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-1 %5bdata-look='neo'%5d.swimlane.cluster rect%7bfilter:none%3b%7d%23mermaid-1 %5bdata-look='neo'%5d.node path%7bstroke:%239370DB%3bstroke-width:1px%3b%7d%23mermaid-1 %5bdata-look='neo'%5d.node .outer-path%7bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-1 %5bdata-look='neo'%5d.node .neo-line path%7bstroke:%239370DB%3bfilter:none%3b%7d%23mermaid-1 %5bdata-look='neo'%5d.node circle%7bstroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-1 %5bdata-look='neo'%5d.node circle .state-start%7bfill:black%3b%7d%23mermaid-1 %5bdata-look='neo'%5d.icon-shape .icon%7bfill:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-1 %5bdata-look='neo'%5d.icon-shape .icon-neo path%7bstroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-1 :root%7b--mermaid-font-family:arial%2csans-serif%3b%7d%3c/style%3e%3cg%3e%3cmarker id='mermaid-1_flowchart-v2-pointEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'%3e%3cpath d='M 0 0 L 10 5 L 0 10 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-1_flowchart-v2-pointStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='4.5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'%3e%3cpath d='M 0 5 L 10 10 L 10 0 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-1_flowchart-v2-pointEnd-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='11.5' refY='7' markerUnits='userSpaceOnUse' markerWidth='10.5' markerHeight='14' orient='auto'%3e%3cpath d='M 0 0 L 11.5 7 L 0 14 z' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-1_flowchart-v2-pointStart-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='1' refY='7' markerUnits='userSpaceOnUse' markerWidth='11.5' markerHeight='14' orient='auto'%3e%3cpolygon points='0%2c7 11.5%2c14 11.5%2c0' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-1_flowchart-v2-circleEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='11' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-1_flowchart-v2-circleStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-1' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-1_flowchart-v2-circleEnd-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refY='5' refX='12.25' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-1_flowchart-v2-circleStart-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-2' refY='5' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-1_flowchart-v2-crossEnd' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='12' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3cpath d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-1_flowchart-v2-crossStart' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='-1' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3cpath d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-1_flowchart-v2-crossEnd-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='17.7' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'%3e%3cpath d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-1_flowchart-v2-crossStart-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='-3.5' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'%3e%3cpath d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cg class='root'%3e%3cg class='clusters'/%3e%3cg class='edgePaths'%3e%3cpath d='M145.117%2c54.833L130.155%2c60.194C115.193%2c65.555%2c85.268%2c76.278%2c70.306%2c85.139C55.344%2c94%2c55.344%2c101%2c55.344%2c104.5L55.344%2c108' id='mermaid-1-L_Region_AZ1_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_Region_AZ1_0' data-points='W3sieCI6MTQ1LjExNzE4NzUsInkiOjU0LjgzMzExODAwMTcyMjY1fSx7IngiOjU1LjM0Mzc1LCJ5Ijo4N30seyJ4Ijo1NS4zNDM3NSwieSI6MTEyfV0=' data-look='classic' marker-end='url(%23mermaid-1_flowchart-v2-pointEnd)'/%3e%3cpath d='M200.469%2c62L200.469%2c66.167C200.469%2c70.333%2c200.469%2c78.667%2c200.469%2c86.333C200.469%2c94%2c200.469%2c101%2c200.469%2c104.5L200.469%2c108' id='mermaid-1-L_Region_AZ2_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_Region_AZ2_0' data-points='W3sieCI6MjAwLjQ2ODc1LCJ5Ijo2Mn0seyJ4IjoyMDAuNDY4NzUsInkiOjg3fSx7IngiOjIwMC40Njg3NSwieSI6MTEyfV0=' data-look='classic' marker-end='url(%23mermaid-1_flowchart-v2-pointEnd)'/%3e%3cpath d='M255.82%2c54.713L270.93%2c60.094C286.039%2c65.475%2c316.258%2c76.238%2c331.367%2c85.119C346.477%2c94%2c346.477%2c101%2c346.477%2c104.5L346.477%2c108' id='mermaid-1-L_Region_AZ3_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_Region_AZ3_0' data-points='W3sieCI6MjU1LjgyMDMxMjUsInkiOjU0LjcxMzIwMDI3ODIzODUzfSx7IngiOjM0Ni40NzY1NjI1LCJ5Ijo4N30seyJ4IjozNDYuNDc2NTYyNSwieSI6MTEyfV0=' data-look='classic' marker-end='url(%23mermaid-1_flowchart-v2-pointEnd)'/%3e%3c/g%3e%3cg class='edgeLabels'%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_Region_AZ1_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_Region_AZ2_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_Region_AZ3_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cg class='nodes'%3e%3cg class='node default' id='mermaid-1-flowchart-Region-0' data-look='classic' transform='translate(200.46875%2c 35)'%3e%3crect class='basic label-container' style='' x='-55.3515625' y='-27' width='110.703125' height='54'/%3e%3cg class='label' style='' transform='translate(-25.3515625%2c -12)'%3e%3crect/%3e%3cforeignObject width='50.703125' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eRegion%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-1-flowchart-AZ1-2' data-look='classic' transform='translate(55.34375%2c 139)'%3e%3crect class='basic label-container' style='' x='-47.34375' y='-27' width='94.6875' height='54'/%3e%3cg class='label' style='' transform='translate(-17.34375%2c -12)'%3e%3crect/%3e%3cforeignObject width='34.6875' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eAZ A%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-1-flowchart-AZ2-4' data-look='classic' transform='translate(200.46875%2c 139)'%3e%3crect class='basic label-container' style='' x='-47.78125' y='-27' width='95.5625' height='54'/%3e%3cg class='label' style='' transform='translate(-17.78125%2c -12)'%3e%3crect/%3e%3cforeignObject width='35.5625' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eAZ B%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-1-flowchart-AZ3-6' data-look='classic' transform='translate(346.4765625%2c 139)'%3e%3crect class='basic label-container' style='' x='-48.2265625' y='-27' width='96.453125' height='54'/%3e%3cg class='label' style='' transform='translate(-18.2265625%2c -12)'%3e%3crect/%3e%3cforeignObject width='36.453125' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eAZ C%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cdefs%3e%3cfilter id='mermaid-1-drop-shadow' height='130%25' width='130%25'%3e%3cfeDropShadow dx='4' dy='4' stdDeviation='0' flood-opacity='0.06' flood-color='black'/%3e%3c/filter%3e%3c/defs%3e%3cdefs%3e%3cfilter id='mermaid-1-drop-shadow-small' height='150%25' width='150%25'%3e%3cfeDropShadow dx='2' dy='2' stdDeviation='0' flood-opacity='0.06' flood-color='black'/%3e%3c/filter%3e%3c/defs%3e%3c/svg%3e)
%3btext-align:center%3b%7d%23mermaid-dark-1%20.edgeLabel%20p%7bbackground-color:hsl(0%2c%200%25%2c%2034.4117647059%25)%3b%7d%23mermaid-dark-1%20.edgeLabel%20rect%7bopacity:0.5%3bbackground-color:hsl(0%2c%200%25%2c%2034.4117647059%25)%3bfill:hsl(0%2c%200%25%2c%2034.4117647059%25)%3b%7d%23mermaid-dark-1%20.labelBkg%7bbackground-color:rgba(87.75%2c%2087.75%2c%2087.75%2c%200.5)%3b%7d%23mermaid-dark-1%20.cluster%20rect%7bfill:hsl(180%2c%201.5873015873%25%2c%2028.3529411765%25)%3bstroke:rgba(255%2c%20255%2c%20255%2c%200.25)%3bstroke-width:1px%3b%7d%23mermaid-dark-1%20.cluster%20text%7bfill:%23F9FFFE%3b%7d%23mermaid-dark-1%20.cluster%20span%7bcolor:%23F9FFFE%3b%7d%23mermaid-dark-1%20.node%20.collapsed-indicator%7bfill:rgba(255%2c%20255%2c%20255%2c%200.25)%3bstroke:none%3bopacity:0.6%3b%7d%23mermaid-dark-1%20.node%20.collapsed-separator%7bstroke:rgba(255%2c%20255%2c%20255%2c%200.25)%3bstroke-width:0.75px%3b%7d%23mermaid-dark-1%20div.mermaidTooltip%7bposition:absolute%3btext-align:center%3bmax-width:200px%3bpadding:2px%3bfont-family:arial%2csans-serif%3bfont-size:12px%3bbackground:hsl(20%2c%201.5873015873%25%2c%2012.3529411765%25)%3bborder:1px%20solid%20rgba(255%2c%20255%2c%20255%2c%200.25)%3bborder-radius:2px%3bpointer-events:none%3bz-index:100%3b%7d%23mermaid-dark-1%20.flowchartTitleText%7btext-anchor:middle%3bfont-size:18px%3bfill:%23ccc%3b%7d%23mermaid-dark-1%20rect.text%7bfill:none%3bstroke-width:0%3b%7d%23mermaid-dark-1%20.icon-shape%2c%23mermaid-dark-1%20.image-shape%7bbackground-color:hsl(0%2c%200%25%2c%2034.4117647059%25)%3btext-align:center%3b%7d%23mermaid-dark-1%20.icon-shape%20p%2c%23mermaid-dark-1%20.image-shape%20p%7bbackground-color:hsl(0%2c%200%25%2c%2034.4117647059%25)%3bpadding:2px%3b%7d%23mermaid-dark-1%20.icon-shape%20.label%20rect%2c%23mermaid-dark-1%20.image-shape%20.label%20rect%7bopacity:0.5%3bbackground-color:hsl(0%2c%200%25%2c%2034.4117647059%25)%3bfill:hsl(0%2c%200%25%2c%2034.4117647059%25)%3b%7d%23mermaid-dark-1%20.label-icon%7bdisplay:inline-block%3bheight:1em%3boverflow:visible%3bvertical-align:-0.125em%3b%7d%23mermaid-dark-1%20.node%20.label-icon%20path%7bfill:currentColor%3bstroke:revert%3bstroke-width:revert%3b%7d%23mermaid-dark-1%20.node%20.neo-node%7bstroke:%23ccc%3b%7d%23mermaid-dark-1%20%5bdata-look='neo'%5d.node%20rect%2c%23mermaid-dark-1%20%5bdata-look='neo'%5d.cluster%20rect%2c%23mermaid-dark-1%20%5bdata-look='neo'%5d.node%20polygon%7bstroke:url(%23mermaid-dark-1-gradient)%3bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-1%20%5bdata-look='neo'%5d.swimlane.cluster%20rect%7bfilter:none%3b%7d%23mermaid-dark-1%20%5bdata-look='neo'%5d.node%20path%7bstroke:url(%23mermaid-dark-1-gradient)%3bstroke-width:1px%3b%7d%23mermaid-dark-1%20%5bdata-look='neo'%5d.node%20.outer-path%7bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-1%20%5bdata-look='neo'%5d.node%20.neo-line%20path%7bstroke:%23ccc%3bfilter:none%3b%7d%23mermaid-dark-1%20%5bdata-look='neo'%5d.node%20circle%7bstroke:url(%23mermaid-dark-1-gradient)%3bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-1%20%5bdata-look='neo'%5d.node%20circle%20.state-start%7bfill:black%3b%7d%23mermaid-dark-1%20%5bdata-look='neo'%5d.icon-shape%20.icon%7bfill:url(%23mermaid-dark-1-gradient)%3bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-1%20%5bdata-look='neo'%5d.icon-shape%20.icon-neo%20path%7bstroke:url(%23mermaid-dark-1-gradient)%3bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-1%20:root%7b--mermaid-font-family:arial%2csans-serif%3b%7d%3c/style%3e%3cg%3e%3cmarker%20id='mermaid-dark-1_flowchart-v2-pointEnd'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='5'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='8'%20markerHeight='8'%20orient='auto'%3e%3cpath%20d='M%200%200%20L%2010%205%20L%200%2010%20z'%20class='arrowMarkerPath'%20style='stroke-width:%201%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-1_flowchart-v2-pointStart'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='4.5'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='8'%20markerHeight='8'%20orient='auto'%3e%3cpath%20d='M%200%205%20L%2010%2010%20L%2010%200%20z'%20class='arrowMarkerPath'%20style='stroke-width:%201%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-1_flowchart-v2-pointEnd-margin'%20class='marker%20flowchart-v2'%20viewBox='0%200%2011.5%2014'%20refX='11.5'%20refY='7'%20markerUnits='userSpaceOnUse'%20markerWidth='10.5'%20markerHeight='14'%20orient='auto'%3e%3cpath%20d='M%200%200%20L%2011.5%207%20L%200%2014%20z'%20class='arrowMarkerPath'%20style='stroke-width:%200%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-1_flowchart-v2-pointStart-margin'%20class='marker%20flowchart-v2'%20viewBox='0%200%2011.5%2014'%20refX='1'%20refY='7'%20markerUnits='userSpaceOnUse'%20markerWidth='11.5'%20markerHeight='14'%20orient='auto'%3e%3cpolygon%20points='0%2c7%2011.5%2c14%2011.5%2c0'%20class='arrowMarkerPath'%20style='stroke-width:%200%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-1_flowchart-v2-circleEnd'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='11'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='11'%20markerHeight='11'%20orient='auto'%3e%3ccircle%20cx='5'%20cy='5'%20r='5'%20class='arrowMarkerPath'%20style='stroke-width:%201%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-1_flowchart-v2-circleStart'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='-1'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='11'%20markerHeight='11'%20orient='auto'%3e%3ccircle%20cx='5'%20cy='5'%20r='5'%20class='arrowMarkerPath'%20style='stroke-width:%201%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-1_flowchart-v2-circleEnd-margin'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refY='5'%20refX='12.25'%20markerUnits='userSpaceOnUse'%20markerWidth='14'%20markerHeight='14'%20orient='auto'%3e%3ccircle%20cx='5'%20cy='5'%20r='5'%20class='arrowMarkerPath'%20style='stroke-width:%200%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-1_flowchart-v2-circleStart-margin'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='-2'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='14'%20markerHeight='14'%20orient='auto'%3e%3ccircle%20cx='5'%20cy='5'%20r='5'%20class='arrowMarkerPath'%20style='stroke-width:%200%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-1_flowchart-v2-crossEnd'%20class='marker%20cross%20flowchart-v2'%20viewBox='0%200%2011%2011'%20refX='12'%20refY='5.2'%20markerUnits='userSpaceOnUse'%20markerWidth='11'%20markerHeight='11'%20orient='auto'%3e%3cpath%20d='M%201%2c1%20l%209%2c9%20M%2010%2c1%20l%20-9%2c9'%20class='arrowMarkerPath'%20style='stroke-width:%202%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-1_flowchart-v2-crossStart'%20class='marker%20cross%20flowchart-v2'%20viewBox='0%200%2011%2011'%20refX='-1'%20refY='5.2'%20markerUnits='userSpaceOnUse'%20markerWidth='11'%20markerHeight='11'%20orient='auto'%3e%3cpath%20d='M%201%2c1%20l%209%2c9%20M%2010%2c1%20l%20-9%2c9'%20class='arrowMarkerPath'%20style='stroke-width:%202%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-1_flowchart-v2-crossEnd-margin'%20class='marker%20cross%20flowchart-v2'%20viewBox='0%200%2015%2015'%20refX='17.7'%20refY='7.5'%20markerUnits='userSpaceOnUse'%20markerWidth='12'%20markerHeight='12'%20orient='auto'%3e%3cpath%20d='M%201%2c1%20L%2014%2c14%20M%201%2c14%20L%2014%2c1'%20class='arrowMarkerPath'%20style='stroke-width:%202.5%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-1_flowchart-v2-crossStart-margin'%20class='marker%20cross%20flowchart-v2'%20viewBox='0%200%2015%2015'%20refX='-3.5'%20refY='7.5'%20markerUnits='userSpaceOnUse'%20markerWidth='12'%20markerHeight='12'%20orient='auto'%3e%3cpath%20d='M%201%2c1%20L%2014%2c14%20M%201%2c14%20L%2014%2c1'%20class='arrowMarkerPath'%20style='stroke-width:%202.5%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cg%20class='root'%3e%3cg%20class='clusters'/%3e%3cg%20class='edgePaths'%3e%3cpath%20d='M145.117%2c54.833L130.155%2c60.194C115.193%2c65.555%2c85.268%2c76.278%2c70.306%2c85.139C55.344%2c94%2c55.344%2c101%2c55.344%2c104.5L55.344%2c108'%20id='mermaid-dark-1-L_Region_AZ1_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_Region_AZ1_0'%20data-points='W3sieCI6MTQ1LjExNzE4NzUsInkiOjU0LjgzMzExODAwMTcyMjY1fSx7IngiOjU1LjM0Mzc1LCJ5Ijo4N30seyJ4Ijo1NS4zNDM3NSwieSI6MTEyfV0='%20data-look='classic'%20marker-end='url(%23mermaid-dark-1_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M200.469%2c62L200.469%2c66.167C200.469%2c70.333%2c200.469%2c78.667%2c200.469%2c86.333C200.469%2c94%2c200.469%2c101%2c200.469%2c104.5L200.469%2c108'%20id='mermaid-dark-1-L_Region_AZ2_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_Region_AZ2_0'%20data-points='W3sieCI6MjAwLjQ2ODc1LCJ5Ijo2Mn0seyJ4IjoyMDAuNDY4NzUsInkiOjg3fSx7IngiOjIwMC40Njg3NSwieSI6MTEyfV0='%20data-look='classic'%20marker-end='url(%23mermaid-dark-1_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M255.82%2c54.713L270.93%2c60.094C286.039%2c65.475%2c316.258%2c76.238%2c331.367%2c85.119C346.477%2c94%2c346.477%2c101%2c346.477%2c104.5L346.477%2c108'%20id='mermaid-dark-1-L_Region_AZ3_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_Region_AZ3_0'%20data-points='W3sieCI6MjU1LjgyMDMxMjUsInkiOjU0LjcxMzIwMDI3ODIzODUzfSx7IngiOjM0Ni40NzY1NjI1LCJ5Ijo4N30seyJ4IjozNDYuNDc2NTYyNSwieSI6MTEyfV0='%20data-look='classic'%20marker-end='url(%23mermaid-dark-1_flowchart-v2-pointEnd)'/%3e%3c/g%3e%3cg%20class='edgeLabels'%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_Region_AZ1_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_Region_AZ2_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_Region_AZ3_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cg%20class='nodes'%3e%3cg%20class='node%20default'%20id='mermaid-dark-1-flowchart-Region-0'%20data-look='classic'%20transform='translate(200.46875%2c%2035)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-55.3515625'%20y='-27'%20width='110.703125'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-25.3515625%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='50.703125'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3eRegion%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-1-flowchart-AZ1-2'%20data-look='classic'%20transform='translate(55.34375%2c%20139)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-47.34375'%20y='-27'%20width='94.6875'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-17.34375%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='34.6875'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3eAZ%20A%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-1-flowchart-AZ2-4'%20data-look='classic'%20transform='translate(200.46875%2c%20139)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-47.78125'%20y='-27'%20width='95.5625'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-17.78125%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='35.5625'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3eAZ%20B%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-1-flowchart-AZ3-6'%20data-look='classic'%20transform='translate(346.4765625%2c%20139)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-48.2265625'%20y='-27'%20width='96.453125'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-18.2265625%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='36.453125'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3eAZ%20C%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cdefs%3e%3cfilter%20id='mermaid-dark-1-drop-shadow'%20height='130%25'%20width='130%25'%3e%3cfeDropShadow%20dx='4'%20dy='4'%20stdDeviation='0'%20flood-opacity='0.06'%20flood-color='white'/%3e%3c/filter%3e%3c/defs%3e%3cdefs%3e%3cfilter%20id='mermaid-dark-1-drop-shadow-small'%20height='150%25'%20width='150%25'%3e%3cfeDropShadow%20dx='2'%20dy='2'%20stdDeviation='0'%20flood-opacity='0.06'%20flood-color='white'/%3e%3c/filter%3e%3c/defs%3e%3clinearGradient%20id='mermaid-dark-1-gradient'%20gradientUnits='objectBoundingBox'%20x1='0%25'%20y1='0%25'%20x2='100%25'%20y2='0%25'%3e%3cstop%20offset='0%25'%20stop-color='%23cccccc'%20stop-opacity='1'/%3e%3cstop%20offset='100%25'%20stop-color='hsl(180%2c%200%25%2c%2018.3529411765%25)'%20stop-opacity='1'/%3e%3c/linearGradient%3e%3c/svg%3e)
多 AZ 并不自动等于高可用。应用副本、负载均衡、数据库主备和故障切换策略 也必须跨 AZ 配置,才能真正利用故障隔离能力。
IAM:谁能操作资源
IAM(Identity and Access Management)控制的是云平台资源访问,而不是商城、 论坛等业务系统的用户登录。它需要同时解决两个问题:
- Authentication(认证):确认请求者是谁;
- Authorization(授权):判断请求者可以执行什么操作。
账号通常是资源归属和计费主体;IAM User 表示账号内的独立人员身份;User Group 用于按岗位批量分配权限;Role 和 Policy 则描述某个身份可以对哪些资源 执行哪些操作。
权限设计应遵循最小权限原则。开发人员不应共享主账号,程序也不应长期持有 超出自身职责的权限。AK/SK、Token 和临时凭证都属于机器身份凭证,其中 SK 尤其不能写入 Git 仓库、容器镜像或普通配置文件。
VPC 与安全组:资源如何连接
VPC(Virtual Private Cloud)是云上的逻辑私有网络。一个 VPC 可以按工作负载 和安全边界划分多个 Subnet,例如:
10.10.0.0/20    Kubernetes 节点与 Pod
10.10.16.0/24   数据库
10.10.17.0/24   中间件
10.10.18.0/24   通用计算实例
Security Group(安全组)根据方向、协议、来源和端口控制资源访问。应用即使 知道数据库 IP,如果安全组没有允许应用网段访问 3306,连接仍然无法建立。
判断两个服务能否通信,至少要依次检查:
名称解析 → 路由可达 → 安全组放行 → 目标端口监听 → 应用层认证所以,“能 ping 通”或“IP 可达”从来不等于业务一定可用。
三、从虚拟机到容器编排
ECS 提供计算资源
ECS(Elastic Cloud Server)本质上是云平台提供的虚拟服务器,包括 CPU、内存、 磁盘、网络和操作系统。团队可以直接在其中安装 Java、Nginx、MySQL 或 Docker。
但当服务数量和实例规模不断增加,逐台管理虚拟机很快会遇到部署、扩缩容、 服务发现、故障恢复和滚动升级等问题。容器编排平台正是为管理这些工作负载而生。
Image、Runtime 与 Kubernetes 各司其职
Container Image 是应用及其运行依赖的静态交付物;Container 是镜像启动后的 运行实例;containerd 等 Container Runtime 负责真正创建和管理容器。
Kubernetes 则位于更高层,负责声明、调度和维护容器化工作负载。它由控制面和 工作节点组成:控制面保存集群状态并执行调度与控制逻辑,工作节点实际运行 Pod。
%3btext-align:center%3b%7d%23mermaid-2 .edgeLabel p%7bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3b%7d%23mermaid-2 .edgeLabel rect%7bopacity:0.5%3bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bfill:rgba(232%2c232%2c232%2c 0.8)%3b%7d%23mermaid-2 .labelBkg%7bbackground-color:rgba(232%2c 232%2c 232%2c 0.5)%3b%7d%23mermaid-2 .cluster rect%7bfill:%23ffffde%3bstroke:%23aaaa33%3bstroke-width:1px%3b%7d%23mermaid-2 .cluster text%7bfill:%23333%3b%7d%23mermaid-2 .cluster span%7bcolor:%23333%3b%7d%23mermaid-2 .node .collapsed-indicator%7bfill:%23aaaa33%3bstroke:none%3bopacity:0.6%3b%7d%23mermaid-2 .node .collapsed-separator%7bstroke:%23aaaa33%3bstroke-width:0.75px%3b%7d%23mermaid-2 div.mermaidTooltip%7bposition:absolute%3btext-align:center%3bmax-width:200px%3bpadding:2px%3bfont-family:arial%2csans-serif%3bfont-size:12px%3bbackground:hsl(80%2c 100%25%2c 96.2745098039%25)%3bborder:1px solid %23aaaa33%3bborder-radius:2px%3bpointer-events:none%3bz-index:100%3b%7d%23mermaid-2 .flowchartTitleText%7btext-anchor:middle%3bfont-size:18px%3bfill:%23333%3b%7d%23mermaid-2 rect.text%7bfill:none%3bstroke-width:0%3b%7d%23mermaid-2 .icon-shape%2c%23mermaid-2 .image-shape%7bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3btext-align:center%3b%7d%23mermaid-2 .icon-shape p%2c%23mermaid-2 .image-shape p%7bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bpadding:2px%3b%7d%23mermaid-2 .icon-shape .label rect%2c%23mermaid-2 .image-shape .label rect%7bopacity:0.5%3bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bfill:rgba(232%2c232%2c232%2c 0.8)%3b%7d%23mermaid-2 .label-icon%7bdisplay:inline-block%3bheight:1em%3boverflow:visible%3bvertical-align:-0.125em%3b%7d%23mermaid-2 .node .label-icon path%7bfill:currentColor%3bstroke:revert%3bstroke-width:revert%3b%7d%23mermaid-2 .node .neo-node%7bstroke:%239370DB%3b%7d%23mermaid-2 %5bdata-look='neo'%5d.node rect%2c%23mermaid-2 %5bdata-look='neo'%5d.cluster rect%2c%23mermaid-2 %5bdata-look='neo'%5d.node polygon%7bstroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-2 %5bdata-look='neo'%5d.swimlane.cluster rect%7bfilter:none%3b%7d%23mermaid-2 %5bdata-look='neo'%5d.node path%7bstroke:%239370DB%3bstroke-width:1px%3b%7d%23mermaid-2 %5bdata-look='neo'%5d.node .outer-path%7bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-2 %5bdata-look='neo'%5d.node .neo-line path%7bstroke:%239370DB%3bfilter:none%3b%7d%23mermaid-2 %5bdata-look='neo'%5d.node circle%7bstroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-2 %5bdata-look='neo'%5d.node circle .state-start%7bfill:black%3b%7d%23mermaid-2 %5bdata-look='neo'%5d.icon-shape .icon%7bfill:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-2 %5bdata-look='neo'%5d.icon-shape .icon-neo path%7bstroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-2 :root%7b--mermaid-font-family:arial%2csans-serif%3b%7d%3c/style%3e%3cg%3e%3cmarker id='mermaid-2_flowchart-v2-pointEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'%3e%3cpath d='M 0 0 L 10 5 L 0 10 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-2_flowchart-v2-pointStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='4.5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'%3e%3cpath d='M 0 5 L 10 10 L 10 0 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-2_flowchart-v2-pointEnd-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='11.5' refY='7' markerUnits='userSpaceOnUse' markerWidth='10.5' markerHeight='14' orient='auto'%3e%3cpath d='M 0 0 L 11.5 7 L 0 14 z' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-2_flowchart-v2-pointStart-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='1' refY='7' markerUnits='userSpaceOnUse' markerWidth='11.5' markerHeight='14' orient='auto'%3e%3cpolygon points='0%2c7 11.5%2c14 11.5%2c0' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-2_flowchart-v2-circleEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='11' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-2_flowchart-v2-circleStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-1' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-2_flowchart-v2-circleEnd-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refY='5' refX='12.25' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-2_flowchart-v2-circleStart-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-2' refY='5' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-2_flowchart-v2-crossEnd' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='12' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3cpath d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-2_flowchart-v2-crossStart' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='-1' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3cpath d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-2_flowchart-v2-crossEnd-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='17.7' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'%3e%3cpath d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-2_flowchart-v2-crossStart-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='-3.5' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'%3e%3cpath d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cg class='root'%3e%3cg class='clusters'/%3e%3cg class='edgePaths'%3e%3cpath d='M149.844%2c35L154.01%2c35C158.177%2c35%2c166.51%2c35%2c174.177%2c35C181.844%2c35%2c188.844%2c35%2c192.344%2c35L195.844%2c35' id='mermaid-2-L_Kubernetes_Kubelet_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_Kubernetes_Kubelet_0' data-points='W3sieCI6MTQ5Ljg0Mzc1LCJ5IjozNX0seyJ4IjoxNzQuODQzNzUsInkiOjM1fSx7IngiOjE5OS44NDM3NSwieSI6MzV9XQ==' data-look='classic' marker-end='url(%23mermaid-2_flowchart-v2-pointEnd)'/%3e%3cpath d='M311.438%2c35L315.604%2c35C319.771%2c35%2c328.104%2c35%2c335.771%2c35C343.438%2c35%2c350.438%2c35%2c353.938%2c35L357.438%2c35' id='mermaid-2-L_Kubelet_CRI_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_Kubelet_CRI_0' data-points='W3sieCI6MzExLjQzNzUsInkiOjM1fSx7IngiOjMzNi40Mzc1LCJ5IjozNX0seyJ4IjozNjEuNDM3NSwieSI6MzV9XQ==' data-look='classic' marker-end='url(%23mermaid-2_flowchart-v2-pointEnd)'/%3e%3cpath d='M449%2c35L453.167%2c35C457.333%2c35%2c465.667%2c35%2c473.333%2c35C481%2c35%2c488%2c35%2c491.5%2c35L495%2c35' id='mermaid-2-L_CRI_Runtime_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_CRI_Runtime_0' data-points='W3sieCI6NDQ5LCJ5IjozNX0seyJ4Ijo0NzQsInkiOjM1fSx7IngiOjQ5OSwieSI6MzV9XQ==' data-look='classic' marker-end='url(%23mermaid-2_flowchart-v2-pointEnd)'/%3e%3cpath d='M633.719%2c35L637.885%2c35C642.052%2c35%2c650.385%2c35%2c658.052%2c35C665.719%2c35%2c672.719%2c35%2c676.219%2c35L679.719%2c35' id='mermaid-2-L_Runtime_Container_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_Runtime_Container_0' data-points='W3sieCI6NjMzLjcxODc1LCJ5IjozNX0seyJ4Ijo2NTguNzE4NzUsInkiOjM1fSx7IngiOjY4My43MTg3NSwieSI6MzV9XQ==' data-look='classic' marker-end='url(%23mermaid-2_flowchart-v2-pointEnd)'/%3e%3c/g%3e%3cg class='edgeLabels'%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_Kubernetes_Kubelet_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_Kubelet_CRI_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_CRI_Runtime_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_Runtime_Container_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cg class='nodes'%3e%3cg class='node default' id='mermaid-2-flowchart-Kubernetes-0' data-look='classic' transform='translate(78.921875%2c 35)'%3e%3crect class='basic label-container' style='' x='-70.921875' y='-27' width='141.84375' height='54'/%3e%3cg class='label' style='' transform='translate(-40.921875%2c -12)'%3e%3crect/%3e%3cforeignObject width='81.84375' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eKubernetes%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-2-flowchart-Kubelet-1' data-look='classic' transform='translate(255.640625%2c 35)'%3e%3crect class='basic label-container' style='' x='-55.796875' y='-27' width='111.59375' height='54'/%3e%3cg class='label' style='' transform='translate(-25.796875%2c -12)'%3e%3crect/%3e%3cforeignObject width='51.59375' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3ekubelet%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-2-flowchart-CRI-3' data-look='classic' transform='translate(405.21875%2c 35)'%3e%3crect class='basic label-container' style='' x='-43.78125' y='-27' width='87.5625' height='54'/%3e%3cg class='label' style='' transform='translate(-13.78125%2c -12)'%3e%3crect/%3e%3cforeignObject width='27.5625' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eCRI%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-2-flowchart-Runtime-5' data-look='classic' transform='translate(566.359375%2c 35)'%3e%3crect class='basic label-container' style='' x='-67.359375' y='-27' width='134.71875' height='54'/%3e%3cg class='label' style='' transform='translate(-37.359375%2c -12)'%3e%3crect/%3e%3cforeignObject width='74.71875' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3econtainerd%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-2-flowchart-Container-7' data-look='classic' transform='translate(748.40625%2c 35)'%3e%3crect class='basic label-container' style='' x='-64.6875' y='-27' width='129.375' height='54'/%3e%3cg class='label' style='' transform='translate(-34.6875%2c -12)'%3e%3crect/%3e%3cforeignObject width='69.375' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eContainer%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cdefs%3e%3cfilter id='mermaid-2-drop-shadow' height='130%25' width='130%25'%3e%3cfeDropShadow dx='4' dy='4' stdDeviation='0' flood-opacity='0.06' flood-color='black'/%3e%3c/filter%3e%3c/defs%3e%3cdefs%3e%3cfilter id='mermaid-2-drop-shadow-small' height='150%25' width='150%25'%3e%3cfeDropShadow dx='2' dy='2' stdDeviation='0' flood-opacity='0.06' flood-color='black'/%3e%3c/filter%3e%3c/defs%3e%3c/svg%3e)
%3btext-align:center%3b%7d%23mermaid-dark-2%20.edgeLabel%20p%7bbackground-color:hsl(0%2c%200%25%2c%2034.4117647059%25)%3b%7d%23mermaid-dark-2%20.edgeLabel%20rect%7bopacity:0.5%3bbackground-color:hsl(0%2c%200%25%2c%2034.4117647059%25)%3bfill:hsl(0%2c%200%25%2c%2034.4117647059%25)%3b%7d%23mermaid-dark-2%20.labelBkg%7bbackground-color:rgba(87.75%2c%2087.75%2c%2087.75%2c%200.5)%3b%7d%23mermaid-dark-2%20.cluster%20rect%7bfill:hsl(180%2c%201.5873015873%25%2c%2028.3529411765%25)%3bstroke:rgba(255%2c%20255%2c%20255%2c%200.25)%3bstroke-width:1px%3b%7d%23mermaid-dark-2%20.cluster%20text%7bfill:%23F9FFFE%3b%7d%23mermaid-dark-2%20.cluster%20span%7bcolor:%23F9FFFE%3b%7d%23mermaid-dark-2%20.node%20.collapsed-indicator%7bfill:rgba(255%2c%20255%2c%20255%2c%200.25)%3bstroke:none%3bopacity:0.6%3b%7d%23mermaid-dark-2%20.node%20.collapsed-separator%7bstroke:rgba(255%2c%20255%2c%20255%2c%200.25)%3bstroke-width:0.75px%3b%7d%23mermaid-dark-2%20div.mermaidTooltip%7bposition:absolute%3btext-align:center%3bmax-width:200px%3bpadding:2px%3bfont-family:arial%2csans-serif%3bfont-size:12px%3bbackground:hsl(20%2c%201.5873015873%25%2c%2012.3529411765%25)%3bborder:1px%20solid%20rgba(255%2c%20255%2c%20255%2c%200.25)%3bborder-radius:2px%3bpointer-events:none%3bz-index:100%3b%7d%23mermaid-dark-2%20.flowchartTitleText%7btext-anchor:middle%3bfont-size:18px%3bfill:%23ccc%3b%7d%23mermaid-dark-2%20rect.text%7bfill:none%3bstroke-width:0%3b%7d%23mermaid-dark-2%20.icon-shape%2c%23mermaid-dark-2%20.image-shape%7bbackground-color:hsl(0%2c%200%25%2c%2034.4117647059%25)%3btext-align:center%3b%7d%23mermaid-dark-2%20.icon-shape%20p%2c%23mermaid-dark-2%20.image-shape%20p%7bbackground-color:hsl(0%2c%200%25%2c%2034.4117647059%25)%3bpadding:2px%3b%7d%23mermaid-dark-2%20.icon-shape%20.label%20rect%2c%23mermaid-dark-2%20.image-shape%20.label%20rect%7bopacity:0.5%3bbackground-color:hsl(0%2c%200%25%2c%2034.4117647059%25)%3bfill:hsl(0%2c%200%25%2c%2034.4117647059%25)%3b%7d%23mermaid-dark-2%20.label-icon%7bdisplay:inline-block%3bheight:1em%3boverflow:visible%3bvertical-align:-0.125em%3b%7d%23mermaid-dark-2%20.node%20.label-icon%20path%7bfill:currentColor%3bstroke:revert%3bstroke-width:revert%3b%7d%23mermaid-dark-2%20.node%20.neo-node%7bstroke:%23ccc%3b%7d%23mermaid-dark-2%20%5bdata-look='neo'%5d.node%20rect%2c%23mermaid-dark-2%20%5bdata-look='neo'%5d.cluster%20rect%2c%23mermaid-dark-2%20%5bdata-look='neo'%5d.node%20polygon%7bstroke:url(%23mermaid-dark-2-gradient)%3bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-2%20%5bdata-look='neo'%5d.swimlane.cluster%20rect%7bfilter:none%3b%7d%23mermaid-dark-2%20%5bdata-look='neo'%5d.node%20path%7bstroke:url(%23mermaid-dark-2-gradient)%3bstroke-width:1px%3b%7d%23mermaid-dark-2%20%5bdata-look='neo'%5d.node%20.outer-path%7bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-2%20%5bdata-look='neo'%5d.node%20.neo-line%20path%7bstroke:%23ccc%3bfilter:none%3b%7d%23mermaid-dark-2%20%5bdata-look='neo'%5d.node%20circle%7bstroke:url(%23mermaid-dark-2-gradient)%3bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-2%20%5bdata-look='neo'%5d.node%20circle%20.state-start%7bfill:black%3b%7d%23mermaid-dark-2%20%5bdata-look='neo'%5d.icon-shape%20.icon%7bfill:url(%23mermaid-dark-2-gradient)%3bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-2%20%5bdata-look='neo'%5d.icon-shape%20.icon-neo%20path%7bstroke:url(%23mermaid-dark-2-gradient)%3bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-2%20:root%7b--mermaid-font-family:arial%2csans-serif%3b%7d%3c/style%3e%3cg%3e%3cmarker%20id='mermaid-dark-2_flowchart-v2-pointEnd'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='5'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='8'%20markerHeight='8'%20orient='auto'%3e%3cpath%20d='M%200%200%20L%2010%205%20L%200%2010%20z'%20class='arrowMarkerPath'%20style='stroke-width:%201%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-2_flowchart-v2-pointStart'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='4.5'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='8'%20markerHeight='8'%20orient='auto'%3e%3cpath%20d='M%200%205%20L%2010%2010%20L%2010%200%20z'%20class='arrowMarkerPath'%20style='stroke-width:%201%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-2_flowchart-v2-pointEnd-margin'%20class='marker%20flowchart-v2'%20viewBox='0%200%2011.5%2014'%20refX='11.5'%20refY='7'%20markerUnits='userSpaceOnUse'%20markerWidth='10.5'%20markerHeight='14'%20orient='auto'%3e%3cpath%20d='M%200%200%20L%2011.5%207%20L%200%2014%20z'%20class='arrowMarkerPath'%20style='stroke-width:%200%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-2_flowchart-v2-pointStart-margin'%20class='marker%20flowchart-v2'%20viewBox='0%200%2011.5%2014'%20refX='1'%20refY='7'%20markerUnits='userSpaceOnUse'%20markerWidth='11.5'%20markerHeight='14'%20orient='auto'%3e%3cpolygon%20points='0%2c7%2011.5%2c14%2011.5%2c0'%20class='arrowMarkerPath'%20style='stroke-width:%200%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-2_flowchart-v2-circleEnd'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='11'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='11'%20markerHeight='11'%20orient='auto'%3e%3ccircle%20cx='5'%20cy='5'%20r='5'%20class='arrowMarkerPath'%20style='stroke-width:%201%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-2_flowchart-v2-circleStart'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='-1'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='11'%20markerHeight='11'%20orient='auto'%3e%3ccircle%20cx='5'%20cy='5'%20r='5'%20class='arrowMarkerPath'%20style='stroke-width:%201%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-2_flowchart-v2-circleEnd-margin'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refY='5'%20refX='12.25'%20markerUnits='userSpaceOnUse'%20markerWidth='14'%20markerHeight='14'%20orient='auto'%3e%3ccircle%20cx='5'%20cy='5'%20r='5'%20class='arrowMarkerPath'%20style='stroke-width:%200%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-2_flowchart-v2-circleStart-margin'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='-2'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='14'%20markerHeight='14'%20orient='auto'%3e%3ccircle%20cx='5'%20cy='5'%20r='5'%20class='arrowMarkerPath'%20style='stroke-width:%200%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-2_flowchart-v2-crossEnd'%20class='marker%20cross%20flowchart-v2'%20viewBox='0%200%2011%2011'%20refX='12'%20refY='5.2'%20markerUnits='userSpaceOnUse'%20markerWidth='11'%20markerHeight='11'%20orient='auto'%3e%3cpath%20d='M%201%2c1%20l%209%2c9%20M%2010%2c1%20l%20-9%2c9'%20class='arrowMarkerPath'%20style='stroke-width:%202%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-2_flowchart-v2-crossStart'%20class='marker%20cross%20flowchart-v2'%20viewBox='0%200%2011%2011'%20refX='-1'%20refY='5.2'%20markerUnits='userSpaceOnUse'%20markerWidth='11'%20markerHeight='11'%20orient='auto'%3e%3cpath%20d='M%201%2c1%20l%209%2c9%20M%2010%2c1%20l%20-9%2c9'%20class='arrowMarkerPath'%20style='stroke-width:%202%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-2_flowchart-v2-crossEnd-margin'%20class='marker%20cross%20flowchart-v2'%20viewBox='0%200%2015%2015'%20refX='17.7'%20refY='7.5'%20markerUnits='userSpaceOnUse'%20markerWidth='12'%20markerHeight='12'%20orient='auto'%3e%3cpath%20d='M%201%2c1%20L%2014%2c14%20M%201%2c14%20L%2014%2c1'%20class='arrowMarkerPath'%20style='stroke-width:%202.5%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-2_flowchart-v2-crossStart-margin'%20class='marker%20cross%20flowchart-v2'%20viewBox='0%200%2015%2015'%20refX='-3.5'%20refY='7.5'%20markerUnits='userSpaceOnUse'%20markerWidth='12'%20markerHeight='12'%20orient='auto'%3e%3cpath%20d='M%201%2c1%20L%2014%2c14%20M%201%2c14%20L%2014%2c1'%20class='arrowMarkerPath'%20style='stroke-width:%202.5%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cg%20class='root'%3e%3cg%20class='clusters'/%3e%3cg%20class='edgePaths'%3e%3cpath%20d='M149.844%2c35L154.01%2c35C158.177%2c35%2c166.51%2c35%2c174.177%2c35C181.844%2c35%2c188.844%2c35%2c192.344%2c35L195.844%2c35'%20id='mermaid-dark-2-L_Kubernetes_Kubelet_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_Kubernetes_Kubelet_0'%20data-points='W3sieCI6MTQ5Ljg0Mzc1LCJ5IjozNX0seyJ4IjoxNzQuODQzNzUsInkiOjM1fSx7IngiOjE5OS44NDM3NSwieSI6MzV9XQ=='%20data-look='classic'%20marker-end='url(%23mermaid-dark-2_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M311.438%2c35L315.604%2c35C319.771%2c35%2c328.104%2c35%2c335.771%2c35C343.438%2c35%2c350.438%2c35%2c353.938%2c35L357.438%2c35'%20id='mermaid-dark-2-L_Kubelet_CRI_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_Kubelet_CRI_0'%20data-points='W3sieCI6MzExLjQzNzUsInkiOjM1fSx7IngiOjMzNi40Mzc1LCJ5IjozNX0seyJ4IjozNjEuNDM3NSwieSI6MzV9XQ=='%20data-look='classic'%20marker-end='url(%23mermaid-dark-2_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M449%2c35L453.167%2c35C457.333%2c35%2c465.667%2c35%2c473.333%2c35C481%2c35%2c488%2c35%2c491.5%2c35L495%2c35'%20id='mermaid-dark-2-L_CRI_Runtime_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_CRI_Runtime_0'%20data-points='W3sieCI6NDQ5LCJ5IjozNX0seyJ4Ijo0NzQsInkiOjM1fSx7IngiOjQ5OSwieSI6MzV9XQ=='%20data-look='classic'%20marker-end='url(%23mermaid-dark-2_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M633.719%2c35L637.885%2c35C642.052%2c35%2c650.385%2c35%2c658.052%2c35C665.719%2c35%2c672.719%2c35%2c676.219%2c35L679.719%2c35'%20id='mermaid-dark-2-L_Runtime_Container_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_Runtime_Container_0'%20data-points='W3sieCI6NjMzLjcxODc1LCJ5IjozNX0seyJ4Ijo2NTguNzE4NzUsInkiOjM1fSx7IngiOjY4My43MTg3NSwieSI6MzV9XQ=='%20data-look='classic'%20marker-end='url(%23mermaid-dark-2_flowchart-v2-pointEnd)'/%3e%3c/g%3e%3cg%20class='edgeLabels'%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_Kubernetes_Kubelet_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_Kubelet_CRI_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_CRI_Runtime_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_Runtime_Container_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cg%20class='nodes'%3e%3cg%20class='node%20default'%20id='mermaid-dark-2-flowchart-Kubernetes-0'%20data-look='classic'%20transform='translate(78.921875%2c%2035)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-70.921875'%20y='-27'%20width='141.84375'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-40.921875%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='81.84375'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3eKubernetes%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-2-flowchart-Kubelet-1'%20data-look='classic'%20transform='translate(255.640625%2c%2035)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-55.796875'%20y='-27'%20width='111.59375'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-25.796875%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='51.59375'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3ekubelet%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-2-flowchart-CRI-3'%20data-look='classic'%20transform='translate(405.21875%2c%2035)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-43.78125'%20y='-27'%20width='87.5625'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-13.78125%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='27.5625'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3eCRI%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-2-flowchart-Runtime-5'%20data-look='classic'%20transform='translate(566.359375%2c%2035)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-67.359375'%20y='-27'%20width='134.71875'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-37.359375%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='74.71875'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3econtainerd%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-2-flowchart-Container-7'%20data-look='classic'%20transform='translate(748.40625%2c%2035)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-64.6875'%20y='-27'%20width='129.375'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-34.6875%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='69.375'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3eContainer%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cdefs%3e%3cfilter%20id='mermaid-dark-2-drop-shadow'%20height='130%25'%20width='130%25'%3e%3cfeDropShadow%20dx='4'%20dy='4'%20stdDeviation='0'%20flood-opacity='0.06'%20flood-color='white'/%3e%3c/filter%3e%3c/defs%3e%3cdefs%3e%3cfilter%20id='mermaid-dark-2-drop-shadow-small'%20height='150%25'%20width='150%25'%3e%3cfeDropShadow%20dx='2'%20dy='2'%20stdDeviation='0'%20flood-opacity='0.06'%20flood-color='white'/%3e%3c/filter%3e%3c/defs%3e%3clinearGradient%20id='mermaid-dark-2-gradient'%20gradientUnits='objectBoundingBox'%20x1='0%25'%20y1='0%25'%20x2='100%25'%20y2='0%25'%3e%3cstop%20offset='0%25'%20stop-color='%23cccccc'%20stop-opacity='1'/%3e%3cstop%20offset='100%25'%20stop-color='hsl(180%2c%200%25%2c%2018.3529411765%25)'%20stop-opacity='1'/%3e%3c/linearGradient%3e%3c/svg%3e)
CCE 是华为云提供的托管 Kubernetes 服务,而不是 Kubernetes 的替代技术。 类似的托管服务还包括 AWS EKS、Azure AKS 和 Google GKE。使用托管集群后, 团队仍然需要理解 Pod、Deployment、Service、ConfigMap 和调度机制。
Kubernetes 的核心工作方式是声明式管理。例如,replicas: 3 描述的是期望状态, Controller 会持续比较实际状态与期望状态,并在实例崩溃或节点故障后尝试恢复。
四、请求如何进入系统并在内部流动
云原生流量可以分为两类:
- 南北向流量:外部客户端与云内服务之间的通信;
- 东西向流量:数据中心或集群内部的服务间通信。
南北向:DNS、WAF、ELB 与 APIG
用户访问 https://api.example.com 时,DNS 首先将域名解析到系统入口。之后的 链路会按业务需要组合以下组件,而不是必然全部出现:
| 组件 | 主要职责 |
|---|---|
| WAF | 检测和过滤恶意 HTTP/HTTPS 请求 |
| ELB | 在多个后端实例间分发流量并执行健康检查 |
| APIG | 管理 API 路由、鉴权、限流、参数和生命周期 |
| Ingress / Gateway | 将集群外的 HTTP/HTTPS 流量路由到 Kubernetes Service |
Security Group 和 WAF 也不能互相替代:前者更接近网络访问控制,后者关注 Web 应用层请求。ELB 主要回答“流量发给哪个后端”,APIG 则进一步理解 API 语义, 回答“谁能以什么规则访问哪个 API”。
东西向:Service 与 Service Mesh
Pod 会创建、销毁、扩缩容,其 IP 并不稳定。Kubernetes Service 为一组 Pod 提供稳定入口和服务发现能力。
当微服务增多,超时、重试、熔断、灰度路由、访问控制和遥测等逻辑如果全部 散落在业务代码中,会带来较高的治理成本。Service Mesh 将这些通信能力下沉 到代理层,Envoy 是常见的数据面代理,ASM 则是华为云的托管服务网格产品。
%3btext-align:center%3b%7d%23mermaid-3 .edgeLabel p%7bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3b%7d%23mermaid-3 .edgeLabel rect%7bopacity:0.5%3bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bfill:rgba(232%2c232%2c232%2c 0.8)%3b%7d%23mermaid-3 .labelBkg%7bbackground-color:rgba(232%2c 232%2c 232%2c 0.5)%3b%7d%23mermaid-3 .cluster rect%7bfill:%23ffffde%3bstroke:%23aaaa33%3bstroke-width:1px%3b%7d%23mermaid-3 .cluster text%7bfill:%23333%3b%7d%23mermaid-3 .cluster span%7bcolor:%23333%3b%7d%23mermaid-3 .node .collapsed-indicator%7bfill:%23aaaa33%3bstroke:none%3bopacity:0.6%3b%7d%23mermaid-3 .node .collapsed-separator%7bstroke:%23aaaa33%3bstroke-width:0.75px%3b%7d%23mermaid-3 div.mermaidTooltip%7bposition:absolute%3btext-align:center%3bmax-width:200px%3bpadding:2px%3bfont-family:arial%2csans-serif%3bfont-size:12px%3bbackground:hsl(80%2c 100%25%2c 96.2745098039%25)%3bborder:1px solid %23aaaa33%3bborder-radius:2px%3bpointer-events:none%3bz-index:100%3b%7d%23mermaid-3 .flowchartTitleText%7btext-anchor:middle%3bfont-size:18px%3bfill:%23333%3b%7d%23mermaid-3 rect.text%7bfill:none%3bstroke-width:0%3b%7d%23mermaid-3 .icon-shape%2c%23mermaid-3 .image-shape%7bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3btext-align:center%3b%7d%23mermaid-3 .icon-shape p%2c%23mermaid-3 .image-shape p%7bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bpadding:2px%3b%7d%23mermaid-3 .icon-shape .label rect%2c%23mermaid-3 .image-shape .label rect%7bopacity:0.5%3bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bfill:rgba(232%2c232%2c232%2c 0.8)%3b%7d%23mermaid-3 .label-icon%7bdisplay:inline-block%3bheight:1em%3boverflow:visible%3bvertical-align:-0.125em%3b%7d%23mermaid-3 .node .label-icon path%7bfill:currentColor%3bstroke:revert%3bstroke-width:revert%3b%7d%23mermaid-3 .node .neo-node%7bstroke:%239370DB%3b%7d%23mermaid-3 %5bdata-look='neo'%5d.node rect%2c%23mermaid-3 %5bdata-look='neo'%5d.cluster rect%2c%23mermaid-3 %5bdata-look='neo'%5d.node polygon%7bstroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-3 %5bdata-look='neo'%5d.swimlane.cluster rect%7bfilter:none%3b%7d%23mermaid-3 %5bdata-look='neo'%5d.node path%7bstroke:%239370DB%3bstroke-width:1px%3b%7d%23mermaid-3 %5bdata-look='neo'%5d.node .outer-path%7bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-3 %5bdata-look='neo'%5d.node .neo-line path%7bstroke:%239370DB%3bfilter:none%3b%7d%23mermaid-3 %5bdata-look='neo'%5d.node circle%7bstroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-3 %5bdata-look='neo'%5d.node circle .state-start%7bfill:black%3b%7d%23mermaid-3 %5bdata-look='neo'%5d.icon-shape .icon%7bfill:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-3 %5bdata-look='neo'%5d.icon-shape .icon-neo path%7bstroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-3 :root%7b--mermaid-font-family:arial%2csans-serif%3b%7d%3c/style%3e%3cg%3e%3cmarker id='mermaid-3_flowchart-v2-pointEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'%3e%3cpath d='M 0 0 L 10 5 L 0 10 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-3_flowchart-v2-pointStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='4.5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'%3e%3cpath d='M 0 5 L 10 10 L 10 0 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-3_flowchart-v2-pointEnd-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='11.5' refY='7' markerUnits='userSpaceOnUse' markerWidth='10.5' markerHeight='14' orient='auto'%3e%3cpath d='M 0 0 L 11.5 7 L 0 14 z' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-3_flowchart-v2-pointStart-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='1' refY='7' markerUnits='userSpaceOnUse' markerWidth='11.5' markerHeight='14' orient='auto'%3e%3cpolygon points='0%2c7 11.5%2c14 11.5%2c0' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-3_flowchart-v2-circleEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='11' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-3_flowchart-v2-circleStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-1' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-3_flowchart-v2-circleEnd-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refY='5' refX='12.25' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-3_flowchart-v2-circleStart-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-2' refY='5' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-3_flowchart-v2-crossEnd' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='12' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3cpath d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-3_flowchart-v2-crossStart' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='-1' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3cpath d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-3_flowchart-v2-crossEnd-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='17.7' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'%3e%3cpath d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-3_flowchart-v2-crossStart-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='-3.5' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'%3e%3cpath d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cg class='root'%3e%3cg class='clusters'/%3e%3cg class='edgePaths'%3e%3cpath d='M116%2c87L120.167%2c87C124.333%2c87%2c132.667%2c87%2c140.333%2c87C148%2c87%2c155%2c87%2c158.5%2c87L162%2c87' id='mermaid-3-L_User_Gateway_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_User_Gateway_0' data-points='W3sieCI6MTE2LCJ5Ijo4N30seyJ4IjoxNDEsInkiOjg3fSx7IngiOjE2NiwieSI6ODd9XQ==' data-look='classic' marker-end='url(%23mermaid-3_flowchart-v2-pointEnd)'/%3e%3cpath d='M355.219%2c87L359.385%2c87C363.552%2c87%2c371.885%2c87%2c379.552%2c87C387.219%2c87%2c394.219%2c87%2c397.719%2c87L401.219%2c87' id='mermaid-3-L_Gateway_Order_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_Gateway_Order_0' data-points='W3sieCI6MzU1LjIxODc1LCJ5Ijo4N30seyJ4IjozODAuMjE4NzUsInkiOjg3fSx7IngiOjQwNS4yMTg3NSwieSI6ODd9XQ==' data-look='classic' marker-end='url(%23mermaid-3_flowchart-v2-pointEnd)'/%3e%3cpath d='M538.753%2c60L547.114%2c55.833C555.476%2c51.667%2c572.199%2c43.333%2c584.283%2c39.167C596.367%2c35%2c603.813%2c35%2c607.535%2c35L611.258%2c35' id='mermaid-3-L_Order_Payment_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_Order_Payment_0' data-points='W3sieCI6NTM4Ljc1Mjg1NDU2NzMwNzcsInkiOjYwfSx7IngiOjU4OC45MjE4NzUsInkiOjM1fSx7IngiOjYxNS4yNTc4MTI1LCJ5IjozNX1d' data-look='classic' marker-end='url(%23mermaid-3_flowchart-v2-pointEnd)'/%3e%3cpath d='M538.753%2c114L547.114%2c118.167C555.476%2c122.333%2c572.199%2c130.667%2c584.06%2c134.833C595.922%2c139%2c602.922%2c139%2c606.422%2c139L609.922%2c139' id='mermaid-3-L_Order_Inventory_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_Order_Inventory_0' data-points='W3sieCI6NTM4Ljc1Mjg1NDU2NzMwNzcsInkiOjExNH0seyJ4Ijo1ODguOTIxODc1LCJ5IjoxMzl9LHsieCI6NjEzLjkyMTg3NSwieSI6MTM5fV0=' data-look='classic' marker-end='url(%23mermaid-3_flowchart-v2-pointEnd)'/%3e%3c/g%3e%3cg class='edgeLabels'%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_User_Gateway_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_Gateway_Order_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_Order_Payment_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_Order_Inventory_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cg class='nodes'%3e%3cg class='node default' id='mermaid-3-flowchart-User-0' data-look='classic' transform='translate(62%2c 87)'%3e%3crect class='basic label-container' style='' x='-54' y='-27' width='108' height='54'/%3e%3cg class='label' style='' transform='translate(-24%2c -12)'%3e%3crect/%3e%3cforeignObject width='48' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3e%e5%a4%96%e9%83%a8%e7%94%a8%e6%88%b7%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-3-flowchart-Gateway-1' data-look='classic' transform='translate(260.609375%2c 87)'%3e%3crect class='basic label-container' style='' x='-94.609375' y='-27' width='189.21875' height='54'/%3e%3cg class='label' style='' transform='translate(-64.609375%2c -12)'%3e%3crect/%3e%3cforeignObject width='129.21875' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eWAF / ELB / APIG%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-3-flowchart-Order-3' data-look='classic' transform='translate(484.5703125%2c 87)'%3e%3crect class='basic label-container' style='' x='-79.3515625' y='-27' width='158.703125' height='54'/%3e%3cg class='label' style='' transform='translate(-49.3515625%2c -12)'%3e%3crect/%3e%3cforeignObject width='98.703125' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eOrder Service%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-3-flowchart-Payment-5' data-look='classic' transform='translate(705.7265625%2c 35)'%3e%3crect class='basic label-container' style='' x='-90.46875' y='-27' width='180.9375' height='54'/%3e%3cg class='label' style='' transform='translate(-60.46875%2c -12)'%3e%3crect/%3e%3cforeignObject width='120.9375' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3ePayment Service%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-3-flowchart-Inventory-7' data-look='classic' transform='translate(705.7265625%2c 139)'%3e%3crect class='basic label-container' style='' x='-91.8046875' y='-27' width='183.609375' height='54'/%3e%3cg class='label' style='' transform='translate(-61.8046875%2c -12)'%3e%3crect/%3e%3cforeignObject width='123.609375' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eInventory Service%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cdefs%3e%3cfilter id='mermaid-3-drop-shadow' height='130%25' width='130%25'%3e%3cfeDropShadow dx='4' dy='4' stdDeviation='0' flood-opacity='0.06' flood-color='black'/%3e%3c/filter%3e%3c/defs%3e%3cdefs%3e%3cfilter id='mermaid-3-drop-shadow-small' height='150%25' width='150%25'%3e%3cfeDropShadow dx='2' dy='2' stdDeviation='0' flood-opacity='0.06' flood-color='black'/%3e%3c/filter%3e%3c/defs%3e%3c/svg%3e)
%3btext-align:center%3b%7d%23mermaid-dark-3%20.edgeLabel%20p%7bbackground-color:hsl(0%2c%200%25%2c%2034.4117647059%25)%3b%7d%23mermaid-dark-3%20.edgeLabel%20rect%7bopacity:0.5%3bbackground-color:hsl(0%2c%200%25%2c%2034.4117647059%25)%3bfill:hsl(0%2c%200%25%2c%2034.4117647059%25)%3b%7d%23mermaid-dark-3%20.labelBkg%7bbackground-color:rgba(87.75%2c%2087.75%2c%2087.75%2c%200.5)%3b%7d%23mermaid-dark-3%20.cluster%20rect%7bfill:hsl(180%2c%201.5873015873%25%2c%2028.3529411765%25)%3bstroke:rgba(255%2c%20255%2c%20255%2c%200.25)%3bstroke-width:1px%3b%7d%23mermaid-dark-3%20.cluster%20text%7bfill:%23F9FFFE%3b%7d%23mermaid-dark-3%20.cluster%20span%7bcolor:%23F9FFFE%3b%7d%23mermaid-dark-3%20.node%20.collapsed-indicator%7bfill:rgba(255%2c%20255%2c%20255%2c%200.25)%3bstroke:none%3bopacity:0.6%3b%7d%23mermaid-dark-3%20.node%20.collapsed-separator%7bstroke:rgba(255%2c%20255%2c%20255%2c%200.25)%3bstroke-width:0.75px%3b%7d%23mermaid-dark-3%20div.mermaidTooltip%7bposition:absolute%3btext-align:center%3bmax-width:200px%3bpadding:2px%3bfont-family:arial%2csans-serif%3bfont-size:12px%3bbackground:hsl(20%2c%201.5873015873%25%2c%2012.3529411765%25)%3bborder:1px%20solid%20rgba(255%2c%20255%2c%20255%2c%200.25)%3bborder-radius:2px%3bpointer-events:none%3bz-index:100%3b%7d%23mermaid-dark-3%20.flowchartTitleText%7btext-anchor:middle%3bfont-size:18px%3bfill:%23ccc%3b%7d%23mermaid-dark-3%20rect.text%7bfill:none%3bstroke-width:0%3b%7d%23mermaid-dark-3%20.icon-shape%2c%23mermaid-dark-3%20.image-shape%7bbackground-color:hsl(0%2c%200%25%2c%2034.4117647059%25)%3btext-align:center%3b%7d%23mermaid-dark-3%20.icon-shape%20p%2c%23mermaid-dark-3%20.image-shape%20p%7bbackground-color:hsl(0%2c%200%25%2c%2034.4117647059%25)%3bpadding:2px%3b%7d%23mermaid-dark-3%20.icon-shape%20.label%20rect%2c%23mermaid-dark-3%20.image-shape%20.label%20rect%7bopacity:0.5%3bbackground-color:hsl(0%2c%200%25%2c%2034.4117647059%25)%3bfill:hsl(0%2c%200%25%2c%2034.4117647059%25)%3b%7d%23mermaid-dark-3%20.label-icon%7bdisplay:inline-block%3bheight:1em%3boverflow:visible%3bvertical-align:-0.125em%3b%7d%23mermaid-dark-3%20.node%20.label-icon%20path%7bfill:currentColor%3bstroke:revert%3bstroke-width:revert%3b%7d%23mermaid-dark-3%20.node%20.neo-node%7bstroke:%23ccc%3b%7d%23mermaid-dark-3%20%5bdata-look='neo'%5d.node%20rect%2c%23mermaid-dark-3%20%5bdata-look='neo'%5d.cluster%20rect%2c%23mermaid-dark-3%20%5bdata-look='neo'%5d.node%20polygon%7bstroke:url(%23mermaid-dark-3-gradient)%3bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-3%20%5bdata-look='neo'%5d.swimlane.cluster%20rect%7bfilter:none%3b%7d%23mermaid-dark-3%20%5bdata-look='neo'%5d.node%20path%7bstroke:url(%23mermaid-dark-3-gradient)%3bstroke-width:1px%3b%7d%23mermaid-dark-3%20%5bdata-look='neo'%5d.node%20.outer-path%7bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-3%20%5bdata-look='neo'%5d.node%20.neo-line%20path%7bstroke:%23ccc%3bfilter:none%3b%7d%23mermaid-dark-3%20%5bdata-look='neo'%5d.node%20circle%7bstroke:url(%23mermaid-dark-3-gradient)%3bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-3%20%5bdata-look='neo'%5d.node%20circle%20.state-start%7bfill:black%3b%7d%23mermaid-dark-3%20%5bdata-look='neo'%5d.icon-shape%20.icon%7bfill:url(%23mermaid-dark-3-gradient)%3bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-3%20%5bdata-look='neo'%5d.icon-shape%20.icon-neo%20path%7bstroke:url(%23mermaid-dark-3-gradient)%3bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-3%20:root%7b--mermaid-font-family:arial%2csans-serif%3b%7d%3c/style%3e%3cg%3e%3cmarker%20id='mermaid-dark-3_flowchart-v2-pointEnd'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='5'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='8'%20markerHeight='8'%20orient='auto'%3e%3cpath%20d='M%200%200%20L%2010%205%20L%200%2010%20z'%20class='arrowMarkerPath'%20style='stroke-width:%201%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-3_flowchart-v2-pointStart'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='4.5'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='8'%20markerHeight='8'%20orient='auto'%3e%3cpath%20d='M%200%205%20L%2010%2010%20L%2010%200%20z'%20class='arrowMarkerPath'%20style='stroke-width:%201%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-3_flowchart-v2-pointEnd-margin'%20class='marker%20flowchart-v2'%20viewBox='0%200%2011.5%2014'%20refX='11.5'%20refY='7'%20markerUnits='userSpaceOnUse'%20markerWidth='10.5'%20markerHeight='14'%20orient='auto'%3e%3cpath%20d='M%200%200%20L%2011.5%207%20L%200%2014%20z'%20class='arrowMarkerPath'%20style='stroke-width:%200%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-3_flowchart-v2-pointStart-margin'%20class='marker%20flowchart-v2'%20viewBox='0%200%2011.5%2014'%20refX='1'%20refY='7'%20markerUnits='userSpaceOnUse'%20markerWidth='11.5'%20markerHeight='14'%20orient='auto'%3e%3cpolygon%20points='0%2c7%2011.5%2c14%2011.5%2c0'%20class='arrowMarkerPath'%20style='stroke-width:%200%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-3_flowchart-v2-circleEnd'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='11'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='11'%20markerHeight='11'%20orient='auto'%3e%3ccircle%20cx='5'%20cy='5'%20r='5'%20class='arrowMarkerPath'%20style='stroke-width:%201%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-3_flowchart-v2-circleStart'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='-1'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='11'%20markerHeight='11'%20orient='auto'%3e%3ccircle%20cx='5'%20cy='5'%20r='5'%20class='arrowMarkerPath'%20style='stroke-width:%201%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-3_flowchart-v2-circleEnd-margin'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refY='5'%20refX='12.25'%20markerUnits='userSpaceOnUse'%20markerWidth='14'%20markerHeight='14'%20orient='auto'%3e%3ccircle%20cx='5'%20cy='5'%20r='5'%20class='arrowMarkerPath'%20style='stroke-width:%200%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-3_flowchart-v2-circleStart-margin'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='-2'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='14'%20markerHeight='14'%20orient='auto'%3e%3ccircle%20cx='5'%20cy='5'%20r='5'%20class='arrowMarkerPath'%20style='stroke-width:%200%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-3_flowchart-v2-crossEnd'%20class='marker%20cross%20flowchart-v2'%20viewBox='0%200%2011%2011'%20refX='12'%20refY='5.2'%20markerUnits='userSpaceOnUse'%20markerWidth='11'%20markerHeight='11'%20orient='auto'%3e%3cpath%20d='M%201%2c1%20l%209%2c9%20M%2010%2c1%20l%20-9%2c9'%20class='arrowMarkerPath'%20style='stroke-width:%202%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-3_flowchart-v2-crossStart'%20class='marker%20cross%20flowchart-v2'%20viewBox='0%200%2011%2011'%20refX='-1'%20refY='5.2'%20markerUnits='userSpaceOnUse'%20markerWidth='11'%20markerHeight='11'%20orient='auto'%3e%3cpath%20d='M%201%2c1%20l%209%2c9%20M%2010%2c1%20l%20-9%2c9'%20class='arrowMarkerPath'%20style='stroke-width:%202%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-3_flowchart-v2-crossEnd-margin'%20class='marker%20cross%20flowchart-v2'%20viewBox='0%200%2015%2015'%20refX='17.7'%20refY='7.5'%20markerUnits='userSpaceOnUse'%20markerWidth='12'%20markerHeight='12'%20orient='auto'%3e%3cpath%20d='M%201%2c1%20L%2014%2c14%20M%201%2c14%20L%2014%2c1'%20class='arrowMarkerPath'%20style='stroke-width:%202.5%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-3_flowchart-v2-crossStart-margin'%20class='marker%20cross%20flowchart-v2'%20viewBox='0%200%2015%2015'%20refX='-3.5'%20refY='7.5'%20markerUnits='userSpaceOnUse'%20markerWidth='12'%20markerHeight='12'%20orient='auto'%3e%3cpath%20d='M%201%2c1%20L%2014%2c14%20M%201%2c14%20L%2014%2c1'%20class='arrowMarkerPath'%20style='stroke-width:%202.5%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cg%20class='root'%3e%3cg%20class='clusters'/%3e%3cg%20class='edgePaths'%3e%3cpath%20d='M116%2c87L120.167%2c87C124.333%2c87%2c132.667%2c87%2c140.333%2c87C148%2c87%2c155%2c87%2c158.5%2c87L162%2c87'%20id='mermaid-dark-3-L_User_Gateway_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_User_Gateway_0'%20data-points='W3sieCI6MTE2LCJ5Ijo4N30seyJ4IjoxNDEsInkiOjg3fSx7IngiOjE2NiwieSI6ODd9XQ=='%20data-look='classic'%20marker-end='url(%23mermaid-dark-3_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M355.219%2c87L359.385%2c87C363.552%2c87%2c371.885%2c87%2c379.552%2c87C387.219%2c87%2c394.219%2c87%2c397.719%2c87L401.219%2c87'%20id='mermaid-dark-3-L_Gateway_Order_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_Gateway_Order_0'%20data-points='W3sieCI6MzU1LjIxODc1LCJ5Ijo4N30seyJ4IjozODAuMjE4NzUsInkiOjg3fSx7IngiOjQwNS4yMTg3NSwieSI6ODd9XQ=='%20data-look='classic'%20marker-end='url(%23mermaid-dark-3_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M538.753%2c60L547.114%2c55.833C555.476%2c51.667%2c572.199%2c43.333%2c584.283%2c39.167C596.367%2c35%2c603.813%2c35%2c607.535%2c35L611.258%2c35'%20id='mermaid-dark-3-L_Order_Payment_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_Order_Payment_0'%20data-points='W3sieCI6NTM4Ljc1Mjg1NDU2NzMwNzcsInkiOjYwfSx7IngiOjU4OC45MjE4NzUsInkiOjM1fSx7IngiOjYxNS4yNTc4MTI1LCJ5IjozNX1d'%20data-look='classic'%20marker-end='url(%23mermaid-dark-3_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M538.753%2c114L547.114%2c118.167C555.476%2c122.333%2c572.199%2c130.667%2c584.06%2c134.833C595.922%2c139%2c602.922%2c139%2c606.422%2c139L609.922%2c139'%20id='mermaid-dark-3-L_Order_Inventory_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_Order_Inventory_0'%20data-points='W3sieCI6NTM4Ljc1Mjg1NDU2NzMwNzcsInkiOjExNH0seyJ4Ijo1ODguOTIxODc1LCJ5IjoxMzl9LHsieCI6NjEzLjkyMTg3NSwieSI6MTM5fV0='%20data-look='classic'%20marker-end='url(%23mermaid-dark-3_flowchart-v2-pointEnd)'/%3e%3c/g%3e%3cg%20class='edgeLabels'%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_User_Gateway_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_Gateway_Order_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_Order_Payment_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_Order_Inventory_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cg%20class='nodes'%3e%3cg%20class='node%20default'%20id='mermaid-dark-3-flowchart-User-0'%20data-look='classic'%20transform='translate(62%2c%2087)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-54'%20y='-27'%20width='108'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-24%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='48'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3e%e5%a4%96%e9%83%a8%e7%94%a8%e6%88%b7%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-3-flowchart-Gateway-1'%20data-look='classic'%20transform='translate(260.609375%2c%2087)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-94.609375'%20y='-27'%20width='189.21875'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-64.609375%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='129.21875'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3eWAF%20/%20ELB%20/%20APIG%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-3-flowchart-Order-3'%20data-look='classic'%20transform='translate(484.5703125%2c%2087)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-79.3515625'%20y='-27'%20width='158.703125'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-49.3515625%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='98.703125'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3eOrder%20Service%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-3-flowchart-Payment-5'%20data-look='classic'%20transform='translate(705.7265625%2c%2035)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-90.46875'%20y='-27'%20width='180.9375'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-60.46875%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='120.9375'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3ePayment%20Service%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-3-flowchart-Inventory-7'%20data-look='classic'%20transform='translate(705.7265625%2c%20139)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-91.8046875'%20y='-27'%20width='183.609375'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-61.8046875%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='123.609375'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3eInventory%20Service%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cdefs%3e%3cfilter%20id='mermaid-dark-3-drop-shadow'%20height='130%25'%20width='130%25'%3e%3cfeDropShadow%20dx='4'%20dy='4'%20stdDeviation='0'%20flood-opacity='0.06'%20flood-color='white'/%3e%3c/filter%3e%3c/defs%3e%3cdefs%3e%3cfilter%20id='mermaid-dark-3-drop-shadow-small'%20height='150%25'%20width='150%25'%3e%3cfeDropShadow%20dx='2'%20dy='2'%20stdDeviation='0'%20flood-opacity='0.06'%20flood-color='white'/%3e%3c/filter%3e%3c/defs%3e%3clinearGradient%20id='mermaid-dark-3-gradient'%20gradientUnits='objectBoundingBox'%20x1='0%25'%20y1='0%25'%20x2='100%25'%20y2='0%25'%3e%3cstop%20offset='0%25'%20stop-color='%23cccccc'%20stop-opacity='1'/%3e%3cstop%20offset='100%25'%20stop-color='hsl(180%2c%200%25%2c%2018.3529411765%25)'%20stop-opacity='1'/%3e%3c/linearGradient%3e%3c/svg%3e)
图中从用户到 Order Service 是南北向流量;Order Service 到 Payment Service 和 Inventory Service 是东西向流量。因此,系统即使已经使用 API 网关,仍然 可能需要服务网格,两者解决的问题并不相同。
五、数据基础设施如何分工
企业应用通常组合多种数据服务,而不是寻找一种可以解决所有问题的存储系统。
| 服务 | 典型用途 | 需要继续掌握的通用知识 |
|---|---|---|
| RDS / MySQL | 持久化关系数据与事务 | SQL、索引、事务、锁、连接池 |
| Redis | 缓存、会话、计数器、临时状态 | 缓存策略、过期、持久化、一致性 |
| Kafka | 异步消息、事件传播、削峰与流处理 | Topic、Partition、Consumer Group、Offset |
| OBS | 图片、视频、安装包、备份等对象数据 | Bucket、Object Key、分片上传、临时授权 |
托管服务把备份、高可用、升级和基础监控等部分运维责任交给云平台,但不会替代 底层知识。例如,使用 RDS 仍需设计索引和事务;使用云 Redis 仍需处理缓存穿透 和数据一致性;使用 Kafka 仍需考虑消息顺序、重复消费与积压。
六、可观测性:描述系统的运行状态
生产系统不仅要“能够运行”,还必须回答服务是否健康、请求为何失败、延迟发生 在哪个环节,以及何时需要通知值班人员。可观测性通常建立在三类数据之上:
- Metrics:CPU、内存、请求量、错误率和延迟等时间序列指标;
- Logs:应用和基础设施产生的离散事件记录;
- Traces:一次请求跨越多个服务形成的完整调用链。
三者解决的问题不同。指标适合发现“系统正在变差”,日志适合解释“具体发生了 什么”,链路追踪适合定位“问题发生在哪一跳”。统一传播 Trace ID,可以把一次 请求在网关、应用、消息消费者和数据库访问中的信息关联起来。
在华为云体系中,AOM 关注应用、容器和基础设施的运行监控,LTS 负责日志采集、 存储和查询,CES 提供云资源监控与告警能力。它们是相互协作的能力,而不是三选一。
七、用两条链路理解整套系统
面对复杂架构时,最有效的方法不是继续罗列产品,而是跟踪两条链路。
请求运行链路
假设用户调用 POST /orders,一次请求可能经历:
)%3b%7d%23mermaid-4 rect.note%5bdata-look='neo'%5d%7bstroke:%23aaaa33%3bfill:%23fff5ad%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-4 text.actor%26gt%3btspan%7bfill:black%3bstroke:none%3b%7d%23mermaid-4 .actor-line%7bstroke:%239370DB%3b%7d%23mermaid-4 .innerArc%7bstroke-width:1.5%3bstroke-dasharray:none%3b%7d%23mermaid-4 .messageLine0%7bstroke-width:1.5%3bstroke-dasharray:none%3bstroke:%23333%3b%7d%23mermaid-4 .messageLine1%7bstroke-width:1.5%3bstroke-dasharray:2%2c2%3bstroke:%23333%3b%7d%23mermaid-4 %5bid%24='-arrowhead'%5d path%7bfill:%23333%3bstroke:%23333%3b%7d%23mermaid-4 .sequenceNumber%7bfill:white%3b%7d%23mermaid-4 %5bid%24='-sequencenumber'%5d%7bfill:%23333%3b%7d%23mermaid-4 %5bid%24='-crosshead'%5d path%7bfill:%23333%3bstroke:%23333%3b%7d%23mermaid-4 .messageText%7bfill:%23333%3bstroke:none%3b%7d%23mermaid-4 .labelBox%7bstroke:%239370DB%3bfill:%23ECECFF%3bfilter:none%3b%7d%23mermaid-4 .labelText%2c%23mermaid-4 .labelText%26gt%3btspan%7bfill:black%3bstroke:none%3b%7d%23mermaid-4 .loopText%2c%23mermaid-4 .loopText%26gt%3btspan%7bfill:black%3bstroke:none%3b%7d%23mermaid-4 .sectionTitle%2c%23mermaid-4 .sectionTitle%26gt%3btspan%7bfill:black%3bstroke:none%3b%7d%23mermaid-4 .loopLine%7bstroke-width:2px%3bstroke-dasharray:2%2c2%3bstroke:%239370DB%3bfill:%239370DB%3b%7d%23mermaid-4 .note%7bstroke:%23aaaa33%3bfill:%23fff5ad%3b%7d%23mermaid-4 .noteText%2c%23mermaid-4 .noteText%26gt%3btspan%7bfill:black%3bstroke:none%3bfont-weight:normal%3b%7d%23mermaid-4 .activation0%7bfill:%23f4f4f4%3bstroke:%23666%3b%7d%23mermaid-4 .activation1%7bfill:%23f4f4f4%3bstroke:%23666%3b%7d%23mermaid-4 .activation2%7bfill:%23f4f4f4%3bstroke:%23666%3b%7d%23mermaid-4 .actorPopupMenu%7bposition:absolute%3b%7d%23mermaid-4 .actorPopupMenuPanel%7bposition:absolute%3bfill:%23ECECFF%3bbox-shadow:0px 8px 16px 0px rgba(0%2c0%2c0%2c0.2)%3bfilter:drop-shadow(3px 5px 2px rgb(0 0 0 / 0.4))%3b%7d%23mermaid-4 .actor-man circle%2c%23mermaid-4 line%7bfill:%23ECECFF%3bstroke-width:2px%3b%7d%23mermaid-4 g rect.rect%7bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3bstroke:%239370DB%3b%7d%23mermaid-4 .node .neo-node%7bstroke:%239370DB%3b%7d%23mermaid-4 %5bdata-look='neo'%5d.node rect%2c%23mermaid-4 %5bdata-look='neo'%5d.cluster rect%2c%23mermaid-4 %5bdata-look='neo'%5d.node polygon%7bstroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-4 %5bdata-look='neo'%5d.swimlane.cluster rect%7bfilter:none%3b%7d%23mermaid-4 %5bdata-look='neo'%5d.node path%7bstroke:%239370DB%3bstroke-width:1px%3b%7d%23mermaid-4 %5bdata-look='neo'%5d.node .outer-path%7bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-4 %5bdata-look='neo'%5d.node .neo-line path%7bstroke:%239370DB%3bfilter:none%3b%7d%23mermaid-4 %5bdata-look='neo'%5d.node circle%7bstroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-4 %5bdata-look='neo'%5d.node circle .state-start%7bfill:black%3b%7d%23mermaid-4 %5bdata-look='neo'%5d.icon-shape .icon%7bfill:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-4 %5bdata-look='neo'%5d.icon-shape .icon-neo path%7bstroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-4 :root%7b--mermaid-font-family:arial%2csans-serif%3b%7d%3c/style%3e%3cg/%3e%3cdefs%3e%3csymbol id='mermaid-4-computer' width='24' height='24'%3e%3cpath transform='scale(.5)' d='M2 2v13h20v-13h-20zm18 11h-16v-9h16v9zm-10.228 6l.466-1h3.524l.467 1h-4.457zm14.228 3h-24l2-6h2.104l-1.33 4h18.45l-1.297-4h2.073l2 6zm-5-10h-14v-7h14v7z'/%3e%3c/symbol%3e%3c/defs%3e%3cdefs%3e%3csymbol id='mermaid-4-database' fill-rule='evenodd' clip-rule='evenodd'%3e%3cpath transform='scale(.5)' d='M12.258.001l.256.004.255.005.253.008.251.01.249.012.247.015.246.016.242.019.241.02.239.023.236.024.233.027.231.028.229.031.225.032.223.034.22.036.217.038.214.04.211.041.208.043.205.045.201.046.198.048.194.05.191.051.187.053.183.054.18.056.175.057.172.059.168.06.163.061.16.063.155.064.15.066.074.033.073.033.071.034.07.034.069.035.068.035.067.035.066.035.064.036.064.036.062.036.06.036.06.037.058.037.058.037.055.038.055.038.053.038.052.038.051.039.05.039.048.039.047.039.045.04.044.04.043.04.041.04.04.041.039.041.037.041.036.041.034.041.033.042.032.042.03.042.029.042.027.042.026.043.024.043.023.043.021.043.02.043.018.044.017.043.015.044.013.044.012.044.011.045.009.044.007.045.006.045.004.045.002.045.001.045v17l-.001.045-.002.045-.004.045-.006.045-.007.045-.009.044-.011.045-.012.044-.013.044-.015.044-.017.043-.018.044-.02.043-.021.043-.023.043-.024.043-.026.043-.027.042-.029.042-.03.042-.032.042-.033.042-.034.041-.036.041-.037.041-.039.041-.04.041-.041.04-.043.04-.044.04-.045.04-.047.039-.048.039-.05.039-.051.039-.052.038-.053.038-.055.038-.055.038-.058.037-.058.037-.06.037-.06.036-.062.036-.064.036-.064.036-.066.035-.067.035-.068.035-.069.035-.07.034-.071.034-.073.033-.074.033-.15.066-.155.064-.16.063-.163.061-.168.06-.172.059-.175.057-.18.056-.183.054-.187.053-.191.051-.194.05-.198.048-.201.046-.205.045-.208.043-.211.041-.214.04-.217.038-.22.036-.223.034-.225.032-.229.031-.231.028-.233.027-.236.024-.239.023-.241.02-.242.019-.246.016-.247.015-.249.012-.251.01-.253.008-.255.005-.256.004-.258.001-.258-.001-.256-.004-.255-.005-.253-.008-.251-.01-.249-.012-.247-.015-.245-.016-.243-.019-.241-.02-.238-.023-.236-.024-.234-.027-.231-.028-.228-.031-.226-.032-.223-.034-.22-.036-.217-.038-.214-.04-.211-.041-.208-.043-.204-.045-.201-.046-.198-.048-.195-.05-.19-.051-.187-.053-.184-.054-.179-.056-.176-.057-.172-.059-.167-.06-.164-.061-.159-.063-.155-.064-.151-.066-.074-.033-.072-.033-.072-.034-.07-.034-.069-.035-.068-.035-.067-.035-.066-.035-.064-.036-.063-.036-.062-.036-.061-.036-.06-.037-.058-.037-.057-.037-.056-.038-.055-.038-.053-.038-.052-.038-.051-.039-.049-.039-.049-.039-.046-.039-.046-.04-.044-.04-.043-.04-.041-.04-.04-.041-.039-.041-.037-.041-.036-.041-.034-.041-.033-.042-.032-.042-.03-.042-.029-.042-.027-.042-.026-.043-.024-.043-.023-.043-.021-.043-.02-.043-.018-.044-.017-.043-.015-.044-.013-.044-.012-.044-.011-.045-.009-.044-.007-.045-.006-.045-.004-.045-.002-.045-.001-.045v-17l.001-.045.002-.045.004-.045.006-.045.007-.045.009-.044.011-.045.012-.044.013-.044.015-.044.017-.043.018-.044.02-.043.021-.043.023-.043.024-.043.026-.043.027-.042.029-.042.03-.042.032-.042.033-.042.034-.041.036-.041.037-.041.039-.041.04-.041.041-.04.043-.04.044-.04.046-.04.046-.039.049-.039.049-.039.051-.039.052-.038.053-.038.055-.038.056-.038.057-.037.058-.037.06-.037.061-.036.062-.036.063-.036.064-.036.066-.035.067-.035.068-.035.069-.035.07-.034.072-.034.072-.033.074-.033.151-.066.155-.064.159-.063.164-.061.167-.06.172-.059.176-.057.179-.056.184-.054.187-.053.19-.051.195-.05.198-.048.201-.046.204-.045.208-.043.211-.041.214-.04.217-.038.22-.036.223-.034.226-.032.228-.031.231-.028.234-.027.236-.024.238-.023.241-.02.243-.019.245-.016.247-.015.249-.012.251-.01.253-.008.255-.005.256-.004.258-.001.258.001zm-9.258 20.499v.01l.001.021.003.021.004.022.005.021.006.022.007.022.009.023.01.022.011.023.012.023.013.023.015.023.016.024.017.023.018.024.019.024.021.024.022.025.023.024.024.025.052.049.056.05.061.051.066.051.07.051.075.051.079.052.084.052.088.052.092.052.097.052.102.051.105.052.11.052.114.051.119.051.123.051.127.05.131.05.135.05.139.048.144.049.147.047.152.047.155.047.16.045.163.045.167.043.171.043.176.041.178.041.183.039.187.039.19.037.194.035.197.035.202.033.204.031.209.03.212.029.216.027.219.025.222.024.226.021.23.02.233.018.236.016.24.015.243.012.246.01.249.008.253.005.256.004.259.001.26-.001.257-.004.254-.005.25-.008.247-.011.244-.012.241-.014.237-.016.233-.018.231-.021.226-.021.224-.024.22-.026.216-.027.212-.028.21-.031.205-.031.202-.034.198-.034.194-.036.191-.037.187-.039.183-.04.179-.04.175-.042.172-.043.168-.044.163-.045.16-.046.155-.046.152-.047.148-.048.143-.049.139-.049.136-.05.131-.05.126-.05.123-.051.118-.052.114-.051.11-.052.106-.052.101-.052.096-.052.092-.052.088-.053.083-.051.079-.052.074-.052.07-.051.065-.051.06-.051.056-.05.051-.05.023-.024.023-.025.021-.024.02-.024.019-.024.018-.024.017-.024.015-.023.014-.024.013-.023.012-.023.01-.023.01-.022.008-.022.006-.022.006-.022.004-.022.004-.021.001-.021.001-.021v-4.127l-.077.055-.08.053-.083.054-.085.053-.087.052-.09.052-.093.051-.095.05-.097.05-.1.049-.102.049-.105.048-.106.047-.109.047-.111.046-.114.045-.115.045-.118.044-.12.043-.122.042-.124.042-.126.041-.128.04-.13.04-.132.038-.134.038-.135.037-.138.037-.139.035-.142.035-.143.034-.144.033-.147.032-.148.031-.15.03-.151.03-.153.029-.154.027-.156.027-.158.026-.159.025-.161.024-.162.023-.163.022-.165.021-.166.02-.167.019-.169.018-.169.017-.171.016-.173.015-.173.014-.175.013-.175.012-.177.011-.178.01-.179.008-.179.008-.181.006-.182.005-.182.004-.184.003-.184.002h-.37l-.184-.002-.184-.003-.182-.004-.182-.005-.181-.006-.179-.008-.179-.008-.178-.01-.176-.011-.176-.012-.175-.013-.173-.014-.172-.015-.171-.016-.17-.017-.169-.018-.167-.019-.166-.02-.165-.021-.163-.022-.162-.023-.161-.024-.159-.025-.157-.026-.156-.027-.155-.027-.153-.029-.151-.03-.15-.03-.148-.031-.146-.032-.145-.033-.143-.034-.141-.035-.14-.035-.137-.037-.136-.037-.134-.038-.132-.038-.13-.04-.128-.04-.126-.041-.124-.042-.122-.042-.12-.044-.117-.043-.116-.045-.113-.045-.112-.046-.109-.047-.106-.047-.105-.048-.102-.049-.1-.049-.097-.05-.095-.05-.093-.052-.09-.051-.087-.052-.085-.053-.083-.054-.08-.054-.077-.054v4.127zm0-5.654v.011l.001.021.003.021.004.021.005.022.006.022.007.022.009.022.01.022.011.023.012.023.013.023.015.024.016.023.017.024.018.024.019.024.021.024.022.024.023.025.024.024.052.05.056.05.061.05.066.051.07.051.075.052.079.051.084.052.088.052.092.052.097.052.102.052.105.052.11.051.114.051.119.052.123.05.127.051.131.05.135.049.139.049.144.048.147.048.152.047.155.046.16.045.163.045.167.044.171.042.176.042.178.04.183.04.187.038.19.037.194.036.197.034.202.033.204.032.209.03.212.028.216.027.219.025.222.024.226.022.23.02.233.018.236.016.24.014.243.012.246.01.249.008.253.006.256.003.259.001.26-.001.257-.003.254-.006.25-.008.247-.01.244-.012.241-.015.237-.016.233-.018.231-.02.226-.022.224-.024.22-.025.216-.027.212-.029.21-.03.205-.032.202-.033.198-.035.194-.036.191-.037.187-.039.183-.039.179-.041.175-.042.172-.043.168-.044.163-.045.16-.045.155-.047.152-.047.148-.048.143-.048.139-.05.136-.049.131-.05.126-.051.123-.051.118-.051.114-.052.11-.052.106-.052.101-.052.096-.052.092-.052.088-.052.083-.052.079-.052.074-.051.07-.052.065-.051.06-.05.056-.051.051-.049.023-.025.023-.024.021-.025.02-.024.019-.024.018-.024.017-.024.015-.023.014-.023.013-.024.012-.022.01-.023.01-.023.008-.022.006-.022.006-.022.004-.021.004-.022.001-.021.001-.021v-4.139l-.077.054-.08.054-.083.054-.085.052-.087.053-.09.051-.093.051-.095.051-.097.05-.1.049-.102.049-.105.048-.106.047-.109.047-.111.046-.114.045-.115.044-.118.044-.12.044-.122.042-.124.042-.126.041-.128.04-.13.039-.132.039-.134.038-.135.037-.138.036-.139.036-.142.035-.143.033-.144.033-.147.033-.148.031-.15.03-.151.03-.153.028-.154.028-.156.027-.158.026-.159.025-.161.024-.162.023-.163.022-.165.021-.166.02-.167.019-.169.018-.169.017-.171.016-.173.015-.173.014-.175.013-.175.012-.177.011-.178.009-.179.009-.179.007-.181.007-.182.005-.182.004-.184.003-.184.002h-.37l-.184-.002-.184-.003-.182-.004-.182-.005-.181-.007-.179-.007-.179-.009-.178-.009-.176-.011-.176-.012-.175-.013-.173-.014-.172-.015-.171-.016-.17-.017-.169-.018-.167-.019-.166-.02-.165-.021-.163-.022-.162-.023-.161-.024-.159-.025-.157-.026-.156-.027-.155-.028-.153-.028-.151-.03-.15-.03-.148-.031-.146-.033-.145-.033-.143-.033-.141-.035-.14-.036-.137-.036-.136-.037-.134-.038-.132-.039-.13-.039-.128-.04-.126-.041-.124-.042-.122-.043-.12-.043-.117-.044-.116-.044-.113-.046-.112-.046-.109-.046-.106-.047-.105-.048-.102-.049-.1-.049-.097-.05-.095-.051-.093-.051-.09-.051-.087-.053-.085-.052-.083-.054-.08-.054-.077-.054v4.139zm0-5.666v.011l.001.02.003.022.004.021.005.022.006.021.007.022.009.023.01.022.011.023.012.023.013.023.015.023.016.024.017.024.018.023.019.024.021.025.022.024.023.024.024.025.052.05.056.05.061.05.066.051.07.051.075.052.079.051.084.052.088.052.092.052.097.052.102.052.105.051.11.052.114.051.119.051.123.051.127.05.131.05.135.05.139.049.144.048.147.048.152.047.155.046.16.045.163.045.167.043.171.043.176.042.178.04.183.04.187.038.19.037.194.036.197.034.202.033.204.032.209.03.212.028.216.027.219.025.222.024.226.021.23.02.233.018.236.017.24.014.243.012.246.01.249.008.253.006.256.003.259.001.26-.001.257-.003.254-.006.25-.008.247-.01.244-.013.241-.014.237-.016.233-.018.231-.02.226-.022.224-.024.22-.025.216-.027.212-.029.21-.03.205-.032.202-.033.198-.035.194-.036.191-.037.187-.039.183-.039.179-.041.175-.042.172-.043.168-.044.163-.045.16-.045.155-.047.152-.047.148-.048.143-.049.139-.049.136-.049.131-.051.126-.05.123-.051.118-.052.114-.051.11-.052.106-.052.101-.052.096-.052.092-.052.088-.052.083-.052.079-.052.074-.052.07-.051.065-.051.06-.051.056-.05.051-.049.023-.025.023-.025.021-.024.02-.024.019-.024.018-.024.017-.024.015-.023.014-.024.013-.023.012-.023.01-.022.01-.023.008-.022.006-.022.006-.022.004-.022.004-.021.001-.021.001-.021v-4.153l-.077.054-.08.054-.083.053-.085.053-.087.053-.09.051-.093.051-.095.051-.097.05-.1.049-.102.048-.105.048-.106.048-.109.046-.111.046-.114.046-.115.044-.118.044-.12.043-.122.043-.124.042-.126.041-.128.04-.13.039-.132.039-.134.038-.135.037-.138.036-.139.036-.142.034-.143.034-.144.033-.147.032-.148.032-.15.03-.151.03-.153.028-.154.028-.156.027-.158.026-.159.024-.161.024-.162.023-.163.023-.165.021-.166.02-.167.019-.169.018-.169.017-.171.016-.173.015-.173.014-.175.013-.175.012-.177.01-.178.01-.179.009-.179.007-.181.006-.182.006-.182.004-.184.003-.184.001-.185.001-.185-.001-.184-.001-.184-.003-.182-.004-.182-.006-.181-.006-.179-.007-.179-.009-.178-.01-.176-.01-.176-.012-.175-.013-.173-.014-.172-.015-.171-.016-.17-.017-.169-.018-.167-.019-.166-.02-.165-.021-.163-.023-.162-.023-.161-.024-.159-.024-.157-.026-.156-.027-.155-.028-.153-.028-.151-.03-.15-.03-.148-.032-.146-.032-.145-.033-.143-.034-.141-.034-.14-.036-.137-.036-.136-.037-.134-.038-.132-.039-.13-.039-.128-.041-.126-.041-.124-.041-.122-.043-.12-.043-.117-.044-.116-.044-.113-.046-.112-.046-.109-.046-.106-.048-.105-.048-.102-.048-.1-.05-.097-.049-.095-.051-.093-.051-.09-.052-.087-.052-.085-.053-.083-.053-.08-.054-.077-.054v4.153zm8.74-8.179l-.257.004-.254.005-.25.008-.247.011-.244.012-.241.014-.237.016-.233.018-.231.021-.226.022-.224.023-.22.026-.216.027-.212.028-.21.031-.205.032-.202.033-.198.034-.194.036-.191.038-.187.038-.183.04-.179.041-.175.042-.172.043-.168.043-.163.045-.16.046-.155.046-.152.048-.148.048-.143.048-.139.049-.136.05-.131.05-.126.051-.123.051-.118.051-.114.052-.11.052-.106.052-.101.052-.096.052-.092.052-.088.052-.083.052-.079.052-.074.051-.07.052-.065.051-.06.05-.056.05-.051.05-.023.025-.023.024-.021.024-.02.025-.019.024-.018.024-.017.023-.015.024-.014.023-.013.023-.012.023-.01.023-.01.022-.008.022-.006.023-.006.021-.004.022-.004.021-.001.021-.001.021.001.021.001.021.004.021.004.022.006.021.006.023.008.022.01.022.01.023.012.023.013.023.014.023.015.024.017.023.018.024.019.024.02.025.021.024.023.024.023.025.051.05.056.05.06.05.065.051.07.052.074.051.079.052.083.052.088.052.092.052.096.052.101.052.106.052.11.052.114.052.118.051.123.051.126.051.131.05.136.05.139.049.143.048.148.048.152.048.155.046.16.046.163.045.168.043.172.043.175.042.179.041.183.04.187.038.191.038.194.036.198.034.202.033.205.032.21.031.212.028.216.027.22.026.224.023.226.022.231.021.233.018.237.016.241.014.244.012.247.011.25.008.254.005.257.004.26.001.26-.001.257-.004.254-.005.25-.008.247-.011.244-.012.241-.014.237-.016.233-.018.231-.021.226-.022.224-.023.22-.026.216-.027.212-.028.21-.031.205-.032.202-.033.198-.034.194-.036.191-.038.187-.038.183-.04.179-.041.175-.042.172-.043.168-.043.163-.045.16-.046.155-.046.152-.048.148-.048.143-.048.139-.049.136-.05.131-.05.126-.051.123-.051.118-.051.114-.052.11-.052.106-.052.101-.052.096-.052.092-.052.088-.052.083-.052.079-.052.074-.051.07-.052.065-.051.06-.05.056-.05.051-.05.023-.025.023-.024.021-.024.02-.025.019-.024.018-.024.017-.023.015-.024.014-.023.013-.023.012-.023.01-.023.01-.022.008-.022.006-.023.006-.021.004-.022.004-.021.001-.021.001-.021-.001-.021-.001-.021-.004-.021-.004-.022-.006-.021-.006-.023-.008-.022-.01-.022-.01-.023-.012-.023-.013-.023-.014-.023-.015-.024-.017-.023-.018-.024-.019-.024-.02-.025-.021-.024-.023-.024-.023-.025-.051-.05-.056-.05-.06-.05-.065-.051-.07-.052-.074-.051-.079-.052-.083-.052-.088-.052-.092-.052-.096-.052-.101-.052-.106-.052-.11-.052-.114-.052-.118-.051-.123-.051-.126-.051-.131-.05-.136-.05-.139-.049-.143-.048-.148-.048-.152-.048-.155-.046-.16-.046-.163-.045-.168-.043-.172-.043-.175-.042-.179-.041-.183-.04-.187-.038-.191-.038-.194-.036-.198-.034-.202-.033-.205-.032-.21-.031-.212-.028-.216-.027-.22-.026-.224-.023-.226-.022-.231-.021-.233-.018-.237-.016-.241-.014-.244-.012-.247-.011-.25-.008-.254-.005-.257-.004-.26-.001-.26.001z'/%3e%3c/symbol%3e%3c/defs%3e%3cdefs%3e%3csymbol id='mermaid-4-clock' width='24' height='24'%3e%3cpath transform='scale(.5)' d='M12 2c5.514 0 10 4.486 10 10s-4.486 10-10 10-10-4.486-10-10 4.486-10 10-10zm0-2c-6.627 0-12 5.373-12 12s5.373 12 12 12 12-5.373 12-12-5.373-12-12-12zm5.848 12.459c.202.038.202.333.001.372-1.907.361-6.045 1.111-6.547 1.111-.719 0-1.301-.582-1.301-1.301 0-.512.77-5.447 1.125-7.445.034-.192.312-.181.343.014l.985 6.238 5.394 1.011z'/%3e%3c/symbol%3e%3c/defs%3e%3cdefs%3e%3cmarker id='mermaid-4-arrowhead' refX='7.9' refY='5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto-start-reverse'%3e%3cpath d='M -1 0 L 10 5 L 0 10 z'/%3e%3c/marker%3e%3c/defs%3e%3cdefs%3e%3cmarker id='mermaid-4-crosshead' markerWidth='15' markerHeight='8' orient='auto' refX='4' refY='4.5'%3e%3cpath fill='none' stroke='black' stroke-width='1pt' d='M 1%2c2 L 6%2c7 M 6%2c2 L 1%2c7' style='stroke-dasharray: 0%2c 0%3b'/%3e%3c/marker%3e%3c/defs%3e%3cdefs%3e%3cmarker id='mermaid-4-filled-head' refX='15.5' refY='7' markerWidth='20' markerHeight='28' orient='auto'%3e%3cpath d='M 18%2c7 L9%2c13 L14%2c7 L9%2c1 Z'/%3e%3c/marker%3e%3c/defs%3e%3cdefs%3e%3cmarker id='mermaid-4-sequencenumber' refX='15' refY='15' markerWidth='60' markerHeight='40' orient='auto'%3e%3ccircle cx='15' cy='15' r='6'/%3e%3c/marker%3e%3c/defs%3e%3cdefs%3e%3cmarker id='mermaid-4-solidTopArrowHead' refX='7.9' refY='7.25' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto-start-reverse'%3e%3cpath d='M 0 0 L 10 8 L 0 8 z'/%3e%3c/marker%3e%3c/defs%3e%3cdefs%3e%3cmarker id='mermaid-4-solidBottomArrowHead' refX='7.9' refY='0.75' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto-start-reverse'%3e%3cpath d='M 0 0 L 10 0 L 0 8 z'/%3e%3c/marker%3e%3c/defs%3e%3cdefs%3e%3cmarker id='mermaid-4-stickTopArrowHead' refX='7.5' refY='7' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto-start-reverse'%3e%3cpath d='M 0 0 L 7 7' stroke='black' stroke-width='1.5' fill='none'/%3e%3c/marker%3e%3c/defs%3e%3cdefs%3e%3cmarker id='mermaid-4-stickBottomArrowHead' refX='7.5' refY='0' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto-start-reverse'%3e%3cpath d='M 0 7 L 7 0' stroke='black' stroke-width='1.5' fill='none'/%3e%3c/marker%3e%3c/defs%3e%3ctext x='183' y='80' text-anchor='middle' dominant-baseline='middle' alignment-baseline='middle' class='messageText' dy='1em' style='font-family: arial%2c sans-serif%3b font-size: 16px%3b font-weight: 400%3b'%3e%e8%ae%bf%e9%97%ae api.example.com%3c/text%3e%3cline x1='76' y1='109' x2='290' y2='109' class='messageLine0' data-et='message' data-id='i0' data-from='Client' data-to='Edge' stroke-width='2' stroke='none' marker-end='url(%23mermaid-4-arrowhead)' style='fill: none%3b'/%3e%3ctext x='393' y='124' text-anchor='middle' dominant-baseline='middle' alignment-baseline='middle' class='messageText' dy='1em' style='font-family: arial%2c sans-serif%3b font-size: 16px%3b font-weight: 400%3b'%3e%e5%ae%89%e5%85%a8%e6%a3%80%e6%9f%a5%e4%b8%8e%e6%b5%81%e9%87%8f%e8%bd%ac%e5%8f%91%3c/text%3e%3cline x1='295' y1='153' x2='490' y2='153' class='messageLine0' data-et='message' data-id='i1' data-from='Edge' data-to='API' stroke-width='2' stroke='none' marker-end='url(%23mermaid-4-arrowhead)' style='fill: none%3b'/%3e%3ctext x='593' y='168' text-anchor='middle' dominant-baseline='middle' alignment-baseline='middle' class='messageText' dy='1em' style='font-family: arial%2c sans-serif%3b font-size: 16px%3b font-weight: 400%3b'%3e%e9%89%b4%e6%9d%83%e3%80%81%e9%99%90%e6%b5%81%e4%b8%8e%e8%b7%af%e7%94%b1%3c/text%3e%3cline x1='495' y1='197' x2='690' y2='197' class='messageLine0' data-et='message' data-id='i2' data-from='API' data-to='App' stroke-width='2' stroke='none' marker-end='url(%23mermaid-4-arrowhead)' style='fill: none%3b'/%3e%3ctext x='793' y='212' text-anchor='middle' dominant-baseline='middle' alignment-baseline='middle' class='messageText' dy='1em' style='font-family: arial%2c sans-serif%3b font-size: 16px%3b font-weight: 400%3b'%3e%e6%9f%a5%e8%af%a2%e7%bc%93%e5%ad%98%3c/text%3e%3cline x1='695' y1='241' x2='890' y2='241' class='messageLine0' data-et='message' data-id='i3' data-from='App' data-to='Cache' stroke-width='2' stroke='none' marker-end='url(%23mermaid-4-arrowhead)' style='fill: none%3b'/%3e%3ctext x='893' y='256' text-anchor='middle' dominant-baseline='middle' alignment-baseline='middle' class='messageText' dy='1em' style='font-family: arial%2c sans-serif%3b font-size: 16px%3b font-weight: 400%3b'%3e%e5%86%99%e5%85%a5%e8%ae%a2%e5%8d%95%3c/text%3e%3cline x1='695' y1='285' x2='1090' y2='285' class='messageLine0' data-et='message' data-id='i4' data-from='App' data-to='DB' stroke-width='2' stroke='none' marker-end='url(%23mermaid-4-arrowhead)' style='fill: none%3b'/%3e%3ctext x='993' y='300' text-anchor='middle' dominant-baseline='middle' alignment-baseline='middle' class='messageText' dy='1em' style='font-family: arial%2c sans-serif%3b font-size: 16px%3b font-weight: 400%3b'%3e%e5%8f%91%e5%b8%83 OrderCreated%3c/text%3e%3cline x1='695' y1='329' x2='1290' y2='329' class='messageLine0' data-et='message' data-id='i5' data-from='App' data-to='MQ' stroke-width='2' stroke='none' marker-end='url(%23mermaid-4-arrowhead)' style='fill: none%3b'/%3e%3ctext x='386' y='344' text-anchor='middle' dominant-baseline='middle' alignment-baseline='middle' class='messageText' dy='1em' style='font-family: arial%2c sans-serif%3b font-size: 16px%3b font-weight: 400%3b'%3e%e8%bf%94%e5%9b%9e%e5%93%8d%e5%ba%94%3c/text%3e%3cline x1='693' y1='373' x2='79' y2='373' class='messageLine1' data-et='message' data-id='i6' data-from='App' data-to='Client' stroke-width='2' stroke='none' marker-end='url(%23mermaid-4-arrowhead)' style='stroke-dasharray: 3%2c 3%3b fill: none%3b'/%3e%3c/svg%3e)
)%3b%7d%23mermaid-dark-4%20rect.note%5bdata-look='neo'%5d%7bstroke:hsl(180%2c%200%25%2c%2018.3529411765%25)%3bfill:hsl(180%2c%201.5873015873%25%2c%2028.3529411765%25)%3bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-4%20text.actor%26gt%3btspan%7bfill:lightgrey%3bstroke:none%3b%7d%23mermaid-dark-4%20.actor-line%7bstroke:%23ccc%3b%7d%23mermaid-dark-4%20.innerArc%7bstroke-width:1.5%3bstroke-dasharray:none%3b%7d%23mermaid-dark-4%20.messageLine0%7bstroke-width:1.5%3bstroke-dasharray:none%3bstroke:lightgrey%3b%7d%23mermaid-dark-4%20.messageLine1%7bstroke-width:1.5%3bstroke-dasharray:2%2c2%3bstroke:lightgrey%3b%7d%23mermaid-dark-4%20%5bid%24='-arrowhead'%5d%20path%7bfill:lightgrey%3bstroke:lightgrey%3b%7d%23mermaid-dark-4%20.sequenceNumber%7bfill:black%3b%7d%23mermaid-dark-4%20%5bid%24='-sequencenumber'%5d%7bfill:lightgrey%3b%7d%23mermaid-dark-4%20%5bid%24='-crosshead'%5d%20path%7bfill:lightgrey%3bstroke:lightgrey%3b%7d%23mermaid-dark-4%20.messageText%7bfill:lightgrey%3bstroke:none%3b%7d%23mermaid-dark-4%20.labelBox%7bstroke:%23ccc%3bfill:%231f2020%3bfilter:none%3b%7d%23mermaid-dark-4%20.labelText%2c%23mermaid-dark-4%20.labelText%26gt%3btspan%7bfill:lightgrey%3bstroke:none%3b%7d%23mermaid-dark-4%20.loopText%2c%23mermaid-dark-4%20.loopText%26gt%3btspan%7bfill:lightgrey%3bstroke:none%3b%7d%23mermaid-dark-4%20.sectionTitle%2c%23mermaid-dark-4%20.sectionTitle%26gt%3btspan%7bfill:lightgrey%3bstroke:none%3b%7d%23mermaid-dark-4%20.loopLine%7bstroke-width:2px%3bstroke-dasharray:2%2c2%3bstroke:%23ccc%3bfill:%23ccc%3b%7d%23mermaid-dark-4%20.note%7bstroke:hsl(180%2c%200%25%2c%2018.3529411765%25)%3bfill:hsl(180%2c%201.5873015873%25%2c%2028.3529411765%25)%3b%7d%23mermaid-dark-4%20.noteText%2c%23mermaid-dark-4%20.noteText%26gt%3btspan%7bfill:rgb(183.8476190475%2c%20181.5523809523%2c%20181.5523809523)%3bstroke:none%3bfont-weight:normal%3b%7d%23mermaid-dark-4%20.activation0%7bfill:hsl(180%2c%201.5873015873%25%2c%2028.3529411765%25)%3bstroke:%23ccc%3b%7d%23mermaid-dark-4%20.activation1%7bfill:hsl(180%2c%201.5873015873%25%2c%2028.3529411765%25)%3bstroke:%23ccc%3b%7d%23mermaid-dark-4%20.activation2%7bfill:hsl(180%2c%201.5873015873%25%2c%2028.3529411765%25)%3bstroke:%23ccc%3b%7d%23mermaid-dark-4%20.actorPopupMenu%7bposition:absolute%3b%7d%23mermaid-dark-4%20.actorPopupMenuPanel%7bposition:absolute%3bfill:%231f2020%3bbox-shadow:0px%208px%2016px%200px%20rgba(0%2c0%2c0%2c0.2)%3bfilter:drop-shadow(3px%205px%202px%20rgb(0%200%200%20/%200.4))%3b%7d%23mermaid-dark-4%20.actor-man%20circle%2c%23mermaid-dark-4%20line%7bfill:%231f2020%3bstroke-width:2px%3b%7d%23mermaid-dark-4%20g%20rect.rect%7bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3bstroke:%23ccc%3b%7d%23mermaid-dark-4%20.node%20.neo-node%7bstroke:%23ccc%3b%7d%23mermaid-dark-4%20%5bdata-look='neo'%5d.node%20rect%2c%23mermaid-dark-4%20%5bdata-look='neo'%5d.cluster%20rect%2c%23mermaid-dark-4%20%5bdata-look='neo'%5d.node%20polygon%7bstroke:url(%23mermaid-dark-4-gradient)%3bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-4%20%5bdata-look='neo'%5d.swimlane.cluster%20rect%7bfilter:none%3b%7d%23mermaid-dark-4%20%5bdata-look='neo'%5d.node%20path%7bstroke:url(%23mermaid-dark-4-gradient)%3bstroke-width:1px%3b%7d%23mermaid-dark-4%20%5bdata-look='neo'%5d.node%20.outer-path%7bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-4%20%5bdata-look='neo'%5d.node%20.neo-line%20path%7bstroke:%23ccc%3bfilter:none%3b%7d%23mermaid-dark-4%20%5bdata-look='neo'%5d.node%20circle%7bstroke:url(%23mermaid-dark-4-gradient)%3bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-4%20%5bdata-look='neo'%5d.node%20circle%20.state-start%7bfill:black%3b%7d%23mermaid-dark-4%20%5bdata-look='neo'%5d.icon-shape%20.icon%7bfill:url(%23mermaid-dark-4-gradient)%3bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-4%20%5bdata-look='neo'%5d.icon-shape%20.icon-neo%20path%7bstroke:url(%23mermaid-dark-4-gradient)%3bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-4%20:root%7b--mermaid-font-family:arial%2csans-serif%3b%7d%3c/style%3e%3cg/%3e%3cdefs%3e%3csymbol%20id='mermaid-dark-4-computer'%20width='24'%20height='24'%3e%3cpath%20transform='scale(.5)'%20d='M2%202v13h20v-13h-20zm18%2011h-16v-9h16v9zm-10.228%206l.466-1h3.524l.467%201h-4.457zm14.228%203h-24l2-6h2.104l-1.33%204h18.45l-1.297-4h2.073l2%206zm-5-10h-14v-7h14v7z'/%3e%3c/symbol%3e%3c/defs%3e%3cdefs%3e%3csymbol%20id='mermaid-dark-4-database'%20fill-rule='evenodd'%20clip-rule='evenodd'%3e%3cpath%20transform='scale(.5)'%20d='M12.258.001l.256.004.255.005.253.008.251.01.249.012.247.015.246.016.242.019.241.02.239.023.236.024.233.027.231.028.229.031.225.032.223.034.22.036.217.038.214.04.211.041.208.043.205.045.201.046.198.048.194.05.191.051.187.053.183.054.18.056.175.057.172.059.168.06.163.061.16.063.155.064.15.066.074.033.073.033.071.034.07.034.069.035.068.035.067.035.066.035.064.036.064.036.062.036.06.036.06.037.058.037.058.037.055.038.055.038.053.038.052.038.051.039.05.039.048.039.047.039.045.04.044.04.043.04.041.04.04.041.039.041.037.041.036.041.034.041.033.042.032.042.03.042.029.042.027.042.026.043.024.043.023.043.021.043.02.043.018.044.017.043.015.044.013.044.012.044.011.045.009.044.007.045.006.045.004.045.002.045.001.045v17l-.001.045-.002.045-.004.045-.006.045-.007.045-.009.044-.011.045-.012.044-.013.044-.015.044-.017.043-.018.044-.02.043-.021.043-.023.043-.024.043-.026.043-.027.042-.029.042-.03.042-.032.042-.033.042-.034.041-.036.041-.037.041-.039.041-.04.041-.041.04-.043.04-.044.04-.045.04-.047.039-.048.039-.05.039-.051.039-.052.038-.053.038-.055.038-.055.038-.058.037-.058.037-.06.037-.06.036-.062.036-.064.036-.064.036-.066.035-.067.035-.068.035-.069.035-.07.034-.071.034-.073.033-.074.033-.15.066-.155.064-.16.063-.163.061-.168.06-.172.059-.175.057-.18.056-.183.054-.187.053-.191.051-.194.05-.198.048-.201.046-.205.045-.208.043-.211.041-.214.04-.217.038-.22.036-.223.034-.225.032-.229.031-.231.028-.233.027-.236.024-.239.023-.241.02-.242.019-.246.016-.247.015-.249.012-.251.01-.253.008-.255.005-.256.004-.258.001-.258-.001-.256-.004-.255-.005-.253-.008-.251-.01-.249-.012-.247-.015-.245-.016-.243-.019-.241-.02-.238-.023-.236-.024-.234-.027-.231-.028-.228-.031-.226-.032-.223-.034-.22-.036-.217-.038-.214-.04-.211-.041-.208-.043-.204-.045-.201-.046-.198-.048-.195-.05-.19-.051-.187-.053-.184-.054-.179-.056-.176-.057-.172-.059-.167-.06-.164-.061-.159-.063-.155-.064-.151-.066-.074-.033-.072-.033-.072-.034-.07-.034-.069-.035-.068-.035-.067-.035-.066-.035-.064-.036-.063-.036-.062-.036-.061-.036-.06-.037-.058-.037-.057-.037-.056-.038-.055-.038-.053-.038-.052-.038-.051-.039-.049-.039-.049-.039-.046-.039-.046-.04-.044-.04-.043-.04-.041-.04-.04-.041-.039-.041-.037-.041-.036-.041-.034-.041-.033-.042-.032-.042-.03-.042-.029-.042-.027-.042-.026-.043-.024-.043-.023-.043-.021-.043-.02-.043-.018-.044-.017-.043-.015-.044-.013-.044-.012-.044-.011-.045-.009-.044-.007-.045-.006-.045-.004-.045-.002-.045-.001-.045v-17l.001-.045.002-.045.004-.045.006-.045.007-.045.009-.044.011-.045.012-.044.013-.044.015-.044.017-.043.018-.044.02-.043.021-.043.023-.043.024-.043.026-.043.027-.042.029-.042.03-.042.032-.042.033-.042.034-.041.036-.041.037-.041.039-.041.04-.041.041-.04.043-.04.044-.04.046-.04.046-.039.049-.039.049-.039.051-.039.052-.038.053-.038.055-.038.056-.038.057-.037.058-.037.06-.037.061-.036.062-.036.063-.036.064-.036.066-.035.067-.035.068-.035.069-.035.07-.034.072-.034.072-.033.074-.033.151-.066.155-.064.159-.063.164-.061.167-.06.172-.059.176-.057.179-.056.184-.054.187-.053.19-.051.195-.05.198-.048.201-.046.204-.045.208-.043.211-.041.214-.04.217-.038.22-.036.223-.034.226-.032.228-.031.231-.028.234-.027.236-.024.238-.023.241-.02.243-.019.245-.016.247-.015.249-.012.251-.01.253-.008.255-.005.256-.004.258-.001.258.001zm-9.258%2020.499v.01l.001.021.003.021.004.022.005.021.006.022.007.022.009.023.01.022.011.023.012.023.013.023.015.023.016.024.017.023.018.024.019.024.021.024.022.025.023.024.024.025.052.049.056.05.061.051.066.051.07.051.075.051.079.052.084.052.088.052.092.052.097.052.102.051.105.052.11.052.114.051.119.051.123.051.127.05.131.05.135.05.139.048.144.049.147.047.152.047.155.047.16.045.163.045.167.043.171.043.176.041.178.041.183.039.187.039.19.037.194.035.197.035.202.033.204.031.209.03.212.029.216.027.219.025.222.024.226.021.23.02.233.018.236.016.24.015.243.012.246.01.249.008.253.005.256.004.259.001.26-.001.257-.004.254-.005.25-.008.247-.011.244-.012.241-.014.237-.016.233-.018.231-.021.226-.021.224-.024.22-.026.216-.027.212-.028.21-.031.205-.031.202-.034.198-.034.194-.036.191-.037.187-.039.183-.04.179-.04.175-.042.172-.043.168-.044.163-.045.16-.046.155-.046.152-.047.148-.048.143-.049.139-.049.136-.05.131-.05.126-.05.123-.051.118-.052.114-.051.11-.052.106-.052.101-.052.096-.052.092-.052.088-.053.083-.051.079-.052.074-.052.07-.051.065-.051.06-.051.056-.05.051-.05.023-.024.023-.025.021-.024.02-.024.019-.024.018-.024.017-.024.015-.023.014-.024.013-.023.012-.023.01-.023.01-.022.008-.022.006-.022.006-.022.004-.022.004-.021.001-.021.001-.021v-4.127l-.077.055-.08.053-.083.054-.085.053-.087.052-.09.052-.093.051-.095.05-.097.05-.1.049-.102.049-.105.048-.106.047-.109.047-.111.046-.114.045-.115.045-.118.044-.12.043-.122.042-.124.042-.126.041-.128.04-.13.04-.132.038-.134.038-.135.037-.138.037-.139.035-.142.035-.143.034-.144.033-.147.032-.148.031-.15.03-.151.03-.153.029-.154.027-.156.027-.158.026-.159.025-.161.024-.162.023-.163.022-.165.021-.166.02-.167.019-.169.018-.169.017-.171.016-.173.015-.173.014-.175.013-.175.012-.177.011-.178.01-.179.008-.179.008-.181.006-.182.005-.182.004-.184.003-.184.002h-.37l-.184-.002-.184-.003-.182-.004-.182-.005-.181-.006-.179-.008-.179-.008-.178-.01-.176-.011-.176-.012-.175-.013-.173-.014-.172-.015-.171-.016-.17-.017-.169-.018-.167-.019-.166-.02-.165-.021-.163-.022-.162-.023-.161-.024-.159-.025-.157-.026-.156-.027-.155-.027-.153-.029-.151-.03-.15-.03-.148-.031-.146-.032-.145-.033-.143-.034-.141-.035-.14-.035-.137-.037-.136-.037-.134-.038-.132-.038-.13-.04-.128-.04-.126-.041-.124-.042-.122-.042-.12-.044-.117-.043-.116-.045-.113-.045-.112-.046-.109-.047-.106-.047-.105-.048-.102-.049-.1-.049-.097-.05-.095-.05-.093-.052-.09-.051-.087-.052-.085-.053-.083-.054-.08-.054-.077-.054v4.127zm0-5.654v.011l.001.021.003.021.004.021.005.022.006.022.007.022.009.022.01.022.011.023.012.023.013.023.015.024.016.023.017.024.018.024.019.024.021.024.022.024.023.025.024.024.052.05.056.05.061.05.066.051.07.051.075.052.079.051.084.052.088.052.092.052.097.052.102.052.105.052.11.051.114.051.119.052.123.05.127.051.131.05.135.049.139.049.144.048.147.048.152.047.155.046.16.045.163.045.167.044.171.042.176.042.178.04.183.04.187.038.19.037.194.036.197.034.202.033.204.032.209.03.212.028.216.027.219.025.222.024.226.022.23.02.233.018.236.016.24.014.243.012.246.01.249.008.253.006.256.003.259.001.26-.001.257-.003.254-.006.25-.008.247-.01.244-.012.241-.015.237-.016.233-.018.231-.02.226-.022.224-.024.22-.025.216-.027.212-.029.21-.03.205-.032.202-.033.198-.035.194-.036.191-.037.187-.039.183-.039.179-.041.175-.042.172-.043.168-.044.163-.045.16-.045.155-.047.152-.047.148-.048.143-.048.139-.05.136-.049.131-.05.126-.051.123-.051.118-.051.114-.052.11-.052.106-.052.101-.052.096-.052.092-.052.088-.052.083-.052.079-.052.074-.051.07-.052.065-.051.06-.05.056-.051.051-.049.023-.025.023-.024.021-.025.02-.024.019-.024.018-.024.017-.024.015-.023.014-.023.013-.024.012-.022.01-.023.01-.023.008-.022.006-.022.006-.022.004-.021.004-.022.001-.021.001-.021v-4.139l-.077.054-.08.054-.083.054-.085.052-.087.053-.09.051-.093.051-.095.051-.097.05-.1.049-.102.049-.105.048-.106.047-.109.047-.111.046-.114.045-.115.044-.118.044-.12.044-.122.042-.124.042-.126.041-.128.04-.13.039-.132.039-.134.038-.135.037-.138.036-.139.036-.142.035-.143.033-.144.033-.147.033-.148.031-.15.03-.151.03-.153.028-.154.028-.156.027-.158.026-.159.025-.161.024-.162.023-.163.022-.165.021-.166.02-.167.019-.169.018-.169.017-.171.016-.173.015-.173.014-.175.013-.175.012-.177.011-.178.009-.179.009-.179.007-.181.007-.182.005-.182.004-.184.003-.184.002h-.37l-.184-.002-.184-.003-.182-.004-.182-.005-.181-.007-.179-.007-.179-.009-.178-.009-.176-.011-.176-.012-.175-.013-.173-.014-.172-.015-.171-.016-.17-.017-.169-.018-.167-.019-.166-.02-.165-.021-.163-.022-.162-.023-.161-.024-.159-.025-.157-.026-.156-.027-.155-.028-.153-.028-.151-.03-.15-.03-.148-.031-.146-.033-.145-.033-.143-.033-.141-.035-.14-.036-.137-.036-.136-.037-.134-.038-.132-.039-.13-.039-.128-.04-.126-.041-.124-.042-.122-.043-.12-.043-.117-.044-.116-.044-.113-.046-.112-.046-.109-.046-.106-.047-.105-.048-.102-.049-.1-.049-.097-.05-.095-.051-.093-.051-.09-.051-.087-.053-.085-.052-.083-.054-.08-.054-.077-.054v4.139zm0-5.666v.011l.001.02.003.022.004.021.005.022.006.021.007.022.009.023.01.022.011.023.012.023.013.023.015.023.016.024.017.024.018.023.019.024.021.025.022.024.023.024.024.025.052.05.056.05.061.05.066.051.07.051.075.052.079.051.084.052.088.052.092.052.097.052.102.052.105.051.11.052.114.051.119.051.123.051.127.05.131.05.135.05.139.049.144.048.147.048.152.047.155.046.16.045.163.045.167.043.171.043.176.042.178.04.183.04.187.038.19.037.194.036.197.034.202.033.204.032.209.03.212.028.216.027.219.025.222.024.226.021.23.02.233.018.236.017.24.014.243.012.246.01.249.008.253.006.256.003.259.001.26-.001.257-.003.254-.006.25-.008.247-.01.244-.013.241-.014.237-.016.233-.018.231-.02.226-.022.224-.024.22-.025.216-.027.212-.029.21-.03.205-.032.202-.033.198-.035.194-.036.191-.037.187-.039.183-.039.179-.041.175-.042.172-.043.168-.044.163-.045.16-.045.155-.047.152-.047.148-.048.143-.049.139-.049.136-.049.131-.051.126-.05.123-.051.118-.052.114-.051.11-.052.106-.052.101-.052.096-.052.092-.052.088-.052.083-.052.079-.052.074-.052.07-.051.065-.051.06-.051.056-.05.051-.049.023-.025.023-.025.021-.024.02-.024.019-.024.018-.024.017-.024.015-.023.014-.024.013-.023.012-.023.01-.022.01-.023.008-.022.006-.022.006-.022.004-.022.004-.021.001-.021.001-.021v-4.153l-.077.054-.08.054-.083.053-.085.053-.087.053-.09.051-.093.051-.095.051-.097.05-.1.049-.102.048-.105.048-.106.048-.109.046-.111.046-.114.046-.115.044-.118.044-.12.043-.122.043-.124.042-.126.041-.128.04-.13.039-.132.039-.134.038-.135.037-.138.036-.139.036-.142.034-.143.034-.144.033-.147.032-.148.032-.15.03-.151.03-.153.028-.154.028-.156.027-.158.026-.159.024-.161.024-.162.023-.163.023-.165.021-.166.02-.167.019-.169.018-.169.017-.171.016-.173.015-.173.014-.175.013-.175.012-.177.01-.178.01-.179.009-.179.007-.181.006-.182.006-.182.004-.184.003-.184.001-.185.001-.185-.001-.184-.001-.184-.003-.182-.004-.182-.006-.181-.006-.179-.007-.179-.009-.178-.01-.176-.01-.176-.012-.175-.013-.173-.014-.172-.015-.171-.016-.17-.017-.169-.018-.167-.019-.166-.02-.165-.021-.163-.023-.162-.023-.161-.024-.159-.024-.157-.026-.156-.027-.155-.028-.153-.028-.151-.03-.15-.03-.148-.032-.146-.032-.145-.033-.143-.034-.141-.034-.14-.036-.137-.036-.136-.037-.134-.038-.132-.039-.13-.039-.128-.041-.126-.041-.124-.041-.122-.043-.12-.043-.117-.044-.116-.044-.113-.046-.112-.046-.109-.046-.106-.048-.105-.048-.102-.048-.1-.05-.097-.049-.095-.051-.093-.051-.09-.052-.087-.052-.085-.053-.083-.053-.08-.054-.077-.054v4.153zm8.74-8.179l-.257.004-.254.005-.25.008-.247.011-.244.012-.241.014-.237.016-.233.018-.231.021-.226.022-.224.023-.22.026-.216.027-.212.028-.21.031-.205.032-.202.033-.198.034-.194.036-.191.038-.187.038-.183.04-.179.041-.175.042-.172.043-.168.043-.163.045-.16.046-.155.046-.152.048-.148.048-.143.048-.139.049-.136.05-.131.05-.126.051-.123.051-.118.051-.114.052-.11.052-.106.052-.101.052-.096.052-.092.052-.088.052-.083.052-.079.052-.074.051-.07.052-.065.051-.06.05-.056.05-.051.05-.023.025-.023.024-.021.024-.02.025-.019.024-.018.024-.017.023-.015.024-.014.023-.013.023-.012.023-.01.023-.01.022-.008.022-.006.023-.006.021-.004.022-.004.021-.001.021-.001.021.001.021.001.021.004.021.004.022.006.021.006.023.008.022.01.022.01.023.012.023.013.023.014.023.015.024.017.023.018.024.019.024.02.025.021.024.023.024.023.025.051.05.056.05.06.05.065.051.07.052.074.051.079.052.083.052.088.052.092.052.096.052.101.052.106.052.11.052.114.052.118.051.123.051.126.051.131.05.136.05.139.049.143.048.148.048.152.048.155.046.16.046.163.045.168.043.172.043.175.042.179.041.183.04.187.038.191.038.194.036.198.034.202.033.205.032.21.031.212.028.216.027.22.026.224.023.226.022.231.021.233.018.237.016.241.014.244.012.247.011.25.008.254.005.257.004.26.001.26-.001.257-.004.254-.005.25-.008.247-.011.244-.012.241-.014.237-.016.233-.018.231-.021.226-.022.224-.023.22-.026.216-.027.212-.028.21-.031.205-.032.202-.033.198-.034.194-.036.191-.038.187-.038.183-.04.179-.041.175-.042.172-.043.168-.043.163-.045.16-.046.155-.046.152-.048.148-.048.143-.048.139-.049.136-.05.131-.05.126-.051.123-.051.118-.051.114-.052.11-.052.106-.052.101-.052.096-.052.092-.052.088-.052.083-.052.079-.052.074-.051.07-.052.065-.051.06-.05.056-.05.051-.05.023-.025.023-.024.021-.024.02-.025.019-.024.018-.024.017-.023.015-.024.014-.023.013-.023.012-.023.01-.023.01-.022.008-.022.006-.023.006-.021.004-.022.004-.021.001-.021.001-.021-.001-.021-.001-.021-.004-.021-.004-.022-.006-.021-.006-.023-.008-.022-.01-.022-.01-.023-.012-.023-.013-.023-.014-.023-.015-.024-.017-.023-.018-.024-.019-.024-.02-.025-.021-.024-.023-.024-.023-.025-.051-.05-.056-.05-.06-.05-.065-.051-.07-.052-.074-.051-.079-.052-.083-.052-.088-.052-.092-.052-.096-.052-.101-.052-.106-.052-.11-.052-.114-.052-.118-.051-.123-.051-.126-.051-.131-.05-.136-.05-.139-.049-.143-.048-.148-.048-.152-.048-.155-.046-.16-.046-.163-.045-.168-.043-.172-.043-.175-.042-.179-.041-.183-.04-.187-.038-.191-.038-.194-.036-.198-.034-.202-.033-.205-.032-.21-.031-.212-.028-.216-.027-.22-.026-.224-.023-.226-.022-.231-.021-.233-.018-.237-.016-.241-.014-.244-.012-.247-.011-.25-.008-.254-.005-.257-.004-.26-.001-.26.001z'/%3e%3c/symbol%3e%3c/defs%3e%3cdefs%3e%3csymbol%20id='mermaid-dark-4-clock'%20width='24'%20height='24'%3e%3cpath%20transform='scale(.5)'%20d='M12%202c5.514%200%2010%204.486%2010%2010s-4.486%2010-10%2010-10-4.486-10-10%204.486-10%2010-10zm0-2c-6.627%200-12%205.373-12%2012s5.373%2012%2012%2012%2012-5.373%2012-12-5.373-12-12-12zm5.848%2012.459c.202.038.202.333.001.372-1.907.361-6.045%201.111-6.547%201.111-.719%200-1.301-.582-1.301-1.301%200-.512.77-5.447%201.125-7.445.034-.192.312-.181.343.014l.985%206.238%205.394%201.011z'/%3e%3c/symbol%3e%3c/defs%3e%3cdefs%3e%3cmarker%20id='mermaid-dark-4-arrowhead'%20refX='7.9'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='12'%20markerHeight='12'%20orient='auto-start-reverse'%3e%3cpath%20d='M%20-1%200%20L%2010%205%20L%200%2010%20z'/%3e%3c/marker%3e%3c/defs%3e%3cdefs%3e%3cmarker%20id='mermaid-dark-4-crosshead'%20markerWidth='15'%20markerHeight='8'%20orient='auto'%20refX='4'%20refY='4.5'%3e%3cpath%20fill='none'%20stroke='black'%20stroke-width='1pt'%20d='M%201%2c2%20L%206%2c7%20M%206%2c2%20L%201%2c7'%20style='stroke-dasharray:%200%2c%200%3b'/%3e%3c/marker%3e%3c/defs%3e%3cdefs%3e%3cmarker%20id='mermaid-dark-4-filled-head'%20refX='15.5'%20refY='7'%20markerWidth='20'%20markerHeight='28'%20orient='auto'%3e%3cpath%20d='M%2018%2c7%20L9%2c13%20L14%2c7%20L9%2c1%20Z'/%3e%3c/marker%3e%3c/defs%3e%3cdefs%3e%3cmarker%20id='mermaid-dark-4-sequencenumber'%20refX='15'%20refY='15'%20markerWidth='60'%20markerHeight='40'%20orient='auto'%3e%3ccircle%20cx='15'%20cy='15'%20r='6'/%3e%3c/marker%3e%3c/defs%3e%3cdefs%3e%3cmarker%20id='mermaid-dark-4-solidTopArrowHead'%20refX='7.9'%20refY='7.25'%20markerUnits='userSpaceOnUse'%20markerWidth='12'%20markerHeight='12'%20orient='auto-start-reverse'%3e%3cpath%20d='M%200%200%20L%2010%208%20L%200%208%20z'/%3e%3c/marker%3e%3c/defs%3e%3cdefs%3e%3cmarker%20id='mermaid-dark-4-solidBottomArrowHead'%20refX='7.9'%20refY='0.75'%20markerUnits='userSpaceOnUse'%20markerWidth='12'%20markerHeight='12'%20orient='auto-start-reverse'%3e%3cpath%20d='M%200%200%20L%2010%200%20L%200%208%20z'/%3e%3c/marker%3e%3c/defs%3e%3cdefs%3e%3cmarker%20id='mermaid-dark-4-stickTopArrowHead'%20refX='7.5'%20refY='7'%20markerUnits='userSpaceOnUse'%20markerWidth='12'%20markerHeight='12'%20orient='auto-start-reverse'%3e%3cpath%20d='M%200%200%20L%207%207'%20stroke='black'%20stroke-width='1.5'%20fill='none'/%3e%3c/marker%3e%3c/defs%3e%3cdefs%3e%3cmarker%20id='mermaid-dark-4-stickBottomArrowHead'%20refX='7.5'%20refY='0'%20markerUnits='userSpaceOnUse'%20markerWidth='12'%20markerHeight='12'%20orient='auto-start-reverse'%3e%3cpath%20d='M%200%207%20L%207%200'%20stroke='black'%20stroke-width='1.5'%20fill='none'/%3e%3c/marker%3e%3c/defs%3e%3ctext%20x='183'%20y='80'%20text-anchor='middle'%20dominant-baseline='middle'%20alignment-baseline='middle'%20class='messageText'%20dy='1em'%20style='font-family:%20arial%2c%20sans-serif%3b%20font-size:%2016px%3b%20font-weight:%20400%3b'%3e%e8%ae%bf%e9%97%ae%20api.example.com%3c/text%3e%3cline%20x1='76'%20y1='109'%20x2='290'%20y2='109'%20class='messageLine0'%20data-et='message'%20data-id='i0'%20data-from='Client'%20data-to='Edge'%20stroke-width='2'%20stroke='none'%20marker-end='url(%23mermaid-dark-4-arrowhead)'%20style='fill:%20none%3b'/%3e%3ctext%20x='393'%20y='124'%20text-anchor='middle'%20dominant-baseline='middle'%20alignment-baseline='middle'%20class='messageText'%20dy='1em'%20style='font-family:%20arial%2c%20sans-serif%3b%20font-size:%2016px%3b%20font-weight:%20400%3b'%3e%e5%ae%89%e5%85%a8%e6%a3%80%e6%9f%a5%e4%b8%8e%e6%b5%81%e9%87%8f%e8%bd%ac%e5%8f%91%3c/text%3e%3cline%20x1='295'%20y1='153'%20x2='490'%20y2='153'%20class='messageLine0'%20data-et='message'%20data-id='i1'%20data-from='Edge'%20data-to='API'%20stroke-width='2'%20stroke='none'%20marker-end='url(%23mermaid-dark-4-arrowhead)'%20style='fill:%20none%3b'/%3e%3ctext%20x='593'%20y='168'%20text-anchor='middle'%20dominant-baseline='middle'%20alignment-baseline='middle'%20class='messageText'%20dy='1em'%20style='font-family:%20arial%2c%20sans-serif%3b%20font-size:%2016px%3b%20font-weight:%20400%3b'%3e%e9%89%b4%e6%9d%83%e3%80%81%e9%99%90%e6%b5%81%e4%b8%8e%e8%b7%af%e7%94%b1%3c/text%3e%3cline%20x1='495'%20y1='197'%20x2='690'%20y2='197'%20class='messageLine0'%20data-et='message'%20data-id='i2'%20data-from='API'%20data-to='App'%20stroke-width='2'%20stroke='none'%20marker-end='url(%23mermaid-dark-4-arrowhead)'%20style='fill:%20none%3b'/%3e%3ctext%20x='793'%20y='212'%20text-anchor='middle'%20dominant-baseline='middle'%20alignment-baseline='middle'%20class='messageText'%20dy='1em'%20style='font-family:%20arial%2c%20sans-serif%3b%20font-size:%2016px%3b%20font-weight:%20400%3b'%3e%e6%9f%a5%e8%af%a2%e7%bc%93%e5%ad%98%3c/text%3e%3cline%20x1='695'%20y1='241'%20x2='890'%20y2='241'%20class='messageLine0'%20data-et='message'%20data-id='i3'%20data-from='App'%20data-to='Cache'%20stroke-width='2'%20stroke='none'%20marker-end='url(%23mermaid-dark-4-arrowhead)'%20style='fill:%20none%3b'/%3e%3ctext%20x='893'%20y='256'%20text-anchor='middle'%20dominant-baseline='middle'%20alignment-baseline='middle'%20class='messageText'%20dy='1em'%20style='font-family:%20arial%2c%20sans-serif%3b%20font-size:%2016px%3b%20font-weight:%20400%3b'%3e%e5%86%99%e5%85%a5%e8%ae%a2%e5%8d%95%3c/text%3e%3cline%20x1='695'%20y1='285'%20x2='1090'%20y2='285'%20class='messageLine0'%20data-et='message'%20data-id='i4'%20data-from='App'%20data-to='DB'%20stroke-width='2'%20stroke='none'%20marker-end='url(%23mermaid-dark-4-arrowhead)'%20style='fill:%20none%3b'/%3e%3ctext%20x='993'%20y='300'%20text-anchor='middle'%20dominant-baseline='middle'%20alignment-baseline='middle'%20class='messageText'%20dy='1em'%20style='font-family:%20arial%2c%20sans-serif%3b%20font-size:%2016px%3b%20font-weight:%20400%3b'%3e%e5%8f%91%e5%b8%83%20OrderCreated%3c/text%3e%3cline%20x1='695'%20y1='329'%20x2='1290'%20y2='329'%20class='messageLine0'%20data-et='message'%20data-id='i5'%20data-from='App'%20data-to='MQ'%20stroke-width='2'%20stroke='none'%20marker-end='url(%23mermaid-dark-4-arrowhead)'%20style='fill:%20none%3b'/%3e%3ctext%20x='386'%20y='344'%20text-anchor='middle'%20dominant-baseline='middle'%20alignment-baseline='middle'%20class='messageText'%20dy='1em'%20style='font-family:%20arial%2c%20sans-serif%3b%20font-size:%2016px%3b%20font-weight:%20400%3b'%3e%e8%bf%94%e5%9b%9e%e5%93%8d%e5%ba%94%3c/text%3e%3cline%20x1='693'%20y1='373'%20x2='79'%20y2='373'%20class='messageLine1'%20data-et='message'%20data-id='i6'%20data-from='App'%20data-to='Client'%20stroke-width='2'%20stroke='none'%20marker-end='url(%23mermaid-dark-4-arrowhead)'%20style='stroke-dasharray:%203%2c%203%3b%20fill:%20none%3b'/%3e%3c/svg%3e)
与此同时,应用会产生指标、日志和 Trace,IAM 与网络策略则在链路之外持续约束 访问权限。图中的组件可以按实际需求增减,关键是明确每一跳解决的问题。
应用交付链路
另一条链路回答“源代码如何成为运行中的服务”:
%3btext-align:center%3b%7d%23mermaid-5 .edgeLabel p%7bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3b%7d%23mermaid-5 .edgeLabel rect%7bopacity:0.5%3bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bfill:rgba(232%2c232%2c232%2c 0.8)%3b%7d%23mermaid-5 .labelBkg%7bbackground-color:rgba(232%2c 232%2c 232%2c 0.5)%3b%7d%23mermaid-5 .cluster rect%7bfill:%23ffffde%3bstroke:%23aaaa33%3bstroke-width:1px%3b%7d%23mermaid-5 .cluster text%7bfill:%23333%3b%7d%23mermaid-5 .cluster span%7bcolor:%23333%3b%7d%23mermaid-5 .node .collapsed-indicator%7bfill:%23aaaa33%3bstroke:none%3bopacity:0.6%3b%7d%23mermaid-5 .node .collapsed-separator%7bstroke:%23aaaa33%3bstroke-width:0.75px%3b%7d%23mermaid-5 div.mermaidTooltip%7bposition:absolute%3btext-align:center%3bmax-width:200px%3bpadding:2px%3bfont-family:arial%2csans-serif%3bfont-size:12px%3bbackground:hsl(80%2c 100%25%2c 96.2745098039%25)%3bborder:1px solid %23aaaa33%3bborder-radius:2px%3bpointer-events:none%3bz-index:100%3b%7d%23mermaid-5 .flowchartTitleText%7btext-anchor:middle%3bfont-size:18px%3bfill:%23333%3b%7d%23mermaid-5 rect.text%7bfill:none%3bstroke-width:0%3b%7d%23mermaid-5 .icon-shape%2c%23mermaid-5 .image-shape%7bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3btext-align:center%3b%7d%23mermaid-5 .icon-shape p%2c%23mermaid-5 .image-shape p%7bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bpadding:2px%3b%7d%23mermaid-5 .icon-shape .label rect%2c%23mermaid-5 .image-shape .label rect%7bopacity:0.5%3bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bfill:rgba(232%2c232%2c232%2c 0.8)%3b%7d%23mermaid-5 .label-icon%7bdisplay:inline-block%3bheight:1em%3boverflow:visible%3bvertical-align:-0.125em%3b%7d%23mermaid-5 .node .label-icon path%7bfill:currentColor%3bstroke:revert%3bstroke-width:revert%3b%7d%23mermaid-5 .node .neo-node%7bstroke:%239370DB%3b%7d%23mermaid-5 %5bdata-look='neo'%5d.node rect%2c%23mermaid-5 %5bdata-look='neo'%5d.cluster rect%2c%23mermaid-5 %5bdata-look='neo'%5d.node polygon%7bstroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-5 %5bdata-look='neo'%5d.swimlane.cluster rect%7bfilter:none%3b%7d%23mermaid-5 %5bdata-look='neo'%5d.node path%7bstroke:%239370DB%3bstroke-width:1px%3b%7d%23mermaid-5 %5bdata-look='neo'%5d.node .outer-path%7bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-5 %5bdata-look='neo'%5d.node .neo-line path%7bstroke:%239370DB%3bfilter:none%3b%7d%23mermaid-5 %5bdata-look='neo'%5d.node circle%7bstroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-5 %5bdata-look='neo'%5d.node circle .state-start%7bfill:black%3b%7d%23mermaid-5 %5bdata-look='neo'%5d.icon-shape .icon%7bfill:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-5 %5bdata-look='neo'%5d.icon-shape .icon-neo path%7bstroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-5 :root%7b--mermaid-font-family:arial%2csans-serif%3b%7d%3c/style%3e%3cg%3e%3cmarker id='mermaid-5_flowchart-v2-pointEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'%3e%3cpath d='M 0 0 L 10 5 L 0 10 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-5_flowchart-v2-pointStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='4.5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'%3e%3cpath d='M 0 5 L 10 10 L 10 0 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-5_flowchart-v2-pointEnd-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='11.5' refY='7' markerUnits='userSpaceOnUse' markerWidth='10.5' markerHeight='14' orient='auto'%3e%3cpath d='M 0 0 L 11.5 7 L 0 14 z' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-5_flowchart-v2-pointStart-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='1' refY='7' markerUnits='userSpaceOnUse' markerWidth='11.5' markerHeight='14' orient='auto'%3e%3cpolygon points='0%2c7 11.5%2c14 11.5%2c0' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-5_flowchart-v2-circleEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='11' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-5_flowchart-v2-circleStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-1' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-5_flowchart-v2-circleEnd-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refY='5' refX='12.25' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-5_flowchart-v2-circleStart-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-2' refY='5' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-5_flowchart-v2-crossEnd' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='12' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3cpath d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-5_flowchart-v2-crossStart' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='-1' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3cpath d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-5_flowchart-v2-crossEnd-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='17.7' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'%3e%3cpath d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-5_flowchart-v2-crossStart-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='-3.5' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'%3e%3cpath d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cg class='root'%3e%3cg class='clusters'/%3e%3cg class='edgePaths'%3e%3cpath d='M161.391%2c35L165.557%2c35C169.724%2c35%2c178.057%2c35%2c185.724%2c35C193.391%2c35%2c200.391%2c35%2c203.891%2c35L207.391%2c35' id='mermaid-5-L_Code_Build_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_Code_Build_0' data-points='W3sieCI6MTYxLjM5MDYyNSwieSI6MzV9LHsieCI6MTg2LjM5MDYyNSwieSI6MzV9LHsieCI6MjExLjM5MDYyNSwieSI6MzV9XQ==' data-look='classic' marker-end='url(%23mermaid-5_flowchart-v2-pointEnd)'/%3e%3cpath d='M349.359%2c35L353.526%2c35C357.693%2c35%2c366.026%2c35%2c373.693%2c35C381.359%2c35%2c388.359%2c35%2c391.859%2c35L395.359%2c35' id='mermaid-5-L_Build_Image_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_Build_Image_0' data-points='W3sieCI6MzQ5LjM1OTM3NSwieSI6MzV9LHsieCI6Mzc0LjM1OTM3NSwieSI6MzV9LHsieCI6Mzk5LjM1OTM3NSwieSI6MzV9XQ==' data-look='classic' marker-end='url(%23mermaid-5_flowchart-v2-pointEnd)'/%3e%3cpath d='M577.656%2c35L581.823%2c35C585.99%2c35%2c594.323%2c35%2c601.99%2c35C609.656%2c35%2c616.656%2c35%2c620.156%2c35L623.656%2c35' id='mermaid-5-L_Image_Registry_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_Image_Registry_0' data-points='W3sieCI6NTc3LjY1NjI1LCJ5IjozNX0seyJ4Ijo2MDIuNjU2MjUsInkiOjM1fSx7IngiOjYyNy42NTYyNSwieSI6MzV9XQ==' data-look='classic' marker-end='url(%23mermaid-5_flowchart-v2-pointEnd)'/%3e%3cpath d='M795.25%2c35L799.417%2c35C803.583%2c35%2c811.917%2c35%2c819.583%2c35C827.25%2c35%2c834.25%2c35%2c837.75%2c35L841.25%2c35' id='mermaid-5-L_Registry_Deploy_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_Registry_Deploy_0' data-points='W3sieCI6Nzk1LjI1LCJ5IjozNX0seyJ4Ijo4MjAuMjUsInkiOjM1fSx7IngiOjg0NS4yNSwieSI6MzV9XQ==' data-look='classic' marker-end='url(%23mermaid-5_flowchart-v2-pointEnd)'/%3e%3cpath d='M999.484%2c35L1003.651%2c35C1007.818%2c35%2c1016.151%2c35%2c1023.818%2c35C1031.484%2c35%2c1038.484%2c35%2c1041.984%2c35L1045.484%2c35' id='mermaid-5-L_Deploy_API_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_Deploy_API_0' data-points='W3sieCI6OTk5LjQ4NDM3NSwieSI6MzV9LHsieCI6MTAyNC40ODQzNzUsInkiOjM1fSx7IngiOjEwNDkuNDg0Mzc1LCJ5IjozNX1d' data-look='classic' marker-end='url(%23mermaid-5_flowchart-v2-pointEnd)'/%3e%3cpath d='M1220.672%2c35L1224.839%2c35C1229.005%2c35%2c1237.339%2c35%2c1245.005%2c35C1252.672%2c35%2c1259.672%2c35%2c1263.172%2c35L1266.672%2c35' id='mermaid-5-L_API_Workload_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_API_Workload_0' data-points='W3sieCI6MTIyMC42NzE4NzUsInkiOjM1fSx7IngiOjEyNDUuNjcxODc1LCJ5IjozNX0seyJ4IjoxMjcwLjY3MTg3NSwieSI6MzV9XQ==' data-look='classic' marker-end='url(%23mermaid-5_flowchart-v2-pointEnd)'/%3e%3c/g%3e%3cg class='edgeLabels'%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_Code_Build_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_Build_Image_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_Image_Registry_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_Registry_Deploy_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_Deploy_API_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_API_Workload_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cg class='nodes'%3e%3cg class='node default' id='mermaid-5-flowchart-Code-0' data-look='classic' transform='translate(84.6953125%2c 35)'%3e%3crect class='basic label-container' style='' x='-76.6953125' y='-27' width='153.390625' height='54'/%3e%3cg class='label' style='' transform='translate(-46.6953125%2c -12)'%3e%3crect/%3e%3cforeignObject width='93.390625' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eSource Code%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-5-flowchart-Build-1' data-look='classic' transform='translate(280.375%2c 35)'%3e%3crect class='basic label-container' style='' x='-68.984375' y='-27' width='137.96875' height='54'/%3e%3cg class='label' style='' transform='translate(-38.984375%2c -12)'%3e%3crect/%3e%3cforeignObject width='77.96875' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eBuild / Test%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-5-flowchart-Image-3' data-look='classic' transform='translate(488.5078125%2c 35)'%3e%3crect class='basic label-container' style='' x='-89.1484375' y='-27' width='178.296875' height='54'/%3e%3cg class='label' style='' transform='translate(-59.1484375%2c -12)'%3e%3crect/%3e%3cforeignObject width='118.296875' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eContainer Image%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-5-flowchart-Registry-5' data-look='classic' transform='translate(711.453125%2c 35)'%3e%3crect class='basic label-container' style='' x='-83.796875' y='-27' width='167.59375' height='54'/%3e%3cg class='label' style='' transform='translate(-53.796875%2c -12)'%3e%3crect/%3e%3cforeignObject width='107.59375' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eImage Registry%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-5-flowchart-Deploy-7' data-look='classic' transform='translate(922.3671875%2c 35)'%3e%3crect class='basic label-container' style='' x='-77.1171875' y='-27' width='154.234375' height='54'/%3e%3cg class='label' style='' transform='translate(-47.1171875%2c -12)'%3e%3crect/%3e%3cforeignObject width='94.234375' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eCI/CD / Helm%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-5-flowchart-API-9' data-look='classic' transform='translate(1135.078125%2c 35)'%3e%3crect class='basic label-container' style='' x='-85.59375' y='-27' width='171.1875' height='54'/%3e%3cg class='label' style='' transform='translate(-55.59375%2c -12)'%3e%3crect/%3e%3cforeignObject width='111.1875' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eKubernetes API%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-5-flowchart-Workload-11' data-look='classic' transform='translate(1364.265625%2c 35)'%3e%3crect class='basic label-container' style='' x='-93.59375' y='-27' width='187.1875' height='54'/%3e%3cg class='label' style='' transform='translate(-63.59375%2c -12)'%3e%3crect/%3e%3cforeignObject width='127.1875' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eDeployment / Pod%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cdefs%3e%3cfilter id='mermaid-5-drop-shadow' height='130%25' width='130%25'%3e%3cfeDropShadow dx='4' dy='4' stdDeviation='0' flood-opacity='0.06' flood-color='black'/%3e%3c/filter%3e%3c/defs%3e%3cdefs%3e%3cfilter id='mermaid-5-drop-shadow-small' height='150%25' width='150%25'%3e%3cfeDropShadow dx='2' dy='2' stdDeviation='0' flood-opacity='0.06' flood-color='black'/%3e%3c/filter%3e%3c/defs%3e%3c/svg%3e)
%3btext-align:center%3b%7d%23mermaid-dark-5%20.edgeLabel%20p%7bbackground-color:hsl(0%2c%200%25%2c%2034.4117647059%25)%3b%7d%23mermaid-dark-5%20.edgeLabel%20rect%7bopacity:0.5%3bbackground-color:hsl(0%2c%200%25%2c%2034.4117647059%25)%3bfill:hsl(0%2c%200%25%2c%2034.4117647059%25)%3b%7d%23mermaid-dark-5%20.labelBkg%7bbackground-color:rgba(87.75%2c%2087.75%2c%2087.75%2c%200.5)%3b%7d%23mermaid-dark-5%20.cluster%20rect%7bfill:hsl(180%2c%201.5873015873%25%2c%2028.3529411765%25)%3bstroke:rgba(255%2c%20255%2c%20255%2c%200.25)%3bstroke-width:1px%3b%7d%23mermaid-dark-5%20.cluster%20text%7bfill:%23F9FFFE%3b%7d%23mermaid-dark-5%20.cluster%20span%7bcolor:%23F9FFFE%3b%7d%23mermaid-dark-5%20.node%20.collapsed-indicator%7bfill:rgba(255%2c%20255%2c%20255%2c%200.25)%3bstroke:none%3bopacity:0.6%3b%7d%23mermaid-dark-5%20.node%20.collapsed-separator%7bstroke:rgba(255%2c%20255%2c%20255%2c%200.25)%3bstroke-width:0.75px%3b%7d%23mermaid-dark-5%20div.mermaidTooltip%7bposition:absolute%3btext-align:center%3bmax-width:200px%3bpadding:2px%3bfont-family:arial%2csans-serif%3bfont-size:12px%3bbackground:hsl(20%2c%201.5873015873%25%2c%2012.3529411765%25)%3bborder:1px%20solid%20rgba(255%2c%20255%2c%20255%2c%200.25)%3bborder-radius:2px%3bpointer-events:none%3bz-index:100%3b%7d%23mermaid-dark-5%20.flowchartTitleText%7btext-anchor:middle%3bfont-size:18px%3bfill:%23ccc%3b%7d%23mermaid-dark-5%20rect.text%7bfill:none%3bstroke-width:0%3b%7d%23mermaid-dark-5%20.icon-shape%2c%23mermaid-dark-5%20.image-shape%7bbackground-color:hsl(0%2c%200%25%2c%2034.4117647059%25)%3btext-align:center%3b%7d%23mermaid-dark-5%20.icon-shape%20p%2c%23mermaid-dark-5%20.image-shape%20p%7bbackground-color:hsl(0%2c%200%25%2c%2034.4117647059%25)%3bpadding:2px%3b%7d%23mermaid-dark-5%20.icon-shape%20.label%20rect%2c%23mermaid-dark-5%20.image-shape%20.label%20rect%7bopacity:0.5%3bbackground-color:hsl(0%2c%200%25%2c%2034.4117647059%25)%3bfill:hsl(0%2c%200%25%2c%2034.4117647059%25)%3b%7d%23mermaid-dark-5%20.label-icon%7bdisplay:inline-block%3bheight:1em%3boverflow:visible%3bvertical-align:-0.125em%3b%7d%23mermaid-dark-5%20.node%20.label-icon%20path%7bfill:currentColor%3bstroke:revert%3bstroke-width:revert%3b%7d%23mermaid-dark-5%20.node%20.neo-node%7bstroke:%23ccc%3b%7d%23mermaid-dark-5%20%5bdata-look='neo'%5d.node%20rect%2c%23mermaid-dark-5%20%5bdata-look='neo'%5d.cluster%20rect%2c%23mermaid-dark-5%20%5bdata-look='neo'%5d.node%20polygon%7bstroke:url(%23mermaid-dark-5-gradient)%3bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-5%20%5bdata-look='neo'%5d.swimlane.cluster%20rect%7bfilter:none%3b%7d%23mermaid-dark-5%20%5bdata-look='neo'%5d.node%20path%7bstroke:url(%23mermaid-dark-5-gradient)%3bstroke-width:1px%3b%7d%23mermaid-dark-5%20%5bdata-look='neo'%5d.node%20.outer-path%7bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-5%20%5bdata-look='neo'%5d.node%20.neo-line%20path%7bstroke:%23ccc%3bfilter:none%3b%7d%23mermaid-dark-5%20%5bdata-look='neo'%5d.node%20circle%7bstroke:url(%23mermaid-dark-5-gradient)%3bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-5%20%5bdata-look='neo'%5d.node%20circle%20.state-start%7bfill:black%3b%7d%23mermaid-dark-5%20%5bdata-look='neo'%5d.icon-shape%20.icon%7bfill:url(%23mermaid-dark-5-gradient)%3bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-5%20%5bdata-look='neo'%5d.icon-shape%20.icon-neo%20path%7bstroke:url(%23mermaid-dark-5-gradient)%3bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-5%20:root%7b--mermaid-font-family:arial%2csans-serif%3b%7d%3c/style%3e%3cg%3e%3cmarker%20id='mermaid-dark-5_flowchart-v2-pointEnd'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='5'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='8'%20markerHeight='8'%20orient='auto'%3e%3cpath%20d='M%200%200%20L%2010%205%20L%200%2010%20z'%20class='arrowMarkerPath'%20style='stroke-width:%201%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-5_flowchart-v2-pointStart'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='4.5'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='8'%20markerHeight='8'%20orient='auto'%3e%3cpath%20d='M%200%205%20L%2010%2010%20L%2010%200%20z'%20class='arrowMarkerPath'%20style='stroke-width:%201%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-5_flowchart-v2-pointEnd-margin'%20class='marker%20flowchart-v2'%20viewBox='0%200%2011.5%2014'%20refX='11.5'%20refY='7'%20markerUnits='userSpaceOnUse'%20markerWidth='10.5'%20markerHeight='14'%20orient='auto'%3e%3cpath%20d='M%200%200%20L%2011.5%207%20L%200%2014%20z'%20class='arrowMarkerPath'%20style='stroke-width:%200%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-5_flowchart-v2-pointStart-margin'%20class='marker%20flowchart-v2'%20viewBox='0%200%2011.5%2014'%20refX='1'%20refY='7'%20markerUnits='userSpaceOnUse'%20markerWidth='11.5'%20markerHeight='14'%20orient='auto'%3e%3cpolygon%20points='0%2c7%2011.5%2c14%2011.5%2c0'%20class='arrowMarkerPath'%20style='stroke-width:%200%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-5_flowchart-v2-circleEnd'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='11'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='11'%20markerHeight='11'%20orient='auto'%3e%3ccircle%20cx='5'%20cy='5'%20r='5'%20class='arrowMarkerPath'%20style='stroke-width:%201%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-5_flowchart-v2-circleStart'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='-1'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='11'%20markerHeight='11'%20orient='auto'%3e%3ccircle%20cx='5'%20cy='5'%20r='5'%20class='arrowMarkerPath'%20style='stroke-width:%201%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-5_flowchart-v2-circleEnd-margin'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refY='5'%20refX='12.25'%20markerUnits='userSpaceOnUse'%20markerWidth='14'%20markerHeight='14'%20orient='auto'%3e%3ccircle%20cx='5'%20cy='5'%20r='5'%20class='arrowMarkerPath'%20style='stroke-width:%200%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-5_flowchart-v2-circleStart-margin'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='-2'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='14'%20markerHeight='14'%20orient='auto'%3e%3ccircle%20cx='5'%20cy='5'%20r='5'%20class='arrowMarkerPath'%20style='stroke-width:%200%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-5_flowchart-v2-crossEnd'%20class='marker%20cross%20flowchart-v2'%20viewBox='0%200%2011%2011'%20refX='12'%20refY='5.2'%20markerUnits='userSpaceOnUse'%20markerWidth='11'%20markerHeight='11'%20orient='auto'%3e%3cpath%20d='M%201%2c1%20l%209%2c9%20M%2010%2c1%20l%20-9%2c9'%20class='arrowMarkerPath'%20style='stroke-width:%202%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-5_flowchart-v2-crossStart'%20class='marker%20cross%20flowchart-v2'%20viewBox='0%200%2011%2011'%20refX='-1'%20refY='5.2'%20markerUnits='userSpaceOnUse'%20markerWidth='11'%20markerHeight='11'%20orient='auto'%3e%3cpath%20d='M%201%2c1%20l%209%2c9%20M%2010%2c1%20l%20-9%2c9'%20class='arrowMarkerPath'%20style='stroke-width:%202%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-5_flowchart-v2-crossEnd-margin'%20class='marker%20cross%20flowchart-v2'%20viewBox='0%200%2015%2015'%20refX='17.7'%20refY='7.5'%20markerUnits='userSpaceOnUse'%20markerWidth='12'%20markerHeight='12'%20orient='auto'%3e%3cpath%20d='M%201%2c1%20L%2014%2c14%20M%201%2c14%20L%2014%2c1'%20class='arrowMarkerPath'%20style='stroke-width:%202.5%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-5_flowchart-v2-crossStart-margin'%20class='marker%20cross%20flowchart-v2'%20viewBox='0%200%2015%2015'%20refX='-3.5'%20refY='7.5'%20markerUnits='userSpaceOnUse'%20markerWidth='12'%20markerHeight='12'%20orient='auto'%3e%3cpath%20d='M%201%2c1%20L%2014%2c14%20M%201%2c14%20L%2014%2c1'%20class='arrowMarkerPath'%20style='stroke-width:%202.5%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cg%20class='root'%3e%3cg%20class='clusters'/%3e%3cg%20class='edgePaths'%3e%3cpath%20d='M161.391%2c35L165.557%2c35C169.724%2c35%2c178.057%2c35%2c185.724%2c35C193.391%2c35%2c200.391%2c35%2c203.891%2c35L207.391%2c35'%20id='mermaid-dark-5-L_Code_Build_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_Code_Build_0'%20data-points='W3sieCI6MTYxLjM5MDYyNSwieSI6MzV9LHsieCI6MTg2LjM5MDYyNSwieSI6MzV9LHsieCI6MjExLjM5MDYyNSwieSI6MzV9XQ=='%20data-look='classic'%20marker-end='url(%23mermaid-dark-5_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M349.359%2c35L353.526%2c35C357.693%2c35%2c366.026%2c35%2c373.693%2c35C381.359%2c35%2c388.359%2c35%2c391.859%2c35L395.359%2c35'%20id='mermaid-dark-5-L_Build_Image_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_Build_Image_0'%20data-points='W3sieCI6MzQ5LjM1OTM3NSwieSI6MzV9LHsieCI6Mzc0LjM1OTM3NSwieSI6MzV9LHsieCI6Mzk5LjM1OTM3NSwieSI6MzV9XQ=='%20data-look='classic'%20marker-end='url(%23mermaid-dark-5_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M577.656%2c35L581.823%2c35C585.99%2c35%2c594.323%2c35%2c601.99%2c35C609.656%2c35%2c616.656%2c35%2c620.156%2c35L623.656%2c35'%20id='mermaid-dark-5-L_Image_Registry_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_Image_Registry_0'%20data-points='W3sieCI6NTc3LjY1NjI1LCJ5IjozNX0seyJ4Ijo2MDIuNjU2MjUsInkiOjM1fSx7IngiOjYyNy42NTYyNSwieSI6MzV9XQ=='%20data-look='classic'%20marker-end='url(%23mermaid-dark-5_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M795.25%2c35L799.417%2c35C803.583%2c35%2c811.917%2c35%2c819.583%2c35C827.25%2c35%2c834.25%2c35%2c837.75%2c35L841.25%2c35'%20id='mermaid-dark-5-L_Registry_Deploy_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_Registry_Deploy_0'%20data-points='W3sieCI6Nzk1LjI1LCJ5IjozNX0seyJ4Ijo4MjAuMjUsInkiOjM1fSx7IngiOjg0NS4yNSwieSI6MzV9XQ=='%20data-look='classic'%20marker-end='url(%23mermaid-dark-5_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M999.484%2c35L1003.651%2c35C1007.818%2c35%2c1016.151%2c35%2c1023.818%2c35C1031.484%2c35%2c1038.484%2c35%2c1041.984%2c35L1045.484%2c35'%20id='mermaid-dark-5-L_Deploy_API_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_Deploy_API_0'%20data-points='W3sieCI6OTk5LjQ4NDM3NSwieSI6MzV9LHsieCI6MTAyNC40ODQzNzUsInkiOjM1fSx7IngiOjEwNDkuNDg0Mzc1LCJ5IjozNX1d'%20data-look='classic'%20marker-end='url(%23mermaid-dark-5_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M1220.672%2c35L1224.839%2c35C1229.005%2c35%2c1237.339%2c35%2c1245.005%2c35C1252.672%2c35%2c1259.672%2c35%2c1263.172%2c35L1266.672%2c35'%20id='mermaid-dark-5-L_API_Workload_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_API_Workload_0'%20data-points='W3sieCI6MTIyMC42NzE4NzUsInkiOjM1fSx7IngiOjEyNDUuNjcxODc1LCJ5IjozNX0seyJ4IjoxMjcwLjY3MTg3NSwieSI6MzV9XQ=='%20data-look='classic'%20marker-end='url(%23mermaid-dark-5_flowchart-v2-pointEnd)'/%3e%3c/g%3e%3cg%20class='edgeLabels'%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_Code_Build_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_Build_Image_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_Image_Registry_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_Registry_Deploy_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_Deploy_API_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_API_Workload_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cg%20class='nodes'%3e%3cg%20class='node%20default'%20id='mermaid-dark-5-flowchart-Code-0'%20data-look='classic'%20transform='translate(84.6953125%2c%2035)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-76.6953125'%20y='-27'%20width='153.390625'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-46.6953125%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='93.390625'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3eSource%20Code%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-5-flowchart-Build-1'%20data-look='classic'%20transform='translate(280.375%2c%2035)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-68.984375'%20y='-27'%20width='137.96875'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-38.984375%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='77.96875'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3eBuild%20/%20Test%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-5-flowchart-Image-3'%20data-look='classic'%20transform='translate(488.5078125%2c%2035)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-89.1484375'%20y='-27'%20width='178.296875'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-59.1484375%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='118.296875'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3eContainer%20Image%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-5-flowchart-Registry-5'%20data-look='classic'%20transform='translate(711.453125%2c%2035)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-83.796875'%20y='-27'%20width='167.59375'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-53.796875%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='107.59375'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3eImage%20Registry%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-5-flowchart-Deploy-7'%20data-look='classic'%20transform='translate(922.3671875%2c%2035)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-77.1171875'%20y='-27'%20width='154.234375'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-47.1171875%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='94.234375'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3eCI/CD%20/%20Helm%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-5-flowchart-API-9'%20data-look='classic'%20transform='translate(1135.078125%2c%2035)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-85.59375'%20y='-27'%20width='171.1875'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-55.59375%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='111.1875'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3eKubernetes%20API%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-5-flowchart-Workload-11'%20data-look='classic'%20transform='translate(1364.265625%2c%2035)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-93.59375'%20y='-27'%20width='187.1875'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-63.59375%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='127.1875'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3eDeployment%20/%20Pod%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cdefs%3e%3cfilter%20id='mermaid-dark-5-drop-shadow'%20height='130%25'%20width='130%25'%3e%3cfeDropShadow%20dx='4'%20dy='4'%20stdDeviation='0'%20flood-opacity='0.06'%20flood-color='white'/%3e%3c/filter%3e%3c/defs%3e%3cdefs%3e%3cfilter%20id='mermaid-dark-5-drop-shadow-small'%20height='150%25'%20width='150%25'%3e%3cfeDropShadow%20dx='2'%20dy='2'%20stdDeviation='0'%20flood-opacity='0.06'%20flood-color='white'/%3e%3c/filter%3e%3c/defs%3e%3clinearGradient%20id='mermaid-dark-5-gradient'%20gradientUnits='objectBoundingBox'%20x1='0%25'%20y1='0%25'%20x2='100%25'%20y2='0%25'%3e%3cstop%20offset='0%25'%20stop-color='%23cccccc'%20stop-opacity='1'/%3e%3cstop%20offset='100%25'%20stop-color='hsl(180%2c%200%25%2c%2018.3529411765%25)'%20stop-opacity='1'/%3e%3c/linearGradient%3e%3c/svg%3e)
运行链路处理用户请求,交付链路改变系统版本。一个成熟的平台必须同时保证两者 安全、稳定、可追踪。
八、三个贯穿后续系列的架构思想
控制面与数据面
控制面决定系统应该如何运行,例如下发配置、调度工作负载和维护路由策略; 数据面真正处理业务数据或网络流量,例如 Pod 执行业务代码、Envoy 和 ELB 转发 请求。理解这个划分,有助于分析 Kubernetes、Service Mesh 和负载均衡系统。
托管服务与自建服务
自建与托管不是“懂底层”和“不懂底层”的区别,而是责任边界不同。托管服务让 云厂商承担更多基础设施运维工作,团队仍需理解通用技术原理,才能正确设计容量、 安全、高可用和故障恢复方案。
通用能力与厂商产品
先理解通用能力,再映射到具体产品,可以避免知识被某一家云平台锁定:
虚拟私有网络 → VPC
托管 Kubernetes → CCE / EKS / AKS / GKE
关系数据库托管 → RDS 类服务
对象存储 → OBS / S3 类服务
身份与访问管理 → IAM 类服务
后续文章将沿着“容器交付 → Kubernetes → 云网络与流量入口 → 服务治理 → 数据基础设施 → 可观测性”的顺序展开。
这套体系最终可以压缩为一句话:
计算承载应用,网络连接资源,容器编排工作负载,网关治理入口流量,服务网格 治理内部通信,数据服务保存业务状态,可观测性描述运行状态,而身份与权限体系 贯穿整个云平台。
掌握这张地图后,再面对一个陌生云产品时,不必先背诵它的全部配置项。先判断它 属于哪一层、解决什么问题、处于哪条链路,再深入具体实现,学习效率会高得多。