

大语言模型擅长理解自然语言、生成文本和进行推理,但它并不天然拥有业务系统中的各种能力。例如,模型本身不能直接查询企业数据库、读取订单状态、调用内部接口、发送邮件或执行部署任务。
如果用户向模型询问:
帮我查询订单 20260919001 当前是什么状态。真正知道答案的不是模型,而是应用程序中的函数:
query_order("20260919001")或者某个远程接口:
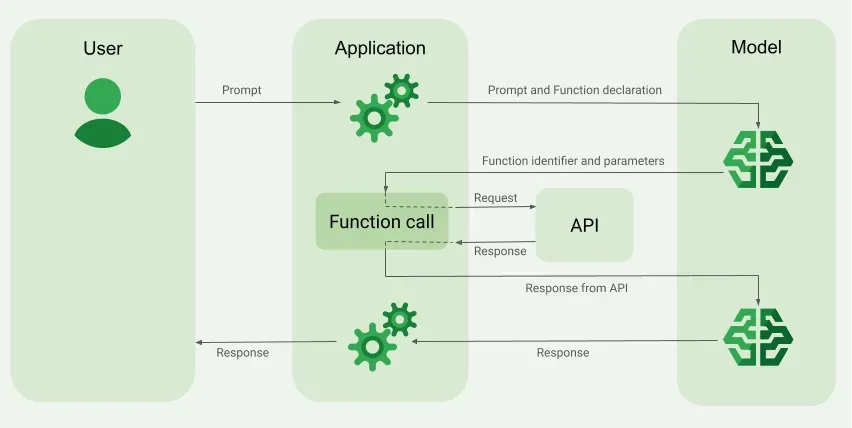
GET /api/orders/20260919001Function Calling 解决的问题是:让模型根据自然语言判断需要使用哪个工具,并生成工具调用所需的结构化参数。
需要特别注意,模型只会生成工具调用请求。真实函数仍然由应用程序执行,权限、校验和业务规则也仍然由应用程序负责。
Function Calling 解决什么问题
假设系统中已经存在一个订单查询函数:
def get_order(order_id: str) -> dict:
    ...
用户可能用很多方式表达同一个需求:
帮我看看订单 20260919001 现在怎么样了。
这个单子发货了吗?
查一下 20260919001。
我的订单到哪了?
传统程序需要自己完成意图识别、关键词匹配和参数提取。Function Calling 提供了不同的职责划分:
| 参与者 | 职责 |
|---|---|
| 用户 | 使用自然语言描述需求 |
| 模型 | 理解需求、选择工具、生成参数 |
| 应用程序 | 校验请求、执行函数、控制权限 |
| 业务系统 | 查询或修改真实数据 |
程序向模型声明存在一个 get_order 工具,以及它需要的 order_id 参数。模型就可以把自然语言转换成类似下面的调用请求:
{
  "name": "get_order",
  "arguments": {
    "order_id": "20260919001"
  }
}
应用程序执行函数后,把真实结果返回给模型:
{
  "order_id": "20260919001",
  "status": "SHIPPED",
  "carrier": "SF Express"
}
模型再组织最终回答:
订单 20260919001 已发货,目前由顺丰承运。)%3b}%23mermaid-0 rect.note[data-look='neo']{stroke:%23aaaa33%3bfill:%23fff5ad%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b}%23mermaid-0 text.actor%26gt%3btspan{fill:black%3bstroke:none%3b}%23mermaid-0 .actor-line{stroke:%239370DB%3b}%23mermaid-0 .innerArc{stroke-width:1.5%3bstroke-dasharray:none%3b}%23mermaid-0 .messageLine0{stroke-width:1.5%3bstroke-dasharray:none%3bstroke:%23333%3b}%23mermaid-0 .messageLine1{stroke-width:1.5%3bstroke-dasharray:2%2c2%3bstroke:%23333%3b}%23mermaid-0 [id%24='-arrowhead'] path{fill:%23333%3bstroke:%23333%3b}%23mermaid-0 .sequenceNumber{fill:white%3b}%23mermaid-0 [id%24='-sequencenumber']{fill:%23333%3b}%23mermaid-0 [id%24='-crosshead'] path{fill:%23333%3bstroke:%23333%3b}%23mermaid-0 .messageText{fill:%23333%3bstroke:none%3b}%23mermaid-0 .labelBox{stroke:%239370DB%3bfill:%23ECECFF%3bfilter:none%3b}%23mermaid-0 .labelText%2c%23mermaid-0 .labelText%26gt%3btspan{fill:black%3bstroke:none%3b}%23mermaid-0 .loopText%2c%23mermaid-0 .loopText%26gt%3btspan{fill:black%3bstroke:none%3b}%23mermaid-0 .sectionTitle%2c%23mermaid-0 .sectionTitle%26gt%3btspan{fill:black%3bstroke:none%3b}%23mermaid-0 .loopLine{stroke-width:2px%3bstroke-dasharray:2%2c2%3bstroke:%239370DB%3bfill:%239370DB%3b}%23mermaid-0 .note{stroke:%23aaaa33%3bfill:%23fff5ad%3b}%23mermaid-0 .noteText%2c%23mermaid-0 .noteText%26gt%3btspan{fill:black%3bstroke:none%3bfont-weight:normal%3b}%23mermaid-0 .activation0{fill:%23f4f4f4%3bstroke:%23666%3b}%23mermaid-0 .activation1{fill:%23f4f4f4%3bstroke:%23666%3b}%23mermaid-0 .activation2{fill:%23f4f4f4%3bstroke:%23666%3b}%23mermaid-0 .actorPopupMenu{position:absolute%3b}%23mermaid-0 .actorPopupMenuPanel{position:absolute%3bfill:%23ECECFF%3bbox-shadow:0px 8px 16px 0px rgba(0%2c0%2c0%2c0.2)%3bfilter:drop-shadow(3px 5px 2px rgb(0 0 0 / 0.4))%3b}%23mermaid-0 .actor-man circle%2c%23mermaid-0 line{fill:%23ECECFF%3bstroke-width:2px%3b}%23mermaid-0 g rect.rect{filter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3bstroke:%239370DB%3b}%23mermaid-0 .node .neo-node{stroke:%239370DB%3b}%23mermaid-0 [data-look='neo'].node rect%2c%23mermaid-0 [data-look='neo'].cluster rect%2c%23mermaid-0 [data-look='neo'].node polygon{stroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b}%23mermaid-0 [data-look='neo'].swimlane.cluster rect{filter:none%3b}%23mermaid-0 [data-look='neo'].node path{stroke:%239370DB%3bstroke-width:1px%3b}%23mermaid-0 [data-look='neo'].node .outer-path{filter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b}%23mermaid-0 [data-look='neo'].node .neo-line path{stroke:%239370DB%3bfilter:none%3b}%23mermaid-0 [data-look='neo'].node circle{stroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b}%23mermaid-0 [data-look='neo'].node circle .state-start{fill:black%3b}%23mermaid-0 [data-look='neo'].icon-shape .icon{fill:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b}%23mermaid-0 [data-look='neo'].icon-shape .icon-neo path{stroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b}%23mermaid-0 :root{--mermaid-font-family:arial%2csans-serif%3b}</style><g/><defs><symbol id='mermaid-0-computer' width='24' height='24'><path transform='scale(.5)' d='M2 2v13h20v-13h-20zm18 11h-16v-9h16v9zm-10.228 6l.466-1h3.524l.467 1h-4.457zm14.228 3h-24l2-6h2.104l-1.33 4h18.45l-1.297-4h2.073l2 6zm-5-10h-14v-7h14v7z'/></symbol></defs><defs><symbol id='mermaid-0-database' fill-rule='evenodd' clip-rule='evenodd'><path transform='scale(.5)' d='M12.258.001l.256.004.255.005.253.008.251.01.249.012.247.015.246.016.242.019.241.02.239.023.236.024.233.027.231.028.229.031.225.032.223.034.22.036.217.038.214.04.211.041.208.043.205.045.201.046.198.048.194.05.191.051.187.053.183.054.18.056.175.057.172.059.168.06.163.061.16.063.155.064.15.066.074.033.073.033.071.034.07.034.069.035.068.035.067.035.066.035.064.036.064.036.062.036.06.036.06.037.058.037.058.037.055.038.055.038.053.038.052.038.051.039.05.039.048.039.047.039.045.04.044.04.043.04.041.04.04.041.039.041.037.041.036.041.034.041.033.042.032.042.03.042.029.042.027.042.026.043.024.043.023.043.021.043.02.043.018.044.017.043.015.044.013.044.012.044.011.045.009.044.007.045.006.045.004.045.002.045.001.045v17l-.001.045-.002.045-.004.045-.006.045-.007.045-.009.044-.011.045-.012.044-.013.044-.015.044-.017.043-.018.044-.02.043-.021.043-.023.043-.024.043-.026.043-.027.042-.029.042-.03.042-.032.042-.033.042-.034.041-.036.041-.037.041-.039.041-.04.041-.041.04-.043.04-.044.04-.045.04-.047.039-.048.039-.05.039-.051.039-.052.038-.053.038-.055.038-.055.038-.058.037-.058.037-.06.037-.06.036-.062.036-.064.036-.064.036-.066.035-.067.035-.068.035-.069.035-.07.034-.071.034-.073.033-.074.033-.15.066-.155.064-.16.063-.163.061-.168.06-.172.059-.175.057-.18.056-.183.054-.187.053-.191.051-.194.05-.198.048-.201.046-.205.045-.208.043-.211.041-.214.04-.217.038-.22.036-.223.034-.225.032-.229.031-.231.028-.233.027-.236.024-.239.023-.241.02-.242.019-.246.016-.247.015-.249.012-.251.01-.253.008-.255.005-.256.004-.258.001-.258-.001-.256-.004-.255-.005-.253-.008-.251-.01-.249-.012-.247-.015-.245-.016-.243-.019-.241-.02-.238-.023-.236-.024-.234-.027-.231-.028-.228-.031-.226-.032-.223-.034-.22-.036-.217-.038-.214-.04-.211-.041-.208-.043-.204-.045-.201-.046-.198-.048-.195-.05-.19-.051-.187-.053-.184-.054-.179-.056-.176-.057-.172-.059-.167-.06-.164-.061-.159-.063-.155-.064-.151-.066-.074-.033-.072-.033-.072-.034-.07-.034-.069-.035-.068-.035-.067-.035-.066-.035-.064-.036-.063-.036-.062-.036-.061-.036-.06-.037-.058-.037-.057-.037-.056-.038-.055-.038-.053-.038-.052-.038-.051-.039-.049-.039-.049-.039-.046-.039-.046-.04-.044-.04-.043-.04-.041-.04-.04-.041-.039-.041-.037-.041-.036-.041-.034-.041-.033-.042-.032-.042-.03-.042-.029-.042-.027-.042-.026-.043-.024-.043-.023-.043-.021-.043-.02-.043-.018-.044-.017-.043-.015-.044-.013-.044-.012-.044-.011-.045-.009-.044-.007-.045-.006-.045-.004-.045-.002-.045-.001-.045v-17l.001-.045.002-.045.004-.045.006-.045.007-.045.009-.044.011-.045.012-.044.013-.044.015-.044.017-.043.018-.044.02-.043.021-.043.023-.043.024-.043.026-.043.027-.042.029-.042.03-.042.032-.042.033-.042.034-.041.036-.041.037-.041.039-.041.04-.041.041-.04.043-.04.044-.04.046-.04.046-.039.049-.039.049-.039.051-.039.052-.038.053-.038.055-.038.056-.038.057-.037.058-.037.06-.037.061-.036.062-.036.063-.036.064-.036.066-.035.067-.035.068-.035.069-.035.07-.034.072-.034.072-.033.074-.033.151-.066.155-.064.159-.063.164-.061.167-.06.172-.059.176-.057.179-.056.184-.054.187-.053.19-.051.195-.05.198-.048.201-.046.204-.045.208-.043.211-.041.214-.04.217-.038.22-.036.223-.034.226-.032.228-.031.231-.028.234-.027.236-.024.238-.023.241-.02.243-.019.245-.016.247-.015.249-.012.251-.01.253-.008.255-.005.256-.004.258-.001.258.001zm-9.258 20.499v.01l.001.021.003.021.004.022.005.021.006.022.007.022.009.023.01.022.011.023.012.023.013.023.015.023.016.024.017.023.018.024.019.024.021.024.022.025.023.024.024.025.052.049.056.05.061.051.066.051.07.051.075.051.079.052.084.052.088.052.092.052.097.052.102.051.105.052.11.052.114.051.119.051.123.051.127.05.131.05.135.05.139.048.144.049.147.047.152.047.155.047.16.045.163.045.167.043.171.043.176.041.178.041.183.039.187.039.19.037.194.035.197.035.202.033.204.031.209.03.212.029.216.027.219.025.222.024.226.021.23.02.233.018.236.016.24.015.243.012.246.01.249.008.253.005.256.004.259.001.26-.001.257-.004.254-.005.25-.008.247-.011.244-.012.241-.014.237-.016.233-.018.231-.021.226-.021.224-.024.22-.026.216-.027.212-.028.21-.031.205-.031.202-.034.198-.034.194-.036.191-.037.187-.039.183-.04.179-.04.175-.042.172-.043.168-.044.163-.045.16-.046.155-.046.152-.047.148-.048.143-.049.139-.049.136-.05.131-.05.126-.05.123-.051.118-.052.114-.051.11-.052.106-.052.101-.052.096-.052.092-.052.088-.053.083-.051.079-.052.074-.052.07-.051.065-.051.06-.051.056-.05.051-.05.023-.024.023-.025.021-.024.02-.024.019-.024.018-.024.017-.024.015-.023.014-.024.013-.023.012-.023.01-.023.01-.022.008-.022.006-.022.006-.022.004-.022.004-.021.001-.021.001-.021v-4.127l-.077.055-.08.053-.083.054-.085.053-.087.052-.09.052-.093.051-.095.05-.097.05-.1.049-.102.049-.105.048-.106.047-.109.047-.111.046-.114.045-.115.045-.118.044-.12.043-.122.042-.124.042-.126.041-.128.04-.13.04-.132.038-.134.038-.135.037-.138.037-.139.035-.142.035-.143.034-.144.033-.147.032-.148.031-.15.03-.151.03-.153.029-.154.027-.156.027-.158.026-.159.025-.161.024-.162.023-.163.022-.165.021-.166.02-.167.019-.169.018-.169.017-.171.016-.173.015-.173.014-.175.013-.175.012-.177.011-.178.01-.179.008-.179.008-.181.006-.182.005-.182.004-.184.003-.184.002h-.37l-.184-.002-.184-.003-.182-.004-.182-.005-.181-.006-.179-.008-.179-.008-.178-.01-.176-.011-.176-.012-.175-.013-.173-.014-.172-.015-.171-.016-.17-.017-.169-.018-.167-.019-.166-.02-.165-.021-.163-.022-.162-.023-.161-.024-.159-.025-.157-.026-.156-.027-.155-.027-.153-.029-.151-.03-.15-.03-.148-.031-.146-.032-.145-.033-.143-.034-.141-.035-.14-.035-.137-.037-.136-.037-.134-.038-.132-.038-.13-.04-.128-.04-.126-.041-.124-.042-.122-.042-.12-.044-.117-.043-.116-.045-.113-.045-.112-.046-.109-.047-.106-.047-.105-.048-.102-.049-.1-.049-.097-.05-.095-.05-.093-.052-.09-.051-.087-.052-.085-.053-.083-.054-.08-.054-.077-.054v4.127zm0-5.654v.011l.001.021.003.021.004.021.005.022.006.022.007.022.009.022.01.022.011.023.012.023.013.023.015.024.016.023.017.024.018.024.019.024.021.024.022.024.023.025.024.024.052.05.056.05.061.05.066.051.07.051.075.052.079.051.084.052.088.052.092.052.097.052.102.052.105.052.11.051.114.051.119.052.123.05.127.051.131.05.135.049.139.049.144.048.147.048.152.047.155.046.16.045.163.045.167.044.171.042.176.042.178.04.183.04.187.038.19.037.194.036.197.034.202.033.204.032.209.03.212.028.216.027.219.025.222.024.226.022.23.02.233.018.236.016.24.014.243.012.246.01.249.008.253.006.256.003.259.001.26-.001.257-.003.254-.006.25-.008.247-.01.244-.012.241-.015.237-.016.233-.018.231-.02.226-.022.224-.024.22-.025.216-.027.212-.029.21-.03.205-.032.202-.033.198-.035.194-.036.191-.037.187-.039.183-.039.179-.041.175-.042.172-.043.168-.044.163-.045.16-.045.155-.047.152-.047.148-.048.143-.048.139-.05.136-.049.131-.05.126-.051.123-.051.118-.051.114-.052.11-.052.106-.052.101-.052.096-.052.092-.052.088-.052.083-.052.079-.052.074-.051.07-.052.065-.051.06-.05.056-.051.051-.049.023-.025.023-.024.021-.025.02-.024.019-.024.018-.024.017-.024.015-.023.014-.023.013-.024.012-.022.01-.023.01-.023.008-.022.006-.022.006-.022.004-.021.004-.022.001-.021.001-.021v-4.139l-.077.054-.08.054-.083.054-.085.052-.087.053-.09.051-.093.051-.095.051-.097.05-.1.049-.102.049-.105.048-.106.047-.109.047-.111.046-.114.045-.115.044-.118.044-.12.044-.122.042-.124.042-.126.041-.128.04-.13.039-.132.039-.134.038-.135.037-.138.036-.139.036-.142.035-.143.033-.144.033-.147.033-.148.031-.15.03-.151.03-.153.028-.154.028-.156.027-.158.026-.159.025-.161.024-.162.023-.163.022-.165.021-.166.02-.167.019-.169.018-.169.017-.171.016-.173.015-.173.014-.175.013-.175.012-.177.011-.178.009-.179.009-.179.007-.181.007-.182.005-.182.004-.184.003-.184.002h-.37l-.184-.002-.184-.003-.182-.004-.182-.005-.181-.007-.179-.007-.179-.009-.178-.009-.176-.011-.176-.012-.175-.013-.173-.014-.172-.015-.171-.016-.17-.017-.169-.018-.167-.019-.166-.02-.165-.021-.163-.022-.162-.023-.161-.024-.159-.025-.157-.026-.156-.027-.155-.028-.153-.028-.151-.03-.15-.03-.148-.031-.146-.033-.145-.033-.143-.033-.141-.035-.14-.036-.137-.036-.136-.037-.134-.038-.132-.039-.13-.039-.128-.04-.126-.041-.124-.042-.122-.043-.12-.043-.117-.044-.116-.044-.113-.046-.112-.046-.109-.046-.106-.047-.105-.048-.102-.049-.1-.049-.097-.05-.095-.051-.093-.051-.09-.051-.087-.053-.085-.052-.083-.054-.08-.054-.077-.054v4.139zm0-5.666v.011l.001.02.003.022.004.021.005.022.006.021.007.022.009.023.01.022.011.023.012.023.013.023.015.023.016.024.017.024.018.023.019.024.021.025.022.024.023.024.024.025.052.05.056.05.061.05.066.051.07.051.075.052.079.051.084.052.088.052.092.052.097.052.102.052.105.051.11.052.114.051.119.051.123.051.127.05.131.05.135.05.139.049.144.048.147.048.152.047.155.046.16.045.163.045.167.043.171.043.176.042.178.04.183.04.187.038.19.037.194.036.197.034.202.033.204.032.209.03.212.028.216.027.219.025.222.024.226.021.23.02.233.018.236.017.24.014.243.012.246.01.249.008.253.006.256.003.259.001.26-.001.257-.003.254-.006.25-.008.247-.01.244-.013.241-.014.237-.016.233-.018.231-.02.226-.022.224-.024.22-.025.216-.027.212-.029.21-.03.205-.032.202-.033.198-.035.194-.036.191-.037.187-.039.183-.039.179-.041.175-.042.172-.043.168-.044.163-.045.16-.045.155-.047.152-.047.148-.048.143-.049.139-.049.136-.049.131-.051.126-.05.123-.051.118-.052.114-.051.11-.052.106-.052.101-.052.096-.052.092-.052.088-.052.083-.052.079-.052.074-.052.07-.051.065-.051.06-.051.056-.05.051-.049.023-.025.023-.025.021-.024.02-.024.019-.024.018-.024.017-.024.015-.023.014-.024.013-.023.012-.023.01-.022.01-.023.008-.022.006-.022.006-.022.004-.022.004-.021.001-.021.001-.021v-4.153l-.077.054-.08.054-.083.053-.085.053-.087.053-.09.051-.093.051-.095.051-.097.05-.1.049-.102.048-.105.048-.106.048-.109.046-.111.046-.114.046-.115.044-.118.044-.12.043-.122.043-.124.042-.126.041-.128.04-.13.039-.132.039-.134.038-.135.037-.138.036-.139.036-.142.034-.143.034-.144.033-.147.032-.148.032-.15.03-.151.03-.153.028-.154.028-.156.027-.158.026-.159.024-.161.024-.162.023-.163.023-.165.021-.166.02-.167.019-.169.018-.169.017-.171.016-.173.015-.173.014-.175.013-.175.012-.177.01-.178.01-.179.009-.179.007-.181.006-.182.006-.182.004-.184.003-.184.001-.185.001-.185-.001-.184-.001-.184-.003-.182-.004-.182-.006-.181-.006-.179-.007-.179-.009-.178-.01-.176-.01-.176-.012-.175-.013-.173-.014-.172-.015-.171-.016-.17-.017-.169-.018-.167-.019-.166-.02-.165-.021-.163-.023-.162-.023-.161-.024-.159-.024-.157-.026-.156-.027-.155-.028-.153-.028-.151-.03-.15-.03-.148-.032-.146-.032-.145-.033-.143-.034-.141-.034-.14-.036-.137-.036-.136-.037-.134-.038-.132-.039-.13-.039-.128-.041-.126-.041-.124-.041-.122-.043-.12-.043-.117-.044-.116-.044-.113-.046-.112-.046-.109-.046-.106-.048-.105-.048-.102-.048-.1-.05-.097-.049-.095-.051-.093-.051-.09-.052-.087-.052-.085-.053-.083-.053-.08-.054-.077-.054v4.153zm8.74-8.179l-.257.004-.254.005-.25.008-.247.011-.244.012-.241.014-.237.016-.233.018-.231.021-.226.022-.224.023-.22.026-.216.027-.212.028-.21.031-.205.032-.202.033-.198.034-.194.036-.191.038-.187.038-.183.04-.179.041-.175.042-.172.043-.168.043-.163.045-.16.046-.155.046-.152.048-.148.048-.143.048-.139.049-.136.05-.131.05-.126.051-.123.051-.118.051-.114.052-.11.052-.106.052-.101.052-.096.052-.092.052-.088.052-.083.052-.079.052-.074.051-.07.052-.065.051-.06.05-.056.05-.051.05-.023.025-.023.024-.021.024-.02.025-.019.024-.018.024-.017.023-.015.024-.014.023-.013.023-.012.023-.01.023-.01.022-.008.022-.006.023-.006.021-.004.022-.004.021-.001.021-.001.021.001.021.001.021.004.021.004.022.006.021.006.023.008.022.01.022.01.023.012.023.013.023.014.023.015.024.017.023.018.024.019.024.02.025.021.024.023.024.023.025.051.05.056.05.06.05.065.051.07.052.074.051.079.052.083.052.088.052.092.052.096.052.101.052.106.052.11.052.114.052.118.051.123.051.126.051.131.05.136.05.139.049.143.048.148.048.152.048.155.046.16.046.163.045.168.043.172.043.175.042.179.041.183.04.187.038.191.038.194.036.198.034.202.033.205.032.21.031.212.028.216.027.22.026.224.023.226.022.231.021.233.018.237.016.241.014.244.012.247.011.25.008.254.005.257.004.26.001.26-.001.257-.004.254-.005.25-.008.247-.011.244-.012.241-.014.237-.016.233-.018.231-.021.226-.022.224-.023.22-.026.216-.027.212-.028.21-.031.205-.032.202-.033.198-.034.194-.036.191-.038.187-.038.183-.04.179-.041.175-.042.172-.043.168-.043.163-.045.16-.046.155-.046.152-.048.148-.048.143-.048.139-.049.136-.05.131-.05.126-.051.123-.051.118-.051.114-.052.11-.052.106-.052.101-.052.096-.052.092-.052.088-.052.083-.052.079-.052.074-.051.07-.052.065-.051.06-.05.056-.05.051-.05.023-.025.023-.024.021-.024.02-.025.019-.024.018-.024.017-.023.015-.024.014-.023.013-.023.012-.023.01-.023.01-.022.008-.022.006-.023.006-.021.004-.022.004-.021.001-.021.001-.021-.001-.021-.001-.021-.004-.021-.004-.022-.006-.021-.006-.023-.008-.022-.01-.022-.01-.023-.012-.023-.013-.023-.014-.023-.015-.024-.017-.023-.018-.024-.019-.024-.02-.025-.021-.024-.023-.024-.023-.025-.051-.05-.056-.05-.06-.05-.065-.051-.07-.052-.074-.051-.079-.052-.083-.052-.088-.052-.092-.052-.096-.052-.101-.052-.106-.052-.11-.052-.114-.052-.118-.051-.123-.051-.126-.051-.131-.05-.136-.05-.139-.049-.143-.048-.148-.048-.152-.048-.155-.046-.16-.046-.163-.045-.168-.043-.172-.043-.175-.042-.179-.041-.183-.04-.187-.038-.191-.038-.194-.036-.198-.034-.202-.033-.205-.032-.21-.031-.212-.028-.216-.027-.22-.026-.224-.023-.226-.022-.231-.021-.233-.018-.237-.016-.241-.014-.244-.012-.247-.011-.25-.008-.254-.005-.257-.004-.26-.001-.26.001z'/></symbol></defs><defs><symbol id='mermaid-0-clock' width='24' height='24'><path transform='scale(.5)' d='M12 2c5.514 0 10 4.486 10 10s-4.486 10-10 10-10-4.486-10-10 4.486-10 10-10zm0-2c-6.627 0-12 5.373-12 12s5.373 12 12 12 12-5.373 12-12-5.373-12-12-12zm5.848 12.459c.202.038.202.333.001.372-1.907.361-6.045 1.111-6.547 1.111-.719 0-1.301-.582-1.301-1.301 0-.512.77-5.447 1.125-7.445.034-.192.312-.181.343.014l.985 6.238 5.394 1.011z'/></symbol></defs><defs><marker id='mermaid-0-arrowhead' refX='7.9' refY='5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto-start-reverse'><path d='M -1 0 L 10 5 L 0 10 z'/></marker></defs><defs><marker id='mermaid-0-crosshead' markerWidth='15' markerHeight='8' orient='auto' refX='4' refY='4.5'><path fill='none' stroke='black' stroke-width='1pt' d='M 1%2c2 L 6%2c7 M 6%2c2 L 1%2c7' style='stroke-dasharray: 0%2c 0%3b'/></marker></defs><defs><marker id='mermaid-0-filled-head' refX='15.5' refY='7' markerWidth='20' markerHeight='28' orient='auto'><path d='M 18%2c7 L9%2c13 L14%2c7 L9%2c1 Z'/></marker></defs><defs><marker id='mermaid-0-sequencenumber' refX='15' refY='15' markerWidth='60' markerHeight='40' orient='auto'><circle cx='15' cy='15' r='6'/></marker></defs><defs><marker id='mermaid-0-solidTopArrowHead' refX='7.9' refY='7.25' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto-start-reverse'><path d='M 0 0 L 10 8 L 0 8 z'/></marker></defs><defs><marker id='mermaid-0-solidBottomArrowHead' refX='7.9' refY='0.75' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto-start-reverse'><path d='M 0 0 L 10 0 L 0 8 z'/></marker></defs><defs><marker id='mermaid-0-stickTopArrowHead' refX='7.5' refY='7' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto-start-reverse'><path d='M 0 0 L 7 7' stroke='black' stroke-width='1.5' fill='none'/></marker></defs><defs><marker id='mermaid-0-stickBottomArrowHead' refX='7.5' refY='0' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto-start-reverse'><path d='M 0 7 L 7 0' stroke='black' stroke-width='1.5' fill='none'/></marker></defs><text x='174' y='80' text-anchor='middle' dominant-baseline='middle' alignment-baseline='middle' class='messageText' dy='1em' style='font-family: arial%2c sans-serif%3b font-size: 16px%3b font-weight: 400%3b'>查询订单状态</text><line x1='76' y1='109' x2='271' y2='109' class='messageLine0' data-et='message' data-id='i0' data-from='User' data-to='App' stroke-width='2' stroke='none' marker-end='url(%23mermaid-0-arrowhead)' style='fill: none%3b'/><text x='380' y='124' text-anchor='middle' dominant-baseline='middle' alignment-baseline='middle' class='messageText' dy='1em' style='font-family: arial%2c sans-serif%3b font-size: 16px%3b font-weight: 400%3b'>用户输入 %2b 工具定义</text><line x1='276' y1='153' x2='484' y2='153' class='messageLine0' data-et='message' data-id='i1' data-from='App' data-to='Model' stroke-width='2' stroke='none' marker-end='url(%23mermaid-0-arrowhead)' style='fill: none%3b'/><text x='383' y='168' text-anchor='middle' dominant-baseline='middle' alignment-baseline='middle' class='messageText' dy='1em' style='font-family: arial%2c sans-serif%3b font-size: 16px%3b font-weight: 400%3b'>get_order(order_id)</text><line x1='487' y1='199' x2='279' y2='199' class='messageLine1' data-et='message' data-id='i2' data-from='Model' data-to='App' stroke-width='2' stroke='none' marker-end='url(%23mermaid-0-arrowhead)' style='stroke-dasharray: 3%2c 3%3b fill: none%3b'/><text x='276' y='214' text-anchor='middle' dominant-baseline='middle' alignment-baseline='middle' class='messageText' dy='1em' style='font-family: arial%2c sans-serif%3b font-size: 16px%3b font-weight: 400%3b'>校验参数和权限</text><path d='M 276%2c243 C 336%2c233 336%2c273 276%2c263' class='messageLine0' data-et='message' data-id='i3' data-from='App' data-to='App' stroke-width='2' stroke='none' marker-end='url(%23mermaid-0-arrowhead)' style='fill: none%3b'/><text x='480' y='288' text-anchor='middle' dominant-baseline='middle' alignment-baseline='middle' class='messageText' dy='1em' style='font-family: arial%2c sans-serif%3b font-size: 16px%3b font-weight: 400%3b'>执行 get_order</text><line x1='276' y1='319' x2='684' y2='319' class='messageLine0' data-et='message' data-id='i4' data-from='App' data-to='Tool' stroke-width='2' stroke='none' marker-end='url(%23mermaid-0-arrowhead)' style='fill: none%3b'/><text x='483' y='334' text-anchor='middle' dominant-baseline='middle' alignment-baseline='middle' class='messageText' dy='1em' style='font-family: arial%2c sans-serif%3b font-size: 16px%3b font-weight: 400%3b'>返回真实订单数据</text><line x1='687' y1='363' x2='279' y2='363' class='messageLine1' data-et='message' data-id='i5' data-from='Tool' data-to='App' stroke-width='2' stroke='none' marker-end='url(%23mermaid-0-arrowhead)' style='stroke-dasharray: 3%2c 3%3b fill: none%3b'/><text x='380' y='378' text-anchor='middle' dominant-baseline='middle' alignment-baseline='middle' class='messageText' dy='1em' style='font-family: arial%2c sans-serif%3b font-size: 16px%3b font-weight: 400%3b'>function_call_output</text><line x1='276' y1='409' x2='484' y2='409' class='messageLine0' data-et='message' data-id='i6' data-from='App' data-to='Model' stroke-width='2' stroke='none' marker-end='url(%23mermaid-0-arrowhead)' style='fill: none%3b'/><text x='383' y='424' text-anchor='middle' dominant-baseline='middle' alignment-baseline='middle' class='messageText' dy='1em' style='font-family: arial%2c sans-serif%3b font-size: 16px%3b font-weight: 400%3b'>生成最终回答</text><line x1='487' y1='453' x2='279' y2='453' class='messageLine1' data-et='message' data-id='i7' data-from='Model' data-to='App' stroke-width='2' stroke='none' marker-end='url(%23mermaid-0-arrowhead)' style='stroke-dasharray: 3%2c 3%3b fill: none%3b'/><text x='177' y='468' text-anchor='middle' dominant-baseline='middle' alignment-baseline='middle' class='messageText' dy='1em' style='font-family: arial%2c sans-serif%3b font-size: 16px%3b font-weight: 400%3b'>展示结果</text><line x1='274' y1='497' x2='79' y2='497' class='messageLine1' data-et='message' data-id='i8' data-from='App' data-to='User' stroke-width='2' stroke='none' marker-end='url(%23mermaid-0-arrowhead)' style='stroke-dasharray: 3%2c 3%3b fill: none%3b'/></svg>)
)%3b}%23mermaid-dark-0 rect.note[data-look='neo']{stroke:hsl(180%2c 0%%2c 18.3529411765%)%3bfill:hsl(180%2c 1.5873015873%%2c 28.3529411765%)%3bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b}%23mermaid-dark-0 text.actor%26gt%3btspan{fill:lightgrey%3bstroke:none%3b}%23mermaid-dark-0 .actor-line{stroke:%23ccc%3b}%23mermaid-dark-0 .innerArc{stroke-width:1.5%3bstroke-dasharray:none%3b}%23mermaid-dark-0 .messageLine0{stroke-width:1.5%3bstroke-dasharray:none%3bstroke:lightgrey%3b}%23mermaid-dark-0 .messageLine1{stroke-width:1.5%3bstroke-dasharray:2%2c2%3bstroke:lightgrey%3b}%23mermaid-dark-0 [id%24='-arrowhead'] path{fill:lightgrey%3bstroke:lightgrey%3b}%23mermaid-dark-0 .sequenceNumber{fill:black%3b}%23mermaid-dark-0 [id%24='-sequencenumber']{fill:lightgrey%3b}%23mermaid-dark-0 [id%24='-crosshead'] path{fill:lightgrey%3bstroke:lightgrey%3b}%23mermaid-dark-0 .messageText{fill:lightgrey%3bstroke:none%3b}%23mermaid-dark-0 .labelBox{stroke:%23ccc%3bfill:%231f2020%3bfilter:none%3b}%23mermaid-dark-0 .labelText%2c%23mermaid-dark-0 .labelText%26gt%3btspan{fill:lightgrey%3bstroke:none%3b}%23mermaid-dark-0 .loopText%2c%23mermaid-dark-0 .loopText%26gt%3btspan{fill:lightgrey%3bstroke:none%3b}%23mermaid-dark-0 .sectionTitle%2c%23mermaid-dark-0 .sectionTitle%26gt%3btspan{fill:lightgrey%3bstroke:none%3b}%23mermaid-dark-0 .loopLine{stroke-width:2px%3bstroke-dasharray:2%2c2%3bstroke:%23ccc%3bfill:%23ccc%3b}%23mermaid-dark-0 .note{stroke:hsl(180%2c 0%%2c 18.3529411765%)%3bfill:hsl(180%2c 1.5873015873%%2c 28.3529411765%)%3b}%23mermaid-dark-0 .noteText%2c%23mermaid-dark-0 .noteText%26gt%3btspan{fill:rgb(183.8476190475%2c 181.5523809523%2c 181.5523809523)%3bstroke:none%3bfont-weight:normal%3b}%23mermaid-dark-0 .activation0{fill:hsl(180%2c 1.5873015873%%2c 28.3529411765%)%3bstroke:%23ccc%3b}%23mermaid-dark-0 .activation1{fill:hsl(180%2c 1.5873015873%%2c 28.3529411765%)%3bstroke:%23ccc%3b}%23mermaid-dark-0 .activation2{fill:hsl(180%2c 1.5873015873%%2c 28.3529411765%)%3bstroke:%23ccc%3b}%23mermaid-dark-0 .actorPopupMenu{position:absolute%3b}%23mermaid-dark-0 .actorPopupMenuPanel{position:absolute%3bfill:%231f2020%3bbox-shadow:0px 8px 16px 0px rgba(0%2c0%2c0%2c0.2)%3bfilter:drop-shadow(3px 5px 2px rgb(0 0 0 / 0.4))%3b}%23mermaid-dark-0 .actor-man circle%2c%23mermaid-dark-0 line{fill:%231f2020%3bstroke-width:2px%3b}%23mermaid-dark-0 g rect.rect{filter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3bstroke:%23ccc%3b}%23mermaid-dark-0 .node .neo-node{stroke:%23ccc%3b}%23mermaid-dark-0 [data-look='neo'].node rect%2c%23mermaid-dark-0 [data-look='neo'].cluster rect%2c%23mermaid-dark-0 [data-look='neo'].node polygon{stroke:url(%23mermaid-dark-0-gradient)%3bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b}%23mermaid-dark-0 [data-look='neo'].swimlane.cluster rect{filter:none%3b}%23mermaid-dark-0 [data-look='neo'].node path{stroke:url(%23mermaid-dark-0-gradient)%3bstroke-width:1px%3b}%23mermaid-dark-0 [data-look='neo'].node .outer-path{filter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b}%23mermaid-dark-0 [data-look='neo'].node .neo-line path{stroke:%23ccc%3bfilter:none%3b}%23mermaid-dark-0 [data-look='neo'].node circle{stroke:url(%23mermaid-dark-0-gradient)%3bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b}%23mermaid-dark-0 [data-look='neo'].node circle .state-start{fill:black%3b}%23mermaid-dark-0 [data-look='neo'].icon-shape .icon{fill:url(%23mermaid-dark-0-gradient)%3bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b}%23mermaid-dark-0 [data-look='neo'].icon-shape .icon-neo path{stroke:url(%23mermaid-dark-0-gradient)%3bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b}%23mermaid-dark-0 :root{--mermaid-font-family:arial%2csans-serif%3b}</style><g/><defs><symbol id='mermaid-dark-0-computer' width='24' height='24'><path transform='scale(.5)' d='M2 2v13h20v-13h-20zm18 11h-16v-9h16v9zm-10.228 6l.466-1h3.524l.467 1h-4.457zm14.228 3h-24l2-6h2.104l-1.33 4h18.45l-1.297-4h2.073l2 6zm-5-10h-14v-7h14v7z'/></symbol></defs><defs><symbol id='mermaid-dark-0-database' fill-rule='evenodd' clip-rule='evenodd'><path transform='scale(.5)' d='M12.258.001l.256.004.255.005.253.008.251.01.249.012.247.015.246.016.242.019.241.02.239.023.236.024.233.027.231.028.229.031.225.032.223.034.22.036.217.038.214.04.211.041.208.043.205.045.201.046.198.048.194.05.191.051.187.053.183.054.18.056.175.057.172.059.168.06.163.061.16.063.155.064.15.066.074.033.073.033.071.034.07.034.069.035.068.035.067.035.066.035.064.036.064.036.062.036.06.036.06.037.058.037.058.037.055.038.055.038.053.038.052.038.051.039.05.039.048.039.047.039.045.04.044.04.043.04.041.04.04.041.039.041.037.041.036.041.034.041.033.042.032.042.03.042.029.042.027.042.026.043.024.043.023.043.021.043.02.043.018.044.017.043.015.044.013.044.012.044.011.045.009.044.007.045.006.045.004.045.002.045.001.045v17l-.001.045-.002.045-.004.045-.006.045-.007.045-.009.044-.011.045-.012.044-.013.044-.015.044-.017.043-.018.044-.02.043-.021.043-.023.043-.024.043-.026.043-.027.042-.029.042-.03.042-.032.042-.033.042-.034.041-.036.041-.037.041-.039.041-.04.041-.041.04-.043.04-.044.04-.045.04-.047.039-.048.039-.05.039-.051.039-.052.038-.053.038-.055.038-.055.038-.058.037-.058.037-.06.037-.06.036-.062.036-.064.036-.064.036-.066.035-.067.035-.068.035-.069.035-.07.034-.071.034-.073.033-.074.033-.15.066-.155.064-.16.063-.163.061-.168.06-.172.059-.175.057-.18.056-.183.054-.187.053-.191.051-.194.05-.198.048-.201.046-.205.045-.208.043-.211.041-.214.04-.217.038-.22.036-.223.034-.225.032-.229.031-.231.028-.233.027-.236.024-.239.023-.241.02-.242.019-.246.016-.247.015-.249.012-.251.01-.253.008-.255.005-.256.004-.258.001-.258-.001-.256-.004-.255-.005-.253-.008-.251-.01-.249-.012-.247-.015-.245-.016-.243-.019-.241-.02-.238-.023-.236-.024-.234-.027-.231-.028-.228-.031-.226-.032-.223-.034-.22-.036-.217-.038-.214-.04-.211-.041-.208-.043-.204-.045-.201-.046-.198-.048-.195-.05-.19-.051-.187-.053-.184-.054-.179-.056-.176-.057-.172-.059-.167-.06-.164-.061-.159-.063-.155-.064-.151-.066-.074-.033-.072-.033-.072-.034-.07-.034-.069-.035-.068-.035-.067-.035-.066-.035-.064-.036-.063-.036-.062-.036-.061-.036-.06-.037-.058-.037-.057-.037-.056-.038-.055-.038-.053-.038-.052-.038-.051-.039-.049-.039-.049-.039-.046-.039-.046-.04-.044-.04-.043-.04-.041-.04-.04-.041-.039-.041-.037-.041-.036-.041-.034-.041-.033-.042-.032-.042-.03-.042-.029-.042-.027-.042-.026-.043-.024-.043-.023-.043-.021-.043-.02-.043-.018-.044-.017-.043-.015-.044-.013-.044-.012-.044-.011-.045-.009-.044-.007-.045-.006-.045-.004-.045-.002-.045-.001-.045v-17l.001-.045.002-.045.004-.045.006-.045.007-.045.009-.044.011-.045.012-.044.013-.044.015-.044.017-.043.018-.044.02-.043.021-.043.023-.043.024-.043.026-.043.027-.042.029-.042.03-.042.032-.042.033-.042.034-.041.036-.041.037-.041.039-.041.04-.041.041-.04.043-.04.044-.04.046-.04.046-.039.049-.039.049-.039.051-.039.052-.038.053-.038.055-.038.056-.038.057-.037.058-.037.06-.037.061-.036.062-.036.063-.036.064-.036.066-.035.067-.035.068-.035.069-.035.07-.034.072-.034.072-.033.074-.033.151-.066.155-.064.159-.063.164-.061.167-.06.172-.059.176-.057.179-.056.184-.054.187-.053.19-.051.195-.05.198-.048.201-.046.204-.045.208-.043.211-.041.214-.04.217-.038.22-.036.223-.034.226-.032.228-.031.231-.028.234-.027.236-.024.238-.023.241-.02.243-.019.245-.016.247-.015.249-.012.251-.01.253-.008.255-.005.256-.004.258-.001.258.001zm-9.258 20.499v.01l.001.021.003.021.004.022.005.021.006.022.007.022.009.023.01.022.011.023.012.023.013.023.015.023.016.024.017.023.018.024.019.024.021.024.022.025.023.024.024.025.052.049.056.05.061.051.066.051.07.051.075.051.079.052.084.052.088.052.092.052.097.052.102.051.105.052.11.052.114.051.119.051.123.051.127.05.131.05.135.05.139.048.144.049.147.047.152.047.155.047.16.045.163.045.167.043.171.043.176.041.178.041.183.039.187.039.19.037.194.035.197.035.202.033.204.031.209.03.212.029.216.027.219.025.222.024.226.021.23.02.233.018.236.016.24.015.243.012.246.01.249.008.253.005.256.004.259.001.26-.001.257-.004.254-.005.25-.008.247-.011.244-.012.241-.014.237-.016.233-.018.231-.021.226-.021.224-.024.22-.026.216-.027.212-.028.21-.031.205-.031.202-.034.198-.034.194-.036.191-.037.187-.039.183-.04.179-.04.175-.042.172-.043.168-.044.163-.045.16-.046.155-.046.152-.047.148-.048.143-.049.139-.049.136-.05.131-.05.126-.05.123-.051.118-.052.114-.051.11-.052.106-.052.101-.052.096-.052.092-.052.088-.053.083-.051.079-.052.074-.052.07-.051.065-.051.06-.051.056-.05.051-.05.023-.024.023-.025.021-.024.02-.024.019-.024.018-.024.017-.024.015-.023.014-.024.013-.023.012-.023.01-.023.01-.022.008-.022.006-.022.006-.022.004-.022.004-.021.001-.021.001-.021v-4.127l-.077.055-.08.053-.083.054-.085.053-.087.052-.09.052-.093.051-.095.05-.097.05-.1.049-.102.049-.105.048-.106.047-.109.047-.111.046-.114.045-.115.045-.118.044-.12.043-.122.042-.124.042-.126.041-.128.04-.13.04-.132.038-.134.038-.135.037-.138.037-.139.035-.142.035-.143.034-.144.033-.147.032-.148.031-.15.03-.151.03-.153.029-.154.027-.156.027-.158.026-.159.025-.161.024-.162.023-.163.022-.165.021-.166.02-.167.019-.169.018-.169.017-.171.016-.173.015-.173.014-.175.013-.175.012-.177.011-.178.01-.179.008-.179.008-.181.006-.182.005-.182.004-.184.003-.184.002h-.37l-.184-.002-.184-.003-.182-.004-.182-.005-.181-.006-.179-.008-.179-.008-.178-.01-.176-.011-.176-.012-.175-.013-.173-.014-.172-.015-.171-.016-.17-.017-.169-.018-.167-.019-.166-.02-.165-.021-.163-.022-.162-.023-.161-.024-.159-.025-.157-.026-.156-.027-.155-.027-.153-.029-.151-.03-.15-.03-.148-.031-.146-.032-.145-.033-.143-.034-.141-.035-.14-.035-.137-.037-.136-.037-.134-.038-.132-.038-.13-.04-.128-.04-.126-.041-.124-.042-.122-.042-.12-.044-.117-.043-.116-.045-.113-.045-.112-.046-.109-.047-.106-.047-.105-.048-.102-.049-.1-.049-.097-.05-.095-.05-.093-.052-.09-.051-.087-.052-.085-.053-.083-.054-.08-.054-.077-.054v4.127zm0-5.654v.011l.001.021.003.021.004.021.005.022.006.022.007.022.009.022.01.022.011.023.012.023.013.023.015.024.016.023.017.024.018.024.019.024.021.024.022.024.023.025.024.024.052.05.056.05.061.05.066.051.07.051.075.052.079.051.084.052.088.052.092.052.097.052.102.052.105.052.11.051.114.051.119.052.123.05.127.051.131.05.135.049.139.049.144.048.147.048.152.047.155.046.16.045.163.045.167.044.171.042.176.042.178.04.183.04.187.038.19.037.194.036.197.034.202.033.204.032.209.03.212.028.216.027.219.025.222.024.226.022.23.02.233.018.236.016.24.014.243.012.246.01.249.008.253.006.256.003.259.001.26-.001.257-.003.254-.006.25-.008.247-.01.244-.012.241-.015.237-.016.233-.018.231-.02.226-.022.224-.024.22-.025.216-.027.212-.029.21-.03.205-.032.202-.033.198-.035.194-.036.191-.037.187-.039.183-.039.179-.041.175-.042.172-.043.168-.044.163-.045.16-.045.155-.047.152-.047.148-.048.143-.048.139-.05.136-.049.131-.05.126-.051.123-.051.118-.051.114-.052.11-.052.106-.052.101-.052.096-.052.092-.052.088-.052.083-.052.079-.052.074-.051.07-.052.065-.051.06-.05.056-.051.051-.049.023-.025.023-.024.021-.025.02-.024.019-.024.018-.024.017-.024.015-.023.014-.023.013-.024.012-.022.01-.023.01-.023.008-.022.006-.022.006-.022.004-.021.004-.022.001-.021.001-.021v-4.139l-.077.054-.08.054-.083.054-.085.052-.087.053-.09.051-.093.051-.095.051-.097.05-.1.049-.102.049-.105.048-.106.047-.109.047-.111.046-.114.045-.115.044-.118.044-.12.044-.122.042-.124.042-.126.041-.128.04-.13.039-.132.039-.134.038-.135.037-.138.036-.139.036-.142.035-.143.033-.144.033-.147.033-.148.031-.15.03-.151.03-.153.028-.154.028-.156.027-.158.026-.159.025-.161.024-.162.023-.163.022-.165.021-.166.02-.167.019-.169.018-.169.017-.171.016-.173.015-.173.014-.175.013-.175.012-.177.011-.178.009-.179.009-.179.007-.181.007-.182.005-.182.004-.184.003-.184.002h-.37l-.184-.002-.184-.003-.182-.004-.182-.005-.181-.007-.179-.007-.179-.009-.178-.009-.176-.011-.176-.012-.175-.013-.173-.014-.172-.015-.171-.016-.17-.017-.169-.018-.167-.019-.166-.02-.165-.021-.163-.022-.162-.023-.161-.024-.159-.025-.157-.026-.156-.027-.155-.028-.153-.028-.151-.03-.15-.03-.148-.031-.146-.033-.145-.033-.143-.033-.141-.035-.14-.036-.137-.036-.136-.037-.134-.038-.132-.039-.13-.039-.128-.04-.126-.041-.124-.042-.122-.043-.12-.043-.117-.044-.116-.044-.113-.046-.112-.046-.109-.046-.106-.047-.105-.048-.102-.049-.1-.049-.097-.05-.095-.051-.093-.051-.09-.051-.087-.053-.085-.052-.083-.054-.08-.054-.077-.054v4.139zm0-5.666v.011l.001.02.003.022.004.021.005.022.006.021.007.022.009.023.01.022.011.023.012.023.013.023.015.023.016.024.017.024.018.023.019.024.021.025.022.024.023.024.024.025.052.05.056.05.061.05.066.051.07.051.075.052.079.051.084.052.088.052.092.052.097.052.102.052.105.051.11.052.114.051.119.051.123.051.127.05.131.05.135.05.139.049.144.048.147.048.152.047.155.046.16.045.163.045.167.043.171.043.176.042.178.04.183.04.187.038.19.037.194.036.197.034.202.033.204.032.209.03.212.028.216.027.219.025.222.024.226.021.23.02.233.018.236.017.24.014.243.012.246.01.249.008.253.006.256.003.259.001.26-.001.257-.003.254-.006.25-.008.247-.01.244-.013.241-.014.237-.016.233-.018.231-.02.226-.022.224-.024.22-.025.216-.027.212-.029.21-.03.205-.032.202-.033.198-.035.194-.036.191-.037.187-.039.183-.039.179-.041.175-.042.172-.043.168-.044.163-.045.16-.045.155-.047.152-.047.148-.048.143-.049.139-.049.136-.049.131-.051.126-.05.123-.051.118-.052.114-.051.11-.052.106-.052.101-.052.096-.052.092-.052.088-.052.083-.052.079-.052.074-.052.07-.051.065-.051.06-.051.056-.05.051-.049.023-.025.023-.025.021-.024.02-.024.019-.024.018-.024.017-.024.015-.023.014-.024.013-.023.012-.023.01-.022.01-.023.008-.022.006-.022.006-.022.004-.022.004-.021.001-.021.001-.021v-4.153l-.077.054-.08.054-.083.053-.085.053-.087.053-.09.051-.093.051-.095.051-.097.05-.1.049-.102.048-.105.048-.106.048-.109.046-.111.046-.114.046-.115.044-.118.044-.12.043-.122.043-.124.042-.126.041-.128.04-.13.039-.132.039-.134.038-.135.037-.138.036-.139.036-.142.034-.143.034-.144.033-.147.032-.148.032-.15.03-.151.03-.153.028-.154.028-.156.027-.158.026-.159.024-.161.024-.162.023-.163.023-.165.021-.166.02-.167.019-.169.018-.169.017-.171.016-.173.015-.173.014-.175.013-.175.012-.177.01-.178.01-.179.009-.179.007-.181.006-.182.006-.182.004-.184.003-.184.001-.185.001-.185-.001-.184-.001-.184-.003-.182-.004-.182-.006-.181-.006-.179-.007-.179-.009-.178-.01-.176-.01-.176-.012-.175-.013-.173-.014-.172-.015-.171-.016-.17-.017-.169-.018-.167-.019-.166-.02-.165-.021-.163-.023-.162-.023-.161-.024-.159-.024-.157-.026-.156-.027-.155-.028-.153-.028-.151-.03-.15-.03-.148-.032-.146-.032-.145-.033-.143-.034-.141-.034-.14-.036-.137-.036-.136-.037-.134-.038-.132-.039-.13-.039-.128-.041-.126-.041-.124-.041-.122-.043-.12-.043-.117-.044-.116-.044-.113-.046-.112-.046-.109-.046-.106-.048-.105-.048-.102-.048-.1-.05-.097-.049-.095-.051-.093-.051-.09-.052-.087-.052-.085-.053-.083-.053-.08-.054-.077-.054v4.153zm8.74-8.179l-.257.004-.254.005-.25.008-.247.011-.244.012-.241.014-.237.016-.233.018-.231.021-.226.022-.224.023-.22.026-.216.027-.212.028-.21.031-.205.032-.202.033-.198.034-.194.036-.191.038-.187.038-.183.04-.179.041-.175.042-.172.043-.168.043-.163.045-.16.046-.155.046-.152.048-.148.048-.143.048-.139.049-.136.05-.131.05-.126.051-.123.051-.118.051-.114.052-.11.052-.106.052-.101.052-.096.052-.092.052-.088.052-.083.052-.079.052-.074.051-.07.052-.065.051-.06.05-.056.05-.051.05-.023.025-.023.024-.021.024-.02.025-.019.024-.018.024-.017.023-.015.024-.014.023-.013.023-.012.023-.01.023-.01.022-.008.022-.006.023-.006.021-.004.022-.004.021-.001.021-.001.021.001.021.001.021.004.021.004.022.006.021.006.023.008.022.01.022.01.023.012.023.013.023.014.023.015.024.017.023.018.024.019.024.02.025.021.024.023.024.023.025.051.05.056.05.06.05.065.051.07.052.074.051.079.052.083.052.088.052.092.052.096.052.101.052.106.052.11.052.114.052.118.051.123.051.126.051.131.05.136.05.139.049.143.048.148.048.152.048.155.046.16.046.163.045.168.043.172.043.175.042.179.041.183.04.187.038.191.038.194.036.198.034.202.033.205.032.21.031.212.028.216.027.22.026.224.023.226.022.231.021.233.018.237.016.241.014.244.012.247.011.25.008.254.005.257.004.26.001.26-.001.257-.004.254-.005.25-.008.247-.011.244-.012.241-.014.237-.016.233-.018.231-.021.226-.022.224-.023.22-.026.216-.027.212-.028.21-.031.205-.032.202-.033.198-.034.194-.036.191-.038.187-.038.183-.04.179-.041.175-.042.172-.043.168-.043.163-.045.16-.046.155-.046.152-.048.148-.048.143-.048.139-.049.136-.05.131-.05.126-.051.123-.051.118-.051.114-.052.11-.052.106-.052.101-.052.096-.052.092-.052.088-.052.083-.052.079-.052.074-.051.07-.052.065-.051.06-.05.056-.05.051-.05.023-.025.023-.024.021-.024.02-.025.019-.024.018-.024.017-.023.015-.024.014-.023.013-.023.012-.023.01-.023.01-.022.008-.022.006-.023.006-.021.004-.022.004-.021.001-.021.001-.021-.001-.021-.001-.021-.004-.021-.004-.022-.006-.021-.006-.023-.008-.022-.01-.022-.01-.023-.012-.023-.013-.023-.014-.023-.015-.024-.017-.023-.018-.024-.019-.024-.02-.025-.021-.024-.023-.024-.023-.025-.051-.05-.056-.05-.06-.05-.065-.051-.07-.052-.074-.051-.079-.052-.083-.052-.088-.052-.092-.052-.096-.052-.101-.052-.106-.052-.11-.052-.114-.052-.118-.051-.123-.051-.126-.051-.131-.05-.136-.05-.139-.049-.143-.048-.148-.048-.152-.048-.155-.046-.16-.046-.163-.045-.168-.043-.172-.043-.175-.042-.179-.041-.183-.04-.187-.038-.191-.038-.194-.036-.198-.034-.202-.033-.205-.032-.21-.031-.212-.028-.216-.027-.22-.026-.224-.023-.226-.022-.231-.021-.233-.018-.237-.016-.241-.014-.244-.012-.247-.011-.25-.008-.254-.005-.257-.004-.26-.001-.26.001z'/></symbol></defs><defs><symbol id='mermaid-dark-0-clock' width='24' height='24'><path transform='scale(.5)' d='M12 2c5.514 0 10 4.486 10 10s-4.486 10-10 10-10-4.486-10-10 4.486-10 10-10zm0-2c-6.627 0-12 5.373-12 12s5.373 12 12 12 12-5.373 12-12-5.373-12-12-12zm5.848 12.459c.202.038.202.333.001.372-1.907.361-6.045 1.111-6.547 1.111-.719 0-1.301-.582-1.301-1.301 0-.512.77-5.447 1.125-7.445.034-.192.312-.181.343.014l.985 6.238 5.394 1.011z'/></symbol></defs><defs><marker id='mermaid-dark-0-arrowhead' refX='7.9' refY='5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto-start-reverse'><path d='M -1 0 L 10 5 L 0 10 z'/></marker></defs><defs><marker id='mermaid-dark-0-crosshead' markerWidth='15' markerHeight='8' orient='auto' refX='4' refY='4.5'><path fill='none' stroke='black' stroke-width='1pt' d='M 1%2c2 L 6%2c7 M 6%2c2 L 1%2c7' style='stroke-dasharray: 0%2c 0%3b'/></marker></defs><defs><marker id='mermaid-dark-0-filled-head' refX='15.5' refY='7' markerWidth='20' markerHeight='28' orient='auto'><path d='M 18%2c7 L9%2c13 L14%2c7 L9%2c1 Z'/></marker></defs><defs><marker id='mermaid-dark-0-sequencenumber' refX='15' refY='15' markerWidth='60' markerHeight='40' orient='auto'><circle cx='15' cy='15' r='6'/></marker></defs><defs><marker id='mermaid-dark-0-solidTopArrowHead' refX='7.9' refY='7.25' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto-start-reverse'><path d='M 0 0 L 10 8 L 0 8 z'/></marker></defs><defs><marker id='mermaid-dark-0-solidBottomArrowHead' refX='7.9' refY='0.75' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto-start-reverse'><path d='M 0 0 L 10 0 L 0 8 z'/></marker></defs><defs><marker id='mermaid-dark-0-stickTopArrowHead' refX='7.5' refY='7' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto-start-reverse'><path d='M 0 0 L 7 7' stroke='black' stroke-width='1.5' fill='none'/></marker></defs><defs><marker id='mermaid-dark-0-stickBottomArrowHead' refX='7.5' refY='0' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto-start-reverse'><path d='M 0 7 L 7 0' stroke='black' stroke-width='1.5' fill='none'/></marker></defs><text x='174' y='80' text-anchor='middle' dominant-baseline='middle' alignment-baseline='middle' class='messageText' dy='1em' style='font-family: arial%2c sans-serif%3b font-size: 16px%3b font-weight: 400%3b'>查询订单状态</text><line x1='76' y1='109' x2='271' y2='109' class='messageLine0' data-et='message' data-id='i0' data-from='User' data-to='App' stroke-width='2' stroke='none' marker-end='url(%23mermaid-dark-0-arrowhead)' style='fill: none%3b'/><text x='380' y='124' text-anchor='middle' dominant-baseline='middle' alignment-baseline='middle' class='messageText' dy='1em' style='font-family: arial%2c sans-serif%3b font-size: 16px%3b font-weight: 400%3b'>用户输入 %2b 工具定义</text><line x1='276' y1='153' x2='484' y2='153' class='messageLine0' data-et='message' data-id='i1' data-from='App' data-to='Model' stroke-width='2' stroke='none' marker-end='url(%23mermaid-dark-0-arrowhead)' style='fill: none%3b'/><text x='383' y='168' text-anchor='middle' dominant-baseline='middle' alignment-baseline='middle' class='messageText' dy='1em' style='font-family: arial%2c sans-serif%3b font-size: 16px%3b font-weight: 400%3b'>get_order(order_id)</text><line x1='487' y1='199' x2='279' y2='199' class='messageLine1' data-et='message' data-id='i2' data-from='Model' data-to='App' stroke-width='2' stroke='none' marker-end='url(%23mermaid-dark-0-arrowhead)' style='stroke-dasharray: 3%2c 3%3b fill: none%3b'/><text x='276' y='214' text-anchor='middle' dominant-baseline='middle' alignment-baseline='middle' class='messageText' dy='1em' style='font-family: arial%2c sans-serif%3b font-size: 16px%3b font-weight: 400%3b'>校验参数和权限</text><path d='M 276%2c243 C 336%2c233 336%2c273 276%2c263' class='messageLine0' data-et='message' data-id='i3' data-from='App' data-to='App' stroke-width='2' stroke='none' marker-end='url(%23mermaid-dark-0-arrowhead)' style='fill: none%3b'/><text x='480' y='288' text-anchor='middle' dominant-baseline='middle' alignment-baseline='middle' class='messageText' dy='1em' style='font-family: arial%2c sans-serif%3b font-size: 16px%3b font-weight: 400%3b'>执行 get_order</text><line x1='276' y1='319' x2='684' y2='319' class='messageLine0' data-et='message' data-id='i4' data-from='App' data-to='Tool' stroke-width='2' stroke='none' marker-end='url(%23mermaid-dark-0-arrowhead)' style='fill: none%3b'/><text x='483' y='334' text-anchor='middle' dominant-baseline='middle' alignment-baseline='middle' class='messageText' dy='1em' style='font-family: arial%2c sans-serif%3b font-size: 16px%3b font-weight: 400%3b'>返回真实订单数据</text><line x1='687' y1='363' x2='279' y2='363' class='messageLine1' data-et='message' data-id='i5' data-from='Tool' data-to='App' stroke-width='2' stroke='none' marker-end='url(%23mermaid-dark-0-arrowhead)' style='stroke-dasharray: 3%2c 3%3b fill: none%3b'/><text x='380' y='378' text-anchor='middle' dominant-baseline='middle' alignment-baseline='middle' class='messageText' dy='1em' style='font-family: arial%2c sans-serif%3b font-size: 16px%3b font-weight: 400%3b'>function_call_output</text><line x1='276' y1='409' x2='484' y2='409' class='messageLine0' data-et='message' data-id='i6' data-from='App' data-to='Model' stroke-width='2' stroke='none' marker-end='url(%23mermaid-dark-0-arrowhead)' style='fill: none%3b'/><text x='383' y='424' text-anchor='middle' dominant-baseline='middle' alignment-baseline='middle' class='messageText' dy='1em' style='font-family: arial%2c sans-serif%3b font-size: 16px%3b font-weight: 400%3b'>生成最终回答</text><line x1='487' y1='453' x2='279' y2='453' class='messageLine1' data-et='message' data-id='i7' data-from='Model' data-to='App' stroke-width='2' stroke='none' marker-end='url(%23mermaid-dark-0-arrowhead)' style='stroke-dasharray: 3%2c 3%3b fill: none%3b'/><text x='177' y='468' text-anchor='middle' dominant-baseline='middle' alignment-baseline='middle' class='messageText' dy='1em' style='font-family: arial%2c sans-serif%3b font-size: 16px%3b font-weight: 400%3b'>展示结果</text><line x1='274' y1='497' x2='79' y2='497' class='messageLine1' data-et='message' data-id='i8' data-from='App' data-to='User' stroke-width='2' stroke='none' marker-end='url(%23mermaid-dark-0-arrowhead)' style='stroke-dasharray: 3%2c 3%3b fill: none%3b'/></svg>)
模型承担的是自然语言理解和语义路由,而不是业务系统的直接执行权。
定义并调用第一个工具
准备业务函数
先定义一个与 AI 无关的普通 Python 函数:
def get_order(order_id: str) -> dict:
    # 实际项目通常会查询数据库或远程服务
    mock_data = {
        "20260919001": {
            "order_id": "20260919001",
            "status": "SHIPPED",
            "carrier": "SF Express",
        }
    }

    return mock_data.get(
        order_id,
        {
            "order_id": order_id,
            "status": "NOT_FOUND",
        },
    )
接下来需要通过 Tool Definition 告诉模型这个函数的用途和参数结构。
声明 Function Tool
tools = [
    {
        "type": "function",
        "name": "get_order",
        "description": "根据系统订单编号查询订单当前状态",
        "parameters": {
            "type": "object",
            "properties": {
                "order_id": {
                    "type": "string",
                    "description": (
                        "系统订单编号,例如 20260919001;"
                        "不是物流运单号"
                    ),
                }
            },
            "required": ["order_id"],
            "additionalProperties": False,
        },
        "strict": True,
    }
]
Tool Definition 的几个核心字段是:
| 字段 | 作用 |
|---|---|
type | 声明这是一个 Function Tool |
name | 模型调用工具时使用的名称 |
description | 说明工具适合解决什么问题 |
parameters | 使用 JSON Schema 定义参数 |
strict | 要求生成的参数遵循 Schema |
工具名称和描述实际上是模型理解业务能力的接口文档。存在多个相近工具时,应明确说明各自边界:
order_tools = [
    {
        "type": "function",
        "name": "get_order",
        "description": (
            "查询订单本身的状态,例如待支付、已支付、"
            "已取消和已发货;不查询详细物流轨迹"
        ),
        # parameters ...
    },
    {
        "type": "function",
        "name": "query_logistics",
        "description": (
            "查询已发货订单的物流公司、运单号和物流轨迹"
        ),
        # parameters ...
    },
]
参数说明也应避免歧义,尤其是 order_id、tracking_number、user_id 等容易混淆的标识。
用 Schema 约束参数
如果参数只能从有限集合选择,应使用 Enum:
"priority": {
    "type": "string",
    "enum": ["LOW", "MEDIUM", "HIGH"],
}
否则模型可能生成 high、urgent、P0 或“严重”等不同表达,业务代码很难统一处理。
开启严格模式时,工具参数 Schema 应明确必要字段,并禁止未定义属性:
"required": ["order_id"],
"additionalProperties": False,
"strict": True,
如果某个字段业务上可以为空,可以让字段类型包含 null,而不是让模型随意省略字段。
让模型选择工具
from openai import OpenAI

client = OpenAI()

response = client.responses.create(
    model="gpt-5.5",
    input="帮我查一下订单 20260919001 当前是什么状态。",
    tools=tools,
)
与普通文本调用相比,关键区别是传入了 tools。此时 response.output_text 不一定已经包含最终回答,模型可能先在 response.output 中返回 function_call。
for item in response.output:
    if item.type == "function_call":
        print(item.name)
        print(item.arguments)
        print(item.call_id)
一次工具调用包含三个重要信息:
name:模型选择的工具;arguments:模型生成的 JSON 参数;call_id:这次工具调用的唯一标识。
call_id 用来把工具执行结果与对应的调用请求关联起来。
完成工具调用闭环
模型返回 Function Call 后,应用程序需要解析参数、找到函数、执行工具,并将结果作为 function_call_output 返回给模型。
执行函数并返回结果
import json

tool_outputs = []

for item in response.output:
    if item.type != "function_call":
        continue

    arguments = json.loads(item.arguments)

    if item.name == "get_order":
        result = get_order(order_id=arguments["order_id"])
    else:
        raise ValueError(f"未知工具:{item.name}")

    tool_outputs.append(
        {
            "type": "function_call_output",
            "call_id": item.call_id,
            "output": json.dumps(result, ensure_ascii=False),
        }
    )
把结果交回模型:
final_response = client.responses.create(
    model="gpt-5.5",
    previous_response_id=response.id,
    input=tool_outputs,
    tools=tools,
)

print(final_response.output_text)
工具返回的是机器数据,而用户通常需要符合当前语境的自然语言。第二次模型请求负责将工具结果组织成最终回答。
一个完整示例
import json

from openai import OpenAI

client = OpenAI()


def get_order(order_id: str) -> dict:
    mock_data = {
        "20260919001": {
            "order_id": "20260919001",
            "status": "SHIPPED",
            "carrier": "SF Express",
        }
    }
    return mock_data.get(
        order_id,
        {"order_id": order_id, "status": "NOT_FOUND"},
    )


tools = [
    {
        "type": "function",
        "name": "get_order",
        "description": "根据系统订单编号查询订单当前状态",
        "parameters": {
            "type": "object",
            "properties": {
                "order_id": {
                    "type": "string",
                    "description": "系统订单编号",
                }
            },
            "required": ["order_id"],
            "additionalProperties": False,
        },
        "strict": True,
    }
]


response = client.responses.create(
    model="gpt-5.5",
    input="查询订单 20260919001 当前是什么状态。",
    tools=tools,
)

tool_outputs = []

for item in response.output:
    if item.type != "function_call":
        continue

    arguments = json.loads(item.arguments)

    if item.name != "get_order":
        raise ValueError(f"未知工具:{item.name}")

    result = get_order(order_id=arguments["order_id"])

    tool_outputs.append(
        {
            "type": "function_call_output",
            "call_id": item.call_id,
            "output": json.dumps(result, ensure_ascii=False),
        }
    )

if tool_outputs:
    response = client.responses.create(
        model="gpt-5.5",
        previous_response_id=response.id,
        input=tool_outputs,
        tools=tools,
    )

print(response.output_text)
整个闭环可以概括为:
%3btext-align:center%3b}%23mermaid-1 .edgeLabel p{background-color:rgba(232%2c232%2c232%2c 0.8)%3b}%23mermaid-1 .edgeLabel rect{opacity:0.5%3bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bfill:rgba(232%2c232%2c232%2c 0.8)%3b}%23mermaid-1 .labelBkg{background-color:rgba(232%2c 232%2c 232%2c 0.5)%3b}%23mermaid-1 .cluster rect{fill:%23ffffde%3bstroke:%23aaaa33%3bstroke-width:1px%3b}%23mermaid-1 .cluster text{fill:%23333%3b}%23mermaid-1 .cluster span{color:%23333%3b}%23mermaid-1 .node .collapsed-indicator{fill:%23aaaa33%3bstroke:none%3bopacity:0.6%3b}%23mermaid-1 .node .collapsed-separator{stroke:%23aaaa33%3bstroke-width:0.75px%3b}%23mermaid-1 div.mermaidTooltip{position:absolute%3btext-align:center%3bmax-width:200px%3bpadding:2px%3bfont-family:arial%2csans-serif%3bfont-size:12px%3bbackground:hsl(80%2c 100%%2c 96.2745098039%)%3bborder:1px solid %23aaaa33%3bborder-radius:2px%3bpointer-events:none%3bz-index:100%3b}%23mermaid-1 .flowchartTitleText{text-anchor:middle%3bfont-size:18px%3bfill:%23333%3b}%23mermaid-1 rect.text{fill:none%3bstroke-width:0%3b}%23mermaid-1 .icon-shape%2c%23mermaid-1 .image-shape{background-color:rgba(232%2c232%2c232%2c 0.8)%3btext-align:center%3b}%23mermaid-1 .icon-shape p%2c%23mermaid-1 .image-shape p{background-color:rgba(232%2c232%2c232%2c 0.8)%3bpadding:2px%3b}%23mermaid-1 .icon-shape .label rect%2c%23mermaid-1 .image-shape .label rect{opacity:0.5%3bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bfill:rgba(232%2c232%2c232%2c 0.8)%3b}%23mermaid-1 .label-icon{display:inline-block%3bheight:1em%3boverflow:visible%3bvertical-align:-0.125em%3b}%23mermaid-1 .node .label-icon path{fill:currentColor%3bstroke:revert%3bstroke-width:revert%3b}%23mermaid-1 .node .neo-node{stroke:%239370DB%3b}%23mermaid-1 [data-look='neo'].node rect%2c%23mermaid-1 [data-look='neo'].cluster rect%2c%23mermaid-1 [data-look='neo'].node polygon{stroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b}%23mermaid-1 [data-look='neo'].swimlane.cluster rect{filter:none%3b}%23mermaid-1 [data-look='neo'].node path{stroke:%239370DB%3bstroke-width:1px%3b}%23mermaid-1 [data-look='neo'].node .outer-path{filter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b}%23mermaid-1 [data-look='neo'].node .neo-line path{stroke:%239370DB%3bfilter:none%3b}%23mermaid-1 [data-look='neo'].node circle{stroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b}%23mermaid-1 [data-look='neo'].node circle .state-start{fill:black%3b}%23mermaid-1 [data-look='neo'].icon-shape .icon{fill:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b}%23mermaid-1 [data-look='neo'].icon-shape .icon-neo path{stroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b}%23mermaid-1 :root{--mermaid-font-family:arial%2csans-serif%3b}</style><g><marker id='mermaid-1_flowchart-v2-pointEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'><path d='M 0 0 L 10 5 L 0 10 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-1_flowchart-v2-pointStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='4.5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'><path d='M 0 5 L 10 10 L 10 0 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-1_flowchart-v2-pointEnd-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='11.5' refY='7' markerUnits='userSpaceOnUse' markerWidth='10.5' markerHeight='14' orient='auto'><path d='M 0 0 L 11.5 7 L 0 14 z' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-1_flowchart-v2-pointStart-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='1' refY='7' markerUnits='userSpaceOnUse' markerWidth='11.5' markerHeight='14' orient='auto'><polygon points='0%2c7 11.5%2c14 11.5%2c0' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-1_flowchart-v2-circleEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='11' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-1_flowchart-v2-circleStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-1' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-1_flowchart-v2-circleEnd-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refY='5' refX='12.25' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-1_flowchart-v2-circleStart-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-2' refY='5' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-1_flowchart-v2-crossEnd' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='12' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><path d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-1_flowchart-v2-crossStart' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='-1' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><path d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-1_flowchart-v2-crossEnd-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='17.7' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'><path d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b'/></marker><marker id='mermaid-1_flowchart-v2-crossStart-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='-3.5' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'><path d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b stroke-dasharray: 1%2c 0%3b'/></marker><g class='root'><g class='clusters'/><g class='edgePaths'><path d='M198.586%2c62L198.586%2c66.167C198.586%2c70.333%2c198.586%2c78.667%2c198.586%2c86.333C198.586%2c94%2c198.586%2c101%2c198.586%2c104.5L198.586%2c108' id='mermaid-1-L_A_B_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_A_B_0' data-points='W3sieCI6MTk4LjU4NTkzNzUsInkiOjYyfSx7IngiOjE5OC41ODU5Mzc1LCJ5Ijo4N30seyJ4IjoxOTguNTg1OTM3NSwieSI6MTEyfV0=' data-look='classic' marker-end='url(%23mermaid-1_flowchart-v2-pointEnd)'/><path d='M198.586%2c166L198.586%2c170.167C198.586%2c174.333%2c198.586%2c182.667%2c198.586%2c190.333C198.586%2c198%2c198.586%2c205%2c198.586%2c208.5L198.586%2c212' id='mermaid-1-L_B_C_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_B_C_0' data-points='W3sieCI6MTk4LjU4NTkzNzUsInkiOjE2Nn0seyJ4IjoxOTguNTg1OTM3NSwieSI6MTkxfSx7IngiOjE5OC41ODU5Mzc1LCJ5IjoyMTZ9XQ==' data-look='classic' marker-end='url(%23mermaid-1_flowchart-v2-pointEnd)'/><path d='M159.542%2c270L153.517%2c274.167C147.492%2c278.333%2c135.441%2c286.667%2c129.416%2c294.333C123.391%2c302%2c123.391%2c309%2c123.391%2c312.5L123.391%2c316' id='mermaid-1-L_C_D_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_C_D_0' data-points='W3sieCI6MTU5LjU0MjIxNzU0ODA3NjksInkiOjI3MH0seyJ4IjoxMjMuMzkwNjI1LCJ5IjoyOTV9LHsieCI6MTIzLjM5MDYyNSwieSI6MzIwfV0=' data-look='classic' marker-end='url(%23mermaid-1_flowchart-v2-pointEnd)'/><path d='M123.391%2c374L123.391%2c378.167C123.391%2c382.333%2c123.391%2c390.667%2c123.391%2c398.333C123.391%2c406%2c123.391%2c413%2c123.391%2c416.5L123.391%2c420' id='mermaid-1-L_D_E_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_D_E_0' data-points='W3sieCI6MTIzLjM5MDYyNSwieSI6Mzc0fSx7IngiOjEyMy4zOTA2MjUsInkiOjM5OX0seyJ4IjoxMjMuMzkwNjI1LCJ5Ijo0MjR9XQ==' data-look='classic' marker-end='url(%23mermaid-1_flowchart-v2-pointEnd)'/><path d='M123.391%2c478L123.391%2c484.167C123.391%2c490.333%2c123.391%2c502.667%2c123.391%2c514.333C123.391%2c526%2c123.391%2c537%2c123.391%2c542.5L123.391%2c548' id='mermaid-1-L_E_F_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_E_F_0' data-points='W3sieCI6MTIzLjM5MDYyNSwieSI6NDc4fSx7IngiOjEyMy4zOTA2MjUsInkiOjUxNX0seyJ4IjoxMjMuMzkwNjI1LCJ5Ijo1NTJ9XQ==' data-look='classic' marker-end='url(%23mermaid-1_flowchart-v2-pointEnd)'/><path d='M123.391%2c606L123.391%2c610.167C123.391%2c614.333%2c123.391%2c622.667%2c123.391%2c630.333C123.391%2c638%2c123.391%2c645%2c123.391%2c648.5L123.391%2c652' id='mermaid-1-L_F_G_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_F_G_0' data-points='W3sieCI6MTIzLjM5MDYyNSwieSI6NjA2fSx7IngiOjEyMy4zOTA2MjUsInkiOjYzMX0seyJ4IjoxMjMuMzkwNjI1LCJ5Ijo2NTZ9XQ==' data-look='classic' marker-end='url(%23mermaid-1_flowchart-v2-pointEnd)'/><path d='M123.391%2c710L123.391%2c714.167C123.391%2c718.333%2c123.391%2c726.667%2c130.46%2c739.525C137.53%2c752.384%2c151.668%2c769.768%2c158.738%2c778.46L165.807%2c787.152' id='mermaid-1-L_G_H_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_G_H_0' data-points='W3sieCI6MTIzLjM5MDYyNSwieSI6NzEwfSx7IngiOjEyMy4zOTA2MjUsInkiOjczNX0seyJ4IjoxNjguMzMxMjAzOTA5MTk4OTMsInkiOjc5MC4yNTQ3MzM1OTA4MDF9XQ==' data-look='classic' marker-end='url(%23mermaid-1_flowchart-v2-pointEnd)'/><path d='M228.841%2c790.255L236.331%2c781.046C243.821%2c771.836%2c258.801%2c753.418%2c266.291%2c735.542C273.781%2c717.667%2c273.781%2c700.333%2c273.781%2c683C273.781%2c665.667%2c273.781%2c648.333%2c273.781%2c631C273.781%2c613.667%2c273.781%2c596.333%2c273.781%2c577C273.781%2c557.667%2c273.781%2c536.333%2c273.781%2c515C273.781%2c493.667%2c273.781%2c472.333%2c273.781%2c453C273.781%2c433.667%2c273.781%2c416.333%2c273.781%2c399C273.781%2c381.667%2c273.781%2c364.333%2c273.781%2c347C273.781%2c329.667%2c273.781%2c312.333%2c268.304%2c299.879C262.827%2c287.425%2c251.873%2c279.85%2c246.397%2c276.063L240.92%2c272.275' id='mermaid-1-L_H_C_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_H_C_0' data-points='W3sieCI6MjI4Ljg0MDY3MTA5MDgwMTA3LCJ5Ijo3OTAuMjU0NzMzNTkwODAxfSx7IngiOjI3My43ODEyNSwieSI6NzM1fSx7IngiOjI3My43ODEyNSwieSI6NjgzfSx7IngiOjI3My43ODEyNSwieSI6NjMxfSx7IngiOjI3My43ODEyNSwieSI6NTc5fSx7IngiOjI3My43ODEyNSwieSI6NTE1fSx7IngiOjI3My43ODEyNSwieSI6NDUxfSx7IngiOjI3My43ODEyNSwieSI6Mzk5fSx7IngiOjI3My43ODEyNSwieSI6MzQ3fSx7IngiOjI3My43ODEyNSwieSI6Mjk1fSx7IngiOjIzNy42Mjk2NTc0NTE5MjMxLCJ5IjoyNzB9XQ==' data-look='classic' marker-end='url(%23mermaid-1_flowchart-v2-pointEnd)'/><path d='M198.586%2c894.906L198.586%2c901.073C198.586%2c907.24%2c198.586%2c919.573%2c198.586%2c931.24C198.586%2c942.906%2c198.586%2c953.906%2c198.586%2c959.406L198.586%2c964.906' id='mermaid-1-L_H_I_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_H_I_0' data-points='W3sieCI6MTk4LjU4NTkzNzUsInkiOjg5NC45MDYyNX0seyJ4IjoxOTguNTg1OTM3NSwieSI6OTMxLjkwNjI1fSx7IngiOjE5OC41ODU5Mzc1LCJ5Ijo5NjguOTA2MjV9XQ==' data-look='classic' marker-end='url(%23mermaid-1_flowchart-v2-pointEnd)'/></g><g class='edgeLabels'><g class='edgeLabel'><g class='label' data-id='L_A_B_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_B_C_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_C_D_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_D_E_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_E_F_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_F_G_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_G_H_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel' transform='translate(273.78125%2c 515)'><g class='label' data-id='L_H_C_0' transform='translate(-6%2c -12)'><foreignObject width='12' height='24'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'><p>是</p></span></div></foreignObject></g></g><g class='edgeLabel' transform='translate(198.5859375%2c 931.90625)'><g class='label' data-id='L_H_I_0' transform='translate(-6%2c -12)'><foreignObject width='12' height='24'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'><p>否</p></span></div></foreignObject></g></g></g><g class='nodes'><g class='node default' id='mermaid-1-flowchart-A-0' data-look='classic' transform='translate(198.5859375%2c 35)'><rect class='basic label-container' style='' x='-96' y='-27' width='192' height='54'/><g class='label' style='' transform='translate(-66%2c -12)'><rect/><foreignObject width='132' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>提交用户输入和工具定义</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-1-flowchart-B-1' data-look='classic' transform='translate(198.5859375%2c 139)'><rect class='basic label-container' style='' x='-102.9140625' y='-27' width='205.828125' height='54'/><g class='label' style='' transform='translate(-72.9140625%2c -12)'><rect/><foreignObject width='145.828125' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>模型返回 Function Call</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-1-flowchart-C-3' data-look='classic' transform='translate(198.5859375%2c 243)'><rect class='basic label-container' style='' x='-66' y='-27' width='132' height='54'/><g class='label' style='' transform='translate(-36%2c -12)'><rect/><foreignObject width='72' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>应用解析参数</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-1-flowchart-D-5' data-look='classic' transform='translate(123.390625%2c 347)'><rect class='basic label-container' style='' x='-72' y='-27' width='144' height='54'/><g class='label' style='' transform='translate(-42%2c -12)'><rect/><foreignObject width='84' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>参数与权限校验</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-1-flowchart-E-7' data-look='classic' transform='translate(123.390625%2c 451)'><rect class='basic label-container' style='' x='-78' y='-27' width='156' height='54'/><g class='label' style='' transform='translate(-48%2c -12)'><rect/><foreignObject width='96' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>执行真实业务函数</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-1-flowchart-F-9' data-look='classic' transform='translate(123.390625%2c 579)'><rect class='basic label-container' style='' x='-115.390625' y='-27' width='230.78125' height='54'/><g class='label' style='' transform='translate(-85.390625%2c -12)'><rect/><foreignObject width='170.78125' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>构造 function_call_output</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-1-flowchart-G-11' data-look='classic' transform='translate(123.390625%2c 683)'><rect class='basic label-container' style='' x='-66' y='-27' width='132' height='54'/><g class='label' style='' transform='translate(-36%2c -12)'><rect/><foreignObject width='72' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>再次请求模型</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-1-flowchart-H-13' data-look='classic' transform='translate(198.5859375%2c 827.453125)'><polygon points='67.453125%2c0 134.90625%2c-67.453125 67.453125%2c-134.90625 0%2c-67.453125' class='label-container' transform='translate(-66.953125%2c 67.453125)'/><g class='label' style='' transform='translate(-40.453125%2c -12)'><rect/><foreignObject width='80.90625' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>仍有工具调用%3f</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-1-flowchart-I-17' data-look='classic' transform='translate(198.5859375%2c 995.90625)'><rect class='basic label-container' style='' x='-66' y='-27' width='132' height='54'/><g class='label' style='' transform='translate(-36%2c -12)'><rect/><foreignObject width='72' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>返回最终回答</p></span></div></foreignObject></g></g></g></g></g><defs><filter id='mermaid-1-drop-shadow' height='130%' width='130%'><feDropShadow dx='4' dy='4' stdDeviation='0' flood-opacity='0.06' flood-color='black'/></filter></defs><defs><filter id='mermaid-1-drop-shadow-small' height='150%' width='150%'><feDropShadow dx='2' dy='2' stdDeviation='0' flood-opacity='0.06' flood-color='black'/></filter></defs></svg>)
%3btext-align:center%3b}%23mermaid-dark-1 .edgeLabel p{background-color:hsl(0%2c 0%%2c 34.4117647059%)%3b}%23mermaid-dark-1 .edgeLabel rect{opacity:0.5%3bbackground-color:hsl(0%2c 0%%2c 34.4117647059%)%3bfill:hsl(0%2c 0%%2c 34.4117647059%)%3b}%23mermaid-dark-1 .labelBkg{background-color:rgba(87.75%2c 87.75%2c 87.75%2c 0.5)%3b}%23mermaid-dark-1 .cluster rect{fill:hsl(180%2c 1.5873015873%%2c 28.3529411765%)%3bstroke:rgba(255%2c 255%2c 255%2c 0.25)%3bstroke-width:1px%3b}%23mermaid-dark-1 .cluster text{fill:%23F9FFFE%3b}%23mermaid-dark-1 .cluster span{color:%23F9FFFE%3b}%23mermaid-dark-1 .node .collapsed-indicator{fill:rgba(255%2c 255%2c 255%2c 0.25)%3bstroke:none%3bopacity:0.6%3b}%23mermaid-dark-1 .node .collapsed-separator{stroke:rgba(255%2c 255%2c 255%2c 0.25)%3bstroke-width:0.75px%3b}%23mermaid-dark-1 div.mermaidTooltip{position:absolute%3btext-align:center%3bmax-width:200px%3bpadding:2px%3bfont-family:arial%2csans-serif%3bfont-size:12px%3bbackground:hsl(20%2c 1.5873015873%%2c 12.3529411765%)%3bborder:1px solid rgba(255%2c 255%2c 255%2c 0.25)%3bborder-radius:2px%3bpointer-events:none%3bz-index:100%3b}%23mermaid-dark-1 .flowchartTitleText{text-anchor:middle%3bfont-size:18px%3bfill:%23ccc%3b}%23mermaid-dark-1 rect.text{fill:none%3bstroke-width:0%3b}%23mermaid-dark-1 .icon-shape%2c%23mermaid-dark-1 .image-shape{background-color:hsl(0%2c 0%%2c 34.4117647059%)%3btext-align:center%3b}%23mermaid-dark-1 .icon-shape p%2c%23mermaid-dark-1 .image-shape p{background-color:hsl(0%2c 0%%2c 34.4117647059%)%3bpadding:2px%3b}%23mermaid-dark-1 .icon-shape .label rect%2c%23mermaid-dark-1 .image-shape .label rect{opacity:0.5%3bbackground-color:hsl(0%2c 0%%2c 34.4117647059%)%3bfill:hsl(0%2c 0%%2c 34.4117647059%)%3b}%23mermaid-dark-1 .label-icon{display:inline-block%3bheight:1em%3boverflow:visible%3bvertical-align:-0.125em%3b}%23mermaid-dark-1 .node .label-icon path{fill:currentColor%3bstroke:revert%3bstroke-width:revert%3b}%23mermaid-dark-1 .node .neo-node{stroke:%23ccc%3b}%23mermaid-dark-1 [data-look='neo'].node rect%2c%23mermaid-dark-1 [data-look='neo'].cluster rect%2c%23mermaid-dark-1 [data-look='neo'].node polygon{stroke:url(%23mermaid-dark-1-gradient)%3bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b}%23mermaid-dark-1 [data-look='neo'].swimlane.cluster rect{filter:none%3b}%23mermaid-dark-1 [data-look='neo'].node path{stroke:url(%23mermaid-dark-1-gradient)%3bstroke-width:1px%3b}%23mermaid-dark-1 [data-look='neo'].node .outer-path{filter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b}%23mermaid-dark-1 [data-look='neo'].node .neo-line path{stroke:%23ccc%3bfilter:none%3b}%23mermaid-dark-1 [data-look='neo'].node circle{stroke:url(%23mermaid-dark-1-gradient)%3bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b}%23mermaid-dark-1 [data-look='neo'].node circle .state-start{fill:black%3b}%23mermaid-dark-1 [data-look='neo'].icon-shape .icon{fill:url(%23mermaid-dark-1-gradient)%3bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b}%23mermaid-dark-1 [data-look='neo'].icon-shape .icon-neo path{stroke:url(%23mermaid-dark-1-gradient)%3bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b}%23mermaid-dark-1 :root{--mermaid-font-family:arial%2csans-serif%3b}</style><g><marker id='mermaid-dark-1_flowchart-v2-pointEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'><path d='M 0 0 L 10 5 L 0 10 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-1_flowchart-v2-pointStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='4.5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'><path d='M 0 5 L 10 10 L 10 0 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-1_flowchart-v2-pointEnd-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='11.5' refY='7' markerUnits='userSpaceOnUse' markerWidth='10.5' markerHeight='14' orient='auto'><path d='M 0 0 L 11.5 7 L 0 14 z' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-1_flowchart-v2-pointStart-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='1' refY='7' markerUnits='userSpaceOnUse' markerWidth='11.5' markerHeight='14' orient='auto'><polygon points='0%2c7 11.5%2c14 11.5%2c0' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-1_flowchart-v2-circleEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='11' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-1_flowchart-v2-circleStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-1' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-1_flowchart-v2-circleEnd-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refY='5' refX='12.25' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-1_flowchart-v2-circleStart-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-2' refY='5' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-1_flowchart-v2-crossEnd' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='12' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><path d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-1_flowchart-v2-crossStart' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='-1' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><path d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-1_flowchart-v2-crossEnd-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='17.7' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'><path d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b'/></marker><marker id='mermaid-dark-1_flowchart-v2-crossStart-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='-3.5' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'><path d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b stroke-dasharray: 1%2c 0%3b'/></marker><g class='root'><g class='clusters'/><g class='edgePaths'><path d='M198.586%2c62L198.586%2c66.167C198.586%2c70.333%2c198.586%2c78.667%2c198.586%2c86.333C198.586%2c94%2c198.586%2c101%2c198.586%2c104.5L198.586%2c108' id='mermaid-dark-1-L_A_B_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_A_B_0' data-points='W3sieCI6MTk4LjU4NTkzNzUsInkiOjYyfSx7IngiOjE5OC41ODU5Mzc1LCJ5Ijo4N30seyJ4IjoxOTguNTg1OTM3NSwieSI6MTEyfV0=' data-look='classic' marker-end='url(%23mermaid-dark-1_flowchart-v2-pointEnd)'/><path d='M198.586%2c166L198.586%2c170.167C198.586%2c174.333%2c198.586%2c182.667%2c198.586%2c190.333C198.586%2c198%2c198.586%2c205%2c198.586%2c208.5L198.586%2c212' id='mermaid-dark-1-L_B_C_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_B_C_0' data-points='W3sieCI6MTk4LjU4NTkzNzUsInkiOjE2Nn0seyJ4IjoxOTguNTg1OTM3NSwieSI6MTkxfSx7IngiOjE5OC41ODU5Mzc1LCJ5IjoyMTZ9XQ==' data-look='classic' marker-end='url(%23mermaid-dark-1_flowchart-v2-pointEnd)'/><path d='M159.542%2c270L153.517%2c274.167C147.492%2c278.333%2c135.441%2c286.667%2c129.416%2c294.333C123.391%2c302%2c123.391%2c309%2c123.391%2c312.5L123.391%2c316' id='mermaid-dark-1-L_C_D_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_C_D_0' data-points='W3sieCI6MTU5LjU0MjIxNzU0ODA3NjksInkiOjI3MH0seyJ4IjoxMjMuMzkwNjI1LCJ5IjoyOTV9LHsieCI6MTIzLjM5MDYyNSwieSI6MzIwfV0=' data-look='classic' marker-end='url(%23mermaid-dark-1_flowchart-v2-pointEnd)'/><path d='M123.391%2c374L123.391%2c378.167C123.391%2c382.333%2c123.391%2c390.667%2c123.391%2c398.333C123.391%2c406%2c123.391%2c413%2c123.391%2c416.5L123.391%2c420' id='mermaid-dark-1-L_D_E_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_D_E_0' data-points='W3sieCI6MTIzLjM5MDYyNSwieSI6Mzc0fSx7IngiOjEyMy4zOTA2MjUsInkiOjM5OX0seyJ4IjoxMjMuMzkwNjI1LCJ5Ijo0MjR9XQ==' data-look='classic' marker-end='url(%23mermaid-dark-1_flowchart-v2-pointEnd)'/><path d='M123.391%2c478L123.391%2c484.167C123.391%2c490.333%2c123.391%2c502.667%2c123.391%2c514.333C123.391%2c526%2c123.391%2c537%2c123.391%2c542.5L123.391%2c548' id='mermaid-dark-1-L_E_F_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_E_F_0' data-points='W3sieCI6MTIzLjM5MDYyNSwieSI6NDc4fSx7IngiOjEyMy4zOTA2MjUsInkiOjUxNX0seyJ4IjoxMjMuMzkwNjI1LCJ5Ijo1NTJ9XQ==' data-look='classic' marker-end='url(%23mermaid-dark-1_flowchart-v2-pointEnd)'/><path d='M123.391%2c606L123.391%2c610.167C123.391%2c614.333%2c123.391%2c622.667%2c123.391%2c630.333C123.391%2c638%2c123.391%2c645%2c123.391%2c648.5L123.391%2c652' id='mermaid-dark-1-L_F_G_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_F_G_0' data-points='W3sieCI6MTIzLjM5MDYyNSwieSI6NjA2fSx7IngiOjEyMy4zOTA2MjUsInkiOjYzMX0seyJ4IjoxMjMuMzkwNjI1LCJ5Ijo2NTZ9XQ==' data-look='classic' marker-end='url(%23mermaid-dark-1_flowchart-v2-pointEnd)'/><path d='M123.391%2c710L123.391%2c714.167C123.391%2c718.333%2c123.391%2c726.667%2c130.46%2c739.525C137.53%2c752.384%2c151.668%2c769.768%2c158.738%2c778.46L165.807%2c787.152' id='mermaid-dark-1-L_G_H_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_G_H_0' data-points='W3sieCI6MTIzLjM5MDYyNSwieSI6NzEwfSx7IngiOjEyMy4zOTA2MjUsInkiOjczNX0seyJ4IjoxNjguMzMxMjAzOTA5MTk4OTMsInkiOjc5MC4yNTQ3MzM1OTA4MDF9XQ==' data-look='classic' marker-end='url(%23mermaid-dark-1_flowchart-v2-pointEnd)'/><path d='M228.841%2c790.255L236.331%2c781.046C243.821%2c771.836%2c258.801%2c753.418%2c266.291%2c735.542C273.781%2c717.667%2c273.781%2c700.333%2c273.781%2c683C273.781%2c665.667%2c273.781%2c648.333%2c273.781%2c631C273.781%2c613.667%2c273.781%2c596.333%2c273.781%2c577C273.781%2c557.667%2c273.781%2c536.333%2c273.781%2c515C273.781%2c493.667%2c273.781%2c472.333%2c273.781%2c453C273.781%2c433.667%2c273.781%2c416.333%2c273.781%2c399C273.781%2c381.667%2c273.781%2c364.333%2c273.781%2c347C273.781%2c329.667%2c273.781%2c312.333%2c268.304%2c299.879C262.827%2c287.425%2c251.873%2c279.85%2c246.397%2c276.063L240.92%2c272.275' id='mermaid-dark-1-L_H_C_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_H_C_0' data-points='W3sieCI6MjI4Ljg0MDY3MTA5MDgwMTA3LCJ5Ijo3OTAuMjU0NzMzNTkwODAxfSx7IngiOjI3My43ODEyNSwieSI6NzM1fSx7IngiOjI3My43ODEyNSwieSI6NjgzfSx7IngiOjI3My43ODEyNSwieSI6NjMxfSx7IngiOjI3My43ODEyNSwieSI6NTc5fSx7IngiOjI3My43ODEyNSwieSI6NTE1fSx7IngiOjI3My43ODEyNSwieSI6NDUxfSx7IngiOjI3My43ODEyNSwieSI6Mzk5fSx7IngiOjI3My43ODEyNSwieSI6MzQ3fSx7IngiOjI3My43ODEyNSwieSI6Mjk1fSx7IngiOjIzNy42Mjk2NTc0NTE5MjMxLCJ5IjoyNzB9XQ==' data-look='classic' marker-end='url(%23mermaid-dark-1_flowchart-v2-pointEnd)'/><path d='M198.586%2c894.906L198.586%2c901.073C198.586%2c907.24%2c198.586%2c919.573%2c198.586%2c931.24C198.586%2c942.906%2c198.586%2c953.906%2c198.586%2c959.406L198.586%2c964.906' id='mermaid-dark-1-L_H_I_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_H_I_0' data-points='W3sieCI6MTk4LjU4NTkzNzUsInkiOjg5NC45MDYyNX0seyJ4IjoxOTguNTg1OTM3NSwieSI6OTMxLjkwNjI1fSx7IngiOjE5OC41ODU5Mzc1LCJ5Ijo5NjguOTA2MjV9XQ==' data-look='classic' marker-end='url(%23mermaid-dark-1_flowchart-v2-pointEnd)'/></g><g class='edgeLabels'><g class='edgeLabel'><g class='label' data-id='L_A_B_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_B_C_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_C_D_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_D_E_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_E_F_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_F_G_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_G_H_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel' transform='translate(273.78125%2c 515)'><g class='label' data-id='L_H_C_0' transform='translate(-6%2c -12)'><foreignObject width='12' height='24'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'><p>是</p></span></div></foreignObject></g></g><g class='edgeLabel' transform='translate(198.5859375%2c 931.90625)'><g class='label' data-id='L_H_I_0' transform='translate(-6%2c -12)'><foreignObject width='12' height='24'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'><p>否</p></span></div></foreignObject></g></g></g><g class='nodes'><g class='node default' id='mermaid-dark-1-flowchart-A-0' data-look='classic' transform='translate(198.5859375%2c 35)'><rect class='basic label-container' style='' x='-96' y='-27' width='192' height='54'/><g class='label' style='' transform='translate(-66%2c -12)'><rect/><foreignObject width='132' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>提交用户输入和工具定义</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-dark-1-flowchart-B-1' data-look='classic' transform='translate(198.5859375%2c 139)'><rect class='basic label-container' style='' x='-102.9140625' y='-27' width='205.828125' height='54'/><g class='label' style='' transform='translate(-72.9140625%2c -12)'><rect/><foreignObject width='145.828125' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>模型返回 Function Call</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-dark-1-flowchart-C-3' data-look='classic' transform='translate(198.5859375%2c 243)'><rect class='basic label-container' style='' x='-66' y='-27' width='132' height='54'/><g class='label' style='' transform='translate(-36%2c -12)'><rect/><foreignObject width='72' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>应用解析参数</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-dark-1-flowchart-D-5' data-look='classic' transform='translate(123.390625%2c 347)'><rect class='basic label-container' style='' x='-72' y='-27' width='144' height='54'/><g class='label' style='' transform='translate(-42%2c -12)'><rect/><foreignObject width='84' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>参数与权限校验</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-dark-1-flowchart-E-7' data-look='classic' transform='translate(123.390625%2c 451)'><rect class='basic label-container' style='' x='-78' y='-27' width='156' height='54'/><g class='label' style='' transform='translate(-48%2c -12)'><rect/><foreignObject width='96' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>执行真实业务函数</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-dark-1-flowchart-F-9' data-look='classic' transform='translate(123.390625%2c 579)'><rect class='basic label-container' style='' x='-115.390625' y='-27' width='230.78125' height='54'/><g class='label' style='' transform='translate(-85.390625%2c -12)'><rect/><foreignObject width='170.78125' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>构造 function_call_output</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-dark-1-flowchart-G-11' data-look='classic' transform='translate(123.390625%2c 683)'><rect class='basic label-container' style='' x='-66' y='-27' width='132' height='54'/><g class='label' style='' transform='translate(-36%2c -12)'><rect/><foreignObject width='72' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>再次请求模型</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-dark-1-flowchart-H-13' data-look='classic' transform='translate(198.5859375%2c 827.453125)'><polygon points='67.453125%2c0 134.90625%2c-67.453125 67.453125%2c-134.90625 0%2c-67.453125' class='label-container' transform='translate(-66.953125%2c 67.453125)'/><g class='label' style='' transform='translate(-40.453125%2c -12)'><rect/><foreignObject width='80.90625' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>仍有工具调用%3f</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-dark-1-flowchart-I-17' data-look='classic' transform='translate(198.5859375%2c 995.90625)'><rect class='basic label-container' style='' x='-66' y='-27' width='132' height='54'/><g class='label' style='' transform='translate(-36%2c -12)'><rect/><foreignObject width='72' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>返回最终回答</p></span></div></foreignObject></g></g></g></g></g><defs><filter id='mermaid-dark-1-drop-shadow' height='130%' width='130%'><feDropShadow dx='4' dy='4' stdDeviation='0' flood-opacity='0.06' flood-color='white'/></filter></defs><defs><filter id='mermaid-dark-1-drop-shadow-small' height='150%' width='150%'><feDropShadow dx='2' dy='2' stdDeviation='0' flood-opacity='0.06' flood-color='white'/></filter></defs><linearGradient id='mermaid-dark-1-gradient' gradientUnits='objectBoundingBox' x1='0%' y1='0%' x2='100%' y2='0%'><stop offset='0%' stop-color='%23cccccc' stop-opacity='1'/><stop offset='100%' stop-color='hsl(180%2c 0%%2c 18.3529411765%)' stop-opacity='1'/></linearGradient></svg>)
多工具与执行循环
实际系统通常会向模型提供多个工具,例如:
get_order
query_logistics
get_refund_status
cancel_order
模型根据用户语义选择合适的工具,因此 Function Calling 也可以理解为在一组程序能力之间进行语义路由。
控制工具选择
tool_choice 可以控制模型是否使用工具:
response = client.responses.create(
    model="gpt-5.5",
    input=user_input,
    tools=tools,
    tool_choice="auto",
)
常见策略包括:
| 策略 | 含义 |
|---|---|
auto | 模型自行决定不调用、调用一个或多个工具 |
required | 本轮必须调用工具 |
none | 禁止调用工具 |
| 指定 Function | 强制使用特定工具 |
如果必须调用指定工具,可以传入:
tool_choice={
    "type": "function",
    "name": "get_order",
}
tool_choice 控制模型如何选择工具,但不代表业务授权。即使模型被要求调用某个工具,应用仍然必须进行权限和状态检查。
处理并行工具调用
用户可能一次查询多个订单,模型也可能在同一轮生成多个 Function Call。不要假设 response.output[0] 是唯一调用,应遍历全部输出项:
tool_calls = [
    item
    for item in response.output
    if item.type == "function_call"
]
执行完成后,可以收集所有 function_call_output,一次性返回模型。业务希望每轮最多使用一个工具时,可以根据所选模型和 API 能力配置 parallel_tool_calls=False。
建立 Tool Registry
工具较多时,不应不断增加 if/elif:
TOOL_REGISTRY = {
    "get_order": get_order,
    "query_logistics": query_logistics,
}


def call_tool(name: str, arguments: dict) -> dict:
    function = TOOL_REGISTRY.get(name)

    if function is None:
        raise ValueError(f"未知工具:{name}")

    return function(**arguments)
Tool Registry 负责工具名到函数的映射,Tool Executor 负责参数解析、校验、执行、错误转换和日志记录。
import json
from collections.abc import Callable


class ToolExecutor:
    def __init__(self) -> None:
        self.tools: dict[str, Callable] = {}

    def register(self, name: str, function: Callable) -> None:
        self.tools[name] = function

    def execute(self, name: str, arguments_json: str) -> str:
        function = self.tools.get(name)

        if function is None:
            raise ValueError(f"未知工具:{name}")

        arguments = json.loads(arguments_json)
        result = function(**arguments)

        return json.dumps(result, ensure_ascii=False)
使用通用执行循环
复杂任务可能需要多轮工具调用。例如,用户要求“订单发货后再查询物流”,模型可能先调用 get_order,再根据结果调用 query_logistics。
因此执行器应使用循环,并设置明确的最大轮数:
import json

from openai import OpenAI


class AIToolService:
    def __init__(
        self,
        model: str,
        tools: list[dict],
        functions: dict,
        max_rounds: int = 8,
    ) -> None:
        self.client = OpenAI()
        self.model = model
        self.tools = tools
        self.functions = functions
        self.max_rounds = max_rounds

    def execute(self, user_input: str) -> str:
        response = self.client.responses.create(
            model=self.model,
            input=user_input,
            tools=self.tools,
        )

        for _ in range(self.max_rounds):
            tool_calls = [
                item
                for item in response.output
                if item.type == "function_call"
            ]

            if not tool_calls:
                return response.output_text

            outputs = []

            for call in tool_calls:
                function = self.functions.get(call.name)
                if function is None:
                    raise ValueError(f"未知工具:{call.name}")

                arguments = json.loads(call.arguments)
                result = function(**arguments)

                outputs.append(
                    {
                        "type": "function_call_output",
                        "call_id": call.call_id,
                        "output": json.dumps(
                            result,
                            ensure_ascii=False,
                        ),
                    }
                )

            response = self.client.responses.create(
                model=self.model,
                previous_response_id=response.id,
                input=outputs,
                tools=self.tools,
            )

        raise RuntimeError("工具调用超过最大轮数")
最大轮数、超时和费用上限是必要的终止条件,不能让模型无限调用工具。
权限与安全边界
Function Calling 最重要的工程原则是:
模型决定“希望调用什么”,系统决定“是否允许调用”。
模型生成下面的调用,并不意味着程序可以直接执行:
{
  "name": "cancel_order",
  "arguments": {
    "order_id": "20260919001"
  }
}
业务层仍然需要检查用户身份、资源归属、订单状态、操作权限和二次确认:
if tool_call.name == "cancel_order":
    check_authenticated(current_user)
    check_order_owner(current_user, arguments["order_id"])
    check_order_can_be_cancelled(arguments["order_id"])
    require_user_confirmation()

    result = cancel_order(arguments["order_id"])
区分读取与写入工具
工具可以按照风险分为两类:
| 类型 | 示例 | 主要风险 |
|---|---|---|
| Read Tool | 查询订单、搜索文档、获取天气 | 数据越权、隐私泄露 |
| Write Tool | 取消订单、退款、发邮件、部署 | 状态变更、重复执行、不可逆影响 |
写操作通常还需要鉴权、审批、人工确认、幂等、事务、审计和限流。
%3btext-align:center%3b}%23mermaid-2 .edgeLabel p{background-color:rgba(232%2c232%2c232%2c 0.8)%3b}%23mermaid-2 .edgeLabel rect{opacity:0.5%3bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bfill:rgba(232%2c232%2c232%2c 0.8)%3b}%23mermaid-2 .labelBkg{background-color:rgba(232%2c 232%2c 232%2c 0.5)%3b}%23mermaid-2 .cluster rect{fill:%23ffffde%3bstroke:%23aaaa33%3bstroke-width:1px%3b}%23mermaid-2 .cluster text{fill:%23333%3b}%23mermaid-2 .cluster span{color:%23333%3b}%23mermaid-2 .node .collapsed-indicator{fill:%23aaaa33%3bstroke:none%3bopacity:0.6%3b}%23mermaid-2 .node .collapsed-separator{stroke:%23aaaa33%3bstroke-width:0.75px%3b}%23mermaid-2 div.mermaidTooltip{position:absolute%3btext-align:center%3bmax-width:200px%3bpadding:2px%3bfont-family:arial%2csans-serif%3bfont-size:12px%3bbackground:hsl(80%2c 100%%2c 96.2745098039%)%3bborder:1px solid %23aaaa33%3bborder-radius:2px%3bpointer-events:none%3bz-index:100%3b}%23mermaid-2 .flowchartTitleText{text-anchor:middle%3bfont-size:18px%3bfill:%23333%3b}%23mermaid-2 rect.text{fill:none%3bstroke-width:0%3b}%23mermaid-2 .icon-shape%2c%23mermaid-2 .image-shape{background-color:rgba(232%2c232%2c232%2c 0.8)%3btext-align:center%3b}%23mermaid-2 .icon-shape p%2c%23mermaid-2 .image-shape p{background-color:rgba(232%2c232%2c232%2c 0.8)%3bpadding:2px%3b}%23mermaid-2 .icon-shape .label rect%2c%23mermaid-2 .image-shape .label rect{opacity:0.5%3bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bfill:rgba(232%2c232%2c232%2c 0.8)%3b}%23mermaid-2 .label-icon{display:inline-block%3bheight:1em%3boverflow:visible%3bvertical-align:-0.125em%3b}%23mermaid-2 .node .label-icon path{fill:currentColor%3bstroke:revert%3bstroke-width:revert%3b}%23mermaid-2 .node .neo-node{stroke:%239370DB%3b}%23mermaid-2 [data-look='neo'].node rect%2c%23mermaid-2 [data-look='neo'].cluster rect%2c%23mermaid-2 [data-look='neo'].node polygon{stroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b}%23mermaid-2 [data-look='neo'].swimlane.cluster rect{filter:none%3b}%23mermaid-2 [data-look='neo'].node path{stroke:%239370DB%3bstroke-width:1px%3b}%23mermaid-2 [data-look='neo'].node .outer-path{filter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b}%23mermaid-2 [data-look='neo'].node .neo-line path{stroke:%239370DB%3bfilter:none%3b}%23mermaid-2 [data-look='neo'].node circle{stroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b}%23mermaid-2 [data-look='neo'].node circle .state-start{fill:black%3b}%23mermaid-2 [data-look='neo'].icon-shape .icon{fill:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b}%23mermaid-2 [data-look='neo'].icon-shape .icon-neo path{stroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b}%23mermaid-2 :root{--mermaid-font-family:arial%2csans-serif%3b}</style><g><marker id='mermaid-2_flowchart-v2-pointEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'><path d='M 0 0 L 10 5 L 0 10 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-2_flowchart-v2-pointStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='4.5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'><path d='M 0 5 L 10 10 L 10 0 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-2_flowchart-v2-pointEnd-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='11.5' refY='7' markerUnits='userSpaceOnUse' markerWidth='10.5' markerHeight='14' orient='auto'><path d='M 0 0 L 11.5 7 L 0 14 z' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-2_flowchart-v2-pointStart-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='1' refY='7' markerUnits='userSpaceOnUse' markerWidth='11.5' markerHeight='14' orient='auto'><polygon points='0%2c7 11.5%2c14 11.5%2c0' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-2_flowchart-v2-circleEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='11' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-2_flowchart-v2-circleStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-1' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-2_flowchart-v2-circleEnd-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refY='5' refX='12.25' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-2_flowchart-v2-circleStart-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-2' refY='5' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-2_flowchart-v2-crossEnd' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='12' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><path d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-2_flowchart-v2-crossStart' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='-1' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><path d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-2_flowchart-v2-crossEnd-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='17.7' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'><path d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b'/></marker><marker id='mermaid-2_flowchart-v2-crossStart-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='-3.5' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'><path d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b stroke-dasharray: 1%2c 0%3b'/></marker><g class='root'><g class='clusters'/><g class='edgePaths'><path d='M181.813%2c87L185.979%2c87C190.146%2c87%2c198.479%2c87%2c206.146%2c87C213.813%2c87%2c220.813%2c87%2c224.313%2c87L227.813%2c87' id='mermaid-2-L_A_B_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_A_B_0' data-points='W3sieCI6MTgxLjgxMjUsInkiOjg3fSx7IngiOjIwNi44MTI1LCJ5Ijo4N30seyJ4IjoyMzEuODEyNSwieSI6ODd9XQ==' data-look='classic' marker-end='url(%23mermaid-2_flowchart-v2-pointEnd)'/><path d='M407.406%2c87L411.573%2c87C415.74%2c87%2c424.073%2c87%2c431.74%2c87C439.406%2c87%2c446.406%2c87%2c449.906%2c87L453.406%2c87' id='mermaid-2-L_B_C_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_B_C_0' data-points='W3sieCI6NDA3LjQwNjI1LCJ5Ijo4N30seyJ4Ijo0MzIuNDA2MjUsInkiOjg3fSx7IngiOjQ1Ny40MDYyNSwieSI6ODd9XQ==' data-look='classic' marker-end='url(%23mermaid-2_flowchart-v2-pointEnd)'/><path d='M589.406%2c87L593.573%2c87C597.74%2c87%2c606.073%2c87%2c613.74%2c87C621.406%2c87%2c628.406%2c87%2c631.906%2c87L635.406%2c87' id='mermaid-2-L_C_D_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_C_D_0' data-points='W3sieCI6NTg5LjQwNjI1LCJ5Ijo4N30seyJ4Ijo2MTQuNDA2MjUsInkiOjg3fSx7IngiOjYzOS40MDYyNSwieSI6ODd9XQ==' data-look='classic' marker-end='url(%23mermaid-2_flowchart-v2-pointEnd)'/><path d='M783.406%2c87L787.573%2c87C791.74%2c87%2c800.073%2c87%2c807.74%2c87C815.406%2c87%2c822.406%2c87%2c825.906%2c87L829.406%2c87' id='mermaid-2-L_D_E_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_D_E_0' data-points='W3sieCI6NzgzLjQwNjI1LCJ5Ijo4N30seyJ4Ijo4MDguNDA2MjUsInkiOjg3fSx7IngiOjgzMy40MDYyNSwieSI6ODd9XQ==' data-look='classic' marker-end='url(%23mermaid-2_flowchart-v2-pointEnd)'/><path d='M912.898%2c67.585L921.3%2c62.154C929.703%2c56.723%2c946.508%2c45.862%2c975.299%2c40.431C1004.091%2c35%2c1044.87%2c35%2c1084.648%2c35C1124.427%2c35%2c1163.206%2c35%2c1186.095%2c35C1208.984%2c35%2c1215.984%2c35%2c1219.484%2c35L1222.984%2c35' id='mermaid-2-L_E_F_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_E_F_0' data-points='W3sieCI6OTEyLjg5NzYxMjY1Nzc3OTksInkiOjY3LjU4NTExMjY1Nzc3OTg3fSx7IngiOjk2My4zMTI1LCJ5IjozNX0seyJ4IjoxMDg1LjY0ODQzNzUsInkiOjM1fSx7IngiOjEyMDEuOTg0Mzc1LCJ5IjozNX0seyJ4IjoxMjI2Ljk4NDM3NSwieSI6MzV9XQ==' data-look='classic' marker-end='url(%23mermaid-2_flowchart-v2-pointEnd)'/><path d='M912.898%2c106.415L921.3%2c111.846C929.703%2c117.277%2c946.508%2c128.138%2c959.41%2c133.569C972.313%2c139%2c981.313%2c139%2c985.813%2c139L990.313%2c139' id='mermaid-2-L_E_G_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_E_G_0' data-points='W3sieCI6OTEyLjg5NzYxMjY1Nzc3OTksInkiOjEwNi40MTQ4ODczNDIyMjAxM30seyJ4Ijo5NjMuMzEyNSwieSI6MTM5fSx7IngiOjk5NC4zMTI1LCJ5IjoxMzl9XQ==' data-look='classic' marker-end='url(%23mermaid-2_flowchart-v2-pointEnd)'/><path d='M1176.984%2c139L1181.151%2c139C1185.318%2c139%2c1193.651%2c139%2c1201.418%2c139C1209.185%2c139%2c1216.385%2c139%2c1219.986%2c139L1223.586%2c139' id='mermaid-2-L_G_H_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_G_H_0' data-points='W3sieCI6MTE3Ni45ODQzNzUsInkiOjEzOX0seyJ4IjoxMjAxLjk4NDM3NSwieSI6MTM5fSx7IngiOjEyMjcuNTg1OTM3NSwieSI6MTM5fV0=' data-look='classic' marker-end='url(%23mermaid-2_flowchart-v2-pointEnd)'/><path d='M1387.188%2c35L1391.354%2c35C1395.521%2c35%2c1403.854%2c35%2c1413.794%2c38.8C1423.734%2c42.6%2c1435.281%2c50.201%2c1441.054%2c54.001L1446.827%2c57.801' id='mermaid-2-L_F_I_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_F_I_0' data-points='W3sieCI6MTM4Ny4xODc1LCJ5IjozNX0seyJ4IjoxNDEyLjE4NzUsInkiOjM1fSx7IngiOjE0NTAuMTY4MjY5MjMwNzY5MywieSI6NjB9XQ==' data-look='classic' marker-end='url(%23mermaid-2_flowchart-v2-pointEnd)'/><path d='M1386.586%2c139L1390.853%2c139C1395.12%2c139%2c1403.654%2c139%2c1413.694%2c135.2C1423.734%2c131.4%2c1435.281%2c123.799%2c1441.054%2c119.999L1446.827%2c116.199' id='mermaid-2-L_H_I_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_H_I_0' data-points='W3sieCI6MTM4Ni41ODU5Mzc1LCJ5IjoxMzl9LHsieCI6MTQxMi4xODc1LCJ5IjoxMzl9LHsieCI6MTQ1MC4xNjgyNjkyMzA3NjkzLCJ5IjoxMTR9XQ==' data-look='classic' marker-end='url(%23mermaid-2_flowchart-v2-pointEnd)'/></g><g class='edgeLabels'><g class='edgeLabel'><g class='label' data-id='L_A_B_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_B_C_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_C_D_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_D_E_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel' transform='translate(1085.6484375%2c 35)'><g class='label' data-id='L_E_F_0' transform='translate(-6%2c -12)'><foreignObject width='12' height='24'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'><p>否</p></span></div></foreignObject></g></g><g class='edgeLabel' transform='translate(963.3125%2c 139)'><g class='label' data-id='L_E_G_0' transform='translate(-6%2c -12)'><foreignObject width='12' height='24'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'><p>是</p></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_G_H_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_F_I_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_H_I_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g></g><g class='nodes'><g class='node default' id='mermaid-2-flowchart-A-0' data-look='classic' transform='translate(94.90625%2c 87)'><rect class='basic label-container' style='' x='-86.90625' y='-27' width='173.8125' height='54'/><g class='label' style='' transform='translate(-56.90625%2c -12)'><rect/><foreignObject width='113.8125' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>模型生成 Tool Call</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-2-flowchart-B-1' data-look='classic' transform='translate(319.609375%2c 87)'><rect class='basic label-container' style='' x='-87.796875' y='-27' width='175.59375' height='54'/><g class='label' style='' transform='translate(-57.796875%2c -12)'><rect/><foreignObject width='115.59375' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>参数 Schema 校验</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-2-flowchart-C-3' data-look='classic' transform='translate(523.40625%2c 87)'><rect class='basic label-container' style='' x='-66' y='-27' width='132' height='54'/><g class='label' style='' transform='translate(-36%2c -12)'><rect/><foreignObject width='72' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>业务参数校验</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-2-flowchart-D-5' data-look='classic' transform='translate(711.40625%2c 87)'><rect class='basic label-container' style='' x='-72' y='-27' width='144' height='54'/><g class='label' style='' transform='translate(-42%2c -12)'><rect/><foreignObject width='84' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>身份与权限检查</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-2-flowchart-E-7' data-look='classic' transform='translate(882.859375%2c 87)'><polygon points='49.453125%2c0 98.90625%2c-49.453125 49.453125%2c-98.90625 0%2c-49.453125' class='label-container' transform='translate(-48.953125%2c 49.453125)'/><g class='label' style='' transform='translate(-22.453125%2c -12)'><rect/><foreignObject width='44.90625' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>写操作%3f</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-2-flowchart-F-9' data-look='classic' transform='translate(1307.0859375%2c 35)'><rect class='basic label-container' style='' x='-80.1015625' y='-27' width='160.203125' height='54'/><g class='label' style='' transform='translate(-50.1015625%2c -12)'><rect/><foreignObject width='100.203125' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>执行 Read Tool</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-2-flowchart-G-11' data-look='classic' transform='translate(1085.6484375%2c 139)'><rect class='basic label-container' style='' x='-91.3359375' y='-27' width='182.671875' height='54'/><g class='label' style='' transform='translate(-61.3359375%2c -12)'><rect/><foreignObject width='122.671875' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>确认 / 审批 / 幂等检查</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-2-flowchart-H-13' data-look='classic' transform='translate(1307.0859375%2c 139)'><rect class='basic label-container' style='' x='-79.5' y='-27' width='159' height='54'/><g class='label' style='' transform='translate(-49.5%2c -12)'><rect/><foreignObject width='99' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>执行 Write Tool</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-2-flowchart-I-15' data-look='classic' transform='translate(1491.1875%2c 87)'><rect class='basic label-container' style='' x='-54' y='-27' width='108' height='54'/><g class='label' style='' transform='translate(-24%2c -12)'><rect/><foreignObject width='48' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>记录结果</p></span></div></foreignObject></g></g></g></g></g><defs><filter id='mermaid-2-drop-shadow' height='130%' width='130%'><feDropShadow dx='4' dy='4' stdDeviation='0' flood-opacity='0.06' flood-color='black'/></filter></defs><defs><filter id='mermaid-2-drop-shadow-small' height='150%' width='150%'><feDropShadow dx='2' dy='2' stdDeviation='0' flood-opacity='0.06' flood-color='black'/></filter></defs></svg>)
%3btext-align:center%3b}%23mermaid-dark-2 .edgeLabel p{background-color:hsl(0%2c 0%%2c 34.4117647059%)%3b}%23mermaid-dark-2 .edgeLabel rect{opacity:0.5%3bbackground-color:hsl(0%2c 0%%2c 34.4117647059%)%3bfill:hsl(0%2c 0%%2c 34.4117647059%)%3b}%23mermaid-dark-2 .labelBkg{background-color:rgba(87.75%2c 87.75%2c 87.75%2c 0.5)%3b}%23mermaid-dark-2 .cluster rect{fill:hsl(180%2c 1.5873015873%%2c 28.3529411765%)%3bstroke:rgba(255%2c 255%2c 255%2c 0.25)%3bstroke-width:1px%3b}%23mermaid-dark-2 .cluster text{fill:%23F9FFFE%3b}%23mermaid-dark-2 .cluster span{color:%23F9FFFE%3b}%23mermaid-dark-2 .node .collapsed-indicator{fill:rgba(255%2c 255%2c 255%2c 0.25)%3bstroke:none%3bopacity:0.6%3b}%23mermaid-dark-2 .node .collapsed-separator{stroke:rgba(255%2c 255%2c 255%2c 0.25)%3bstroke-width:0.75px%3b}%23mermaid-dark-2 div.mermaidTooltip{position:absolute%3btext-align:center%3bmax-width:200px%3bpadding:2px%3bfont-family:arial%2csans-serif%3bfont-size:12px%3bbackground:hsl(20%2c 1.5873015873%%2c 12.3529411765%)%3bborder:1px solid rgba(255%2c 255%2c 255%2c 0.25)%3bborder-radius:2px%3bpointer-events:none%3bz-index:100%3b}%23mermaid-dark-2 .flowchartTitleText{text-anchor:middle%3bfont-size:18px%3bfill:%23ccc%3b}%23mermaid-dark-2 rect.text{fill:none%3bstroke-width:0%3b}%23mermaid-dark-2 .icon-shape%2c%23mermaid-dark-2 .image-shape{background-color:hsl(0%2c 0%%2c 34.4117647059%)%3btext-align:center%3b}%23mermaid-dark-2 .icon-shape p%2c%23mermaid-dark-2 .image-shape p{background-color:hsl(0%2c 0%%2c 34.4117647059%)%3bpadding:2px%3b}%23mermaid-dark-2 .icon-shape .label rect%2c%23mermaid-dark-2 .image-shape .label rect{opacity:0.5%3bbackground-color:hsl(0%2c 0%%2c 34.4117647059%)%3bfill:hsl(0%2c 0%%2c 34.4117647059%)%3b}%23mermaid-dark-2 .label-icon{display:inline-block%3bheight:1em%3boverflow:visible%3bvertical-align:-0.125em%3b}%23mermaid-dark-2 .node .label-icon path{fill:currentColor%3bstroke:revert%3bstroke-width:revert%3b}%23mermaid-dark-2 .node .neo-node{stroke:%23ccc%3b}%23mermaid-dark-2 [data-look='neo'].node rect%2c%23mermaid-dark-2 [data-look='neo'].cluster rect%2c%23mermaid-dark-2 [data-look='neo'].node polygon{stroke:url(%23mermaid-dark-2-gradient)%3bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b}%23mermaid-dark-2 [data-look='neo'].swimlane.cluster rect{filter:none%3b}%23mermaid-dark-2 [data-look='neo'].node path{stroke:url(%23mermaid-dark-2-gradient)%3bstroke-width:1px%3b}%23mermaid-dark-2 [data-look='neo'].node .outer-path{filter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b}%23mermaid-dark-2 [data-look='neo'].node .neo-line path{stroke:%23ccc%3bfilter:none%3b}%23mermaid-dark-2 [data-look='neo'].node circle{stroke:url(%23mermaid-dark-2-gradient)%3bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b}%23mermaid-dark-2 [data-look='neo'].node circle .state-start{fill:black%3b}%23mermaid-dark-2 [data-look='neo'].icon-shape .icon{fill:url(%23mermaid-dark-2-gradient)%3bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b}%23mermaid-dark-2 [data-look='neo'].icon-shape .icon-neo path{stroke:url(%23mermaid-dark-2-gradient)%3bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b}%23mermaid-dark-2 :root{--mermaid-font-family:arial%2csans-serif%3b}</style><g><marker id='mermaid-dark-2_flowchart-v2-pointEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'><path d='M 0 0 L 10 5 L 0 10 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-2_flowchart-v2-pointStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='4.5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'><path d='M 0 5 L 10 10 L 10 0 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-2_flowchart-v2-pointEnd-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='11.5' refY='7' markerUnits='userSpaceOnUse' markerWidth='10.5' markerHeight='14' orient='auto'><path d='M 0 0 L 11.5 7 L 0 14 z' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-2_flowchart-v2-pointStart-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='1' refY='7' markerUnits='userSpaceOnUse' markerWidth='11.5' markerHeight='14' orient='auto'><polygon points='0%2c7 11.5%2c14 11.5%2c0' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-2_flowchart-v2-circleEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='11' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-2_flowchart-v2-circleStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-1' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-2_flowchart-v2-circleEnd-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refY='5' refX='12.25' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-2_flowchart-v2-circleStart-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-2' refY='5' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-2_flowchart-v2-crossEnd' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='12' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><path d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-2_flowchart-v2-crossStart' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='-1' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><path d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-2_flowchart-v2-crossEnd-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='17.7' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'><path d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b'/></marker><marker id='mermaid-dark-2_flowchart-v2-crossStart-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='-3.5' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'><path d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b stroke-dasharray: 1%2c 0%3b'/></marker><g class='root'><g class='clusters'/><g class='edgePaths'><path d='M181.813%2c87L185.979%2c87C190.146%2c87%2c198.479%2c87%2c206.146%2c87C213.813%2c87%2c220.813%2c87%2c224.313%2c87L227.813%2c87' id='mermaid-dark-2-L_A_B_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_A_B_0' data-points='W3sieCI6MTgxLjgxMjUsInkiOjg3fSx7IngiOjIwNi44MTI1LCJ5Ijo4N30seyJ4IjoyMzEuODEyNSwieSI6ODd9XQ==' data-look='classic' marker-end='url(%23mermaid-dark-2_flowchart-v2-pointEnd)'/><path d='M407.406%2c87L411.573%2c87C415.74%2c87%2c424.073%2c87%2c431.74%2c87C439.406%2c87%2c446.406%2c87%2c449.906%2c87L453.406%2c87' id='mermaid-dark-2-L_B_C_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_B_C_0' data-points='W3sieCI6NDA3LjQwNjI1LCJ5Ijo4N30seyJ4Ijo0MzIuNDA2MjUsInkiOjg3fSx7IngiOjQ1Ny40MDYyNSwieSI6ODd9XQ==' data-look='classic' marker-end='url(%23mermaid-dark-2_flowchart-v2-pointEnd)'/><path d='M589.406%2c87L593.573%2c87C597.74%2c87%2c606.073%2c87%2c613.74%2c87C621.406%2c87%2c628.406%2c87%2c631.906%2c87L635.406%2c87' id='mermaid-dark-2-L_C_D_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_C_D_0' data-points='W3sieCI6NTg5LjQwNjI1LCJ5Ijo4N30seyJ4Ijo2MTQuNDA2MjUsInkiOjg3fSx7IngiOjYzOS40MDYyNSwieSI6ODd9XQ==' data-look='classic' marker-end='url(%23mermaid-dark-2_flowchart-v2-pointEnd)'/><path d='M783.406%2c87L787.573%2c87C791.74%2c87%2c800.073%2c87%2c807.74%2c87C815.406%2c87%2c822.406%2c87%2c825.906%2c87L829.406%2c87' id='mermaid-dark-2-L_D_E_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_D_E_0' data-points='W3sieCI6NzgzLjQwNjI1LCJ5Ijo4N30seyJ4Ijo4MDguNDA2MjUsInkiOjg3fSx7IngiOjgzMy40MDYyNSwieSI6ODd9XQ==' data-look='classic' marker-end='url(%23mermaid-dark-2_flowchart-v2-pointEnd)'/><path d='M912.898%2c67.585L921.3%2c62.154C929.703%2c56.723%2c946.508%2c45.862%2c975.299%2c40.431C1004.091%2c35%2c1044.87%2c35%2c1084.648%2c35C1124.427%2c35%2c1163.206%2c35%2c1186.095%2c35C1208.984%2c35%2c1215.984%2c35%2c1219.484%2c35L1222.984%2c35' id='mermaid-dark-2-L_E_F_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_E_F_0' data-points='W3sieCI6OTEyLjg5NzYxMjY1Nzc3OTksInkiOjY3LjU4NTExMjY1Nzc3OTg3fSx7IngiOjk2My4zMTI1LCJ5IjozNX0seyJ4IjoxMDg1LjY0ODQzNzUsInkiOjM1fSx7IngiOjEyMDEuOTg0Mzc1LCJ5IjozNX0seyJ4IjoxMjI2Ljk4NDM3NSwieSI6MzV9XQ==' data-look='classic' marker-end='url(%23mermaid-dark-2_flowchart-v2-pointEnd)'/><path d='M912.898%2c106.415L921.3%2c111.846C929.703%2c117.277%2c946.508%2c128.138%2c959.41%2c133.569C972.313%2c139%2c981.313%2c139%2c985.813%2c139L990.313%2c139' id='mermaid-dark-2-L_E_G_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_E_G_0' data-points='W3sieCI6OTEyLjg5NzYxMjY1Nzc3OTksInkiOjEwNi40MTQ4ODczNDIyMjAxM30seyJ4Ijo5NjMuMzEyNSwieSI6MTM5fSx7IngiOjk5NC4zMTI1LCJ5IjoxMzl9XQ==' data-look='classic' marker-end='url(%23mermaid-dark-2_flowchart-v2-pointEnd)'/><path d='M1176.984%2c139L1181.151%2c139C1185.318%2c139%2c1193.651%2c139%2c1201.418%2c139C1209.185%2c139%2c1216.385%2c139%2c1219.986%2c139L1223.586%2c139' id='mermaid-dark-2-L_G_H_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_G_H_0' data-points='W3sieCI6MTE3Ni45ODQzNzUsInkiOjEzOX0seyJ4IjoxMjAxLjk4NDM3NSwieSI6MTM5fSx7IngiOjEyMjcuNTg1OTM3NSwieSI6MTM5fV0=' data-look='classic' marker-end='url(%23mermaid-dark-2_flowchart-v2-pointEnd)'/><path d='M1387.188%2c35L1391.354%2c35C1395.521%2c35%2c1403.854%2c35%2c1413.794%2c38.8C1423.734%2c42.6%2c1435.281%2c50.201%2c1441.054%2c54.001L1446.827%2c57.801' id='mermaid-dark-2-L_F_I_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_F_I_0' data-points='W3sieCI6MTM4Ny4xODc1LCJ5IjozNX0seyJ4IjoxNDEyLjE4NzUsInkiOjM1fSx7IngiOjE0NTAuMTY4MjY5MjMwNzY5MywieSI6NjB9XQ==' data-look='classic' marker-end='url(%23mermaid-dark-2_flowchart-v2-pointEnd)'/><path d='M1386.586%2c139L1390.853%2c139C1395.12%2c139%2c1403.654%2c139%2c1413.694%2c135.2C1423.734%2c131.4%2c1435.281%2c123.799%2c1441.054%2c119.999L1446.827%2c116.199' id='mermaid-dark-2-L_H_I_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_H_I_0' data-points='W3sieCI6MTM4Ni41ODU5Mzc1LCJ5IjoxMzl9LHsieCI6MTQxMi4xODc1LCJ5IjoxMzl9LHsieCI6MTQ1MC4xNjgyNjkyMzA3NjkzLCJ5IjoxMTR9XQ==' data-look='classic' marker-end='url(%23mermaid-dark-2_flowchart-v2-pointEnd)'/></g><g class='edgeLabels'><g class='edgeLabel'><g class='label' data-id='L_A_B_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_B_C_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_C_D_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_D_E_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel' transform='translate(1085.6484375%2c 35)'><g class='label' data-id='L_E_F_0' transform='translate(-6%2c -12)'><foreignObject width='12' height='24'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'><p>否</p></span></div></foreignObject></g></g><g class='edgeLabel' transform='translate(963.3125%2c 139)'><g class='label' data-id='L_E_G_0' transform='translate(-6%2c -12)'><foreignObject width='12' height='24'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'><p>是</p></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_G_H_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_F_I_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_H_I_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g></g><g class='nodes'><g class='node default' id='mermaid-dark-2-flowchart-A-0' data-look='classic' transform='translate(94.90625%2c 87)'><rect class='basic label-container' style='' x='-86.90625' y='-27' width='173.8125' height='54'/><g class='label' style='' transform='translate(-56.90625%2c -12)'><rect/><foreignObject width='113.8125' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>模型生成 Tool Call</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-dark-2-flowchart-B-1' data-look='classic' transform='translate(319.609375%2c 87)'><rect class='basic label-container' style='' x='-87.796875' y='-27' width='175.59375' height='54'/><g class='label' style='' transform='translate(-57.796875%2c -12)'><rect/><foreignObject width='115.59375' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>参数 Schema 校验</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-dark-2-flowchart-C-3' data-look='classic' transform='translate(523.40625%2c 87)'><rect class='basic label-container' style='' x='-66' y='-27' width='132' height='54'/><g class='label' style='' transform='translate(-36%2c -12)'><rect/><foreignObject width='72' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>业务参数校验</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-dark-2-flowchart-D-5' data-look='classic' transform='translate(711.40625%2c 87)'><rect class='basic label-container' style='' x='-72' y='-27' width='144' height='54'/><g class='label' style='' transform='translate(-42%2c -12)'><rect/><foreignObject width='84' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>身份与权限检查</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-dark-2-flowchart-E-7' data-look='classic' transform='translate(882.859375%2c 87)'><polygon points='49.453125%2c0 98.90625%2c-49.453125 49.453125%2c-98.90625 0%2c-49.453125' class='label-container' transform='translate(-48.953125%2c 49.453125)'/><g class='label' style='' transform='translate(-22.453125%2c -12)'><rect/><foreignObject width='44.90625' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>写操作%3f</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-dark-2-flowchart-F-9' data-look='classic' transform='translate(1307.0859375%2c 35)'><rect class='basic label-container' style='' x='-80.1015625' y='-27' width='160.203125' height='54'/><g class='label' style='' transform='translate(-50.1015625%2c -12)'><rect/><foreignObject width='100.203125' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>执行 Read Tool</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-dark-2-flowchart-G-11' data-look='classic' transform='translate(1085.6484375%2c 139)'><rect class='basic label-container' style='' x='-91.3359375' y='-27' width='182.671875' height='54'/><g class='label' style='' transform='translate(-61.3359375%2c -12)'><rect/><foreignObject width='122.671875' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>确认 / 审批 / 幂等检查</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-dark-2-flowchart-H-13' data-look='classic' transform='translate(1307.0859375%2c 139)'><rect class='basic label-container' style='' x='-79.5' y='-27' width='159' height='54'/><g class='label' style='' transform='translate(-49.5%2c -12)'><rect/><foreignObject width='99' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>执行 Write Tool</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-dark-2-flowchart-I-15' data-look='classic' transform='translate(1491.1875%2c 87)'><rect class='basic label-container' style='' x='-54' y='-27' width='108' height='54'/><g class='label' style='' transform='translate(-24%2c -12)'><rect/><foreignObject width='48' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>记录结果</p></span></div></foreignObject></g></g></g></g></g><defs><filter id='mermaid-dark-2-drop-shadow' height='130%' width='130%'><feDropShadow dx='4' dy='4' stdDeviation='0' flood-opacity='0.06' flood-color='white'/></filter></defs><defs><filter id='mermaid-dark-2-drop-shadow-small' height='150%' width='150%'><feDropShadow dx='2' dy='2' stdDeviation='0' flood-opacity='0.06' flood-color='white'/></filter></defs><linearGradient id='mermaid-dark-2-gradient' gradientUnits='objectBoundingBox' x1='0%' y1='0%' x2='100%' y2='0%'><stop offset='0%' stop-color='%23cccccc' stop-opacity='1'/><stop offset='100%' stop-color='hsl(180%2c 0%%2c 18.3529411765%)' stop-opacity='1'/></linearGradient></svg>)
始终重新校验输入
即使启用了 strict=True,也不能跳过业务校验。Schema 可以限制参数类型、字段和枚举,却无法判断:
- 订单是否存在;
- 订单是否属于当前用户;
- 当前状态是否允许取消;
- 用户是否有权访问目标数据;
- 参数是否违反业务限制。
Tool Executor 仍然属于后端业务代码,不能因为参数来自模型就降低验证标准。
遵循最小权限原则
不要把底层无限能力直接提供给模型:
execute_sql(sql)
run_shell(command)
call_any_url(url)
更合理的是提供范围明确的业务工具:
get_order(order_id)
create_ticket(...)
update_ticket_status(...)
query_service_health(service_name)
不同业务场景也应获得不同的工具集合。订单助手不需要部署权限,研发助手也不应默认拥有退款能力。
控制工具输出
工具结果应遵循最小必要数据原则。不要把完整数据库记录、内部字段、审计信息和历史数据全部交给模型。
推荐返回明确的状态结构:
{
  "success": false,
  "error_code": "ORDER_NOT_FOUND",
  "message": "订单不存在"
}
而不是含糊的字符串:
找不到内部异常也不应直接返回堆栈。应用可以记录详细日志,但只向模型暴露经过处理的业务错误码,避免泄露数据库地址、表名、文件路径和内部类名。
幂等、审计与重试
查询工具通常可以安全重试,但退款、发送邮件、部署和删除等写操作可能因为重复调用产生严重后果。应使用幂等键、请求去重、事务和状态检查。
Tool Calling 的审计日志至少可以记录:
| 字段 | 说明 |
|---|---|
| Request ID | 用户请求标识 |
| Response ID | 模型响应标识 |
| Tool Name | 调用的工具 |
| Call ID | 模型工具调用标识 |
| Arguments | 经脱敏的参数 |
| Result | 经脱敏的结果 |
| User ID | 触发操作的用户 |
| Duration | 工具执行耗时 |
| Status | 成功或失败 |
查询工具可以对临时网络错误有限重试;写操作是否重试,则必须结合幂等性和业务语义判断。
在系统架构中的位置
一个清晰的 Function Calling 架构可以分为以下层次:
%3btext-align:center%3b}%23mermaid-3 .edgeLabel p{background-color:rgba(232%2c232%2c232%2c 0.8)%3b}%23mermaid-3 .edgeLabel rect{opacity:0.5%3bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bfill:rgba(232%2c232%2c232%2c 0.8)%3b}%23mermaid-3 .labelBkg{background-color:rgba(232%2c 232%2c 232%2c 0.5)%3b}%23mermaid-3 .cluster rect{fill:%23ffffde%3bstroke:%23aaaa33%3bstroke-width:1px%3b}%23mermaid-3 .cluster text{fill:%23333%3b}%23mermaid-3 .cluster span{color:%23333%3b}%23mermaid-3 .node .collapsed-indicator{fill:%23aaaa33%3bstroke:none%3bopacity:0.6%3b}%23mermaid-3 .node .collapsed-separator{stroke:%23aaaa33%3bstroke-width:0.75px%3b}%23mermaid-3 div.mermaidTooltip{position:absolute%3btext-align:center%3bmax-width:200px%3bpadding:2px%3bfont-family:arial%2csans-serif%3bfont-size:12px%3bbackground:hsl(80%2c 100%%2c 96.2745098039%)%3bborder:1px solid %23aaaa33%3bborder-radius:2px%3bpointer-events:none%3bz-index:100%3b}%23mermaid-3 .flowchartTitleText{text-anchor:middle%3bfont-size:18px%3bfill:%23333%3b}%23mermaid-3 rect.text{fill:none%3bstroke-width:0%3b}%23mermaid-3 .icon-shape%2c%23mermaid-3 .image-shape{background-color:rgba(232%2c232%2c232%2c 0.8)%3btext-align:center%3b}%23mermaid-3 .icon-shape p%2c%23mermaid-3 .image-shape p{background-color:rgba(232%2c232%2c232%2c 0.8)%3bpadding:2px%3b}%23mermaid-3 .icon-shape .label rect%2c%23mermaid-3 .image-shape .label rect{opacity:0.5%3bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bfill:rgba(232%2c232%2c232%2c 0.8)%3b}%23mermaid-3 .label-icon{display:inline-block%3bheight:1em%3boverflow:visible%3bvertical-align:-0.125em%3b}%23mermaid-3 .node .label-icon path{fill:currentColor%3bstroke:revert%3bstroke-width:revert%3b}%23mermaid-3 .node .neo-node{stroke:%239370DB%3b}%23mermaid-3 [data-look='neo'].node rect%2c%23mermaid-3 [data-look='neo'].cluster rect%2c%23mermaid-3 [data-look='neo'].node polygon{stroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b}%23mermaid-3 [data-look='neo'].swimlane.cluster rect{filter:none%3b}%23mermaid-3 [data-look='neo'].node path{stroke:%239370DB%3bstroke-width:1px%3b}%23mermaid-3 [data-look='neo'].node .outer-path{filter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b}%23mermaid-3 [data-look='neo'].node .neo-line path{stroke:%239370DB%3bfilter:none%3b}%23mermaid-3 [data-look='neo'].node circle{stroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b}%23mermaid-3 [data-look='neo'].node circle .state-start{fill:black%3b}%23mermaid-3 [data-look='neo'].icon-shape .icon{fill:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b}%23mermaid-3 [data-look='neo'].icon-shape .icon-neo path{stroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b}%23mermaid-3 :root{--mermaid-font-family:arial%2csans-serif%3b}</style><g><marker id='mermaid-3_flowchart-v2-pointEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'><path d='M 0 0 L 10 5 L 0 10 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-3_flowchart-v2-pointStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='4.5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'><path d='M 0 5 L 10 10 L 10 0 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-3_flowchart-v2-pointEnd-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='11.5' refY='7' markerUnits='userSpaceOnUse' markerWidth='10.5' markerHeight='14' orient='auto'><path d='M 0 0 L 11.5 7 L 0 14 z' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-3_flowchart-v2-pointStart-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='1' refY='7' markerUnits='userSpaceOnUse' markerWidth='11.5' markerHeight='14' orient='auto'><polygon points='0%2c7 11.5%2c14 11.5%2c0' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-3_flowchart-v2-circleEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='11' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-3_flowchart-v2-circleStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-1' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-3_flowchart-v2-circleEnd-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refY='5' refX='12.25' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-3_flowchart-v2-circleStart-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-2' refY='5' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-3_flowchart-v2-crossEnd' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='12' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><path d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-3_flowchart-v2-crossStart' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='-1' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><path d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-3_flowchart-v2-crossEnd-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='17.7' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'><path d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b'/></marker><marker id='mermaid-3_flowchart-v2-crossStart-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='-3.5' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'><path d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b stroke-dasharray: 1%2c 0%3b'/></marker><g class='root'><g class='clusters'/><g class='edgePaths'><path d='M212.859%2c62L212.859%2c66.167C212.859%2c70.333%2c212.859%2c78.667%2c212.859%2c86.333C212.859%2c94%2c212.859%2c101%2c212.859%2c104.5L212.859%2c108' id='mermaid-3-L_A_B_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_A_B_0' data-points='W3sieCI6MjEyLjg1OTM3NSwieSI6NjJ9LHsieCI6MjEyLjg1OTM3NSwieSI6ODd9LHsieCI6MjEyLjg1OTM3NSwieSI6MTEyfV0=' data-look='classic' marker-end='url(%23mermaid-3_flowchart-v2-pointEnd)'/><path d='M212.859%2c166L212.859%2c170.167C212.859%2c174.333%2c212.859%2c182.667%2c212.859%2c190.333C212.859%2c198%2c212.859%2c205%2c212.859%2c208.5L212.859%2c212' id='mermaid-3-L_B_C_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_B_C_0' data-points='W3sieCI6MjEyLjg1OTM3NSwieSI6MTY2fSx7IngiOjIxMi44NTkzNzUsInkiOjE5MX0seyJ4IjoyMTIuODU5Mzc1LCJ5IjoyMTZ9XQ==' data-look='classic' marker-end='url(%23mermaid-3_flowchart-v2-pointEnd)'/><path d='M212.859%2c270L212.859%2c274.167C212.859%2c278.333%2c212.859%2c286.667%2c212.859%2c294.333C212.859%2c302%2c212.859%2c309%2c212.859%2c312.5L212.859%2c316' id='mermaid-3-L_C_D_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_C_D_0' data-points='W3sieCI6MjEyLjg1OTM3NSwieSI6MjcwfSx7IngiOjIxMi44NTkzNzUsInkiOjI5NX0seyJ4IjoyMTIuODU5Mzc1LCJ5IjozMjB9XQ==' data-look='classic' marker-end='url(%23mermaid-3_flowchart-v2-pointEnd)'/><path d='M212.859%2c374L212.859%2c378.167C212.859%2c382.333%2c212.859%2c390.667%2c212.859%2c398.333C212.859%2c406%2c212.859%2c413%2c212.859%2c416.5L212.859%2c420' id='mermaid-3-L_D_E_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_D_E_0' data-points='W3sieCI6MjEyLjg1OTM3NSwieSI6Mzc0fSx7IngiOjIxMi44NTkzNzUsInkiOjM5OX0seyJ4IjoyMTIuODU5Mzc1LCJ5Ijo0MjR9XQ==' data-look='classic' marker-end='url(%23mermaid-3_flowchart-v2-pointEnd)'/><path d='M128.168%2c478L115.098%2c482.167C102.029%2c486.333%2c75.889%2c494.667%2c62.82%2c502.333C49.75%2c510%2c49.75%2c517%2c49.75%2c520.5L49.75%2c524' id='mermaid-3-L_E_F_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_E_F_0' data-points='W3sieCI6MTI4LjE2Nzk2ODc1LCJ5Ijo0Nzh9LHsieCI6NDkuNzUsInkiOjUwM30seyJ4Ijo0OS43NSwieSI6NTI4fV0=' data-look='classic' marker-end='url(%23mermaid-3_flowchart-v2-pointEnd)'/><path d='M212.859%2c478L212.859%2c482.167C212.859%2c486.333%2c212.859%2c494.667%2c212.859%2c503.586C212.859%2c512.506%2c212.859%2c522.012%2c212.859%2c526.765L212.859%2c531.518' id='mermaid-3-L_E_G_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_E_G_0' data-points='W3sieCI6MjEyLjg1OTM3NSwieSI6NDc4fSx7IngiOjIxMi44NTkzNzUsInkiOjUwM30seyJ4IjoyMTIuODU5Mzc1LCJ5Ijo1MzUuNTE3OTg2Mjk3NjA3NH1d' data-look='classic' marker-end='url(%23mermaid-3_flowchart-v2-pointEnd)'/><path d='M304.219%2c472.699L325.482%2c477.749C346.745%2c482.799%2c389.271%2c492.9%2c410.534%2c502.703C431.797%2c512.506%2c431.797%2c522.012%2c431.797%2c526.765L431.797%2c531.518' id='mermaid-3-L_E_H_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_E_H_0' data-points='W3sieCI6MzA0LjIxODc1LCJ5Ijo0NzIuNjk4ODI5NTc0NjUwM30seyJ4Ijo0MzEuNzk2ODc1LCJ5Ijo1MDN9LHsieCI6NDMxLjc5Njg3NSwieSI6NTM1LjUxNzk4NjI5NzYwNzR9XQ==' data-look='classic' marker-end='url(%23mermaid-3_flowchart-v2-pointEnd)'/></g><g class='edgeLabels'><g class='edgeLabel'><g class='label' data-id='L_A_B_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_B_C_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_C_D_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_D_E_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_E_F_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_E_G_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_E_H_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g></g><g class='nodes'><g class='node default' id='mermaid-3-flowchart-A-0' data-look='classic' transform='translate(212.859375%2c 35)'><rect class='basic label-container' style='' x='-65.1328125' y='-27' width='130.265625' height='54'/><g class='label' style='' transform='translate(-35.1328125%2c -12)'><rect/><foreignObject width='70.265625' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>API Layer</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-3-flowchart-B-1' data-look='classic' transform='translate(212.859375%2c 139)'><rect class='basic label-container' style='' x='-74.4609375' y='-27' width='148.921875' height='54'/><g class='label' style='' transform='translate(-44.4609375%2c -12)'><rect/><foreignObject width='88.921875' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>LLM Service</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-3-flowchart-C-3' data-look='classic' transform='translate(212.859375%2c 243)'><rect class='basic label-container' style='' x='-76.2421875' y='-27' width='152.484375' height='54'/><g class='label' style='' transform='translate(-46.2421875%2c -12)'><rect/><foreignObject width='92.484375' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>Tool Registry</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-3-flowchart-D-5' data-look='classic' transform='translate(212.859375%2c 347)'><rect class='basic label-container' style='' x='-78.46875' y='-27' width='156.9375' height='54'/><g class='label' style='' transform='translate(-48.46875%2c -12)'><rect/><foreignObject width='96.9375' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>Tool Executor</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-3-flowchart-E-7' data-look='classic' transform='translate(212.859375%2c 451)'><rect class='basic label-container' style='' x='-91.359375' y='-27' width='182.71875' height='54'/><g class='label' style='' transform='translate(-61.359375%2c -12)'><rect/><foreignObject width='122.71875' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>Business Service</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-3-flowchart-F-9' data-look='classic' transform='translate(49.75%2c 562.5179862976074)'><path d='M0%2c10.011990407673862 a41.75%2c10.011990407673862 0%2c0%2c0 83.5%2c0 a41.75%2c10.011990407673862 0%2c0%2c0 -83.5%2c0 l0%2c49.01199040767386 a41.75%2c10.011990407673862 0%2c0%2c0 83.5%2c0 l0%2c-49.01199040767386' class='basic label-container outer-path' style='' transform='translate(-41.75%2c -34.517985611510795)'/><g class='label' style='' transform='translate(-34.25%2c -2)'><rect/><foreignObject width='68.5' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>Database</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-3-flowchart-G-11' data-look='classic' transform='translate(212.859375%2c 562.5179862976074)'><rect class='basic label-container' style='' x='-71.359375' y='-27' width='142.71875' height='54'/><g class='label' style='' transform='translate(-41.359375%2c -12)'><rect/><foreignObject width='82.71875' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>Internal API</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-3-flowchart-H-13' data-look='classic' transform='translate(431.796875%2c 562.5179862976074)'><rect class='basic label-container' style='' x='-97.578125' y='-27' width='195.15625' height='54'/><g class='label' style='' transform='translate(-67.578125%2c -12)'><rect/><foreignObject width='135.15625' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>Third-party Service</p></span></div></foreignObject></g></g></g></g></g><defs><filter id='mermaid-3-drop-shadow' height='130%' width='130%'><feDropShadow dx='4' dy='4' stdDeviation='0' flood-opacity='0.06' flood-color='black'/></filter></defs><defs><filter id='mermaid-3-drop-shadow-small' height='150%' width='150%'><feDropShadow dx='2' dy='2' stdDeviation='0' flood-opacity='0.06' flood-color='black'/></filter></defs></svg>)
%3btext-align:center%3b}%23mermaid-dark-3 .edgeLabel p{background-color:hsl(0%2c 0%%2c 34.4117647059%)%3b}%23mermaid-dark-3 .edgeLabel rect{opacity:0.5%3bbackground-color:hsl(0%2c 0%%2c 34.4117647059%)%3bfill:hsl(0%2c 0%%2c 34.4117647059%)%3b}%23mermaid-dark-3 .labelBkg{background-color:rgba(87.75%2c 87.75%2c 87.75%2c 0.5)%3b}%23mermaid-dark-3 .cluster rect{fill:hsl(180%2c 1.5873015873%%2c 28.3529411765%)%3bstroke:rgba(255%2c 255%2c 255%2c 0.25)%3bstroke-width:1px%3b}%23mermaid-dark-3 .cluster text{fill:%23F9FFFE%3b}%23mermaid-dark-3 .cluster span{color:%23F9FFFE%3b}%23mermaid-dark-3 .node .collapsed-indicator{fill:rgba(255%2c 255%2c 255%2c 0.25)%3bstroke:none%3bopacity:0.6%3b}%23mermaid-dark-3 .node .collapsed-separator{stroke:rgba(255%2c 255%2c 255%2c 0.25)%3bstroke-width:0.75px%3b}%23mermaid-dark-3 div.mermaidTooltip{position:absolute%3btext-align:center%3bmax-width:200px%3bpadding:2px%3bfont-family:arial%2csans-serif%3bfont-size:12px%3bbackground:hsl(20%2c 1.5873015873%%2c 12.3529411765%)%3bborder:1px solid rgba(255%2c 255%2c 255%2c 0.25)%3bborder-radius:2px%3bpointer-events:none%3bz-index:100%3b}%23mermaid-dark-3 .flowchartTitleText{text-anchor:middle%3bfont-size:18px%3bfill:%23ccc%3b}%23mermaid-dark-3 rect.text{fill:none%3bstroke-width:0%3b}%23mermaid-dark-3 .icon-shape%2c%23mermaid-dark-3 .image-shape{background-color:hsl(0%2c 0%%2c 34.4117647059%)%3btext-align:center%3b}%23mermaid-dark-3 .icon-shape p%2c%23mermaid-dark-3 .image-shape p{background-color:hsl(0%2c 0%%2c 34.4117647059%)%3bpadding:2px%3b}%23mermaid-dark-3 .icon-shape .label rect%2c%23mermaid-dark-3 .image-shape .label rect{opacity:0.5%3bbackground-color:hsl(0%2c 0%%2c 34.4117647059%)%3bfill:hsl(0%2c 0%%2c 34.4117647059%)%3b}%23mermaid-dark-3 .label-icon{display:inline-block%3bheight:1em%3boverflow:visible%3bvertical-align:-0.125em%3b}%23mermaid-dark-3 .node .label-icon path{fill:currentColor%3bstroke:revert%3bstroke-width:revert%3b}%23mermaid-dark-3 .node .neo-node{stroke:%23ccc%3b}%23mermaid-dark-3 [data-look='neo'].node rect%2c%23mermaid-dark-3 [data-look='neo'].cluster rect%2c%23mermaid-dark-3 [data-look='neo'].node polygon{stroke:url(%23mermaid-dark-3-gradient)%3bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b}%23mermaid-dark-3 [data-look='neo'].swimlane.cluster rect{filter:none%3b}%23mermaid-dark-3 [data-look='neo'].node path{stroke:url(%23mermaid-dark-3-gradient)%3bstroke-width:1px%3b}%23mermaid-dark-3 [data-look='neo'].node .outer-path{filter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b}%23mermaid-dark-3 [data-look='neo'].node .neo-line path{stroke:%23ccc%3bfilter:none%3b}%23mermaid-dark-3 [data-look='neo'].node circle{stroke:url(%23mermaid-dark-3-gradient)%3bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b}%23mermaid-dark-3 [data-look='neo'].node circle .state-start{fill:black%3b}%23mermaid-dark-3 [data-look='neo'].icon-shape .icon{fill:url(%23mermaid-dark-3-gradient)%3bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b}%23mermaid-dark-3 [data-look='neo'].icon-shape .icon-neo path{stroke:url(%23mermaid-dark-3-gradient)%3bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b}%23mermaid-dark-3 :root{--mermaid-font-family:arial%2csans-serif%3b}</style><g><marker id='mermaid-dark-3_flowchart-v2-pointEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'><path d='M 0 0 L 10 5 L 0 10 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-3_flowchart-v2-pointStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='4.5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'><path d='M 0 5 L 10 10 L 10 0 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-3_flowchart-v2-pointEnd-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='11.5' refY='7' markerUnits='userSpaceOnUse' markerWidth='10.5' markerHeight='14' orient='auto'><path d='M 0 0 L 11.5 7 L 0 14 z' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-3_flowchart-v2-pointStart-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='1' refY='7' markerUnits='userSpaceOnUse' markerWidth='11.5' markerHeight='14' orient='auto'><polygon points='0%2c7 11.5%2c14 11.5%2c0' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-3_flowchart-v2-circleEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='11' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-3_flowchart-v2-circleStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-1' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-3_flowchart-v2-circleEnd-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refY='5' refX='12.25' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-3_flowchart-v2-circleStart-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-2' refY='5' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-3_flowchart-v2-crossEnd' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='12' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><path d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-3_flowchart-v2-crossStart' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='-1' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><path d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-3_flowchart-v2-crossEnd-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='17.7' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'><path d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b'/></marker><marker id='mermaid-dark-3_flowchart-v2-crossStart-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='-3.5' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'><path d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b stroke-dasharray: 1%2c 0%3b'/></marker><g class='root'><g class='clusters'/><g class='edgePaths'><path d='M212.859%2c62L212.859%2c66.167C212.859%2c70.333%2c212.859%2c78.667%2c212.859%2c86.333C212.859%2c94%2c212.859%2c101%2c212.859%2c104.5L212.859%2c108' id='mermaid-dark-3-L_A_B_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_A_B_0' data-points='W3sieCI6MjEyLjg1OTM3NSwieSI6NjJ9LHsieCI6MjEyLjg1OTM3NSwieSI6ODd9LHsieCI6MjEyLjg1OTM3NSwieSI6MTEyfV0=' data-look='classic' marker-end='url(%23mermaid-dark-3_flowchart-v2-pointEnd)'/><path d='M212.859%2c166L212.859%2c170.167C212.859%2c174.333%2c212.859%2c182.667%2c212.859%2c190.333C212.859%2c198%2c212.859%2c205%2c212.859%2c208.5L212.859%2c212' id='mermaid-dark-3-L_B_C_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_B_C_0' data-points='W3sieCI6MjEyLjg1OTM3NSwieSI6MTY2fSx7IngiOjIxMi44NTkzNzUsInkiOjE5MX0seyJ4IjoyMTIuODU5Mzc1LCJ5IjoyMTZ9XQ==' data-look='classic' marker-end='url(%23mermaid-dark-3_flowchart-v2-pointEnd)'/><path d='M212.859%2c270L212.859%2c274.167C212.859%2c278.333%2c212.859%2c286.667%2c212.859%2c294.333C212.859%2c302%2c212.859%2c309%2c212.859%2c312.5L212.859%2c316' id='mermaid-dark-3-L_C_D_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_C_D_0' data-points='W3sieCI6MjEyLjg1OTM3NSwieSI6MjcwfSx7IngiOjIxMi44NTkzNzUsInkiOjI5NX0seyJ4IjoyMTIuODU5Mzc1LCJ5IjozMjB9XQ==' data-look='classic' marker-end='url(%23mermaid-dark-3_flowchart-v2-pointEnd)'/><path d='M212.859%2c374L212.859%2c378.167C212.859%2c382.333%2c212.859%2c390.667%2c212.859%2c398.333C212.859%2c406%2c212.859%2c413%2c212.859%2c416.5L212.859%2c420' id='mermaid-dark-3-L_D_E_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_D_E_0' data-points='W3sieCI6MjEyLjg1OTM3NSwieSI6Mzc0fSx7IngiOjIxMi44NTkzNzUsInkiOjM5OX0seyJ4IjoyMTIuODU5Mzc1LCJ5Ijo0MjR9XQ==' data-look='classic' marker-end='url(%23mermaid-dark-3_flowchart-v2-pointEnd)'/><path d='M128.168%2c478L115.098%2c482.167C102.029%2c486.333%2c75.889%2c494.667%2c62.82%2c502.333C49.75%2c510%2c49.75%2c517%2c49.75%2c520.5L49.75%2c524' id='mermaid-dark-3-L_E_F_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_E_F_0' data-points='W3sieCI6MTI4LjE2Nzk2ODc1LCJ5Ijo0Nzh9LHsieCI6NDkuNzUsInkiOjUwM30seyJ4Ijo0OS43NSwieSI6NTI4fV0=' data-look='classic' marker-end='url(%23mermaid-dark-3_flowchart-v2-pointEnd)'/><path d='M212.859%2c478L212.859%2c482.167C212.859%2c486.333%2c212.859%2c494.667%2c212.859%2c503.586C212.859%2c512.506%2c212.859%2c522.012%2c212.859%2c526.765L212.859%2c531.518' id='mermaid-dark-3-L_E_G_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_E_G_0' data-points='W3sieCI6MjEyLjg1OTM3NSwieSI6NDc4fSx7IngiOjIxMi44NTkzNzUsInkiOjUwM30seyJ4IjoyMTIuODU5Mzc1LCJ5Ijo1MzUuNTE3OTg2Mjk3NjA3NH1d' data-look='classic' marker-end='url(%23mermaid-dark-3_flowchart-v2-pointEnd)'/><path d='M304.219%2c472.699L325.482%2c477.749C346.745%2c482.799%2c389.271%2c492.9%2c410.534%2c502.703C431.797%2c512.506%2c431.797%2c522.012%2c431.797%2c526.765L431.797%2c531.518' id='mermaid-dark-3-L_E_H_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_E_H_0' data-points='W3sieCI6MzA0LjIxODc1LCJ5Ijo0NzIuNjk4ODI5NTc0NjUwM30seyJ4Ijo0MzEuNzk2ODc1LCJ5Ijo1MDN9LHsieCI6NDMxLjc5Njg3NSwieSI6NTM1LjUxNzk4NjI5NzYwNzR9XQ==' data-look='classic' marker-end='url(%23mermaid-dark-3_flowchart-v2-pointEnd)'/></g><g class='edgeLabels'><g class='edgeLabel'><g class='label' data-id='L_A_B_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_B_C_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_C_D_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_D_E_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_E_F_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_E_G_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_E_H_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g></g><g class='nodes'><g class='node default' id='mermaid-dark-3-flowchart-A-0' data-look='classic' transform='translate(212.859375%2c 35)'><rect class='basic label-container' style='' x='-65.1328125' y='-27' width='130.265625' height='54'/><g class='label' style='' transform='translate(-35.1328125%2c -12)'><rect/><foreignObject width='70.265625' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>API Layer</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-dark-3-flowchart-B-1' data-look='classic' transform='translate(212.859375%2c 139)'><rect class='basic label-container' style='' x='-74.4609375' y='-27' width='148.921875' height='54'/><g class='label' style='' transform='translate(-44.4609375%2c -12)'><rect/><foreignObject width='88.921875' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>LLM Service</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-dark-3-flowchart-C-3' data-look='classic' transform='translate(212.859375%2c 243)'><rect class='basic label-container' style='' x='-76.2421875' y='-27' width='152.484375' height='54'/><g class='label' style='' transform='translate(-46.2421875%2c -12)'><rect/><foreignObject width='92.484375' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>Tool Registry</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-dark-3-flowchart-D-5' data-look='classic' transform='translate(212.859375%2c 347)'><rect class='basic label-container' style='' x='-78.46875' y='-27' width='156.9375' height='54'/><g class='label' style='' transform='translate(-48.46875%2c -12)'><rect/><foreignObject width='96.9375' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>Tool Executor</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-dark-3-flowchart-E-7' data-look='classic' transform='translate(212.859375%2c 451)'><rect class='basic label-container' style='' x='-91.359375' y='-27' width='182.71875' height='54'/><g class='label' style='' transform='translate(-61.359375%2c -12)'><rect/><foreignObject width='122.71875' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>Business Service</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-dark-3-flowchart-F-9' data-look='classic' transform='translate(49.75%2c 562.5179862976074)'><path d='M0%2c10.011990407673862 a41.75%2c10.011990407673862 0%2c0%2c0 83.5%2c0 a41.75%2c10.011990407673862 0%2c0%2c0 -83.5%2c0 l0%2c49.01199040767386 a41.75%2c10.011990407673862 0%2c0%2c0 83.5%2c0 l0%2c-49.01199040767386' class='basic label-container outer-path' style='' transform='translate(-41.75%2c -34.517985611510795)'/><g class='label' style='' transform='translate(-34.25%2c -2)'><rect/><foreignObject width='68.5' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>Database</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-dark-3-flowchart-G-11' data-look='classic' transform='translate(212.859375%2c 562.5179862976074)'><rect class='basic label-container' style='' x='-71.359375' y='-27' width='142.71875' height='54'/><g class='label' style='' transform='translate(-41.359375%2c -12)'><rect/><foreignObject width='82.71875' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>Internal API</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-dark-3-flowchart-H-13' data-look='classic' transform='translate(431.796875%2c 562.5179862976074)'><rect class='basic label-container' style='' x='-97.578125' y='-27' width='195.15625' height='54'/><g class='label' style='' transform='translate(-67.578125%2c -12)'><rect/><foreignObject width='135.15625' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>Third-party Service</p></span></div></foreignObject></g></g></g></g></g><defs><filter id='mermaid-dark-3-drop-shadow' height='130%' width='130%'><feDropShadow dx='4' dy='4' stdDeviation='0' flood-opacity='0.06' flood-color='white'/></filter></defs><defs><filter id='mermaid-dark-3-drop-shadow-small' height='150%' width='150%'><feDropShadow dx='2' dy='2' stdDeviation='0' flood-opacity='0.06' flood-color='white'/></filter></defs><linearGradient id='mermaid-dark-3-gradient' gradientUnits='objectBoundingBox' x1='0%' y1='0%' x2='100%' y2='0%'><stop offset='0%' stop-color='%23cccccc' stop-opacity='1'/><stop offset='100%' stop-color='hsl(180%2c 0%%2c 18.3529411765%)' stop-opacity='1'/></linearGradient></svg>)
各层职责如下:
- API Layer:接收用户请求并建立用户上下文;
- LLM Service:负责模型请求、上下文和执行循环;
- Tool Registry:定义当前场景允许模型看到的工具;
- Tool Executor:解析调用、校验参数、处理错误和记录审计;
- Business Service:执行真实业务规则;
- External System:数据库、微服务和第三方 API。
模型不会直接进入数据库层,只能通过经过控制的 Tool Adapter 使用业务能力。
推荐的项目结构
project/
├── api/
│   └── assistant.py
├── llm/
│   ├── client.py
│   └── tool_loop.py
├── tools/
│   ├── definitions.py
│   ├── registry.py
│   ├── executor.py
│   └── order_tools.py
├── services/
│   └── order_service.py
├── models/
│   └── tool_models.py
└── main.py
Tool 函数应尽量保持轻量,更像 AI 层到业务层的 Adapter:
def get_order(order_id: str) -> dict:
    return order_service.get_order(order_id)
复杂业务规则仍然属于 Service,而不是 Tool Definition 或提示词。
内置工具、自定义函数与 MCP
Responses API 的工具能力不只包括自定义 Function。不同工具适合不同需求:
| 工具类型 | 适合场景 |
|---|---|
| 自定义 Function | 调用自己的业务服务和内部逻辑 |
| Web Search | 获取实时网络信息 |
| File Search | 检索文件和知识资料 |
| MCP | 通过标准协议接入外部工具或系统 |
无论工具由谁提供,应用都应根据数据敏感度和操作风险设计权限与确认机制。
与 Structured Outputs 和 Agent 的关系
Function Calling 和 Structured Outputs 都使用 Schema,但约束对象不同:
| 能力 | Structured Outputs | Function Calling |
|---|---|---|
| 主要目标 | 返回结构化数据 | 调用程序能力 |
| Schema 描述 | 模型最终输出 | 工具输入参数 |
| 是否执行函数 | 否 | 由应用程序执行 |
| 常见用途 | 分类、抽取、分析 | 查询、操作、系统集成 |
| 是否通常需要多轮请求 | 不一定 | 通常需要 |
可以简单理解为:
- Structured Outputs 解决“模型最终应该返回什么”;
- Function Calling 解决“模型接下来应该调用什么”。
两者也可以组合:模型先调用工具取得真实数据,再用 Structured Outputs 返回稳定的最终对象。
%3btext-align:center%3b}%23mermaid-4 .edgeLabel p{background-color:rgba(232%2c232%2c232%2c 0.8)%3b}%23mermaid-4 .edgeLabel rect{opacity:0.5%3bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bfill:rgba(232%2c232%2c232%2c 0.8)%3b}%23mermaid-4 .labelBkg{background-color:rgba(232%2c 232%2c 232%2c 0.5)%3b}%23mermaid-4 .cluster rect{fill:%23ffffde%3bstroke:%23aaaa33%3bstroke-width:1px%3b}%23mermaid-4 .cluster text{fill:%23333%3b}%23mermaid-4 .cluster span{color:%23333%3b}%23mermaid-4 .node .collapsed-indicator{fill:%23aaaa33%3bstroke:none%3bopacity:0.6%3b}%23mermaid-4 .node .collapsed-separator{stroke:%23aaaa33%3bstroke-width:0.75px%3b}%23mermaid-4 div.mermaidTooltip{position:absolute%3btext-align:center%3bmax-width:200px%3bpadding:2px%3bfont-family:arial%2csans-serif%3bfont-size:12px%3bbackground:hsl(80%2c 100%%2c 96.2745098039%)%3bborder:1px solid %23aaaa33%3bborder-radius:2px%3bpointer-events:none%3bz-index:100%3b}%23mermaid-4 .flowchartTitleText{text-anchor:middle%3bfont-size:18px%3bfill:%23333%3b}%23mermaid-4 rect.text{fill:none%3bstroke-width:0%3b}%23mermaid-4 .icon-shape%2c%23mermaid-4 .image-shape{background-color:rgba(232%2c232%2c232%2c 0.8)%3btext-align:center%3b}%23mermaid-4 .icon-shape p%2c%23mermaid-4 .image-shape p{background-color:rgba(232%2c232%2c232%2c 0.8)%3bpadding:2px%3b}%23mermaid-4 .icon-shape .label rect%2c%23mermaid-4 .image-shape .label rect{opacity:0.5%3bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bfill:rgba(232%2c232%2c232%2c 0.8)%3b}%23mermaid-4 .label-icon{display:inline-block%3bheight:1em%3boverflow:visible%3bvertical-align:-0.125em%3b}%23mermaid-4 .node .label-icon path{fill:currentColor%3bstroke:revert%3bstroke-width:revert%3b}%23mermaid-4 .node .neo-node{stroke:%239370DB%3b}%23mermaid-4 [data-look='neo'].node rect%2c%23mermaid-4 [data-look='neo'].cluster rect%2c%23mermaid-4 [data-look='neo'].node polygon{stroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b}%23mermaid-4 [data-look='neo'].swimlane.cluster rect{filter:none%3b}%23mermaid-4 [data-look='neo'].node path{stroke:%239370DB%3bstroke-width:1px%3b}%23mermaid-4 [data-look='neo'].node .outer-path{filter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b}%23mermaid-4 [data-look='neo'].node .neo-line path{stroke:%239370DB%3bfilter:none%3b}%23mermaid-4 [data-look='neo'].node circle{stroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b}%23mermaid-4 [data-look='neo'].node circle .state-start{fill:black%3b}%23mermaid-4 [data-look='neo'].icon-shape .icon{fill:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b}%23mermaid-4 [data-look='neo'].icon-shape .icon-neo path{stroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b}%23mermaid-4 :root{--mermaid-font-family:arial%2csans-serif%3b}</style><g><marker id='mermaid-4_flowchart-v2-pointEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'><path d='M 0 0 L 10 5 L 0 10 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-4_flowchart-v2-pointStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='4.5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'><path d='M 0 5 L 10 10 L 10 0 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-4_flowchart-v2-pointEnd-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='11.5' refY='7' markerUnits='userSpaceOnUse' markerWidth='10.5' markerHeight='14' orient='auto'><path d='M 0 0 L 11.5 7 L 0 14 z' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-4_flowchart-v2-pointStart-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='1' refY='7' markerUnits='userSpaceOnUse' markerWidth='11.5' markerHeight='14' orient='auto'><polygon points='0%2c7 11.5%2c14 11.5%2c0' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-4_flowchart-v2-circleEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='11' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-4_flowchart-v2-circleStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-1' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-4_flowchart-v2-circleEnd-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refY='5' refX='12.25' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-4_flowchart-v2-circleStart-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-2' refY='5' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-4_flowchart-v2-crossEnd' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='12' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><path d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-4_flowchart-v2-crossStart' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='-1' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><path d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-4_flowchart-v2-crossEnd-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='17.7' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'><path d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b'/></marker><marker id='mermaid-4_flowchart-v2-crossStart-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='-3.5' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'><path d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b stroke-dasharray: 1%2c 0%3b'/></marker><g class='root'><g class='clusters'/><g class='edgePaths'><path d='M116%2c35L120.167%2c35C124.333%2c35%2c132.667%2c35%2c140.333%2c35C148%2c35%2c155%2c35%2c158.5%2c35L162%2c35' id='mermaid-4-L_A_B_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_A_B_0' data-points='W3sieCI6MTE2LCJ5IjozNX0seyJ4IjoxNDEsInkiOjM1fSx7IngiOjE2NiwieSI6MzV9XQ==' data-look='classic' marker-end='url(%23mermaid-4_flowchart-v2-pointEnd)'/><path d='M298%2c35L302.167%2c35C306.333%2c35%2c314.667%2c35%2c322.333%2c35C330%2c35%2c337%2c35%2c340.5%2c35L344%2c35' id='mermaid-4-L_B_C_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_B_C_0' data-points='W3sieCI6Mjk4LCJ5IjozNX0seyJ4IjozMjMsInkiOjM1fSx7IngiOjM0OCwieSI6MzV9XQ==' data-look='classic' marker-end='url(%23mermaid-4_flowchart-v2-pointEnd)'/><path d='M480%2c35L484.167%2c35C488.333%2c35%2c496.667%2c35%2c504.333%2c35C512%2c35%2c519%2c35%2c522.5%2c35L526%2c35' id='mermaid-4-L_C_D_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_C_D_0' data-points='W3sieCI6NDgwLCJ5IjozNX0seyJ4Ijo1MDUsInkiOjM1fSx7IngiOjUzMCwieSI6MzV9XQ==' data-look='classic' marker-end='url(%23mermaid-4_flowchart-v2-pointEnd)'/><path d='M662%2c35L666.167%2c35C670.333%2c35%2c678.667%2c35%2c686.333%2c35C694%2c35%2c701%2c35%2c704.5%2c35L708%2c35' id='mermaid-4-L_D_E_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_D_E_0' data-points='W3sieCI6NjYyLCJ5IjozNX0seyJ4Ijo2ODcsInkiOjM1fSx7IngiOjcxMiwieSI6MzV9XQ==' data-look='classic' marker-end='url(%23mermaid-4_flowchart-v2-pointEnd)'/><path d='M906.297%2c35L910.464%2c35C914.63%2c35%2c922.964%2c35%2c930.63%2c35C938.297%2c35%2c945.297%2c35%2c948.797%2c35L952.297%2c35' id='mermaid-4-L_E_F_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_E_F_0' data-points='W3sieCI6OTA2LjI5Njg3NSwieSI6MzV9LHsieCI6OTMxLjI5Njg3NSwieSI6MzV9LHsieCI6OTU2LjI5Njg3NSwieSI6MzV9XQ==' data-look='classic' marker-end='url(%23mermaid-4_flowchart-v2-pointEnd)'/></g><g class='edgeLabels'><g class='edgeLabel'><g class='label' data-id='L_A_B_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_B_C_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_C_D_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_D_E_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_E_F_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g></g><g class='nodes'><g class='node default' id='mermaid-4-flowchart-A-0' data-look='classic' transform='translate(62%2c 35)'><rect class='basic label-container' style='' x='-54' y='-27' width='108' height='54'/><g class='label' style='' transform='translate(-24%2c -12)'><rect/><foreignObject width='48' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>用户请求</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-4-flowchart-B-1' data-look='classic' transform='translate(232%2c 35)'><rect class='basic label-container' style='' x='-66' y='-27' width='132' height='54'/><g class='label' style='' transform='translate(-36%2c -12)'><rect/><foreignObject width='72' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>模型选择工具</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-4-flowchart-C-3' data-look='classic' transform='translate(414%2c 35)'><rect class='basic label-container' style='' x='-66' y='-27' width='132' height='54'/><g class='label' style='' transform='translate(-36%2c -12)'><rect/><foreignObject width='72' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>应用执行工具</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-4-flowchart-D-5' data-look='classic' transform='translate(596%2c 35)'><rect class='basic label-container' style='' x='-66' y='-27' width='132' height='54'/><g class='label' style='' transform='translate(-36%2c -12)'><rect/><foreignObject width='72' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>获得真实数据</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-4-flowchart-E-7' data-look='classic' transform='translate(809.1484375%2c 35)'><rect class='basic label-container' style='' x='-97.1484375' y='-27' width='194.296875' height='54'/><g class='label' style='' transform='translate(-67.1484375%2c -12)'><rect/><foreignObject width='134.296875' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>Structured Outputs</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-4-flowchart-F-9' data-look='classic' transform='translate(1046.296875%2c 35)'><rect class='basic label-container' style='' x='-90' y='-27' width='180' height='54'/><g class='label' style='' transform='translate(-60%2c -12)'><rect/><foreignObject width='120' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>业务可消费的类型对象</p></span></div></foreignObject></g></g></g></g></g><defs><filter id='mermaid-4-drop-shadow' height='130%' width='130%'><feDropShadow dx='4' dy='4' stdDeviation='0' flood-opacity='0.06' flood-color='black'/></filter></defs><defs><filter id='mermaid-4-drop-shadow-small' height='150%' width='150%'><feDropShadow dx='2' dy='2' stdDeviation='0' flood-opacity='0.06' flood-color='black'/></filter></defs></svg>)
%3btext-align:center%3b}%23mermaid-dark-4 .edgeLabel p{background-color:hsl(0%2c 0%%2c 34.4117647059%)%3b}%23mermaid-dark-4 .edgeLabel rect{opacity:0.5%3bbackground-color:hsl(0%2c 0%%2c 34.4117647059%)%3bfill:hsl(0%2c 0%%2c 34.4117647059%)%3b}%23mermaid-dark-4 .labelBkg{background-color:rgba(87.75%2c 87.75%2c 87.75%2c 0.5)%3b}%23mermaid-dark-4 .cluster rect{fill:hsl(180%2c 1.5873015873%%2c 28.3529411765%)%3bstroke:rgba(255%2c 255%2c 255%2c 0.25)%3bstroke-width:1px%3b}%23mermaid-dark-4 .cluster text{fill:%23F9FFFE%3b}%23mermaid-dark-4 .cluster span{color:%23F9FFFE%3b}%23mermaid-dark-4 .node .collapsed-indicator{fill:rgba(255%2c 255%2c 255%2c 0.25)%3bstroke:none%3bopacity:0.6%3b}%23mermaid-dark-4 .node .collapsed-separator{stroke:rgba(255%2c 255%2c 255%2c 0.25)%3bstroke-width:0.75px%3b}%23mermaid-dark-4 div.mermaidTooltip{position:absolute%3btext-align:center%3bmax-width:200px%3bpadding:2px%3bfont-family:arial%2csans-serif%3bfont-size:12px%3bbackground:hsl(20%2c 1.5873015873%%2c 12.3529411765%)%3bborder:1px solid rgba(255%2c 255%2c 255%2c 0.25)%3bborder-radius:2px%3bpointer-events:none%3bz-index:100%3b}%23mermaid-dark-4 .flowchartTitleText{text-anchor:middle%3bfont-size:18px%3bfill:%23ccc%3b}%23mermaid-dark-4 rect.text{fill:none%3bstroke-width:0%3b}%23mermaid-dark-4 .icon-shape%2c%23mermaid-dark-4 .image-shape{background-color:hsl(0%2c 0%%2c 34.4117647059%)%3btext-align:center%3b}%23mermaid-dark-4 .icon-shape p%2c%23mermaid-dark-4 .image-shape p{background-color:hsl(0%2c 0%%2c 34.4117647059%)%3bpadding:2px%3b}%23mermaid-dark-4 .icon-shape .label rect%2c%23mermaid-dark-4 .image-shape .label rect{opacity:0.5%3bbackground-color:hsl(0%2c 0%%2c 34.4117647059%)%3bfill:hsl(0%2c 0%%2c 34.4117647059%)%3b}%23mermaid-dark-4 .label-icon{display:inline-block%3bheight:1em%3boverflow:visible%3bvertical-align:-0.125em%3b}%23mermaid-dark-4 .node .label-icon path{fill:currentColor%3bstroke:revert%3bstroke-width:revert%3b}%23mermaid-dark-4 .node .neo-node{stroke:%23ccc%3b}%23mermaid-dark-4 [data-look='neo'].node rect%2c%23mermaid-dark-4 [data-look='neo'].cluster rect%2c%23mermaid-dark-4 [data-look='neo'].node polygon{stroke:url(%23mermaid-dark-4-gradient)%3bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b}%23mermaid-dark-4 [data-look='neo'].swimlane.cluster rect{filter:none%3b}%23mermaid-dark-4 [data-look='neo'].node path{stroke:url(%23mermaid-dark-4-gradient)%3bstroke-width:1px%3b}%23mermaid-dark-4 [data-look='neo'].node .outer-path{filter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b}%23mermaid-dark-4 [data-look='neo'].node .neo-line path{stroke:%23ccc%3bfilter:none%3b}%23mermaid-dark-4 [data-look='neo'].node circle{stroke:url(%23mermaid-dark-4-gradient)%3bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b}%23mermaid-dark-4 [data-look='neo'].node circle .state-start{fill:black%3b}%23mermaid-dark-4 [data-look='neo'].icon-shape .icon{fill:url(%23mermaid-dark-4-gradient)%3bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b}%23mermaid-dark-4 [data-look='neo'].icon-shape .icon-neo path{stroke:url(%23mermaid-dark-4-gradient)%3bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b}%23mermaid-dark-4 :root{--mermaid-font-family:arial%2csans-serif%3b}</style><g><marker id='mermaid-dark-4_flowchart-v2-pointEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'><path d='M 0 0 L 10 5 L 0 10 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-4_flowchart-v2-pointStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='4.5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'><path d='M 0 5 L 10 10 L 10 0 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-4_flowchart-v2-pointEnd-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='11.5' refY='7' markerUnits='userSpaceOnUse' markerWidth='10.5' markerHeight='14' orient='auto'><path d='M 0 0 L 11.5 7 L 0 14 z' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-4_flowchart-v2-pointStart-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='1' refY='7' markerUnits='userSpaceOnUse' markerWidth='11.5' markerHeight='14' orient='auto'><polygon points='0%2c7 11.5%2c14 11.5%2c0' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-4_flowchart-v2-circleEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='11' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-4_flowchart-v2-circleStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-1' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-4_flowchart-v2-circleEnd-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refY='5' refX='12.25' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-4_flowchart-v2-circleStart-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-2' refY='5' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-4_flowchart-v2-crossEnd' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='12' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><path d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-4_flowchart-v2-crossStart' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='-1' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><path d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-4_flowchart-v2-crossEnd-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='17.7' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'><path d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b'/></marker><marker id='mermaid-dark-4_flowchart-v2-crossStart-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='-3.5' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'><path d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b stroke-dasharray: 1%2c 0%3b'/></marker><g class='root'><g class='clusters'/><g class='edgePaths'><path d='M116%2c35L120.167%2c35C124.333%2c35%2c132.667%2c35%2c140.333%2c35C148%2c35%2c155%2c35%2c158.5%2c35L162%2c35' id='mermaid-dark-4-L_A_B_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_A_B_0' data-points='W3sieCI6MTE2LCJ5IjozNX0seyJ4IjoxNDEsInkiOjM1fSx7IngiOjE2NiwieSI6MzV9XQ==' data-look='classic' marker-end='url(%23mermaid-dark-4_flowchart-v2-pointEnd)'/><path d='M298%2c35L302.167%2c35C306.333%2c35%2c314.667%2c35%2c322.333%2c35C330%2c35%2c337%2c35%2c340.5%2c35L344%2c35' id='mermaid-dark-4-L_B_C_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_B_C_0' data-points='W3sieCI6Mjk4LCJ5IjozNX0seyJ4IjozMjMsInkiOjM1fSx7IngiOjM0OCwieSI6MzV9XQ==' data-look='classic' marker-end='url(%23mermaid-dark-4_flowchart-v2-pointEnd)'/><path d='M480%2c35L484.167%2c35C488.333%2c35%2c496.667%2c35%2c504.333%2c35C512%2c35%2c519%2c35%2c522.5%2c35L526%2c35' id='mermaid-dark-4-L_C_D_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_C_D_0' data-points='W3sieCI6NDgwLCJ5IjozNX0seyJ4Ijo1MDUsInkiOjM1fSx7IngiOjUzMCwieSI6MzV9XQ==' data-look='classic' marker-end='url(%23mermaid-dark-4_flowchart-v2-pointEnd)'/><path d='M662%2c35L666.167%2c35C670.333%2c35%2c678.667%2c35%2c686.333%2c35C694%2c35%2c701%2c35%2c704.5%2c35L708%2c35' id='mermaid-dark-4-L_D_E_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_D_E_0' data-points='W3sieCI6NjYyLCJ5IjozNX0seyJ4Ijo2ODcsInkiOjM1fSx7IngiOjcxMiwieSI6MzV9XQ==' data-look='classic' marker-end='url(%23mermaid-dark-4_flowchart-v2-pointEnd)'/><path d='M906.297%2c35L910.464%2c35C914.63%2c35%2c922.964%2c35%2c930.63%2c35C938.297%2c35%2c945.297%2c35%2c948.797%2c35L952.297%2c35' id='mermaid-dark-4-L_E_F_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_E_F_0' data-points='W3sieCI6OTA2LjI5Njg3NSwieSI6MzV9LHsieCI6OTMxLjI5Njg3NSwieSI6MzV9LHsieCI6OTU2LjI5Njg3NSwieSI6MzV9XQ==' data-look='classic' marker-end='url(%23mermaid-dark-4_flowchart-v2-pointEnd)'/></g><g class='edgeLabels'><g class='edgeLabel'><g class='label' data-id='L_A_B_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_B_C_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_C_D_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_D_E_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_E_F_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g></g><g class='nodes'><g class='node default' id='mermaid-dark-4-flowchart-A-0' data-look='classic' transform='translate(62%2c 35)'><rect class='basic label-container' style='' x='-54' y='-27' width='108' height='54'/><g class='label' style='' transform='translate(-24%2c -12)'><rect/><foreignObject width='48' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>用户请求</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-dark-4-flowchart-B-1' data-look='classic' transform='translate(232%2c 35)'><rect class='basic label-container' style='' x='-66' y='-27' width='132' height='54'/><g class='label' style='' transform='translate(-36%2c -12)'><rect/><foreignObject width='72' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>模型选择工具</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-dark-4-flowchart-C-3' data-look='classic' transform='translate(414%2c 35)'><rect class='basic label-container' style='' x='-66' y='-27' width='132' height='54'/><g class='label' style='' transform='translate(-36%2c -12)'><rect/><foreignObject width='72' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>应用执行工具</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-dark-4-flowchart-D-5' data-look='classic' transform='translate(596%2c 35)'><rect class='basic label-container' style='' x='-66' y='-27' width='132' height='54'/><g class='label' style='' transform='translate(-36%2c -12)'><rect/><foreignObject width='72' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>获得真实数据</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-dark-4-flowchart-E-7' data-look='classic' transform='translate(809.1484375%2c 35)'><rect class='basic label-container' style='' x='-97.1484375' y='-27' width='194.296875' height='54'/><g class='label' style='' transform='translate(-67.1484375%2c -12)'><rect/><foreignObject width='134.296875' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>Structured Outputs</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-dark-4-flowchart-F-9' data-look='classic' transform='translate(1046.296875%2c 35)'><rect class='basic label-container' style='' x='-90' y='-27' width='180' height='54'/><g class='label' style='' transform='translate(-60%2c -12)'><rect/><foreignObject width='120' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>业务可消费的类型对象</p></span></div></foreignObject></g></g></g></g></g><defs><filter id='mermaid-dark-4-drop-shadow' height='130%' width='130%'><feDropShadow dx='4' dy='4' stdDeviation='0' flood-opacity='0.06' flood-color='white'/></filter></defs><defs><filter id='mermaid-dark-4-drop-shadow-small' height='150%' width='150%'><feDropShadow dx='2' dy='2' stdDeviation='0' flood-opacity='0.06' flood-color='white'/></filter></defs><linearGradient id='mermaid-dark-4-gradient' gradientUnits='objectBoundingBox' x1='0%' y1='0%' x2='100%' y2='0%'><stop offset='0%' stop-color='%23cccccc' stop-opacity='1'/><stop offset='100%' stop-color='hsl(180%2c 0%%2c 18.3529411765%)' stop-opacity='1'/></linearGradient></svg>)
当系统允许模型围绕目标不断选择工具、查看结果、重新规划并继续执行时,就逐渐形成 Agent:
LLM
+ Tool Calling
+ Context
+ State
+ Execution Loop
+ Termination Condition
Function Calling 是 Agent 的基础能力之一,但一个安全的 Agent 还必须有最大步数、超时、费用限制、状态管理、权限边界和终止条件。
总结
Function Calling 并不是让 OpenAI 服务器执行本地 Python 函数,而是把用户的自然语言需求转换成应用程序可以识别的结构化工具请求。
一个完整系统包含:
%3btext-align:center%3b}%23mermaid-5 .edgeLabel p{background-color:rgba(232%2c232%2c232%2c 0.8)%3b}%23mermaid-5 .edgeLabel rect{opacity:0.5%3bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bfill:rgba(232%2c232%2c232%2c 0.8)%3b}%23mermaid-5 .labelBkg{background-color:rgba(232%2c 232%2c 232%2c 0.5)%3b}%23mermaid-5 .cluster rect{fill:%23ffffde%3bstroke:%23aaaa33%3bstroke-width:1px%3b}%23mermaid-5 .cluster text{fill:%23333%3b}%23mermaid-5 .cluster span{color:%23333%3b}%23mermaid-5 .node .collapsed-indicator{fill:%23aaaa33%3bstroke:none%3bopacity:0.6%3b}%23mermaid-5 .node .collapsed-separator{stroke:%23aaaa33%3bstroke-width:0.75px%3b}%23mermaid-5 div.mermaidTooltip{position:absolute%3btext-align:center%3bmax-width:200px%3bpadding:2px%3bfont-family:arial%2csans-serif%3bfont-size:12px%3bbackground:hsl(80%2c 100%%2c 96.2745098039%)%3bborder:1px solid %23aaaa33%3bborder-radius:2px%3bpointer-events:none%3bz-index:100%3b}%23mermaid-5 .flowchartTitleText{text-anchor:middle%3bfont-size:18px%3bfill:%23333%3b}%23mermaid-5 rect.text{fill:none%3bstroke-width:0%3b}%23mermaid-5 .icon-shape%2c%23mermaid-5 .image-shape{background-color:rgba(232%2c232%2c232%2c 0.8)%3btext-align:center%3b}%23mermaid-5 .icon-shape p%2c%23mermaid-5 .image-shape p{background-color:rgba(232%2c232%2c232%2c 0.8)%3bpadding:2px%3b}%23mermaid-5 .icon-shape .label rect%2c%23mermaid-5 .image-shape .label rect{opacity:0.5%3bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bfill:rgba(232%2c232%2c232%2c 0.8)%3b}%23mermaid-5 .label-icon{display:inline-block%3bheight:1em%3boverflow:visible%3bvertical-align:-0.125em%3b}%23mermaid-5 .node .label-icon path{fill:currentColor%3bstroke:revert%3bstroke-width:revert%3b}%23mermaid-5 .node .neo-node{stroke:%239370DB%3b}%23mermaid-5 [data-look='neo'].node rect%2c%23mermaid-5 [data-look='neo'].cluster rect%2c%23mermaid-5 [data-look='neo'].node polygon{stroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b}%23mermaid-5 [data-look='neo'].swimlane.cluster rect{filter:none%3b}%23mermaid-5 [data-look='neo'].node path{stroke:%239370DB%3bstroke-width:1px%3b}%23mermaid-5 [data-look='neo'].node .outer-path{filter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b}%23mermaid-5 [data-look='neo'].node .neo-line path{stroke:%239370DB%3bfilter:none%3b}%23mermaid-5 [data-look='neo'].node circle{stroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b}%23mermaid-5 [data-look='neo'].node circle .state-start{fill:black%3b}%23mermaid-5 [data-look='neo'].icon-shape .icon{fill:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b}%23mermaid-5 [data-look='neo'].icon-shape .icon-neo path{stroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b}%23mermaid-5 :root{--mermaid-font-family:arial%2csans-serif%3b}</style><g><marker id='mermaid-5_flowchart-v2-pointEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'><path d='M 0 0 L 10 5 L 0 10 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-5_flowchart-v2-pointStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='4.5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'><path d='M 0 5 L 10 10 L 10 0 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-5_flowchart-v2-pointEnd-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='11.5' refY='7' markerUnits='userSpaceOnUse' markerWidth='10.5' markerHeight='14' orient='auto'><path d='M 0 0 L 11.5 7 L 0 14 z' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-5_flowchart-v2-pointStart-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='1' refY='7' markerUnits='userSpaceOnUse' markerWidth='11.5' markerHeight='14' orient='auto'><polygon points='0%2c7 11.5%2c14 11.5%2c0' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-5_flowchart-v2-circleEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='11' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-5_flowchart-v2-circleStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-1' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-5_flowchart-v2-circleEnd-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refY='5' refX='12.25' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-5_flowchart-v2-circleStart-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-2' refY='5' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-5_flowchart-v2-crossEnd' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='12' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><path d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-5_flowchart-v2-crossStart' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='-1' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><path d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-5_flowchart-v2-crossEnd-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='17.7' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'><path d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b'/></marker><marker id='mermaid-5_flowchart-v2-crossStart-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='-3.5' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'><path d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b stroke-dasharray: 1%2c 0%3b'/></marker><g class='root'><g class='clusters'/><g class='edgePaths'><path d='M168.5%2c35L172.667%2c35C176.833%2c35%2c185.167%2c35%2c192.833%2c35C200.5%2c35%2c207.5%2c35%2c211%2c35L214.5%2c35' id='mermaid-5-L_A_B_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_A_B_0' data-points='W3sieCI6MTY4LjUsInkiOjM1fSx7IngiOjE5My41LCJ5IjozNX0seyJ4IjoyMTguNSwieSI6MzV9XQ==' data-look='classic' marker-end='url(%23mermaid-5_flowchart-v2-pointEnd)'/><path d='M378.125%2c35L382.292%2c35C386.458%2c35%2c394.792%2c35%2c402.458%2c35C410.125%2c35%2c417.125%2c35%2c420.625%2c35L424.125%2c35' id='mermaid-5-L_B_C_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_B_C_0' data-points='W3sieCI6Mzc4LjEyNSwieSI6MzV9LHsieCI6NDAzLjEyNSwieSI6MzV9LHsieCI6NDI4LjEyNSwieSI6MzV9XQ==' data-look='classic' marker-end='url(%23mermaid-5_flowchart-v2-pointEnd)'/><path d='M641.109%2c35L645.276%2c35C649.443%2c35%2c657.776%2c35%2c665.443%2c35C673.109%2c35%2c680.109%2c35%2c683.609%2c35L687.109%2c35' id='mermaid-5-L_C_D_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_C_D_0' data-points='W3sieCI6NjQxLjEwOTM3NSwieSI6MzV9LHsieCI6NjY2LjEwOTM3NSwieSI6MzV9LHsieCI6NjkxLjEwOTM3NSwieSI6MzV9XQ==' data-look='classic' marker-end='url(%23mermaid-5_flowchart-v2-pointEnd)'/><path d='M932.266%2c35L936.432%2c35C940.599%2c35%2c948.932%2c35%2c956.599%2c35C964.266%2c35%2c971.266%2c35%2c974.766%2c35L978.266%2c35' id='mermaid-5-L_D_E_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_D_E_0' data-points='W3sieCI6OTMyLjI2NTYyNSwieSI6MzV9LHsieCI6OTU3LjI2NTYyNSwieSI6MzV9LHsieCI6OTgyLjI2NTYyNSwieSI6MzV9XQ==' data-look='classic' marker-end='url(%23mermaid-5_flowchart-v2-pointEnd)'/><path d='M1146.328%2c35L1150.495%2c35C1154.661%2c35%2c1162.995%2c35%2c1170.661%2c35C1178.328%2c35%2c1185.328%2c35%2c1188.828%2c35L1192.328%2c35' id='mermaid-5-L_E_F_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_E_F_0' data-points='W3sieCI6MTE0Ni4zMjgxMjUsInkiOjM1fSx7IngiOjExNzEuMzI4MTI1LCJ5IjozNX0seyJ4IjoxMTk2LjMyODEyNSwieSI6MzV9XQ==' data-look='classic' marker-end='url(%23mermaid-5_flowchart-v2-pointEnd)'/><path d='M1338.156%2c35L1342.323%2c35C1346.49%2c35%2c1354.823%2c35%2c1362.49%2c35C1370.156%2c35%2c1377.156%2c35%2c1380.656%2c35L1384.156%2c35' id='mermaid-5-L_F_G_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_F_G_0' data-points='W3sieCI6MTMzOC4xNTYyNSwieSI6MzV9LHsieCI6MTM2My4xNTYyNSwieSI6MzV9LHsieCI6MTM4OC4xNTYyNSwieSI6MzV9XQ==' data-look='classic' marker-end='url(%23mermaid-5_flowchart-v2-pointEnd)'/></g><g class='edgeLabels'><g class='edgeLabel'><g class='label' data-id='L_A_B_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_B_C_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_C_D_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_D_E_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_E_F_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_F_G_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g></g><g class='nodes'><g class='node default' id='mermaid-5-flowchart-A-0' data-look='classic' transform='translate(88.25%2c 35)'><rect class='basic label-container' style='' x='-80.25' y='-27' width='160.5' height='54'/><g class='label' style='' transform='translate(-50.25%2c -12)'><rect/><foreignObject width='100.5' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>Tool Definition</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-5-flowchart-B-1' data-look='classic' transform='translate(298.3125%2c 35)'><rect class='basic label-container' style='' x='-79.8125' y='-27' width='159.625' height='54'/><g class='label' style='' transform='translate(-49.8125%2c -12)'><rect/><foreignObject width='99.625' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>Tool Selection</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-5-flowchart-C-3' data-look='classic' transform='translate(534.6171875%2c 35)'><rect class='basic label-container' style='' x='-106.4921875' y='-27' width='212.984375' height='54'/><g class='label' style='' transform='translate(-76.4921875%2c -12)'><rect/><foreignObject width='152.984375' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>Argument Generation</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-5-flowchart-D-5' data-look='classic' transform='translate(811.6875%2c 35)'><rect class='basic label-container' style='' x='-120.578125' y='-27' width='241.15625' height='54'/><g class='label' style='' transform='translate(-90.578125%2c -12)'><rect/><foreignObject width='181.15625' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>Validation %26amp%3b Authorization</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-5-flowchart-E-7' data-look='classic' transform='translate(1064.296875%2c 35)'><rect class='basic label-container' style='' x='-82.03125' y='-27' width='164.0625' height='54'/><g class='label' style='' transform='translate(-52.03125%2c -12)'><rect/><foreignObject width='104.0625' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>Tool Execution</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-5-flowchart-F-9' data-look='classic' transform='translate(1267.2421875%2c 35)'><rect class='basic label-container' style='' x='-70.9140625' y='-27' width='141.828125' height='54'/><g class='label' style='' transform='translate(-40.9140625%2c -12)'><rect/><foreignObject width='81.828125' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>Tool Output</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-5-flowchart-G-11' data-look='classic' transform='translate(1473.7421875%2c 35)'><rect class='basic label-container' style='' x='-85.5859375' y='-27' width='171.171875' height='54'/><g class='label' style='' transform='translate(-55.5859375%2c -12)'><rect/><foreignObject width='111.171875' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>Final Response</p></span></div></foreignObject></g></g></g></g></g><defs><filter id='mermaid-5-drop-shadow' height='130%' width='130%'><feDropShadow dx='4' dy='4' stdDeviation='0' flood-opacity='0.06' flood-color='black'/></filter></defs><defs><filter id='mermaid-5-drop-shadow-small' height='150%' width='150%'><feDropShadow dx='2' dy='2' stdDeviation='0' flood-opacity='0.06' flood-color='black'/></filter></defs></svg>)
%3btext-align:center%3b}%23mermaid-dark-5 .edgeLabel p{background-color:hsl(0%2c 0%%2c 34.4117647059%)%3b}%23mermaid-dark-5 .edgeLabel rect{opacity:0.5%3bbackground-color:hsl(0%2c 0%%2c 34.4117647059%)%3bfill:hsl(0%2c 0%%2c 34.4117647059%)%3b}%23mermaid-dark-5 .labelBkg{background-color:rgba(87.75%2c 87.75%2c 87.75%2c 0.5)%3b}%23mermaid-dark-5 .cluster rect{fill:hsl(180%2c 1.5873015873%%2c 28.3529411765%)%3bstroke:rgba(255%2c 255%2c 255%2c 0.25)%3bstroke-width:1px%3b}%23mermaid-dark-5 .cluster text{fill:%23F9FFFE%3b}%23mermaid-dark-5 .cluster span{color:%23F9FFFE%3b}%23mermaid-dark-5 .node .collapsed-indicator{fill:rgba(255%2c 255%2c 255%2c 0.25)%3bstroke:none%3bopacity:0.6%3b}%23mermaid-dark-5 .node .collapsed-separator{stroke:rgba(255%2c 255%2c 255%2c 0.25)%3bstroke-width:0.75px%3b}%23mermaid-dark-5 div.mermaidTooltip{position:absolute%3btext-align:center%3bmax-width:200px%3bpadding:2px%3bfont-family:arial%2csans-serif%3bfont-size:12px%3bbackground:hsl(20%2c 1.5873015873%%2c 12.3529411765%)%3bborder:1px solid rgba(255%2c 255%2c 255%2c 0.25)%3bborder-radius:2px%3bpointer-events:none%3bz-index:100%3b}%23mermaid-dark-5 .flowchartTitleText{text-anchor:middle%3bfont-size:18px%3bfill:%23ccc%3b}%23mermaid-dark-5 rect.text{fill:none%3bstroke-width:0%3b}%23mermaid-dark-5 .icon-shape%2c%23mermaid-dark-5 .image-shape{background-color:hsl(0%2c 0%%2c 34.4117647059%)%3btext-align:center%3b}%23mermaid-dark-5 .icon-shape p%2c%23mermaid-dark-5 .image-shape p{background-color:hsl(0%2c 0%%2c 34.4117647059%)%3bpadding:2px%3b}%23mermaid-dark-5 .icon-shape .label rect%2c%23mermaid-dark-5 .image-shape .label rect{opacity:0.5%3bbackground-color:hsl(0%2c 0%%2c 34.4117647059%)%3bfill:hsl(0%2c 0%%2c 34.4117647059%)%3b}%23mermaid-dark-5 .label-icon{display:inline-block%3bheight:1em%3boverflow:visible%3bvertical-align:-0.125em%3b}%23mermaid-dark-5 .node .label-icon path{fill:currentColor%3bstroke:revert%3bstroke-width:revert%3b}%23mermaid-dark-5 .node .neo-node{stroke:%23ccc%3b}%23mermaid-dark-5 [data-look='neo'].node rect%2c%23mermaid-dark-5 [data-look='neo'].cluster rect%2c%23mermaid-dark-5 [data-look='neo'].node polygon{stroke:url(%23mermaid-dark-5-gradient)%3bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b}%23mermaid-dark-5 [data-look='neo'].swimlane.cluster rect{filter:none%3b}%23mermaid-dark-5 [data-look='neo'].node path{stroke:url(%23mermaid-dark-5-gradient)%3bstroke-width:1px%3b}%23mermaid-dark-5 [data-look='neo'].node .outer-path{filter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b}%23mermaid-dark-5 [data-look='neo'].node .neo-line path{stroke:%23ccc%3bfilter:none%3b}%23mermaid-dark-5 [data-look='neo'].node circle{stroke:url(%23mermaid-dark-5-gradient)%3bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b}%23mermaid-dark-5 [data-look='neo'].node circle .state-start{fill:black%3b}%23mermaid-dark-5 [data-look='neo'].icon-shape .icon{fill:url(%23mermaid-dark-5-gradient)%3bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b}%23mermaid-dark-5 [data-look='neo'].icon-shape .icon-neo path{stroke:url(%23mermaid-dark-5-gradient)%3bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b}%23mermaid-dark-5 :root{--mermaid-font-family:arial%2csans-serif%3b}</style><g><marker id='mermaid-dark-5_flowchart-v2-pointEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'><path d='M 0 0 L 10 5 L 0 10 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-5_flowchart-v2-pointStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='4.5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'><path d='M 0 5 L 10 10 L 10 0 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-5_flowchart-v2-pointEnd-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='11.5' refY='7' markerUnits='userSpaceOnUse' markerWidth='10.5' markerHeight='14' orient='auto'><path d='M 0 0 L 11.5 7 L 0 14 z' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-5_flowchart-v2-pointStart-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='1' refY='7' markerUnits='userSpaceOnUse' markerWidth='11.5' markerHeight='14' orient='auto'><polygon points='0%2c7 11.5%2c14 11.5%2c0' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-5_flowchart-v2-circleEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='11' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-5_flowchart-v2-circleStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-1' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-5_flowchart-v2-circleEnd-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refY='5' refX='12.25' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-5_flowchart-v2-circleStart-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-2' refY='5' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-5_flowchart-v2-crossEnd' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='12' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><path d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-5_flowchart-v2-crossStart' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='-1' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><path d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-5_flowchart-v2-crossEnd-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='17.7' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'><path d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b'/></marker><marker id='mermaid-dark-5_flowchart-v2-crossStart-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='-3.5' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'><path d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b stroke-dasharray: 1%2c 0%3b'/></marker><g class='root'><g class='clusters'/><g class='edgePaths'><path d='M168.5%2c35L172.667%2c35C176.833%2c35%2c185.167%2c35%2c192.833%2c35C200.5%2c35%2c207.5%2c35%2c211%2c35L214.5%2c35' id='mermaid-dark-5-L_A_B_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_A_B_0' data-points='W3sieCI6MTY4LjUsInkiOjM1fSx7IngiOjE5My41LCJ5IjozNX0seyJ4IjoyMTguNSwieSI6MzV9XQ==' data-look='classic' marker-end='url(%23mermaid-dark-5_flowchart-v2-pointEnd)'/><path d='M378.125%2c35L382.292%2c35C386.458%2c35%2c394.792%2c35%2c402.458%2c35C410.125%2c35%2c417.125%2c35%2c420.625%2c35L424.125%2c35' id='mermaid-dark-5-L_B_C_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_B_C_0' data-points='W3sieCI6Mzc4LjEyNSwieSI6MzV9LHsieCI6NDAzLjEyNSwieSI6MzV9LHsieCI6NDI4LjEyNSwieSI6MzV9XQ==' data-look='classic' marker-end='url(%23mermaid-dark-5_flowchart-v2-pointEnd)'/><path d='M641.109%2c35L645.276%2c35C649.443%2c35%2c657.776%2c35%2c665.443%2c35C673.109%2c35%2c680.109%2c35%2c683.609%2c35L687.109%2c35' id='mermaid-dark-5-L_C_D_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_C_D_0' data-points='W3sieCI6NjQxLjEwOTM3NSwieSI6MzV9LHsieCI6NjY2LjEwOTM3NSwieSI6MzV9LHsieCI6NjkxLjEwOTM3NSwieSI6MzV9XQ==' data-look='classic' marker-end='url(%23mermaid-dark-5_flowchart-v2-pointEnd)'/><path d='M932.266%2c35L936.432%2c35C940.599%2c35%2c948.932%2c35%2c956.599%2c35C964.266%2c35%2c971.266%2c35%2c974.766%2c35L978.266%2c35' id='mermaid-dark-5-L_D_E_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_D_E_0' data-points='W3sieCI6OTMyLjI2NTYyNSwieSI6MzV9LHsieCI6OTU3LjI2NTYyNSwieSI6MzV9LHsieCI6OTgyLjI2NTYyNSwieSI6MzV9XQ==' data-look='classic' marker-end='url(%23mermaid-dark-5_flowchart-v2-pointEnd)'/><path d='M1146.328%2c35L1150.495%2c35C1154.661%2c35%2c1162.995%2c35%2c1170.661%2c35C1178.328%2c35%2c1185.328%2c35%2c1188.828%2c35L1192.328%2c35' id='mermaid-dark-5-L_E_F_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_E_F_0' data-points='W3sieCI6MTE0Ni4zMjgxMjUsInkiOjM1fSx7IngiOjExNzEuMzI4MTI1LCJ5IjozNX0seyJ4IjoxMTk2LjMyODEyNSwieSI6MzV9XQ==' data-look='classic' marker-end='url(%23mermaid-dark-5_flowchart-v2-pointEnd)'/><path d='M1338.156%2c35L1342.323%2c35C1346.49%2c35%2c1354.823%2c35%2c1362.49%2c35C1370.156%2c35%2c1377.156%2c35%2c1380.656%2c35L1384.156%2c35' id='mermaid-dark-5-L_F_G_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_F_G_0' data-points='W3sieCI6MTMzOC4xNTYyNSwieSI6MzV9LHsieCI6MTM2My4xNTYyNSwieSI6MzV9LHsieCI6MTM4OC4xNTYyNSwieSI6MzV9XQ==' data-look='classic' marker-end='url(%23mermaid-dark-5_flowchart-v2-pointEnd)'/></g><g class='edgeLabels'><g class='edgeLabel'><g class='label' data-id='L_A_B_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_B_C_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_C_D_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_D_E_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_E_F_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_F_G_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g></g><g class='nodes'><g class='node default' id='mermaid-dark-5-flowchart-A-0' data-look='classic' transform='translate(88.25%2c 35)'><rect class='basic label-container' style='' x='-80.25' y='-27' width='160.5' height='54'/><g class='label' style='' transform='translate(-50.25%2c -12)'><rect/><foreignObject width='100.5' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>Tool Definition</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-dark-5-flowchart-B-1' data-look='classic' transform='translate(298.3125%2c 35)'><rect class='basic label-container' style='' x='-79.8125' y='-27' width='159.625' height='54'/><g class='label' style='' transform='translate(-49.8125%2c -12)'><rect/><foreignObject width='99.625' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>Tool Selection</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-dark-5-flowchart-C-3' data-look='classic' transform='translate(534.6171875%2c 35)'><rect class='basic label-container' style='' x='-106.4921875' y='-27' width='212.984375' height='54'/><g class='label' style='' transform='translate(-76.4921875%2c -12)'><rect/><foreignObject width='152.984375' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>Argument Generation</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-dark-5-flowchart-D-5' data-look='classic' transform='translate(811.6875%2c 35)'><rect class='basic label-container' style='' x='-120.578125' y='-27' width='241.15625' height='54'/><g class='label' style='' transform='translate(-90.578125%2c -12)'><rect/><foreignObject width='181.15625' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>Validation %26amp%3b Authorization</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-dark-5-flowchart-E-7' data-look='classic' transform='translate(1064.296875%2c 35)'><rect class='basic label-container' style='' x='-82.03125' y='-27' width='164.0625' height='54'/><g class='label' style='' transform='translate(-52.03125%2c -12)'><rect/><foreignObject width='104.0625' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>Tool Execution</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-dark-5-flowchart-F-9' data-look='classic' transform='translate(1267.2421875%2c 35)'><rect class='basic label-container' style='' x='-70.9140625' y='-27' width='141.828125' height='54'/><g class='label' style='' transform='translate(-40.9140625%2c -12)'><rect/><foreignObject width='81.828125' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>Tool Output</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-dark-5-flowchart-G-11' data-look='classic' transform='translate(1473.7421875%2c 35)'><rect class='basic label-container' style='' x='-85.5859375' y='-27' width='171.171875' height='54'/><g class='label' style='' transform='translate(-55.5859375%2c -12)'><rect/><foreignObject width='111.171875' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>Final Response</p></span></div></foreignObject></g></g></g></g></g><defs><filter id='mermaid-dark-5-drop-shadow' height='130%' width='130%'><feDropShadow dx='4' dy='4' stdDeviation='0' flood-opacity='0.06' flood-color='white'/></filter></defs><defs><filter id='mermaid-dark-5-drop-shadow-small' height='150%' width='150%'><feDropShadow dx='2' dy='2' stdDeviation='0' flood-opacity='0.06' flood-color='white'/></filter></defs><linearGradient id='mermaid-dark-5-gradient' gradientUnits='objectBoundingBox' x1='0%' y1='0%' x2='100%' y2='0%'><stop offset='0%' stop-color='%23cccccc' stop-opacity='1'/><stop offset='100%' stop-color='hsl(180%2c 0%%2c 18.3529411765%)' stop-opacity='1'/></linearGradient></svg>)
其中最重要的职责边界是:
- 模型负责理解需求、选择工具和生成参数;
- 应用负责校验、鉴权、执行、幂等和审计;
- 业务服务负责真实规则与数据;
- 用户或审批系统负责确认高风险操作。
模型不应该成为业务系统的超级管理员。它更适合作为一个智能调用协调层,在明确的权限和数据边界内使用程序提供的能力。