容器镜像解决的是“应用如何被标准化封装和分发”,Kubernetes 解决的是镜像进入 集群后的问题:应用如何被调度、运行、访问、扩缩容、升级和恢复。
如果只使用容器运行时,团队仍然需要人工决定容器运行在哪台服务器、异常后如何 重启、多个实例如何发现彼此、如何接入流量,以及节点故障后如何迁移。Kubernetes 把这些能力抽象为标准资源,并通过控制器持续维护系统状态。
因此,理解 Kubernetes 的关键不是记住 YAML 字段,而是理解一句话:
资源对象描述期望状态,控制器持续推动实际状态向期望状态收敛。
本文是云服务系列第三篇,承接《容器镜像与云原生持续交付体系》, 关注制品进入 Kubernetes 之后的完整运行机制。
%3btext-align:center%3b%7d%23mermaid-0 .edgeLabel p%7bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3b%7d%23mermaid-0 .edgeLabel rect%7bopacity:0.5%3bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bfill:rgba(232%2c232%2c232%2c 0.8)%3b%7d%23mermaid-0 .labelBkg%7bbackground-color:rgba(232%2c 232%2c 232%2c 0.5)%3b%7d%23mermaid-0 .cluster rect%7bfill:%23ffffde%3bstroke:%23aaaa33%3bstroke-width:1px%3b%7d%23mermaid-0 .cluster text%7bfill:%23333%3b%7d%23mermaid-0 .cluster span%7bcolor:%23333%3b%7d%23mermaid-0 .node .collapsed-indicator%7bfill:%23aaaa33%3bstroke:none%3bopacity:0.6%3b%7d%23mermaid-0 .node .collapsed-separator%7bstroke:%23aaaa33%3bstroke-width:0.75px%3b%7d%23mermaid-0 div.mermaidTooltip%7bposition:absolute%3btext-align:center%3bmax-width:200px%3bpadding:2px%3bfont-family:arial%2csans-serif%3bfont-size:12px%3bbackground:hsl(80%2c 100%25%2c 96.2745098039%25)%3bborder:1px solid %23aaaa33%3bborder-radius:2px%3bpointer-events:none%3bz-index:100%3b%7d%23mermaid-0 .flowchartTitleText%7btext-anchor:middle%3bfont-size:18px%3bfill:%23333%3b%7d%23mermaid-0 rect.text%7bfill:none%3bstroke-width:0%3b%7d%23mermaid-0 .icon-shape%2c%23mermaid-0 .image-shape%7bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3btext-align:center%3b%7d%23mermaid-0 .icon-shape p%2c%23mermaid-0 .image-shape p%7bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bpadding:2px%3b%7d%23mermaid-0 .icon-shape .label rect%2c%23mermaid-0 .image-shape .label rect%7bopacity:0.5%3bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bfill:rgba(232%2c232%2c232%2c 0.8)%3b%7d%23mermaid-0 .label-icon%7bdisplay:inline-block%3bheight:1em%3boverflow:visible%3bvertical-align:-0.125em%3b%7d%23mermaid-0 .node .label-icon path%7bfill:currentColor%3bstroke:revert%3bstroke-width:revert%3b%7d%23mermaid-0 .node .neo-node%7bstroke:%239370DB%3b%7d%23mermaid-0 %5bdata-look='neo'%5d.node rect%2c%23mermaid-0 %5bdata-look='neo'%5d.cluster rect%2c%23mermaid-0 %5bdata-look='neo'%5d.node polygon%7bstroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-0 %5bdata-look='neo'%5d.swimlane.cluster rect%7bfilter:none%3b%7d%23mermaid-0 %5bdata-look='neo'%5d.node path%7bstroke:%239370DB%3bstroke-width:1px%3b%7d%23mermaid-0 %5bdata-look='neo'%5d.node .outer-path%7bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-0 %5bdata-look='neo'%5d.node .neo-line path%7bstroke:%239370DB%3bfilter:none%3b%7d%23mermaid-0 %5bdata-look='neo'%5d.node circle%7bstroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-0 %5bdata-look='neo'%5d.node circle .state-start%7bfill:black%3b%7d%23mermaid-0 %5bdata-look='neo'%5d.icon-shape .icon%7bfill:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-0 %5bdata-look='neo'%5d.icon-shape .icon-neo path%7bstroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-0 :root%7b--mermaid-font-family:arial%2csans-serif%3b%7d%3c/style%3e%3cg%3e%3cmarker id='mermaid-0_flowchart-v2-pointEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'%3e%3cpath d='M 0 0 L 10 5 L 0 10 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-pointStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='4.5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'%3e%3cpath d='M 0 5 L 10 10 L 10 0 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-pointEnd-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='11.5' refY='7' markerUnits='userSpaceOnUse' markerWidth='10.5' markerHeight='14' orient='auto'%3e%3cpath d='M 0 0 L 11.5 7 L 0 14 z' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-pointStart-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='1' refY='7' markerUnits='userSpaceOnUse' markerWidth='11.5' markerHeight='14' orient='auto'%3e%3cpolygon points='0%2c7 11.5%2c14 11.5%2c0' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-circleEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='11' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-circleStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-1' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-circleEnd-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refY='5' refX='12.25' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-circleStart-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-2' refY='5' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-crossEnd' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='12' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3cpath d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-crossStart' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='-1' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3cpath d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-crossEnd-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='17.7' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'%3e%3cpath d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-0_flowchart-v2-crossStart-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='-3.5' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'%3e%3cpath d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cg class='root'%3e%3cg class='clusters'/%3e%3cg class='edgePaths'%3e%3cpath d='M111.563%2c35L115.729%2c35C119.896%2c35%2c128.229%2c35%2c135.896%2c35C143.563%2c35%2c150.563%2c35%2c154.063%2c35L157.563%2c35' id='mermaid-0-L_Pipeline_Registry_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_Pipeline_Registry_0' data-points='W3sieCI6MTExLjU2MjUsInkiOjM1fSx7IngiOjEzNi41NjI1LCJ5IjozNX0seyJ4IjoxNjEuNTYyNSwieSI6MzV9XQ==' data-look='classic' marker-end='url(%23mermaid-0_flowchart-v2-pointEnd)'/%3e%3cpath d='M329.156%2c35L333.323%2c35C337.49%2c35%2c345.823%2c35%2c358.382%2c35C370.94%2c35%2c387.724%2c35%2c396.116%2c35L404.508%2c35' id='mermaid-0-L_Registry_Helm_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_Registry_Helm_0' data-points='W3sieCI6MzI5LjE1NjI1LCJ5IjozNX0seyJ4IjozNTQuMTU2MjUsInkiOjM1fSx7IngiOjQwOC41MDc4MTI1LCJ5IjozNX1d' data-look='classic' marker-end='url(%23mermaid-0_flowchart-v2-pointEnd)'/%3e%3cpath d='M505.852%2c35L514.91%2c35C523.969%2c35%2c542.086%2c35%2c560.107%2c38.901C578.127%2c42.801%2c596.052%2c50.602%2c605.014%2c54.503L613.976%2c58.404' id='mermaid-0-L_Helm_K8s_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_Helm_K8s_0' data-points='W3sieCI6NTA1Ljg1MTU2MjUsInkiOjM1fSx7IngiOjU2MC4yMDMxMjUsInkiOjM1fSx7IngiOjYxNy42NDM3ODAwNDgwNzY5LCJ5Ijo2MH1d' data-look='classic' marker-end='url(%23mermaid-0_flowchart-v2-pointEnd)'/%3e%3cpath d='M774.156%2c87L778.323%2c87C782.49%2c87%2c790.823%2c87%2c798.49%2c87C806.156%2c87%2c813.156%2c87%2c816.656%2c87L820.156%2c87' id='mermaid-0-L_K8s_Pod_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_K8s_Pod_0' data-points='W3sieCI6Nzc0LjE1NjI1LCJ5Ijo4N30seyJ4Ijo3OTkuMTU2MjUsInkiOjg3fSx7IngiOjgyNC4xNTYyNSwieSI6ODd9XQ==' data-look='classic' marker-end='url(%23mermaid-0_flowchart-v2-pointEnd)'/%3e%3cpath d='M535.203%2c139L539.37%2c139C543.536%2c139%2c551.87%2c139%2c564.999%2c135.099C578.127%2c131.199%2c596.052%2c123.398%2c605.014%2c119.497L613.976%2c115.596' id='mermaid-0-L_Entry_K8s_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_Entry_K8s_0' data-points='W3sieCI6NTM1LjIwMzEyNSwieSI6MTM5fSx7IngiOjU2MC4yMDMxMjUsInkiOjEzOX0seyJ4Ijo2MTcuNjQzNzgwMDQ4MDc2OSwieSI6MTE0fV0=' data-look='classic' marker-end='url(%23mermaid-0_flowchart-v2-pointEnd)'/%3e%3cpath d='M995.344%2c87L999.51%2c87C1003.677%2c87%2c1012.01%2c87%2c1019.677%2c87C1027.344%2c87%2c1034.344%2c87%2c1037.844%2c87L1041.344%2c87' id='mermaid-0-L_Pod_Data_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_Pod_Data_0' data-points='W3sieCI6OTk1LjM0Mzc1LCJ5Ijo4N30seyJ4IjoxMDIwLjM0Mzc1LCJ5Ijo4N30seyJ4IjoxMDQ1LjM0Mzc1LCJ5Ijo4N31d' data-look='classic' marker-end='url(%23mermaid-0_flowchart-v2-pointEnd)'/%3e%3c/g%3e%3cg class='edgeLabels'%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_Pipeline_Registry_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_Registry_Helm_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_Helm_K8s_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_K8s_Pod_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_Entry_K8s_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_Pod_Data_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cg class='nodes'%3e%3cg class='node default' id='mermaid-0-flowchart-Pipeline-0' data-look='classic' transform='translate(59.78125%2c 35)'%3e%3crect class='basic label-container' style='' x='-51.78125' y='-27' width='103.5625' height='54'/%3e%3cg class='label' style='' transform='translate(-21.78125%2c -12)'%3e%3crect/%3e%3cforeignObject width='43.5625' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eCI/CD%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-0-flowchart-Registry-1' data-look='classic' transform='translate(245.359375%2c 35)'%3e%3crect class='basic label-container' style='' x='-83.796875' y='-27' width='167.59375' height='54'/%3e%3cg class='label' style='' transform='translate(-53.796875%2c -12)'%3e%3crect/%3e%3cforeignObject width='107.59375' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eImage Registry%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-0-flowchart-Helm-3' data-look='classic' transform='translate(457.1796875%2c 35)'%3e%3crect class='basic label-container' style='' x='-48.671875' y='-27' width='97.34375' height='54'/%3e%3cg class='label' style='' transform='translate(-18.671875%2c -12)'%3e%3crect/%3e%3cforeignObject width='37.34375' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eHelm%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-0-flowchart-K8s-5' data-look='classic' transform='translate(679.6796875%2c 87)'%3e%3crect class='basic label-container' style='' x='-94.4765625' y='-27' width='188.953125' height='54'/%3e%3cg class='label' style='' transform='translate(-64.4765625%2c -12)'%3e%3crect/%3e%3cforeignObject width='128.953125' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eKubernetes / CCE%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-0-flowchart-Pod-7' data-look='classic' transform='translate(909.75%2c 87)'%3e%3crect class='basic label-container' style='' x='-85.59375' y='-27' width='171.1875' height='54'/%3e%3cg class='label' style='' transform='translate(-55.59375%2c -12)'%3e%3crect/%3e%3cforeignObject width='111.1875' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3ePod / Container%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-0-flowchart-Entry-8' data-look='classic' transform='translate(457.1796875%2c 139)'%3e%3crect class='basic label-container' style='' x='-78.0234375' y='-27' width='156.046875' height='54'/%3e%3cg class='label' style='' transform='translate(-48.0234375%2c -12)'%3e%3crect/%3e%3cforeignObject width='96.046875' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eELB / Ingress%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-0-flowchart-Data-11' data-look='classic' transform='translate(1170.046875%2c 87)'%3e%3crect class='basic label-container' style='' x='-124.703125' y='-27' width='249.40625' height='54'/%3e%3cg class='label' style='' transform='translate(-94.703125%2c -12)'%3e%3crect/%3e%3cforeignObject width='189.40625' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eRDS / Redis / Kafka / OBS%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cdefs%3e%3cfilter id='mermaid-0-drop-shadow' height='130%25' width='130%25'%3e%3cfeDropShadow dx='4' dy='4' stdDeviation='0' flood-opacity='0.06' flood-color='black'/%3e%3c/filter%3e%3c/defs%3e%3cdefs%3e%3cfilter id='mermaid-0-drop-shadow-small' height='150%25' width='150%25'%3e%3cfeDropShadow dx='2' dy='2' stdDeviation='0' flood-opacity='0.06' flood-color='black'/%3e%3c/filter%3e%3c/defs%3e%3c/svg%3e)
%3btext-align:center%3b%7d%23mermaid-dark-0%20.edgeLabel%20p%7bbackground-color:hsl(0%2c%200%25%2c%2034.4117647059%25)%3b%7d%23mermaid-dark-0%20.edgeLabel%20rect%7bopacity:0.5%3bbackground-color:hsl(0%2c%200%25%2c%2034.4117647059%25)%3bfill:hsl(0%2c%200%25%2c%2034.4117647059%25)%3b%7d%23mermaid-dark-0%20.labelBkg%7bbackground-color:rgba(87.75%2c%2087.75%2c%2087.75%2c%200.5)%3b%7d%23mermaid-dark-0%20.cluster%20rect%7bfill:hsl(180%2c%201.5873015873%25%2c%2028.3529411765%25)%3bstroke:rgba(255%2c%20255%2c%20255%2c%200.25)%3bstroke-width:1px%3b%7d%23mermaid-dark-0%20.cluster%20text%7bfill:%23F9FFFE%3b%7d%23mermaid-dark-0%20.cluster%20span%7bcolor:%23F9FFFE%3b%7d%23mermaid-dark-0%20.node%20.collapsed-indicator%7bfill:rgba(255%2c%20255%2c%20255%2c%200.25)%3bstroke:none%3bopacity:0.6%3b%7d%23mermaid-dark-0%20.node%20.collapsed-separator%7bstroke:rgba(255%2c%20255%2c%20255%2c%200.25)%3bstroke-width:0.75px%3b%7d%23mermaid-dark-0%20div.mermaidTooltip%7bposition:absolute%3btext-align:center%3bmax-width:200px%3bpadding:2px%3bfont-family:arial%2csans-serif%3bfont-size:12px%3bbackground:hsl(20%2c%201.5873015873%25%2c%2012.3529411765%25)%3bborder:1px%20solid%20rgba(255%2c%20255%2c%20255%2c%200.25)%3bborder-radius:2px%3bpointer-events:none%3bz-index:100%3b%7d%23mermaid-dark-0%20.flowchartTitleText%7btext-anchor:middle%3bfont-size:18px%3bfill:%23ccc%3b%7d%23mermaid-dark-0%20rect.text%7bfill:none%3bstroke-width:0%3b%7d%23mermaid-dark-0%20.icon-shape%2c%23mermaid-dark-0%20.image-shape%7bbackground-color:hsl(0%2c%200%25%2c%2034.4117647059%25)%3btext-align:center%3b%7d%23mermaid-dark-0%20.icon-shape%20p%2c%23mermaid-dark-0%20.image-shape%20p%7bbackground-color:hsl(0%2c%200%25%2c%2034.4117647059%25)%3bpadding:2px%3b%7d%23mermaid-dark-0%20.icon-shape%20.label%20rect%2c%23mermaid-dark-0%20.image-shape%20.label%20rect%7bopacity:0.5%3bbackground-color:hsl(0%2c%200%25%2c%2034.4117647059%25)%3bfill:hsl(0%2c%200%25%2c%2034.4117647059%25)%3b%7d%23mermaid-dark-0%20.label-icon%7bdisplay:inline-block%3bheight:1em%3boverflow:visible%3bvertical-align:-0.125em%3b%7d%23mermaid-dark-0%20.node%20.label-icon%20path%7bfill:currentColor%3bstroke:revert%3bstroke-width:revert%3b%7d%23mermaid-dark-0%20.node%20.neo-node%7bstroke:%23ccc%3b%7d%23mermaid-dark-0%20%5bdata-look='neo'%5d.node%20rect%2c%23mermaid-dark-0%20%5bdata-look='neo'%5d.cluster%20rect%2c%23mermaid-dark-0%20%5bdata-look='neo'%5d.node%20polygon%7bstroke:url(%23mermaid-dark-0-gradient)%3bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-0%20%5bdata-look='neo'%5d.swimlane.cluster%20rect%7bfilter:none%3b%7d%23mermaid-dark-0%20%5bdata-look='neo'%5d.node%20path%7bstroke:url(%23mermaid-dark-0-gradient)%3bstroke-width:1px%3b%7d%23mermaid-dark-0%20%5bdata-look='neo'%5d.node%20.outer-path%7bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-0%20%5bdata-look='neo'%5d.node%20.neo-line%20path%7bstroke:%23ccc%3bfilter:none%3b%7d%23mermaid-dark-0%20%5bdata-look='neo'%5d.node%20circle%7bstroke:url(%23mermaid-dark-0-gradient)%3bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-0%20%5bdata-look='neo'%5d.node%20circle%20.state-start%7bfill:black%3b%7d%23mermaid-dark-0%20%5bdata-look='neo'%5d.icon-shape%20.icon%7bfill:url(%23mermaid-dark-0-gradient)%3bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-0%20%5bdata-look='neo'%5d.icon-shape%20.icon-neo%20path%7bstroke:url(%23mermaid-dark-0-gradient)%3bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-0%20:root%7b--mermaid-font-family:arial%2csans-serif%3b%7d%3c/style%3e%3cg%3e%3cmarker%20id='mermaid-dark-0_flowchart-v2-pointEnd'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='5'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='8'%20markerHeight='8'%20orient='auto'%3e%3cpath%20d='M%200%200%20L%2010%205%20L%200%2010%20z'%20class='arrowMarkerPath'%20style='stroke-width:%201%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-0_flowchart-v2-pointStart'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='4.5'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='8'%20markerHeight='8'%20orient='auto'%3e%3cpath%20d='M%200%205%20L%2010%2010%20L%2010%200%20z'%20class='arrowMarkerPath'%20style='stroke-width:%201%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-0_flowchart-v2-pointEnd-margin'%20class='marker%20flowchart-v2'%20viewBox='0%200%2011.5%2014'%20refX='11.5'%20refY='7'%20markerUnits='userSpaceOnUse'%20markerWidth='10.5'%20markerHeight='14'%20orient='auto'%3e%3cpath%20d='M%200%200%20L%2011.5%207%20L%200%2014%20z'%20class='arrowMarkerPath'%20style='stroke-width:%200%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-0_flowchart-v2-pointStart-margin'%20class='marker%20flowchart-v2'%20viewBox='0%200%2011.5%2014'%20refX='1'%20refY='7'%20markerUnits='userSpaceOnUse'%20markerWidth='11.5'%20markerHeight='14'%20orient='auto'%3e%3cpolygon%20points='0%2c7%2011.5%2c14%2011.5%2c0'%20class='arrowMarkerPath'%20style='stroke-width:%200%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-0_flowchart-v2-circleEnd'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='11'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='11'%20markerHeight='11'%20orient='auto'%3e%3ccircle%20cx='5'%20cy='5'%20r='5'%20class='arrowMarkerPath'%20style='stroke-width:%201%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-0_flowchart-v2-circleStart'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='-1'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='11'%20markerHeight='11'%20orient='auto'%3e%3ccircle%20cx='5'%20cy='5'%20r='5'%20class='arrowMarkerPath'%20style='stroke-width:%201%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-0_flowchart-v2-circleEnd-margin'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refY='5'%20refX='12.25'%20markerUnits='userSpaceOnUse'%20markerWidth='14'%20markerHeight='14'%20orient='auto'%3e%3ccircle%20cx='5'%20cy='5'%20r='5'%20class='arrowMarkerPath'%20style='stroke-width:%200%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-0_flowchart-v2-circleStart-margin'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='-2'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='14'%20markerHeight='14'%20orient='auto'%3e%3ccircle%20cx='5'%20cy='5'%20r='5'%20class='arrowMarkerPath'%20style='stroke-width:%200%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-0_flowchart-v2-crossEnd'%20class='marker%20cross%20flowchart-v2'%20viewBox='0%200%2011%2011'%20refX='12'%20refY='5.2'%20markerUnits='userSpaceOnUse'%20markerWidth='11'%20markerHeight='11'%20orient='auto'%3e%3cpath%20d='M%201%2c1%20l%209%2c9%20M%2010%2c1%20l%20-9%2c9'%20class='arrowMarkerPath'%20style='stroke-width:%202%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-0_flowchart-v2-crossStart'%20class='marker%20cross%20flowchart-v2'%20viewBox='0%200%2011%2011'%20refX='-1'%20refY='5.2'%20markerUnits='userSpaceOnUse'%20markerWidth='11'%20markerHeight='11'%20orient='auto'%3e%3cpath%20d='M%201%2c1%20l%209%2c9%20M%2010%2c1%20l%20-9%2c9'%20class='arrowMarkerPath'%20style='stroke-width:%202%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-0_flowchart-v2-crossEnd-margin'%20class='marker%20cross%20flowchart-v2'%20viewBox='0%200%2015%2015'%20refX='17.7'%20refY='7.5'%20markerUnits='userSpaceOnUse'%20markerWidth='12'%20markerHeight='12'%20orient='auto'%3e%3cpath%20d='M%201%2c1%20L%2014%2c14%20M%201%2c14%20L%2014%2c1'%20class='arrowMarkerPath'%20style='stroke-width:%202.5%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-0_flowchart-v2-crossStart-margin'%20class='marker%20cross%20flowchart-v2'%20viewBox='0%200%2015%2015'%20refX='-3.5'%20refY='7.5'%20markerUnits='userSpaceOnUse'%20markerWidth='12'%20markerHeight='12'%20orient='auto'%3e%3cpath%20d='M%201%2c1%20L%2014%2c14%20M%201%2c14%20L%2014%2c1'%20class='arrowMarkerPath'%20style='stroke-width:%202.5%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cg%20class='root'%3e%3cg%20class='clusters'/%3e%3cg%20class='edgePaths'%3e%3cpath%20d='M111.563%2c35L115.729%2c35C119.896%2c35%2c128.229%2c35%2c135.896%2c35C143.563%2c35%2c150.563%2c35%2c154.063%2c35L157.563%2c35'%20id='mermaid-dark-0-L_Pipeline_Registry_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_Pipeline_Registry_0'%20data-points='W3sieCI6MTExLjU2MjUsInkiOjM1fSx7IngiOjEzNi41NjI1LCJ5IjozNX0seyJ4IjoxNjEuNTYyNSwieSI6MzV9XQ=='%20data-look='classic'%20marker-end='url(%23mermaid-dark-0_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M329.156%2c35L333.323%2c35C337.49%2c35%2c345.823%2c35%2c358.382%2c35C370.94%2c35%2c387.724%2c35%2c396.116%2c35L404.508%2c35'%20id='mermaid-dark-0-L_Registry_Helm_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_Registry_Helm_0'%20data-points='W3sieCI6MzI5LjE1NjI1LCJ5IjozNX0seyJ4IjozNTQuMTU2MjUsInkiOjM1fSx7IngiOjQwOC41MDc4MTI1LCJ5IjozNX1d'%20data-look='classic'%20marker-end='url(%23mermaid-dark-0_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M505.852%2c35L514.91%2c35C523.969%2c35%2c542.086%2c35%2c560.107%2c38.901C578.127%2c42.801%2c596.052%2c50.602%2c605.014%2c54.503L613.976%2c58.404'%20id='mermaid-dark-0-L_Helm_K8s_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_Helm_K8s_0'%20data-points='W3sieCI6NTA1Ljg1MTU2MjUsInkiOjM1fSx7IngiOjU2MC4yMDMxMjUsInkiOjM1fSx7IngiOjYxNy42NDM3ODAwNDgwNzY5LCJ5Ijo2MH1d'%20data-look='classic'%20marker-end='url(%23mermaid-dark-0_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M774.156%2c87L778.323%2c87C782.49%2c87%2c790.823%2c87%2c798.49%2c87C806.156%2c87%2c813.156%2c87%2c816.656%2c87L820.156%2c87'%20id='mermaid-dark-0-L_K8s_Pod_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_K8s_Pod_0'%20data-points='W3sieCI6Nzc0LjE1NjI1LCJ5Ijo4N30seyJ4Ijo3OTkuMTU2MjUsInkiOjg3fSx7IngiOjgyNC4xNTYyNSwieSI6ODd9XQ=='%20data-look='classic'%20marker-end='url(%23mermaid-dark-0_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M535.203%2c139L539.37%2c139C543.536%2c139%2c551.87%2c139%2c564.999%2c135.099C578.127%2c131.199%2c596.052%2c123.398%2c605.014%2c119.497L613.976%2c115.596'%20id='mermaid-dark-0-L_Entry_K8s_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_Entry_K8s_0'%20data-points='W3sieCI6NTM1LjIwMzEyNSwieSI6MTM5fSx7IngiOjU2MC4yMDMxMjUsInkiOjEzOX0seyJ4Ijo2MTcuNjQzNzgwMDQ4MDc2OSwieSI6MTE0fV0='%20data-look='classic'%20marker-end='url(%23mermaid-dark-0_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M995.344%2c87L999.51%2c87C1003.677%2c87%2c1012.01%2c87%2c1019.677%2c87C1027.344%2c87%2c1034.344%2c87%2c1037.844%2c87L1041.344%2c87'%20id='mermaid-dark-0-L_Pod_Data_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_Pod_Data_0'%20data-points='W3sieCI6OTk1LjM0Mzc1LCJ5Ijo4N30seyJ4IjoxMDIwLjM0Mzc1LCJ5Ijo4N30seyJ4IjoxMDQ1LjM0Mzc1LCJ5Ijo4N31d'%20data-look='classic'%20marker-end='url(%23mermaid-dark-0_flowchart-v2-pointEnd)'/%3e%3c/g%3e%3cg%20class='edgeLabels'%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_Pipeline_Registry_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_Registry_Helm_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_Helm_K8s_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_K8s_Pod_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_Entry_K8s_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_Pod_Data_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cg%20class='nodes'%3e%3cg%20class='node%20default'%20id='mermaid-dark-0-flowchart-Pipeline-0'%20data-look='classic'%20transform='translate(59.78125%2c%2035)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-51.78125'%20y='-27'%20width='103.5625'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-21.78125%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='43.5625'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3eCI/CD%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-0-flowchart-Registry-1'%20data-look='classic'%20transform='translate(245.359375%2c%2035)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-83.796875'%20y='-27'%20width='167.59375'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-53.796875%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='107.59375'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3eImage%20Registry%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-0-flowchart-Helm-3'%20data-look='classic'%20transform='translate(457.1796875%2c%2035)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-48.671875'%20y='-27'%20width='97.34375'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-18.671875%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='37.34375'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3eHelm%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-0-flowchart-K8s-5'%20data-look='classic'%20transform='translate(679.6796875%2c%2087)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-94.4765625'%20y='-27'%20width='188.953125'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-64.4765625%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='128.953125'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3eKubernetes%20/%20CCE%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-0-flowchart-Pod-7'%20data-look='classic'%20transform='translate(909.75%2c%2087)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-85.59375'%20y='-27'%20width='171.1875'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-55.59375%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='111.1875'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3ePod%20/%20Container%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-0-flowchart-Entry-8'%20data-look='classic'%20transform='translate(457.1796875%2c%20139)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-78.0234375'%20y='-27'%20width='156.046875'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-48.0234375%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='96.046875'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3eELB%20/%20Ingress%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-0-flowchart-Data-11'%20data-look='classic'%20transform='translate(1170.046875%2c%2087)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-124.703125'%20y='-27'%20width='249.40625'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-94.703125%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='189.40625'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3eRDS%20/%20Redis%20/%20Kafka%20/%20OBS%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cdefs%3e%3cfilter%20id='mermaid-dark-0-drop-shadow'%20height='130%25'%20width='130%25'%3e%3cfeDropShadow%20dx='4'%20dy='4'%20stdDeviation='0'%20flood-opacity='0.06'%20flood-color='white'/%3e%3c/filter%3e%3c/defs%3e%3cdefs%3e%3cfilter%20id='mermaid-dark-0-drop-shadow-small'%20height='150%25'%20width='150%25'%3e%3cfeDropShadow%20dx='2'%20dy='2'%20stdDeviation='0'%20flood-opacity='0.06'%20flood-color='white'/%3e%3c/filter%3e%3c/defs%3e%3clinearGradient%20id='mermaid-dark-0-gradient'%20gradientUnits='objectBoundingBox'%20x1='0%25'%20y1='0%25'%20x2='100%25'%20y2='0%25'%3e%3cstop%20offset='0%25'%20stop-color='%23cccccc'%20stop-opacity='1'/%3e%3cstop%20offset='100%25'%20stop-color='hsl(180%2c%200%25%2c%2018.3529411765%25)'%20stop-opacity='1'/%3e%3c/linearGradient%3e%3c/svg%3e)
一、声明式 API 与协调循环
命令式操作描述“执行哪些步骤”,声明式配置描述“系统最终应该是什么样子”。 例如:
spec:
  replicas: 3
这不是一次“创建三个 Pod”的命令,而是要求系统持续保持三个副本。如果实际只有 两个,控制器补充一个;如果实际有四个,控制器移除一个。
资源对象的共同结构
Kubernetes 几乎所有能力都通过 API Resource 表达:
apiVersion: apps/v1
kind: Deployment
metadata:
  name: order-service
  namespace: production
  labels:
    app: order-service
spec:
  replicas: 3
status: {}| 字段 | 作用 |
|---|---|
apiVersion | 指定资源使用的 API 组与版本 |
kind | 指定 Deployment、Service 等资源类型 |
metadata | 描述名称、命名空间、标签和注解 |
spec | 用户声明的期望状态 |
status | 控制器记录的当前实际状态 |
用户通常只维护 spec,控制器观察 status 并执行 Reconciliation Loop:
%3btext-align:center%3b%7d%23mermaid-1 .edgeLabel p%7bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3b%7d%23mermaid-1 .edgeLabel rect%7bopacity:0.5%3bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bfill:rgba(232%2c232%2c232%2c 0.8)%3b%7d%23mermaid-1 .labelBkg%7bbackground-color:rgba(232%2c 232%2c 232%2c 0.5)%3b%7d%23mermaid-1 .cluster rect%7bfill:%23ffffde%3bstroke:%23aaaa33%3bstroke-width:1px%3b%7d%23mermaid-1 .cluster text%7bfill:%23333%3b%7d%23mermaid-1 .cluster span%7bcolor:%23333%3b%7d%23mermaid-1 .node .collapsed-indicator%7bfill:%23aaaa33%3bstroke:none%3bopacity:0.6%3b%7d%23mermaid-1 .node .collapsed-separator%7bstroke:%23aaaa33%3bstroke-width:0.75px%3b%7d%23mermaid-1 div.mermaidTooltip%7bposition:absolute%3btext-align:center%3bmax-width:200px%3bpadding:2px%3bfont-family:arial%2csans-serif%3bfont-size:12px%3bbackground:hsl(80%2c 100%25%2c 96.2745098039%25)%3bborder:1px solid %23aaaa33%3bborder-radius:2px%3bpointer-events:none%3bz-index:100%3b%7d%23mermaid-1 .flowchartTitleText%7btext-anchor:middle%3bfont-size:18px%3bfill:%23333%3b%7d%23mermaid-1 rect.text%7bfill:none%3bstroke-width:0%3b%7d%23mermaid-1 .icon-shape%2c%23mermaid-1 .image-shape%7bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3btext-align:center%3b%7d%23mermaid-1 .icon-shape p%2c%23mermaid-1 .image-shape p%7bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bpadding:2px%3b%7d%23mermaid-1 .icon-shape .label rect%2c%23mermaid-1 .image-shape .label rect%7bopacity:0.5%3bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bfill:rgba(232%2c232%2c232%2c 0.8)%3b%7d%23mermaid-1 .label-icon%7bdisplay:inline-block%3bheight:1em%3boverflow:visible%3bvertical-align:-0.125em%3b%7d%23mermaid-1 .node .label-icon path%7bfill:currentColor%3bstroke:revert%3bstroke-width:revert%3b%7d%23mermaid-1 .node .neo-node%7bstroke:%239370DB%3b%7d%23mermaid-1 %5bdata-look='neo'%5d.node rect%2c%23mermaid-1 %5bdata-look='neo'%5d.cluster rect%2c%23mermaid-1 %5bdata-look='neo'%5d.node polygon%7bstroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-1 %5bdata-look='neo'%5d.swimlane.cluster rect%7bfilter:none%3b%7d%23mermaid-1 %5bdata-look='neo'%5d.node path%7bstroke:%239370DB%3bstroke-width:1px%3b%7d%23mermaid-1 %5bdata-look='neo'%5d.node .outer-path%7bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-1 %5bdata-look='neo'%5d.node .neo-line path%7bstroke:%239370DB%3bfilter:none%3b%7d%23mermaid-1 %5bdata-look='neo'%5d.node circle%7bstroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-1 %5bdata-look='neo'%5d.node circle .state-start%7bfill:black%3b%7d%23mermaid-1 %5bdata-look='neo'%5d.icon-shape .icon%7bfill:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-1 %5bdata-look='neo'%5d.icon-shape .icon-neo path%7bstroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-1 :root%7b--mermaid-font-family:arial%2csans-serif%3b%7d%3c/style%3e%3cg%3e%3cmarker id='mermaid-1_flowchart-v2-pointEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'%3e%3cpath d='M 0 0 L 10 5 L 0 10 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-1_flowchart-v2-pointStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='4.5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'%3e%3cpath d='M 0 5 L 10 10 L 10 0 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-1_flowchart-v2-pointEnd-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='11.5' refY='7' markerUnits='userSpaceOnUse' markerWidth='10.5' markerHeight='14' orient='auto'%3e%3cpath d='M 0 0 L 11.5 7 L 0 14 z' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-1_flowchart-v2-pointStart-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='1' refY='7' markerUnits='userSpaceOnUse' markerWidth='11.5' markerHeight='14' orient='auto'%3e%3cpolygon points='0%2c7 11.5%2c14 11.5%2c0' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-1_flowchart-v2-circleEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='11' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-1_flowchart-v2-circleStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-1' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-1_flowchart-v2-circleEnd-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refY='5' refX='12.25' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-1_flowchart-v2-circleStart-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-2' refY='5' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-1_flowchart-v2-crossEnd' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='12' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3cpath d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-1_flowchart-v2-crossStart' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='-1' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3cpath d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-1_flowchart-v2-crossEnd-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='17.7' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'%3e%3cpath d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-1_flowchart-v2-crossStart-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='-3.5' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'%3e%3cpath d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cg class='root'%3e%3cg class='clusters'/%3e%3cg class='edgePaths'%3e%3cpath d='M212.078%2c66L216.245%2c66C220.411%2c66%2c228.745%2c66%2c236.411%2c66C244.078%2c66%2c251.078%2c66%2c254.578%2c66L258.078%2c66' id='mermaid-1-L_Desired_Compare_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_Desired_Compare_0' data-points='W3sieCI6MjEyLjA3ODEyNSwieSI6NjZ9LHsieCI6MjM3LjA3ODEyNSwieSI6NjZ9LHsieCI6MjYyLjA3ODEyNSwieSI6NjZ9XQ==' data-look='classic' marker-end='url(%23mermaid-1_flowchart-v2-pointEnd)'/%3e%3cpath d='M820.453%2c35L824.62%2c35C828.786%2c35%2c837.12%2c35%2c844.827%2c36.288C852.533%2c37.575%2c859.614%2c40.15%2c863.154%2c41.438L866.694%2c42.725' id='mermaid-1-L_Actual_Observe_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_Actual_Observe_0' data-points='W3sieCI6ODIwLjQ1MzEyNSwieSI6MzV9LHsieCI6ODQ1LjQ1MzEyNSwieSI6MzV9LHsieCI6ODcwLjQ1MzEyNSwieSI6NDQuMDkyNTc1NjE4Njk4NDR9XQ==' data-look='classic' marker-end='url(%23mermaid-1_flowchart-v2-pointEnd)'/%3e%3cpath d='M870.453%2c87.907L866.286%2c89.423C862.12%2c90.938%2c853.786%2c93.969%2c828.595%2c95.485C803.404%2c97%2c761.354%2c97%2c719.305%2c97C677.255%2c97%2c635.206%2c97%2c599.159%2c97C563.112%2c97%2c533.068%2c97%2c503.023%2c97C472.979%2c97%2c442.935%2c97%2c424.375%2c95.752C405.815%2c94.505%2c398.739%2c92.009%2c395.201%2c90.762L391.663%2c89.514' id='mermaid-1-L_Observe_Compare_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_Observe_Compare_0' data-points='W3sieCI6ODcwLjQ1MzEyNSwieSI6ODcuOTA3NDI0MzgxMzAxNTV9LHsieCI6ODQ1LjQ1MzEyNSwieSI6OTd9LHsieCI6NzE5LjMwNDY4NzUsInkiOjk3fSx7IngiOjU5My4xNTYyNSwieSI6OTd9LHsieCI6NTAzLjAyMzQzNzUsInkiOjk3fSx7IngiOjQxMi44OTA2MjUsInkiOjk3fSx7IngiOjM4Ny44OTA2MjUsInkiOjg4LjE4Mzc4OTU0ODUyNDcxfV0=' data-look='classic' marker-end='url(%23mermaid-1_flowchart-v2-pointEnd)'/%3e%3cpath d='M387.891%2c43.816L392.057%2c42.347C396.224%2c40.877%2c404.557%2c37.939%2c412.224%2c36.469C419.891%2c35%2c426.891%2c35%2c430.391%2c35L433.891%2c35' id='mermaid-1-L_Compare_Reconcile_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_Compare_Reconcile_0' data-points='W3sieCI6Mzg3Ljg5MDYyNSwieSI6NDMuODE2MjEwNDUxNDc1Mjl9LHsieCI6NDEyLjg5MDYyNSwieSI6MzV9LHsieCI6NDM3Ljg5MDYyNSwieSI6MzV9XQ==' data-look='classic' marker-end='url(%23mermaid-1_flowchart-v2-pointEnd)'/%3e%3cpath d='M568.156%2c35L572.323%2c35C576.49%2c35%2c584.823%2c35%2c592.49%2c35C600.156%2c35%2c607.156%2c35%2c610.656%2c35L614.156%2c35' id='mermaid-1-L_Reconcile_Actual_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_Reconcile_Actual_0' data-points='W3sieCI6NTY4LjE1NjI1LCJ5IjozNX0seyJ4Ijo1OTMuMTU2MjUsInkiOjM1fSx7IngiOjYxOC4xNTYyNSwieSI6MzV9XQ==' data-look='classic' marker-end='url(%23mermaid-1_flowchart-v2-pointEnd)'/%3e%3c/g%3e%3cg class='edgeLabels'%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_Desired_Compare_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_Actual_Observe_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_Observe_Compare_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_Compare_Reconcile_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_Reconcile_Actual_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cg class='nodes'%3e%3cg class='node default' id='mermaid-1-flowchart-Desired-0' data-look='classic' transform='translate(110.0390625%2c 66)'%3e%3crect class='basic label-container' style='' x='-102.0390625' y='-27' width='204.078125' height='54'/%3e%3cg class='label' style='' transform='translate(-72.0390625%2c -12)'%3e%3crect/%3e%3cforeignObject width='144.078125' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eDesired State / spec%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-1-flowchart-Compare-1' data-look='classic' transform='translate(324.984375%2c 66)'%3e%3crect class='basic label-container' style='' x='-62.90625' y='-27' width='125.8125' height='54'/%3e%3cg class='label' style='' transform='translate(-32.90625%2c -12)'%3e%3crect/%3e%3cforeignObject width='65.8125' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eCompare%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-1-flowchart-Actual-2' data-look='classic' transform='translate(719.3046875%2c 35)'%3e%3crect class='basic label-container' style='' x='-101.1484375' y='-27' width='202.296875' height='54'/%3e%3cg class='label' style='' transform='translate(-71.1484375%2c -12)'%3e%3crect/%3e%3cforeignObject width='142.296875' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eActual State / status%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-1-flowchart-Observe-3' data-look='classic' transform='translate(930.6875%2c 66)'%3e%3crect class='basic label-container' style='' x='-60.234375' y='-27' width='120.46875' height='54'/%3e%3cg class='label' style='' transform='translate(-30.234375%2c -12)'%3e%3crect/%3e%3cforeignObject width='60.46875' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eObserve%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-1-flowchart-Reconcile-7' data-look='classic' transform='translate(503.0234375%2c 35)'%3e%3crect class='basic label-container' style='' x='-65.1328125' y='-27' width='130.265625' height='54'/%3e%3cg class='label' style='' transform='translate(-35.1328125%2c -12)'%3e%3crect/%3e%3cforeignObject width='70.265625' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eReconcile%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cdefs%3e%3cfilter id='mermaid-1-drop-shadow' height='130%25' width='130%25'%3e%3cfeDropShadow dx='4' dy='4' stdDeviation='0' flood-opacity='0.06' flood-color='black'/%3e%3c/filter%3e%3c/defs%3e%3cdefs%3e%3cfilter id='mermaid-1-drop-shadow-small' height='150%25' width='150%25'%3e%3cfeDropShadow dx='2' dy='2' stdDeviation='0' flood-opacity='0.06' flood-color='black'/%3e%3c/filter%3e%3c/defs%3e%3c/svg%3e)
%3btext-align:center%3b%7d%23mermaid-dark-1%20.edgeLabel%20p%7bbackground-color:hsl(0%2c%200%25%2c%2034.4117647059%25)%3b%7d%23mermaid-dark-1%20.edgeLabel%20rect%7bopacity:0.5%3bbackground-color:hsl(0%2c%200%25%2c%2034.4117647059%25)%3bfill:hsl(0%2c%200%25%2c%2034.4117647059%25)%3b%7d%23mermaid-dark-1%20.labelBkg%7bbackground-color:rgba(87.75%2c%2087.75%2c%2087.75%2c%200.5)%3b%7d%23mermaid-dark-1%20.cluster%20rect%7bfill:hsl(180%2c%201.5873015873%25%2c%2028.3529411765%25)%3bstroke:rgba(255%2c%20255%2c%20255%2c%200.25)%3bstroke-width:1px%3b%7d%23mermaid-dark-1%20.cluster%20text%7bfill:%23F9FFFE%3b%7d%23mermaid-dark-1%20.cluster%20span%7bcolor:%23F9FFFE%3b%7d%23mermaid-dark-1%20.node%20.collapsed-indicator%7bfill:rgba(255%2c%20255%2c%20255%2c%200.25)%3bstroke:none%3bopacity:0.6%3b%7d%23mermaid-dark-1%20.node%20.collapsed-separator%7bstroke:rgba(255%2c%20255%2c%20255%2c%200.25)%3bstroke-width:0.75px%3b%7d%23mermaid-dark-1%20div.mermaidTooltip%7bposition:absolute%3btext-align:center%3bmax-width:200px%3bpadding:2px%3bfont-family:arial%2csans-serif%3bfont-size:12px%3bbackground:hsl(20%2c%201.5873015873%25%2c%2012.3529411765%25)%3bborder:1px%20solid%20rgba(255%2c%20255%2c%20255%2c%200.25)%3bborder-radius:2px%3bpointer-events:none%3bz-index:100%3b%7d%23mermaid-dark-1%20.flowchartTitleText%7btext-anchor:middle%3bfont-size:18px%3bfill:%23ccc%3b%7d%23mermaid-dark-1%20rect.text%7bfill:none%3bstroke-width:0%3b%7d%23mermaid-dark-1%20.icon-shape%2c%23mermaid-dark-1%20.image-shape%7bbackground-color:hsl(0%2c%200%25%2c%2034.4117647059%25)%3btext-align:center%3b%7d%23mermaid-dark-1%20.icon-shape%20p%2c%23mermaid-dark-1%20.image-shape%20p%7bbackground-color:hsl(0%2c%200%25%2c%2034.4117647059%25)%3bpadding:2px%3b%7d%23mermaid-dark-1%20.icon-shape%20.label%20rect%2c%23mermaid-dark-1%20.image-shape%20.label%20rect%7bopacity:0.5%3bbackground-color:hsl(0%2c%200%25%2c%2034.4117647059%25)%3bfill:hsl(0%2c%200%25%2c%2034.4117647059%25)%3b%7d%23mermaid-dark-1%20.label-icon%7bdisplay:inline-block%3bheight:1em%3boverflow:visible%3bvertical-align:-0.125em%3b%7d%23mermaid-dark-1%20.node%20.label-icon%20path%7bfill:currentColor%3bstroke:revert%3bstroke-width:revert%3b%7d%23mermaid-dark-1%20.node%20.neo-node%7bstroke:%23ccc%3b%7d%23mermaid-dark-1%20%5bdata-look='neo'%5d.node%20rect%2c%23mermaid-dark-1%20%5bdata-look='neo'%5d.cluster%20rect%2c%23mermaid-dark-1%20%5bdata-look='neo'%5d.node%20polygon%7bstroke:url(%23mermaid-dark-1-gradient)%3bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-1%20%5bdata-look='neo'%5d.swimlane.cluster%20rect%7bfilter:none%3b%7d%23mermaid-dark-1%20%5bdata-look='neo'%5d.node%20path%7bstroke:url(%23mermaid-dark-1-gradient)%3bstroke-width:1px%3b%7d%23mermaid-dark-1%20%5bdata-look='neo'%5d.node%20.outer-path%7bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-1%20%5bdata-look='neo'%5d.node%20.neo-line%20path%7bstroke:%23ccc%3bfilter:none%3b%7d%23mermaid-dark-1%20%5bdata-look='neo'%5d.node%20circle%7bstroke:url(%23mermaid-dark-1-gradient)%3bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-1%20%5bdata-look='neo'%5d.node%20circle%20.state-start%7bfill:black%3b%7d%23mermaid-dark-1%20%5bdata-look='neo'%5d.icon-shape%20.icon%7bfill:url(%23mermaid-dark-1-gradient)%3bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-1%20%5bdata-look='neo'%5d.icon-shape%20.icon-neo%20path%7bstroke:url(%23mermaid-dark-1-gradient)%3bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-1%20:root%7b--mermaid-font-family:arial%2csans-serif%3b%7d%3c/style%3e%3cg%3e%3cmarker%20id='mermaid-dark-1_flowchart-v2-pointEnd'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='5'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='8'%20markerHeight='8'%20orient='auto'%3e%3cpath%20d='M%200%200%20L%2010%205%20L%200%2010%20z'%20class='arrowMarkerPath'%20style='stroke-width:%201%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-1_flowchart-v2-pointStart'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='4.5'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='8'%20markerHeight='8'%20orient='auto'%3e%3cpath%20d='M%200%205%20L%2010%2010%20L%2010%200%20z'%20class='arrowMarkerPath'%20style='stroke-width:%201%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-1_flowchart-v2-pointEnd-margin'%20class='marker%20flowchart-v2'%20viewBox='0%200%2011.5%2014'%20refX='11.5'%20refY='7'%20markerUnits='userSpaceOnUse'%20markerWidth='10.5'%20markerHeight='14'%20orient='auto'%3e%3cpath%20d='M%200%200%20L%2011.5%207%20L%200%2014%20z'%20class='arrowMarkerPath'%20style='stroke-width:%200%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-1_flowchart-v2-pointStart-margin'%20class='marker%20flowchart-v2'%20viewBox='0%200%2011.5%2014'%20refX='1'%20refY='7'%20markerUnits='userSpaceOnUse'%20markerWidth='11.5'%20markerHeight='14'%20orient='auto'%3e%3cpolygon%20points='0%2c7%2011.5%2c14%2011.5%2c0'%20class='arrowMarkerPath'%20style='stroke-width:%200%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-1_flowchart-v2-circleEnd'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='11'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='11'%20markerHeight='11'%20orient='auto'%3e%3ccircle%20cx='5'%20cy='5'%20r='5'%20class='arrowMarkerPath'%20style='stroke-width:%201%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-1_flowchart-v2-circleStart'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='-1'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='11'%20markerHeight='11'%20orient='auto'%3e%3ccircle%20cx='5'%20cy='5'%20r='5'%20class='arrowMarkerPath'%20style='stroke-width:%201%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-1_flowchart-v2-circleEnd-margin'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refY='5'%20refX='12.25'%20markerUnits='userSpaceOnUse'%20markerWidth='14'%20markerHeight='14'%20orient='auto'%3e%3ccircle%20cx='5'%20cy='5'%20r='5'%20class='arrowMarkerPath'%20style='stroke-width:%200%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-1_flowchart-v2-circleStart-margin'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='-2'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='14'%20markerHeight='14'%20orient='auto'%3e%3ccircle%20cx='5'%20cy='5'%20r='5'%20class='arrowMarkerPath'%20style='stroke-width:%200%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-1_flowchart-v2-crossEnd'%20class='marker%20cross%20flowchart-v2'%20viewBox='0%200%2011%2011'%20refX='12'%20refY='5.2'%20markerUnits='userSpaceOnUse'%20markerWidth='11'%20markerHeight='11'%20orient='auto'%3e%3cpath%20d='M%201%2c1%20l%209%2c9%20M%2010%2c1%20l%20-9%2c9'%20class='arrowMarkerPath'%20style='stroke-width:%202%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-1_flowchart-v2-crossStart'%20class='marker%20cross%20flowchart-v2'%20viewBox='0%200%2011%2011'%20refX='-1'%20refY='5.2'%20markerUnits='userSpaceOnUse'%20markerWidth='11'%20markerHeight='11'%20orient='auto'%3e%3cpath%20d='M%201%2c1%20l%209%2c9%20M%2010%2c1%20l%20-9%2c9'%20class='arrowMarkerPath'%20style='stroke-width:%202%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-1_flowchart-v2-crossEnd-margin'%20class='marker%20cross%20flowchart-v2'%20viewBox='0%200%2015%2015'%20refX='17.7'%20refY='7.5'%20markerUnits='userSpaceOnUse'%20markerWidth='12'%20markerHeight='12'%20orient='auto'%3e%3cpath%20d='M%201%2c1%20L%2014%2c14%20M%201%2c14%20L%2014%2c1'%20class='arrowMarkerPath'%20style='stroke-width:%202.5%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-1_flowchart-v2-crossStart-margin'%20class='marker%20cross%20flowchart-v2'%20viewBox='0%200%2015%2015'%20refX='-3.5'%20refY='7.5'%20markerUnits='userSpaceOnUse'%20markerWidth='12'%20markerHeight='12'%20orient='auto'%3e%3cpath%20d='M%201%2c1%20L%2014%2c14%20M%201%2c14%20L%2014%2c1'%20class='arrowMarkerPath'%20style='stroke-width:%202.5%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cg%20class='root'%3e%3cg%20class='clusters'/%3e%3cg%20class='edgePaths'%3e%3cpath%20d='M212.078%2c66L216.245%2c66C220.411%2c66%2c228.745%2c66%2c236.411%2c66C244.078%2c66%2c251.078%2c66%2c254.578%2c66L258.078%2c66'%20id='mermaid-dark-1-L_Desired_Compare_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_Desired_Compare_0'%20data-points='W3sieCI6MjEyLjA3ODEyNSwieSI6NjZ9LHsieCI6MjM3LjA3ODEyNSwieSI6NjZ9LHsieCI6MjYyLjA3ODEyNSwieSI6NjZ9XQ=='%20data-look='classic'%20marker-end='url(%23mermaid-dark-1_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M820.453%2c35L824.62%2c35C828.786%2c35%2c837.12%2c35%2c844.827%2c36.288C852.533%2c37.575%2c859.614%2c40.15%2c863.154%2c41.438L866.694%2c42.725'%20id='mermaid-dark-1-L_Actual_Observe_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_Actual_Observe_0'%20data-points='W3sieCI6ODIwLjQ1MzEyNSwieSI6MzV9LHsieCI6ODQ1LjQ1MzEyNSwieSI6MzV9LHsieCI6ODcwLjQ1MzEyNSwieSI6NDQuMDkyNTc1NjE4Njk4NDR9XQ=='%20data-look='classic'%20marker-end='url(%23mermaid-dark-1_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M870.453%2c87.907L866.286%2c89.423C862.12%2c90.938%2c853.786%2c93.969%2c828.595%2c95.485C803.404%2c97%2c761.354%2c97%2c719.305%2c97C677.255%2c97%2c635.206%2c97%2c599.159%2c97C563.112%2c97%2c533.068%2c97%2c503.023%2c97C472.979%2c97%2c442.935%2c97%2c424.375%2c95.752C405.815%2c94.505%2c398.739%2c92.009%2c395.201%2c90.762L391.663%2c89.514'%20id='mermaid-dark-1-L_Observe_Compare_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_Observe_Compare_0'%20data-points='W3sieCI6ODcwLjQ1MzEyNSwieSI6ODcuOTA3NDI0MzgxMzAxNTV9LHsieCI6ODQ1LjQ1MzEyNSwieSI6OTd9LHsieCI6NzE5LjMwNDY4NzUsInkiOjk3fSx7IngiOjU5My4xNTYyNSwieSI6OTd9LHsieCI6NTAzLjAyMzQzNzUsInkiOjk3fSx7IngiOjQxMi44OTA2MjUsInkiOjk3fSx7IngiOjM4Ny44OTA2MjUsInkiOjg4LjE4Mzc4OTU0ODUyNDcxfV0='%20data-look='classic'%20marker-end='url(%23mermaid-dark-1_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M387.891%2c43.816L392.057%2c42.347C396.224%2c40.877%2c404.557%2c37.939%2c412.224%2c36.469C419.891%2c35%2c426.891%2c35%2c430.391%2c35L433.891%2c35'%20id='mermaid-dark-1-L_Compare_Reconcile_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_Compare_Reconcile_0'%20data-points='W3sieCI6Mzg3Ljg5MDYyNSwieSI6NDMuODE2MjEwNDUxNDc1Mjl9LHsieCI6NDEyLjg5MDYyNSwieSI6MzV9LHsieCI6NDM3Ljg5MDYyNSwieSI6MzV9XQ=='%20data-look='classic'%20marker-end='url(%23mermaid-dark-1_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M568.156%2c35L572.323%2c35C576.49%2c35%2c584.823%2c35%2c592.49%2c35C600.156%2c35%2c607.156%2c35%2c610.656%2c35L614.156%2c35'%20id='mermaid-dark-1-L_Reconcile_Actual_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_Reconcile_Actual_0'%20data-points='W3sieCI6NTY4LjE1NjI1LCJ5IjozNX0seyJ4Ijo1OTMuMTU2MjUsInkiOjM1fSx7IngiOjYxOC4xNTYyNSwieSI6MzV9XQ=='%20data-look='classic'%20marker-end='url(%23mermaid-dark-1_flowchart-v2-pointEnd)'/%3e%3c/g%3e%3cg%20class='edgeLabels'%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_Desired_Compare_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_Actual_Observe_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_Observe_Compare_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_Compare_Reconcile_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_Reconcile_Actual_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cg%20class='nodes'%3e%3cg%20class='node%20default'%20id='mermaid-dark-1-flowchart-Desired-0'%20data-look='classic'%20transform='translate(110.0390625%2c%2066)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-102.0390625'%20y='-27'%20width='204.078125'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-72.0390625%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='144.078125'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3eDesired%20State%20/%20spec%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-1-flowchart-Compare-1'%20data-look='classic'%20transform='translate(324.984375%2c%2066)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-62.90625'%20y='-27'%20width='125.8125'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-32.90625%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='65.8125'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3eCompare%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-1-flowchart-Actual-2'%20data-look='classic'%20transform='translate(719.3046875%2c%2035)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-101.1484375'%20y='-27'%20width='202.296875'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-71.1484375%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='142.296875'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3eActual%20State%20/%20status%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-1-flowchart-Observe-3'%20data-look='classic'%20transform='translate(930.6875%2c%2066)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-60.234375'%20y='-27'%20width='120.46875'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-30.234375%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='60.46875'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3eObserve%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-1-flowchart-Reconcile-7'%20data-look='classic'%20transform='translate(503.0234375%2c%2035)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-65.1328125'%20y='-27'%20width='130.265625'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-35.1328125%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='70.265625'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3eReconcile%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cdefs%3e%3cfilter%20id='mermaid-dark-1-drop-shadow'%20height='130%25'%20width='130%25'%3e%3cfeDropShadow%20dx='4'%20dy='4'%20stdDeviation='0'%20flood-opacity='0.06'%20flood-color='white'/%3e%3c/filter%3e%3c/defs%3e%3cdefs%3e%3cfilter%20id='mermaid-dark-1-drop-shadow-small'%20height='150%25'%20width='150%25'%3e%3cfeDropShadow%20dx='2'%20dy='2'%20stdDeviation='0'%20flood-opacity='0.06'%20flood-color='white'/%3e%3c/filter%3e%3c/defs%3e%3clinearGradient%20id='mermaid-dark-1-gradient'%20gradientUnits='objectBoundingBox'%20x1='0%25'%20y1='0%25'%20x2='100%25'%20y2='0%25'%3e%3cstop%20offset='0%25'%20stop-color='%23cccccc'%20stop-opacity='1'/%3e%3cstop%20offset='100%25'%20stop-color='hsl(180%2c%200%25%2c%2018.3529411765%25)'%20stop-opacity='1'/%3e%3c/linearGradient%3e%3c/svg%3e)
API Server、etcd 与 Controller
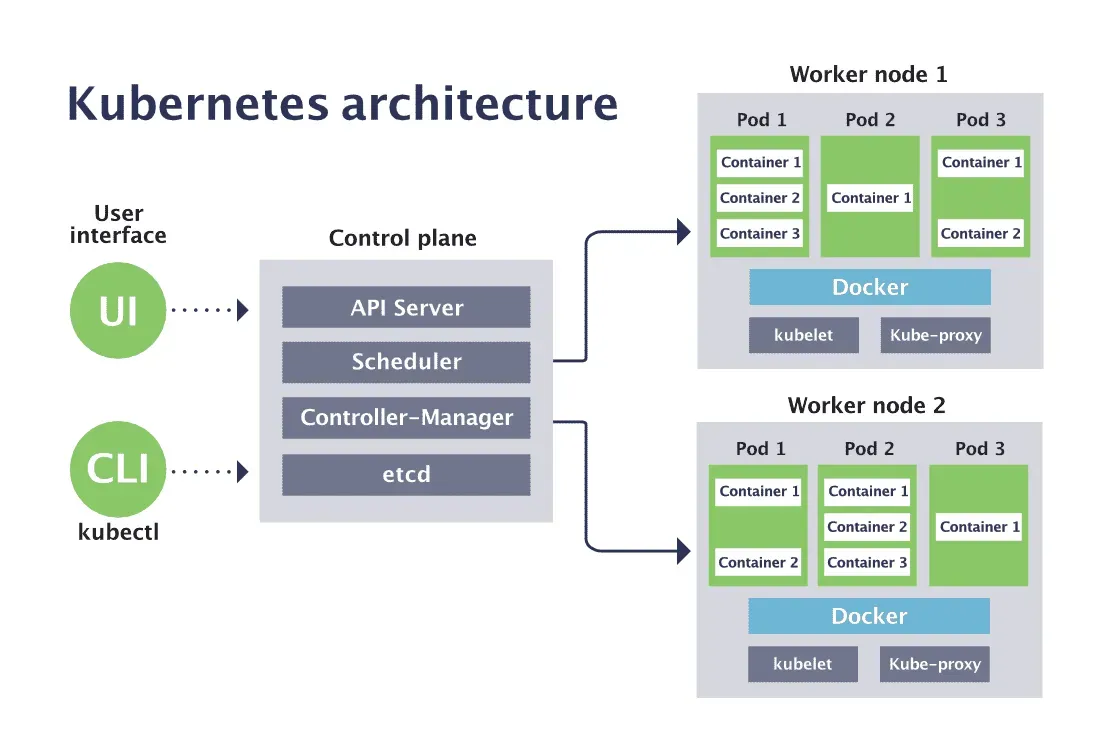
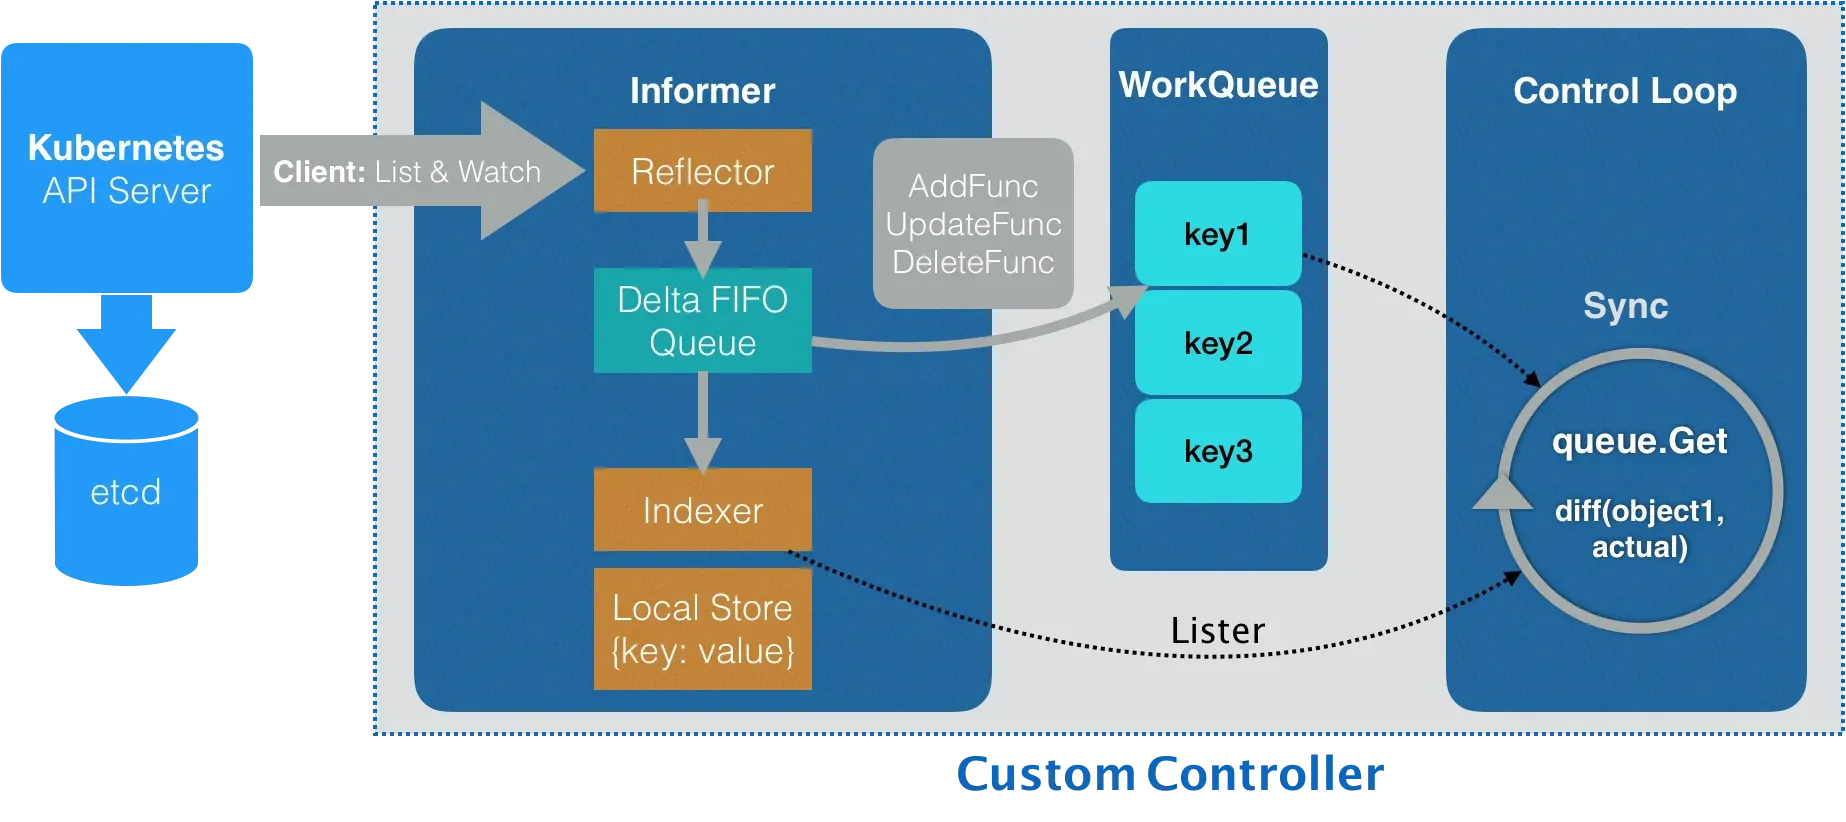
kubectl apply 或 Helm 并不会直接启动容器。请求首先进入 kube-apiserver,经过 认证、授权、准入和数据校验后,资源状态保存到 etcd。Controller 通过 API 观察 资源变化并创建或更新下游对象。
etcd 保存的是 Kubernetes 控制面状态,不是业务数据库。API Server 是资源访问 入口,etcd 是状态存储,Controller 则负责让现实逐渐符合声明,三者职责不能混淆。
二、Pod 如何成为运行中的容器
Pod 是 Kubernetes 最基本的调度与运行单元。Kubernetes 调度的是 Pod,而不是 单个 Container。
一个 Pod 通常只有一个业务容器,也可以包含多个紧密协作的容器。Pod 内的容器 共享网络命名空间、Pod IP、端口空间和挂载的 Volume,因此可以通过 localhost 通信,但不能同时监听相同端口。
%3btext-align:center%3b%7d%23mermaid-2 .edgeLabel p%7bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3b%7d%23mermaid-2 .edgeLabel rect%7bopacity:0.5%3bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bfill:rgba(232%2c232%2c232%2c 0.8)%3b%7d%23mermaid-2 .labelBkg%7bbackground-color:rgba(232%2c 232%2c 232%2c 0.5)%3b%7d%23mermaid-2 .cluster rect%7bfill:%23ffffde%3bstroke:%23aaaa33%3bstroke-width:1px%3b%7d%23mermaid-2 .cluster text%7bfill:%23333%3b%7d%23mermaid-2 .cluster span%7bcolor:%23333%3b%7d%23mermaid-2 .node .collapsed-indicator%7bfill:%23aaaa33%3bstroke:none%3bopacity:0.6%3b%7d%23mermaid-2 .node .collapsed-separator%7bstroke:%23aaaa33%3bstroke-width:0.75px%3b%7d%23mermaid-2 div.mermaidTooltip%7bposition:absolute%3btext-align:center%3bmax-width:200px%3bpadding:2px%3bfont-family:arial%2csans-serif%3bfont-size:12px%3bbackground:hsl(80%2c 100%25%2c 96.2745098039%25)%3bborder:1px solid %23aaaa33%3bborder-radius:2px%3bpointer-events:none%3bz-index:100%3b%7d%23mermaid-2 .flowchartTitleText%7btext-anchor:middle%3bfont-size:18px%3bfill:%23333%3b%7d%23mermaid-2 rect.text%7bfill:none%3bstroke-width:0%3b%7d%23mermaid-2 .icon-shape%2c%23mermaid-2 .image-shape%7bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3btext-align:center%3b%7d%23mermaid-2 .icon-shape p%2c%23mermaid-2 .image-shape p%7bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bpadding:2px%3b%7d%23mermaid-2 .icon-shape .label rect%2c%23mermaid-2 .image-shape .label rect%7bopacity:0.5%3bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bfill:rgba(232%2c232%2c232%2c 0.8)%3b%7d%23mermaid-2 .label-icon%7bdisplay:inline-block%3bheight:1em%3boverflow:visible%3bvertical-align:-0.125em%3b%7d%23mermaid-2 .node .label-icon path%7bfill:currentColor%3bstroke:revert%3bstroke-width:revert%3b%7d%23mermaid-2 .node .neo-node%7bstroke:%239370DB%3b%7d%23mermaid-2 %5bdata-look='neo'%5d.node rect%2c%23mermaid-2 %5bdata-look='neo'%5d.cluster rect%2c%23mermaid-2 %5bdata-look='neo'%5d.node polygon%7bstroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-2 %5bdata-look='neo'%5d.swimlane.cluster rect%7bfilter:none%3b%7d%23mermaid-2 %5bdata-look='neo'%5d.node path%7bstroke:%239370DB%3bstroke-width:1px%3b%7d%23mermaid-2 %5bdata-look='neo'%5d.node .outer-path%7bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-2 %5bdata-look='neo'%5d.node .neo-line path%7bstroke:%239370DB%3bfilter:none%3b%7d%23mermaid-2 %5bdata-look='neo'%5d.node circle%7bstroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-2 %5bdata-look='neo'%5d.node circle .state-start%7bfill:black%3b%7d%23mermaid-2 %5bdata-look='neo'%5d.icon-shape .icon%7bfill:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-2 %5bdata-look='neo'%5d.icon-shape .icon-neo path%7bstroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-2 :root%7b--mermaid-font-family:arial%2csans-serif%3b%7d%3c/style%3e%3cg%3e%3cmarker id='mermaid-2_flowchart-v2-pointEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'%3e%3cpath d='M 0 0 L 10 5 L 0 10 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-2_flowchart-v2-pointStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='4.5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'%3e%3cpath d='M 0 5 L 10 10 L 10 0 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-2_flowchart-v2-pointEnd-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='11.5' refY='7' markerUnits='userSpaceOnUse' markerWidth='10.5' markerHeight='14' orient='auto'%3e%3cpath d='M 0 0 L 11.5 7 L 0 14 z' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-2_flowchart-v2-pointStart-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='1' refY='7' markerUnits='userSpaceOnUse' markerWidth='11.5' markerHeight='14' orient='auto'%3e%3cpolygon points='0%2c7 11.5%2c14 11.5%2c0' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-2_flowchart-v2-circleEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='11' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-2_flowchart-v2-circleStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-1' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-2_flowchart-v2-circleEnd-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refY='5' refX='12.25' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-2_flowchart-v2-circleStart-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-2' refY='5' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-2_flowchart-v2-crossEnd' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='12' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3cpath d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-2_flowchart-v2-crossStart' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='-1' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3cpath d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-2_flowchart-v2-crossEnd-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='17.7' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'%3e%3cpath d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-2_flowchart-v2-crossStart-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='-3.5' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'%3e%3cpath d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cg class='root'%3e%3cg class='clusters'/%3e%3cg class='edgePaths'%3e%3cpath d='M153.518%2c62L144.496%2c66.167C135.473%2c70.333%2c117.428%2c78.667%2c108.405%2c86.333C99.383%2c94%2c99.383%2c101%2c99.383%2c104.5L99.383%2c108' id='mermaid-2-L_Pod_App_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_Pod_App_0' data-points='W3sieCI6MTUzLjUxODE3OTA4NjUzODQ1LCJ5Ijo2Mn0seyJ4Ijo5OS4zODI4MTI1LCJ5Ijo4N30seyJ4Ijo5OS4zODI4MTI1LCJ5IjoxMTJ9XQ==' data-look='classic' marker-end='url(%23mermaid-2_flowchart-v2-pointEnd)'/%3e%3cpath d='M270.451%2c62L279.473%2c66.167C288.496%2c70.333%2c306.541%2c78.667%2c315.563%2c86.333C324.586%2c94%2c324.586%2c101%2c324.586%2c104.5L324.586%2c108' id='mermaid-2-L_Pod_Sidecar_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_Pod_Sidecar_0' data-points='W3sieCI6MjcwLjQ1MDU3MDkxMzQ2MTU1LCJ5Ijo2Mn0seyJ4IjozMjQuNTg1OTM3NSwieSI6ODd9LHsieCI6MzI0LjU4NTkzNzUsInkiOjExMn1d' data-look='classic' marker-end='url(%23mermaid-2_flowchart-v2-pointEnd)'/%3e%3cpath d='M99.383%2c166L99.383%2c170.167C99.383%2c174.333%2c99.383%2c182.667%2c107.8%2c190.72C116.217%2c198.774%2c133.052%2c206.549%2c141.469%2c210.436L149.887%2c214.323' id='mermaid-2-L_App_Volume_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_App_Volume_0' data-points='W3sieCI6OTkuMzgyODEyNSwieSI6MTY2fSx7IngiOjk5LjM4MjgxMjUsInkiOjE5MX0seyJ4IjoxNTMuNTE4MTc5MDg2NTM4NDUsInkiOjIxNn1d' data-look='classic' marker-end='url(%23mermaid-2_flowchart-v2-pointEnd)'/%3e%3cpath d='M324.586%2c166L324.586%2c170.167C324.586%2c174.333%2c324.586%2c182.667%2c316.169%2c190.72C307.751%2c198.774%2c290.917%2c206.549%2c282.499%2c210.436L274.082%2c214.323' id='mermaid-2-L_Sidecar_Volume_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_Sidecar_Volume_0' data-points='W3sieCI6MzI0LjU4NTkzNzUsInkiOjE2Nn0seyJ4IjozMjQuNTg1OTM3NSwieSI6MTkxfSx7IngiOjI3MC40NTA1NzA5MTM0NjE1NSwieSI6MjE2fV0=' data-look='classic' marker-end='url(%23mermaid-2_flowchart-v2-pointEnd)'/%3e%3c/g%3e%3cg class='edgeLabels'%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_Pod_App_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_Pod_Sidecar_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_App_Volume_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_Sidecar_Volume_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cg class='nodes'%3e%3cg class='node default' id='mermaid-2-flowchart-Pod-0' data-look='classic' transform='translate(211.984375%2c 35)'%3e%3crect class='basic label-container' style='' x='-90.9453125' y='-27' width='181.890625' height='54'/%3e%3cg class='label' style='' transform='translate(-60.9453125%2c -12)'%3e%3crect/%3e%3cforeignObject width='121.890625' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3ePod: 10.244.3.17%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-2-flowchart-App-1' data-look='classic' transform='translate(99.3828125%2c 139)'%3e%3crect class='basic label-container' style='' x='-91.3828125' y='-27' width='182.765625' height='54'/%3e%3cg class='label' style='' transform='translate(-61.3828125%2c -12)'%3e%3crect/%3e%3cforeignObject width='122.765625' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eApplication :8080%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-2-flowchart-Sidecar-2' data-look='classic' transform='translate(324.5859375%2c 139)'%3e%3crect class='basic label-container' style='' x='-83.8203125' y='-27' width='167.640625' height='54'/%3e%3cg class='label' style='' transform='translate(-53.8203125%2c -12)'%3e%3crect/%3e%3cforeignObject width='107.640625' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eSidecar :15001%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-2-flowchart-Volume-3' data-look='classic' transform='translate(211.984375%2c 243)'%3e%3crect class='basic label-container' style='' x='-84.703125' y='-27' width='169.40625' height='54'/%3e%3cg class='label' style='' transform='translate(-54.703125%2c -12)'%3e%3crect/%3e%3cforeignObject width='109.40625' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eShared Volume%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cdefs%3e%3cfilter id='mermaid-2-drop-shadow' height='130%25' width='130%25'%3e%3cfeDropShadow dx='4' dy='4' stdDeviation='0' flood-opacity='0.06' flood-color='black'/%3e%3c/filter%3e%3c/defs%3e%3cdefs%3e%3cfilter id='mermaid-2-drop-shadow-small' height='150%25' width='150%25'%3e%3cfeDropShadow dx='2' dy='2' stdDeviation='0' flood-opacity='0.06' flood-color='black'/%3e%3c/filter%3e%3c/defs%3e%3c/svg%3e)
%3btext-align:center%3b%7d%23mermaid-dark-2%20.edgeLabel%20p%7bbackground-color:hsl(0%2c%200%25%2c%2034.4117647059%25)%3b%7d%23mermaid-dark-2%20.edgeLabel%20rect%7bopacity:0.5%3bbackground-color:hsl(0%2c%200%25%2c%2034.4117647059%25)%3bfill:hsl(0%2c%200%25%2c%2034.4117647059%25)%3b%7d%23mermaid-dark-2%20.labelBkg%7bbackground-color:rgba(87.75%2c%2087.75%2c%2087.75%2c%200.5)%3b%7d%23mermaid-dark-2%20.cluster%20rect%7bfill:hsl(180%2c%201.5873015873%25%2c%2028.3529411765%25)%3bstroke:rgba(255%2c%20255%2c%20255%2c%200.25)%3bstroke-width:1px%3b%7d%23mermaid-dark-2%20.cluster%20text%7bfill:%23F9FFFE%3b%7d%23mermaid-dark-2%20.cluster%20span%7bcolor:%23F9FFFE%3b%7d%23mermaid-dark-2%20.node%20.collapsed-indicator%7bfill:rgba(255%2c%20255%2c%20255%2c%200.25)%3bstroke:none%3bopacity:0.6%3b%7d%23mermaid-dark-2%20.node%20.collapsed-separator%7bstroke:rgba(255%2c%20255%2c%20255%2c%200.25)%3bstroke-width:0.75px%3b%7d%23mermaid-dark-2%20div.mermaidTooltip%7bposition:absolute%3btext-align:center%3bmax-width:200px%3bpadding:2px%3bfont-family:arial%2csans-serif%3bfont-size:12px%3bbackground:hsl(20%2c%201.5873015873%25%2c%2012.3529411765%25)%3bborder:1px%20solid%20rgba(255%2c%20255%2c%20255%2c%200.25)%3bborder-radius:2px%3bpointer-events:none%3bz-index:100%3b%7d%23mermaid-dark-2%20.flowchartTitleText%7btext-anchor:middle%3bfont-size:18px%3bfill:%23ccc%3b%7d%23mermaid-dark-2%20rect.text%7bfill:none%3bstroke-width:0%3b%7d%23mermaid-dark-2%20.icon-shape%2c%23mermaid-dark-2%20.image-shape%7bbackground-color:hsl(0%2c%200%25%2c%2034.4117647059%25)%3btext-align:center%3b%7d%23mermaid-dark-2%20.icon-shape%20p%2c%23mermaid-dark-2%20.image-shape%20p%7bbackground-color:hsl(0%2c%200%25%2c%2034.4117647059%25)%3bpadding:2px%3b%7d%23mermaid-dark-2%20.icon-shape%20.label%20rect%2c%23mermaid-dark-2%20.image-shape%20.label%20rect%7bopacity:0.5%3bbackground-color:hsl(0%2c%200%25%2c%2034.4117647059%25)%3bfill:hsl(0%2c%200%25%2c%2034.4117647059%25)%3b%7d%23mermaid-dark-2%20.label-icon%7bdisplay:inline-block%3bheight:1em%3boverflow:visible%3bvertical-align:-0.125em%3b%7d%23mermaid-dark-2%20.node%20.label-icon%20path%7bfill:currentColor%3bstroke:revert%3bstroke-width:revert%3b%7d%23mermaid-dark-2%20.node%20.neo-node%7bstroke:%23ccc%3b%7d%23mermaid-dark-2%20%5bdata-look='neo'%5d.node%20rect%2c%23mermaid-dark-2%20%5bdata-look='neo'%5d.cluster%20rect%2c%23mermaid-dark-2%20%5bdata-look='neo'%5d.node%20polygon%7bstroke:url(%23mermaid-dark-2-gradient)%3bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-2%20%5bdata-look='neo'%5d.swimlane.cluster%20rect%7bfilter:none%3b%7d%23mermaid-dark-2%20%5bdata-look='neo'%5d.node%20path%7bstroke:url(%23mermaid-dark-2-gradient)%3bstroke-width:1px%3b%7d%23mermaid-dark-2%20%5bdata-look='neo'%5d.node%20.outer-path%7bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-2%20%5bdata-look='neo'%5d.node%20.neo-line%20path%7bstroke:%23ccc%3bfilter:none%3b%7d%23mermaid-dark-2%20%5bdata-look='neo'%5d.node%20circle%7bstroke:url(%23mermaid-dark-2-gradient)%3bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-2%20%5bdata-look='neo'%5d.node%20circle%20.state-start%7bfill:black%3b%7d%23mermaid-dark-2%20%5bdata-look='neo'%5d.icon-shape%20.icon%7bfill:url(%23mermaid-dark-2-gradient)%3bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-2%20%5bdata-look='neo'%5d.icon-shape%20.icon-neo%20path%7bstroke:url(%23mermaid-dark-2-gradient)%3bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-2%20:root%7b--mermaid-font-family:arial%2csans-serif%3b%7d%3c/style%3e%3cg%3e%3cmarker%20id='mermaid-dark-2_flowchart-v2-pointEnd'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='5'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='8'%20markerHeight='8'%20orient='auto'%3e%3cpath%20d='M%200%200%20L%2010%205%20L%200%2010%20z'%20class='arrowMarkerPath'%20style='stroke-width:%201%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-2_flowchart-v2-pointStart'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='4.5'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='8'%20markerHeight='8'%20orient='auto'%3e%3cpath%20d='M%200%205%20L%2010%2010%20L%2010%200%20z'%20class='arrowMarkerPath'%20style='stroke-width:%201%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-2_flowchart-v2-pointEnd-margin'%20class='marker%20flowchart-v2'%20viewBox='0%200%2011.5%2014'%20refX='11.5'%20refY='7'%20markerUnits='userSpaceOnUse'%20markerWidth='10.5'%20markerHeight='14'%20orient='auto'%3e%3cpath%20d='M%200%200%20L%2011.5%207%20L%200%2014%20z'%20class='arrowMarkerPath'%20style='stroke-width:%200%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-2_flowchart-v2-pointStart-margin'%20class='marker%20flowchart-v2'%20viewBox='0%200%2011.5%2014'%20refX='1'%20refY='7'%20markerUnits='userSpaceOnUse'%20markerWidth='11.5'%20markerHeight='14'%20orient='auto'%3e%3cpolygon%20points='0%2c7%2011.5%2c14%2011.5%2c0'%20class='arrowMarkerPath'%20style='stroke-width:%200%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-2_flowchart-v2-circleEnd'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='11'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='11'%20markerHeight='11'%20orient='auto'%3e%3ccircle%20cx='5'%20cy='5'%20r='5'%20class='arrowMarkerPath'%20style='stroke-width:%201%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-2_flowchart-v2-circleStart'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='-1'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='11'%20markerHeight='11'%20orient='auto'%3e%3ccircle%20cx='5'%20cy='5'%20r='5'%20class='arrowMarkerPath'%20style='stroke-width:%201%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-2_flowchart-v2-circleEnd-margin'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refY='5'%20refX='12.25'%20markerUnits='userSpaceOnUse'%20markerWidth='14'%20markerHeight='14'%20orient='auto'%3e%3ccircle%20cx='5'%20cy='5'%20r='5'%20class='arrowMarkerPath'%20style='stroke-width:%200%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-2_flowchart-v2-circleStart-margin'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='-2'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='14'%20markerHeight='14'%20orient='auto'%3e%3ccircle%20cx='5'%20cy='5'%20r='5'%20class='arrowMarkerPath'%20style='stroke-width:%200%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-2_flowchart-v2-crossEnd'%20class='marker%20cross%20flowchart-v2'%20viewBox='0%200%2011%2011'%20refX='12'%20refY='5.2'%20markerUnits='userSpaceOnUse'%20markerWidth='11'%20markerHeight='11'%20orient='auto'%3e%3cpath%20d='M%201%2c1%20l%209%2c9%20M%2010%2c1%20l%20-9%2c9'%20class='arrowMarkerPath'%20style='stroke-width:%202%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-2_flowchart-v2-crossStart'%20class='marker%20cross%20flowchart-v2'%20viewBox='0%200%2011%2011'%20refX='-1'%20refY='5.2'%20markerUnits='userSpaceOnUse'%20markerWidth='11'%20markerHeight='11'%20orient='auto'%3e%3cpath%20d='M%201%2c1%20l%209%2c9%20M%2010%2c1%20l%20-9%2c9'%20class='arrowMarkerPath'%20style='stroke-width:%202%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-2_flowchart-v2-crossEnd-margin'%20class='marker%20cross%20flowchart-v2'%20viewBox='0%200%2015%2015'%20refX='17.7'%20refY='7.5'%20markerUnits='userSpaceOnUse'%20markerWidth='12'%20markerHeight='12'%20orient='auto'%3e%3cpath%20d='M%201%2c1%20L%2014%2c14%20M%201%2c14%20L%2014%2c1'%20class='arrowMarkerPath'%20style='stroke-width:%202.5%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-2_flowchart-v2-crossStart-margin'%20class='marker%20cross%20flowchart-v2'%20viewBox='0%200%2015%2015'%20refX='-3.5'%20refY='7.5'%20markerUnits='userSpaceOnUse'%20markerWidth='12'%20markerHeight='12'%20orient='auto'%3e%3cpath%20d='M%201%2c1%20L%2014%2c14%20M%201%2c14%20L%2014%2c1'%20class='arrowMarkerPath'%20style='stroke-width:%202.5%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cg%20class='root'%3e%3cg%20class='clusters'/%3e%3cg%20class='edgePaths'%3e%3cpath%20d='M153.518%2c62L144.496%2c66.167C135.473%2c70.333%2c117.428%2c78.667%2c108.405%2c86.333C99.383%2c94%2c99.383%2c101%2c99.383%2c104.5L99.383%2c108'%20id='mermaid-dark-2-L_Pod_App_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_Pod_App_0'%20data-points='W3sieCI6MTUzLjUxODE3OTA4NjUzODQ1LCJ5Ijo2Mn0seyJ4Ijo5OS4zODI4MTI1LCJ5Ijo4N30seyJ4Ijo5OS4zODI4MTI1LCJ5IjoxMTJ9XQ=='%20data-look='classic'%20marker-end='url(%23mermaid-dark-2_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M270.451%2c62L279.473%2c66.167C288.496%2c70.333%2c306.541%2c78.667%2c315.563%2c86.333C324.586%2c94%2c324.586%2c101%2c324.586%2c104.5L324.586%2c108'%20id='mermaid-dark-2-L_Pod_Sidecar_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_Pod_Sidecar_0'%20data-points='W3sieCI6MjcwLjQ1MDU3MDkxMzQ2MTU1LCJ5Ijo2Mn0seyJ4IjozMjQuNTg1OTM3NSwieSI6ODd9LHsieCI6MzI0LjU4NTkzNzUsInkiOjExMn1d'%20data-look='classic'%20marker-end='url(%23mermaid-dark-2_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M99.383%2c166L99.383%2c170.167C99.383%2c174.333%2c99.383%2c182.667%2c107.8%2c190.72C116.217%2c198.774%2c133.052%2c206.549%2c141.469%2c210.436L149.887%2c214.323'%20id='mermaid-dark-2-L_App_Volume_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_App_Volume_0'%20data-points='W3sieCI6OTkuMzgyODEyNSwieSI6MTY2fSx7IngiOjk5LjM4MjgxMjUsInkiOjE5MX0seyJ4IjoxNTMuNTE4MTc5MDg2NTM4NDUsInkiOjIxNn1d'%20data-look='classic'%20marker-end='url(%23mermaid-dark-2_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M324.586%2c166L324.586%2c170.167C324.586%2c174.333%2c324.586%2c182.667%2c316.169%2c190.72C307.751%2c198.774%2c290.917%2c206.549%2c282.499%2c210.436L274.082%2c214.323'%20id='mermaid-dark-2-L_Sidecar_Volume_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_Sidecar_Volume_0'%20data-points='W3sieCI6MzI0LjU4NTkzNzUsInkiOjE2Nn0seyJ4IjozMjQuNTg1OTM3NSwieSI6MTkxfSx7IngiOjI3MC40NTA1NzA5MTM0NjE1NSwieSI6MjE2fV0='%20data-look='classic'%20marker-end='url(%23mermaid-dark-2_flowchart-v2-pointEnd)'/%3e%3c/g%3e%3cg%20class='edgeLabels'%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_Pod_App_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_Pod_Sidecar_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_App_Volume_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_Sidecar_Volume_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cg%20class='nodes'%3e%3cg%20class='node%20default'%20id='mermaid-dark-2-flowchart-Pod-0'%20data-look='classic'%20transform='translate(211.984375%2c%2035)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-90.9453125'%20y='-27'%20width='181.890625'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-60.9453125%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='121.890625'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3ePod:%2010.244.3.17%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-2-flowchart-App-1'%20data-look='classic'%20transform='translate(99.3828125%2c%20139)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-91.3828125'%20y='-27'%20width='182.765625'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-61.3828125%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='122.765625'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3eApplication%20:8080%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-2-flowchart-Sidecar-2'%20data-look='classic'%20transform='translate(324.5859375%2c%20139)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-83.8203125'%20y='-27'%20width='167.640625'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-53.8203125%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='107.640625'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3eSidecar%20:15001%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-2-flowchart-Volume-3'%20data-look='classic'%20transform='translate(211.984375%2c%20243)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-84.703125'%20y='-27'%20width='169.40625'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-54.703125%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='109.40625'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3eShared%20Volume%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cdefs%3e%3cfilter%20id='mermaid-dark-2-drop-shadow'%20height='130%25'%20width='130%25'%3e%3cfeDropShadow%20dx='4'%20dy='4'%20stdDeviation='0'%20flood-opacity='0.06'%20flood-color='white'/%3e%3c/filter%3e%3c/defs%3e%3cdefs%3e%3cfilter%20id='mermaid-dark-2-drop-shadow-small'%20height='150%25'%20width='150%25'%3e%3cfeDropShadow%20dx='2'%20dy='2'%20stdDeviation='0'%20flood-opacity='0.06'%20flood-color='white'/%3e%3c/filter%3e%3c/defs%3e%3clinearGradient%20id='mermaid-dark-2-gradient'%20gradientUnits='objectBoundingBox'%20x1='0%25'%20y1='0%25'%20x2='100%25'%20y2='0%25'%3e%3cstop%20offset='0%25'%20stop-color='%23cccccc'%20stop-opacity='1'/%3e%3cstop%20offset='100%25'%20stop-color='hsl(180%2c%200%25%2c%2018.3529411765%25)'%20stop-opacity='1'/%3e%3c/linearGradient%3e%3c/svg%3e)
Sidecar 适合代理、日志处理和配置同步等与主程序生命周期紧密相关的能力,但不应 把所有辅助组件都塞进一个 Pod。只有需要共享网络、存储或生命周期的容器才适合 组合在一起。
从 PodSpec 到 Container
Pod 创建时通常还没有绑定 Node。kube-scheduler 根据资源请求、节点状态、亲和 与反亲和、Taint 和 Toleration 等约束选择节点。节点上的 kubelet 获取 PodSpec, 再通过 CRI 调用 containerd 等运行时拉取镜像并启动容器。
%3btext-align:center%3b%7d%23mermaid-3 .edgeLabel p%7bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3b%7d%23mermaid-3 .edgeLabel rect%7bopacity:0.5%3bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bfill:rgba(232%2c232%2c232%2c 0.8)%3b%7d%23mermaid-3 .labelBkg%7bbackground-color:rgba(232%2c 232%2c 232%2c 0.5)%3b%7d%23mermaid-3 .cluster rect%7bfill:%23ffffde%3bstroke:%23aaaa33%3bstroke-width:1px%3b%7d%23mermaid-3 .cluster text%7bfill:%23333%3b%7d%23mermaid-3 .cluster span%7bcolor:%23333%3b%7d%23mermaid-3 .node .collapsed-indicator%7bfill:%23aaaa33%3bstroke:none%3bopacity:0.6%3b%7d%23mermaid-3 .node .collapsed-separator%7bstroke:%23aaaa33%3bstroke-width:0.75px%3b%7d%23mermaid-3 div.mermaidTooltip%7bposition:absolute%3btext-align:center%3bmax-width:200px%3bpadding:2px%3bfont-family:arial%2csans-serif%3bfont-size:12px%3bbackground:hsl(80%2c 100%25%2c 96.2745098039%25)%3bborder:1px solid %23aaaa33%3bborder-radius:2px%3bpointer-events:none%3bz-index:100%3b%7d%23mermaid-3 .flowchartTitleText%7btext-anchor:middle%3bfont-size:18px%3bfill:%23333%3b%7d%23mermaid-3 rect.text%7bfill:none%3bstroke-width:0%3b%7d%23mermaid-3 .icon-shape%2c%23mermaid-3 .image-shape%7bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3btext-align:center%3b%7d%23mermaid-3 .icon-shape p%2c%23mermaid-3 .image-shape p%7bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bpadding:2px%3b%7d%23mermaid-3 .icon-shape .label rect%2c%23mermaid-3 .image-shape .label rect%7bopacity:0.5%3bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bfill:rgba(232%2c232%2c232%2c 0.8)%3b%7d%23mermaid-3 .label-icon%7bdisplay:inline-block%3bheight:1em%3boverflow:visible%3bvertical-align:-0.125em%3b%7d%23mermaid-3 .node .label-icon path%7bfill:currentColor%3bstroke:revert%3bstroke-width:revert%3b%7d%23mermaid-3 .node .neo-node%7bstroke:%239370DB%3b%7d%23mermaid-3 %5bdata-look='neo'%5d.node rect%2c%23mermaid-3 %5bdata-look='neo'%5d.cluster rect%2c%23mermaid-3 %5bdata-look='neo'%5d.node polygon%7bstroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-3 %5bdata-look='neo'%5d.swimlane.cluster rect%7bfilter:none%3b%7d%23mermaid-3 %5bdata-look='neo'%5d.node path%7bstroke:%239370DB%3bstroke-width:1px%3b%7d%23mermaid-3 %5bdata-look='neo'%5d.node .outer-path%7bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-3 %5bdata-look='neo'%5d.node .neo-line path%7bstroke:%239370DB%3bfilter:none%3b%7d%23mermaid-3 %5bdata-look='neo'%5d.node circle%7bstroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-3 %5bdata-look='neo'%5d.node circle .state-start%7bfill:black%3b%7d%23mermaid-3 %5bdata-look='neo'%5d.icon-shape .icon%7bfill:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-3 %5bdata-look='neo'%5d.icon-shape .icon-neo path%7bstroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-3 :root%7b--mermaid-font-family:arial%2csans-serif%3b%7d%3c/style%3e%3cg%3e%3cmarker id='mermaid-3_flowchart-v2-pointEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'%3e%3cpath d='M 0 0 L 10 5 L 0 10 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-3_flowchart-v2-pointStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='4.5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'%3e%3cpath d='M 0 5 L 10 10 L 10 0 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-3_flowchart-v2-pointEnd-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='11.5' refY='7' markerUnits='userSpaceOnUse' markerWidth='10.5' markerHeight='14' orient='auto'%3e%3cpath d='M 0 0 L 11.5 7 L 0 14 z' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-3_flowchart-v2-pointStart-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='1' refY='7' markerUnits='userSpaceOnUse' markerWidth='11.5' markerHeight='14' orient='auto'%3e%3cpolygon points='0%2c7 11.5%2c14 11.5%2c0' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-3_flowchart-v2-circleEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='11' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-3_flowchart-v2-circleStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-1' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-3_flowchart-v2-circleEnd-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refY='5' refX='12.25' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-3_flowchart-v2-circleStart-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-2' refY='5' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-3_flowchart-v2-crossEnd' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='12' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3cpath d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-3_flowchart-v2-crossStart' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='-1' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3cpath d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-3_flowchart-v2-crossEnd-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='17.7' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'%3e%3cpath d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-3_flowchart-v2-crossStart-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='-3.5' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'%3e%3cpath d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cg class='root'%3e%3cg class='clusters'/%3e%3cg class='edgePaths'%3e%3cpath d='M145.359%2c35L149.526%2c35C153.693%2c35%2c162.026%2c35%2c169.693%2c35C177.359%2c35%2c184.359%2c35%2c187.859%2c35L191.359%2c35' id='mermaid-3-L_API_Pod_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_API_Pod_0' data-points='W3sieCI6MTQ1LjM1OTM3NSwieSI6MzV9LHsieCI6MTcwLjM1OTM3NSwieSI6MzV9LHsieCI6MTk1LjM1OTM3NSwieSI6MzV9XQ==' data-look='classic' marker-end='url(%23mermaid-3_flowchart-v2-pointEnd)'/%3e%3cpath d='M347%2c35L351.167%2c35C355.333%2c35%2c363.667%2c35%2c371.333%2c35C379%2c35%2c386%2c35%2c389.5%2c35L393%2c35' id='mermaid-3-L_Pod_Scheduler_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_Pod_Scheduler_0' data-points='W3sieCI6MzQ3LCJ5IjozNX0seyJ4IjozNzIsInkiOjM1fSx7IngiOjM5NywieSI6MzV9XQ==' data-look='classic' marker-end='url(%23mermaid-3_flowchart-v2-pointEnd)'/%3e%3cpath d='M566.406%2c35L570.573%2c35C574.74%2c35%2c583.073%2c35%2c590.74%2c35C598.406%2c35%2c605.406%2c35%2c608.906%2c35L612.406%2c35' id='mermaid-3-L_Scheduler_Node_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_Scheduler_Node_0' data-points='W3sieCI6NTY2LjQwNjI1LCJ5IjozNX0seyJ4Ijo1OTEuNDA2MjUsInkiOjM1fSx7IngiOjYxNi40MDYyNSwieSI6MzV9XQ==' data-look='classic' marker-end='url(%23mermaid-3_flowchart-v2-pointEnd)'/%3e%3cpath d='M781.375%2c35L785.542%2c35C789.708%2c35%2c798.042%2c35%2c805.708%2c35C813.375%2c35%2c820.375%2c35%2c823.875%2c35L827.375%2c35' id='mermaid-3-L_Node_Kubelet_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_Node_Kubelet_0' data-points='W3sieCI6NzgxLjM3NSwieSI6MzV9LHsieCI6ODA2LjM3NSwieSI6MzV9LHsieCI6ODMxLjM3NSwieSI6MzV9XQ==' data-look='classic' marker-end='url(%23mermaid-3_flowchart-v2-pointEnd)'/%3e%3cpath d='M942.969%2c35L947.135%2c35C951.302%2c35%2c959.635%2c35%2c967.302%2c35C974.969%2c35%2c981.969%2c35%2c985.469%2c35L988.969%2c35' id='mermaid-3-L_Kubelet_CRI_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_Kubelet_CRI_0' data-points='W3sieCI6OTQyLjk2ODc1LCJ5IjozNX0seyJ4Ijo5NjcuOTY4NzUsInkiOjM1fSx7IngiOjk5Mi45Njg3NSwieSI6MzV9XQ==' data-look='classic' marker-end='url(%23mermaid-3_flowchart-v2-pointEnd)'/%3e%3cpath d='M1080.531%2c35L1084.698%2c35C1088.865%2c35%2c1097.198%2c35%2c1104.865%2c35C1112.531%2c35%2c1119.531%2c35%2c1123.031%2c35L1126.531%2c35' id='mermaid-3-L_CRI_Runtime_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_CRI_Runtime_0' data-points='W3sieCI6MTA4MC41MzEyNSwieSI6MzV9LHsieCI6MTEwNS41MzEyNSwieSI6MzV9LHsieCI6MTEzMC41MzEyNSwieSI6MzV9XQ==' data-look='classic' marker-end='url(%23mermaid-3_flowchart-v2-pointEnd)'/%3e%3cpath d='M1265.25%2c35L1269.417%2c35C1273.583%2c35%2c1281.917%2c35%2c1289.583%2c35C1297.25%2c35%2c1304.25%2c35%2c1307.75%2c35L1311.25%2c35' id='mermaid-3-L_Runtime_Container_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_Runtime_Container_0' data-points='W3sieCI6MTI2NS4yNSwieSI6MzV9LHsieCI6MTI5MC4yNSwieSI6MzV9LHsieCI6MTMxNS4yNSwieSI6MzV9XQ==' data-look='classic' marker-end='url(%23mermaid-3_flowchart-v2-pointEnd)'/%3e%3c/g%3e%3cg class='edgeLabels'%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_API_Pod_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_Pod_Scheduler_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_Scheduler_Node_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_Node_Kubelet_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_Kubelet_CRI_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_CRI_Runtime_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_Runtime_Container_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cg class='nodes'%3e%3cg class='node default' id='mermaid-3-flowchart-API-0' data-look='classic' transform='translate(76.6796875%2c 35)'%3e%3crect class='basic label-container' style='' x='-68.6796875' y='-27' width='137.359375' height='54'/%3e%3cg class='label' style='' transform='translate(-38.6796875%2c -12)'%3e%3crect/%3e%3cforeignObject width='77.359375' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eAPI Server%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-3-flowchart-Pod-1' data-look='classic' transform='translate(271.1796875%2c 35)'%3e%3crect class='basic label-container' style='' x='-75.8203125' y='-27' width='151.640625' height='54'/%3e%3cg class='label' style='' transform='translate(-45.8203125%2c -12)'%3e%3crect/%3e%3cforeignObject width='91.640625' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3ePending Pod%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-3-flowchart-Scheduler-3' data-look='classic' transform='translate(481.703125%2c 35)'%3e%3crect class='basic label-container' style='' x='-84.703125' y='-27' width='169.40625' height='54'/%3e%3cg class='label' style='' transform='translate(-54.703125%2c -12)'%3e%3crect/%3e%3cforeignObject width='109.40625' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3ekube-scheduler%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-3-flowchart-Node-5' data-look='classic' transform='translate(698.890625%2c 35)'%3e%3crect class='basic label-container' style='' x='-82.484375' y='-27' width='164.96875' height='54'/%3e%3cg class='label' style='' transform='translate(-52.484375%2c -12)'%3e%3crect/%3e%3cforeignObject width='104.96875' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eSelected Node%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-3-flowchart-Kubelet-7' data-look='classic' transform='translate(887.171875%2c 35)'%3e%3crect class='basic label-container' style='' x='-55.796875' y='-27' width='111.59375' height='54'/%3e%3cg class='label' style='' transform='translate(-25.796875%2c -12)'%3e%3crect/%3e%3cforeignObject width='51.59375' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3ekubelet%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-3-flowchart-CRI-9' data-look='classic' transform='translate(1036.75%2c 35)'%3e%3crect class='basic label-container' style='' x='-43.78125' y='-27' width='87.5625' height='54'/%3e%3cg class='label' style='' transform='translate(-13.78125%2c -12)'%3e%3crect/%3e%3cforeignObject width='27.5625' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eCRI%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-3-flowchart-Runtime-11' data-look='classic' transform='translate(1197.890625%2c 35)'%3e%3crect class='basic label-container' style='' x='-67.359375' y='-27' width='134.71875' height='54'/%3e%3cg class='label' style='' transform='translate(-37.359375%2c -12)'%3e%3crect/%3e%3cforeignObject width='74.71875' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3econtainerd%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-3-flowchart-Container-13' data-look='classic' transform='translate(1379.9375%2c 35)'%3e%3crect class='basic label-container' style='' x='-64.6875' y='-27' width='129.375' height='54'/%3e%3cg class='label' style='' transform='translate(-34.6875%2c -12)'%3e%3crect/%3e%3cforeignObject width='69.375' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eContainer%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cdefs%3e%3cfilter id='mermaid-3-drop-shadow' height='130%25' width='130%25'%3e%3cfeDropShadow dx='4' dy='4' stdDeviation='0' flood-opacity='0.06' flood-color='black'/%3e%3c/filter%3e%3c/defs%3e%3cdefs%3e%3cfilter id='mermaid-3-drop-shadow-small' height='150%25' width='150%25'%3e%3cfeDropShadow dx='2' dy='2' stdDeviation='0' flood-opacity='0.06' flood-color='black'/%3e%3c/filter%3e%3c/defs%3e%3c/svg%3e)
%3btext-align:center%3b%7d%23mermaid-dark-3%20.edgeLabel%20p%7bbackground-color:hsl(0%2c%200%25%2c%2034.4117647059%25)%3b%7d%23mermaid-dark-3%20.edgeLabel%20rect%7bopacity:0.5%3bbackground-color:hsl(0%2c%200%25%2c%2034.4117647059%25)%3bfill:hsl(0%2c%200%25%2c%2034.4117647059%25)%3b%7d%23mermaid-dark-3%20.labelBkg%7bbackground-color:rgba(87.75%2c%2087.75%2c%2087.75%2c%200.5)%3b%7d%23mermaid-dark-3%20.cluster%20rect%7bfill:hsl(180%2c%201.5873015873%25%2c%2028.3529411765%25)%3bstroke:rgba(255%2c%20255%2c%20255%2c%200.25)%3bstroke-width:1px%3b%7d%23mermaid-dark-3%20.cluster%20text%7bfill:%23F9FFFE%3b%7d%23mermaid-dark-3%20.cluster%20span%7bcolor:%23F9FFFE%3b%7d%23mermaid-dark-3%20.node%20.collapsed-indicator%7bfill:rgba(255%2c%20255%2c%20255%2c%200.25)%3bstroke:none%3bopacity:0.6%3b%7d%23mermaid-dark-3%20.node%20.collapsed-separator%7bstroke:rgba(255%2c%20255%2c%20255%2c%200.25)%3bstroke-width:0.75px%3b%7d%23mermaid-dark-3%20div.mermaidTooltip%7bposition:absolute%3btext-align:center%3bmax-width:200px%3bpadding:2px%3bfont-family:arial%2csans-serif%3bfont-size:12px%3bbackground:hsl(20%2c%201.5873015873%25%2c%2012.3529411765%25)%3bborder:1px%20solid%20rgba(255%2c%20255%2c%20255%2c%200.25)%3bborder-radius:2px%3bpointer-events:none%3bz-index:100%3b%7d%23mermaid-dark-3%20.flowchartTitleText%7btext-anchor:middle%3bfont-size:18px%3bfill:%23ccc%3b%7d%23mermaid-dark-3%20rect.text%7bfill:none%3bstroke-width:0%3b%7d%23mermaid-dark-3%20.icon-shape%2c%23mermaid-dark-3%20.image-shape%7bbackground-color:hsl(0%2c%200%25%2c%2034.4117647059%25)%3btext-align:center%3b%7d%23mermaid-dark-3%20.icon-shape%20p%2c%23mermaid-dark-3%20.image-shape%20p%7bbackground-color:hsl(0%2c%200%25%2c%2034.4117647059%25)%3bpadding:2px%3b%7d%23mermaid-dark-3%20.icon-shape%20.label%20rect%2c%23mermaid-dark-3%20.image-shape%20.label%20rect%7bopacity:0.5%3bbackground-color:hsl(0%2c%200%25%2c%2034.4117647059%25)%3bfill:hsl(0%2c%200%25%2c%2034.4117647059%25)%3b%7d%23mermaid-dark-3%20.label-icon%7bdisplay:inline-block%3bheight:1em%3boverflow:visible%3bvertical-align:-0.125em%3b%7d%23mermaid-dark-3%20.node%20.label-icon%20path%7bfill:currentColor%3bstroke:revert%3bstroke-width:revert%3b%7d%23mermaid-dark-3%20.node%20.neo-node%7bstroke:%23ccc%3b%7d%23mermaid-dark-3%20%5bdata-look='neo'%5d.node%20rect%2c%23mermaid-dark-3%20%5bdata-look='neo'%5d.cluster%20rect%2c%23mermaid-dark-3%20%5bdata-look='neo'%5d.node%20polygon%7bstroke:url(%23mermaid-dark-3-gradient)%3bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-3%20%5bdata-look='neo'%5d.swimlane.cluster%20rect%7bfilter:none%3b%7d%23mermaid-dark-3%20%5bdata-look='neo'%5d.node%20path%7bstroke:url(%23mermaid-dark-3-gradient)%3bstroke-width:1px%3b%7d%23mermaid-dark-3%20%5bdata-look='neo'%5d.node%20.outer-path%7bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-3%20%5bdata-look='neo'%5d.node%20.neo-line%20path%7bstroke:%23ccc%3bfilter:none%3b%7d%23mermaid-dark-3%20%5bdata-look='neo'%5d.node%20circle%7bstroke:url(%23mermaid-dark-3-gradient)%3bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-3%20%5bdata-look='neo'%5d.node%20circle%20.state-start%7bfill:black%3b%7d%23mermaid-dark-3%20%5bdata-look='neo'%5d.icon-shape%20.icon%7bfill:url(%23mermaid-dark-3-gradient)%3bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-3%20%5bdata-look='neo'%5d.icon-shape%20.icon-neo%20path%7bstroke:url(%23mermaid-dark-3-gradient)%3bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-3%20:root%7b--mermaid-font-family:arial%2csans-serif%3b%7d%3c/style%3e%3cg%3e%3cmarker%20id='mermaid-dark-3_flowchart-v2-pointEnd'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='5'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='8'%20markerHeight='8'%20orient='auto'%3e%3cpath%20d='M%200%200%20L%2010%205%20L%200%2010%20z'%20class='arrowMarkerPath'%20style='stroke-width:%201%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-3_flowchart-v2-pointStart'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='4.5'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='8'%20markerHeight='8'%20orient='auto'%3e%3cpath%20d='M%200%205%20L%2010%2010%20L%2010%200%20z'%20class='arrowMarkerPath'%20style='stroke-width:%201%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-3_flowchart-v2-pointEnd-margin'%20class='marker%20flowchart-v2'%20viewBox='0%200%2011.5%2014'%20refX='11.5'%20refY='7'%20markerUnits='userSpaceOnUse'%20markerWidth='10.5'%20markerHeight='14'%20orient='auto'%3e%3cpath%20d='M%200%200%20L%2011.5%207%20L%200%2014%20z'%20class='arrowMarkerPath'%20style='stroke-width:%200%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-3_flowchart-v2-pointStart-margin'%20class='marker%20flowchart-v2'%20viewBox='0%200%2011.5%2014'%20refX='1'%20refY='7'%20markerUnits='userSpaceOnUse'%20markerWidth='11.5'%20markerHeight='14'%20orient='auto'%3e%3cpolygon%20points='0%2c7%2011.5%2c14%2011.5%2c0'%20class='arrowMarkerPath'%20style='stroke-width:%200%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-3_flowchart-v2-circleEnd'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='11'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='11'%20markerHeight='11'%20orient='auto'%3e%3ccircle%20cx='5'%20cy='5'%20r='5'%20class='arrowMarkerPath'%20style='stroke-width:%201%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-3_flowchart-v2-circleStart'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='-1'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='11'%20markerHeight='11'%20orient='auto'%3e%3ccircle%20cx='5'%20cy='5'%20r='5'%20class='arrowMarkerPath'%20style='stroke-width:%201%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-3_flowchart-v2-circleEnd-margin'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refY='5'%20refX='12.25'%20markerUnits='userSpaceOnUse'%20markerWidth='14'%20markerHeight='14'%20orient='auto'%3e%3ccircle%20cx='5'%20cy='5'%20r='5'%20class='arrowMarkerPath'%20style='stroke-width:%200%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-3_flowchart-v2-circleStart-margin'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='-2'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='14'%20markerHeight='14'%20orient='auto'%3e%3ccircle%20cx='5'%20cy='5'%20r='5'%20class='arrowMarkerPath'%20style='stroke-width:%200%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-3_flowchart-v2-crossEnd'%20class='marker%20cross%20flowchart-v2'%20viewBox='0%200%2011%2011'%20refX='12'%20refY='5.2'%20markerUnits='userSpaceOnUse'%20markerWidth='11'%20markerHeight='11'%20orient='auto'%3e%3cpath%20d='M%201%2c1%20l%209%2c9%20M%2010%2c1%20l%20-9%2c9'%20class='arrowMarkerPath'%20style='stroke-width:%202%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-3_flowchart-v2-crossStart'%20class='marker%20cross%20flowchart-v2'%20viewBox='0%200%2011%2011'%20refX='-1'%20refY='5.2'%20markerUnits='userSpaceOnUse'%20markerWidth='11'%20markerHeight='11'%20orient='auto'%3e%3cpath%20d='M%201%2c1%20l%209%2c9%20M%2010%2c1%20l%20-9%2c9'%20class='arrowMarkerPath'%20style='stroke-width:%202%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-3_flowchart-v2-crossEnd-margin'%20class='marker%20cross%20flowchart-v2'%20viewBox='0%200%2015%2015'%20refX='17.7'%20refY='7.5'%20markerUnits='userSpaceOnUse'%20markerWidth='12'%20markerHeight='12'%20orient='auto'%3e%3cpath%20d='M%201%2c1%20L%2014%2c14%20M%201%2c14%20L%2014%2c1'%20class='arrowMarkerPath'%20style='stroke-width:%202.5%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-3_flowchart-v2-crossStart-margin'%20class='marker%20cross%20flowchart-v2'%20viewBox='0%200%2015%2015'%20refX='-3.5'%20refY='7.5'%20markerUnits='userSpaceOnUse'%20markerWidth='12'%20markerHeight='12'%20orient='auto'%3e%3cpath%20d='M%201%2c1%20L%2014%2c14%20M%201%2c14%20L%2014%2c1'%20class='arrowMarkerPath'%20style='stroke-width:%202.5%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cg%20class='root'%3e%3cg%20class='clusters'/%3e%3cg%20class='edgePaths'%3e%3cpath%20d='M145.359%2c35L149.526%2c35C153.693%2c35%2c162.026%2c35%2c169.693%2c35C177.359%2c35%2c184.359%2c35%2c187.859%2c35L191.359%2c35'%20id='mermaid-dark-3-L_API_Pod_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_API_Pod_0'%20data-points='W3sieCI6MTQ1LjM1OTM3NSwieSI6MzV9LHsieCI6MTcwLjM1OTM3NSwieSI6MzV9LHsieCI6MTk1LjM1OTM3NSwieSI6MzV9XQ=='%20data-look='classic'%20marker-end='url(%23mermaid-dark-3_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M347%2c35L351.167%2c35C355.333%2c35%2c363.667%2c35%2c371.333%2c35C379%2c35%2c386%2c35%2c389.5%2c35L393%2c35'%20id='mermaid-dark-3-L_Pod_Scheduler_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_Pod_Scheduler_0'%20data-points='W3sieCI6MzQ3LCJ5IjozNX0seyJ4IjozNzIsInkiOjM1fSx7IngiOjM5NywieSI6MzV9XQ=='%20data-look='classic'%20marker-end='url(%23mermaid-dark-3_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M566.406%2c35L570.573%2c35C574.74%2c35%2c583.073%2c35%2c590.74%2c35C598.406%2c35%2c605.406%2c35%2c608.906%2c35L612.406%2c35'%20id='mermaid-dark-3-L_Scheduler_Node_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_Scheduler_Node_0'%20data-points='W3sieCI6NTY2LjQwNjI1LCJ5IjozNX0seyJ4Ijo1OTEuNDA2MjUsInkiOjM1fSx7IngiOjYxNi40MDYyNSwieSI6MzV9XQ=='%20data-look='classic'%20marker-end='url(%23mermaid-dark-3_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M781.375%2c35L785.542%2c35C789.708%2c35%2c798.042%2c35%2c805.708%2c35C813.375%2c35%2c820.375%2c35%2c823.875%2c35L827.375%2c35'%20id='mermaid-dark-3-L_Node_Kubelet_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_Node_Kubelet_0'%20data-points='W3sieCI6NzgxLjM3NSwieSI6MzV9LHsieCI6ODA2LjM3NSwieSI6MzV9LHsieCI6ODMxLjM3NSwieSI6MzV9XQ=='%20data-look='classic'%20marker-end='url(%23mermaid-dark-3_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M942.969%2c35L947.135%2c35C951.302%2c35%2c959.635%2c35%2c967.302%2c35C974.969%2c35%2c981.969%2c35%2c985.469%2c35L988.969%2c35'%20id='mermaid-dark-3-L_Kubelet_CRI_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_Kubelet_CRI_0'%20data-points='W3sieCI6OTQyLjk2ODc1LCJ5IjozNX0seyJ4Ijo5NjcuOTY4NzUsInkiOjM1fSx7IngiOjk5Mi45Njg3NSwieSI6MzV9XQ=='%20data-look='classic'%20marker-end='url(%23mermaid-dark-3_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M1080.531%2c35L1084.698%2c35C1088.865%2c35%2c1097.198%2c35%2c1104.865%2c35C1112.531%2c35%2c1119.531%2c35%2c1123.031%2c35L1126.531%2c35'%20id='mermaid-dark-3-L_CRI_Runtime_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_CRI_Runtime_0'%20data-points='W3sieCI6MTA4MC41MzEyNSwieSI6MzV9LHsieCI6MTEwNS41MzEyNSwieSI6MzV9LHsieCI6MTEzMC41MzEyNSwieSI6MzV9XQ=='%20data-look='classic'%20marker-end='url(%23mermaid-dark-3_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M1265.25%2c35L1269.417%2c35C1273.583%2c35%2c1281.917%2c35%2c1289.583%2c35C1297.25%2c35%2c1304.25%2c35%2c1307.75%2c35L1311.25%2c35'%20id='mermaid-dark-3-L_Runtime_Container_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_Runtime_Container_0'%20data-points='W3sieCI6MTI2NS4yNSwieSI6MzV9LHsieCI6MTI5MC4yNSwieSI6MzV9LHsieCI6MTMxNS4yNSwieSI6MzV9XQ=='%20data-look='classic'%20marker-end='url(%23mermaid-dark-3_flowchart-v2-pointEnd)'/%3e%3c/g%3e%3cg%20class='edgeLabels'%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_API_Pod_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_Pod_Scheduler_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_Scheduler_Node_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_Node_Kubelet_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_Kubelet_CRI_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_CRI_Runtime_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_Runtime_Container_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cg%20class='nodes'%3e%3cg%20class='node%20default'%20id='mermaid-dark-3-flowchart-API-0'%20data-look='classic'%20transform='translate(76.6796875%2c%2035)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-68.6796875'%20y='-27'%20width='137.359375'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-38.6796875%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='77.359375'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3eAPI%20Server%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-3-flowchart-Pod-1'%20data-look='classic'%20transform='translate(271.1796875%2c%2035)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-75.8203125'%20y='-27'%20width='151.640625'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-45.8203125%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='91.640625'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3ePending%20Pod%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-3-flowchart-Scheduler-3'%20data-look='classic'%20transform='translate(481.703125%2c%2035)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-84.703125'%20y='-27'%20width='169.40625'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-54.703125%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='109.40625'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3ekube-scheduler%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-3-flowchart-Node-5'%20data-look='classic'%20transform='translate(698.890625%2c%2035)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-82.484375'%20y='-27'%20width='164.96875'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-52.484375%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='104.96875'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3eSelected%20Node%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-3-flowchart-Kubelet-7'%20data-look='classic'%20transform='translate(887.171875%2c%2035)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-55.796875'%20y='-27'%20width='111.59375'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-25.796875%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='51.59375'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3ekubelet%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-3-flowchart-CRI-9'%20data-look='classic'%20transform='translate(1036.75%2c%2035)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-43.78125'%20y='-27'%20width='87.5625'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-13.78125%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='27.5625'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3eCRI%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-3-flowchart-Runtime-11'%20data-look='classic'%20transform='translate(1197.890625%2c%2035)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-67.359375'%20y='-27'%20width='134.71875'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-37.359375%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='74.71875'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3econtainerd%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-3-flowchart-Container-13'%20data-look='classic'%20transform='translate(1379.9375%2c%2035)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-64.6875'%20y='-27'%20width='129.375'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-34.6875%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='69.375'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3eContainer%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cdefs%3e%3cfilter%20id='mermaid-dark-3-drop-shadow'%20height='130%25'%20width='130%25'%3e%3cfeDropShadow%20dx='4'%20dy='4'%20stdDeviation='0'%20flood-opacity='0.06'%20flood-color='white'/%3e%3c/filter%3e%3c/defs%3e%3cdefs%3e%3cfilter%20id='mermaid-dark-3-drop-shadow-small'%20height='150%25'%20width='150%25'%3e%3cfeDropShadow%20dx='2'%20dy='2'%20stdDeviation='0'%20flood-opacity='0.06'%20flood-color='white'/%3e%3c/filter%3e%3c/defs%3e%3clinearGradient%20id='mermaid-dark-3-gradient'%20gradientUnits='objectBoundingBox'%20x1='0%25'%20y1='0%25'%20x2='100%25'%20y2='0%25'%3e%3cstop%20offset='0%25'%20stop-color='%23cccccc'%20stop-opacity='1'/%3e%3cstop%20offset='100%25'%20stop-color='hsl(180%2c%200%25%2c%2018.3529411765%25)'%20stop-opacity='1'/%3e%3c/linearGradient%3e%3c/svg%3e)
Pod 会经历 Pending、Running、Succeeded、Failed 或 Unknown 等阶段, 但它不是虚拟机式的永久身份。Pod 可以被删除、重建或迁移,名称和 IP 也可能 改变。业务不能依赖某个 Pod 长期存在,这一前提贯穿服务发现、自愈和滚动更新。
三、工作负载控制器管理不同类型的应用
生产系统通常不直接创建裸 Pod,因为裸 Pod 消失后没有上层控制器负责补充。 工作负载应该根据生命周期和身份要求选择控制器。
| 资源 | 核心能力 | 典型场景 |
|---|---|---|
| Deployment | 管理可替换副本、滚动更新与回滚 | Java API、Web 服务等无状态应用 |
| StatefulSet | 提供稳定名称、有序操作和独立存储 | 数据库、需要稳定成员身份的集群 |
| DaemonSet | 在符合条件的每个 Node 上运行实例 | 日志、监控、网络和安全 Agent |
| Job | 保证一次性任务执行完成 | 数据迁移、批处理、初始化 |
| CronJob | 按计划周期创建 Job | 定时清理、报表和备份任务 |
Deployment、ReplicaSet 与 Pod
Deployment 是无状态服务最常用的资源,但它并不直接管理 Pod,而是通过 ReplicaSet 维护副本数量:
%3btext-align:center%3b%7d%23mermaid-4 .edgeLabel p%7bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3b%7d%23mermaid-4 .edgeLabel rect%7bopacity:0.5%3bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bfill:rgba(232%2c232%2c232%2c 0.8)%3b%7d%23mermaid-4 .labelBkg%7bbackground-color:rgba(232%2c 232%2c 232%2c 0.5)%3b%7d%23mermaid-4 .cluster rect%7bfill:%23ffffde%3bstroke:%23aaaa33%3bstroke-width:1px%3b%7d%23mermaid-4 .cluster text%7bfill:%23333%3b%7d%23mermaid-4 .cluster span%7bcolor:%23333%3b%7d%23mermaid-4 .node .collapsed-indicator%7bfill:%23aaaa33%3bstroke:none%3bopacity:0.6%3b%7d%23mermaid-4 .node .collapsed-separator%7bstroke:%23aaaa33%3bstroke-width:0.75px%3b%7d%23mermaid-4 div.mermaidTooltip%7bposition:absolute%3btext-align:center%3bmax-width:200px%3bpadding:2px%3bfont-family:arial%2csans-serif%3bfont-size:12px%3bbackground:hsl(80%2c 100%25%2c 96.2745098039%25)%3bborder:1px solid %23aaaa33%3bborder-radius:2px%3bpointer-events:none%3bz-index:100%3b%7d%23mermaid-4 .flowchartTitleText%7btext-anchor:middle%3bfont-size:18px%3bfill:%23333%3b%7d%23mermaid-4 rect.text%7bfill:none%3bstroke-width:0%3b%7d%23mermaid-4 .icon-shape%2c%23mermaid-4 .image-shape%7bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3btext-align:center%3b%7d%23mermaid-4 .icon-shape p%2c%23mermaid-4 .image-shape p%7bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bpadding:2px%3b%7d%23mermaid-4 .icon-shape .label rect%2c%23mermaid-4 .image-shape .label rect%7bopacity:0.5%3bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bfill:rgba(232%2c232%2c232%2c 0.8)%3b%7d%23mermaid-4 .label-icon%7bdisplay:inline-block%3bheight:1em%3boverflow:visible%3bvertical-align:-0.125em%3b%7d%23mermaid-4 .node .label-icon path%7bfill:currentColor%3bstroke:revert%3bstroke-width:revert%3b%7d%23mermaid-4 .node .neo-node%7bstroke:%239370DB%3b%7d%23mermaid-4 %5bdata-look='neo'%5d.node rect%2c%23mermaid-4 %5bdata-look='neo'%5d.cluster rect%2c%23mermaid-4 %5bdata-look='neo'%5d.node polygon%7bstroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-4 %5bdata-look='neo'%5d.swimlane.cluster rect%7bfilter:none%3b%7d%23mermaid-4 %5bdata-look='neo'%5d.node path%7bstroke:%239370DB%3bstroke-width:1px%3b%7d%23mermaid-4 %5bdata-look='neo'%5d.node .outer-path%7bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-4 %5bdata-look='neo'%5d.node .neo-line path%7bstroke:%239370DB%3bfilter:none%3b%7d%23mermaid-4 %5bdata-look='neo'%5d.node circle%7bstroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-4 %5bdata-look='neo'%5d.node circle .state-start%7bfill:black%3b%7d%23mermaid-4 %5bdata-look='neo'%5d.icon-shape .icon%7bfill:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-4 %5bdata-look='neo'%5d.icon-shape .icon-neo path%7bstroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-4 :root%7b--mermaid-font-family:arial%2csans-serif%3b%7d%3c/style%3e%3cg%3e%3cmarker id='mermaid-4_flowchart-v2-pointEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'%3e%3cpath d='M 0 0 L 10 5 L 0 10 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-4_flowchart-v2-pointStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='4.5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'%3e%3cpath d='M 0 5 L 10 10 L 10 0 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-4_flowchart-v2-pointEnd-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='11.5' refY='7' markerUnits='userSpaceOnUse' markerWidth='10.5' markerHeight='14' orient='auto'%3e%3cpath d='M 0 0 L 11.5 7 L 0 14 z' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-4_flowchart-v2-pointStart-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='1' refY='7' markerUnits='userSpaceOnUse' markerWidth='11.5' markerHeight='14' orient='auto'%3e%3cpolygon points='0%2c7 11.5%2c14 11.5%2c0' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-4_flowchart-v2-circleEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='11' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-4_flowchart-v2-circleStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-1' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-4_flowchart-v2-circleEnd-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refY='5' refX='12.25' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-4_flowchart-v2-circleStart-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-2' refY='5' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-4_flowchart-v2-crossEnd' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='12' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3cpath d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-4_flowchart-v2-crossStart' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='-1' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3cpath d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-4_flowchart-v2-crossEnd-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='17.7' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'%3e%3cpath d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-4_flowchart-v2-crossStart-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='-3.5' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'%3e%3cpath d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cg class='root'%3e%3cg class='clusters'/%3e%3cg class='edgePaths'%3e%3cpath d='M190.703%2c62L190.703%2c66.167C190.703%2c70.333%2c190.703%2c78.667%2c190.703%2c86.333C190.703%2c94%2c190.703%2c101%2c190.703%2c104.5L190.703%2c108' id='mermaid-4-L_Deployment_ReplicaSet_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_Deployment_ReplicaSet_0' data-points='W3sieCI6MTkwLjcwMzEyNSwieSI6NjJ9LHsieCI6MTkwLjcwMzEyNSwieSI6ODd9LHsieCI6MTkwLjcwMzEyNSwieSI6MTEyfV0=' data-look='classic' marker-end='url(%23mermaid-4_flowchart-v2-pointEnd)'/%3e%3cpath d='M122.016%2c164.795L110.385%2c169.162C98.755%2c173.53%2c75.495%2c182.265%2c63.865%2c190.132C52.234%2c198%2c52.234%2c205%2c52.234%2c208.5L52.234%2c212' id='mermaid-4-L_ReplicaSet_P1_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_ReplicaSet_P1_0' data-points='W3sieCI6MTIyLjAxNTYyNSwieSI6MTY0Ljc5NDYyODc1MTk3NDczfSx7IngiOjUyLjIzNDM3NSwieSI6MTkxfSx7IngiOjUyLjIzNDM3NSwieSI6MjE2fV0=' data-look='classic' marker-end='url(%23mermaid-4_flowchart-v2-pointEnd)'/%3e%3cpath d='M190.703%2c166L190.703%2c170.167C190.703%2c174.333%2c190.703%2c182.667%2c190.703%2c190.333C190.703%2c198%2c190.703%2c205%2c190.703%2c208.5L190.703%2c212' id='mermaid-4-L_ReplicaSet_P2_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_ReplicaSet_P2_0' data-points='W3sieCI6MTkwLjcwMzEyNSwieSI6MTY2fSx7IngiOjE5MC43MDMxMjUsInkiOjE5MX0seyJ4IjoxOTAuNzAzMTI1LCJ5IjoyMTZ9XQ==' data-look='classic' marker-end='url(%23mermaid-4_flowchart-v2-pointEnd)'/%3e%3cpath d='M259.391%2c164.795L271.021%2c169.162C282.651%2c173.53%2c305.911%2c182.265%2c317.542%2c190.132C329.172%2c198%2c329.172%2c205%2c329.172%2c208.5L329.172%2c212' id='mermaid-4-L_ReplicaSet_P3_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_ReplicaSet_P3_0' data-points='W3sieCI6MjU5LjM5MDYyNSwieSI6MTY0Ljc5NDYyODc1MTk3NDczfSx7IngiOjMyOS4xNzE4NzUsInkiOjE5MX0seyJ4IjozMjkuMTcxODc1LCJ5IjoyMTZ9XQ==' data-look='classic' marker-end='url(%23mermaid-4_flowchart-v2-pointEnd)'/%3e%3c/g%3e%3cg class='edgeLabels'%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_Deployment_ReplicaSet_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_ReplicaSet_P1_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_ReplicaSet_P2_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_ReplicaSet_P3_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cg class='nodes'%3e%3cg class='node default' id='mermaid-4-flowchart-Deployment-0' data-look='classic' transform='translate(190.703125%2c 35)'%3e%3crect class='basic label-container' style='' x='-72.6875' y='-27' width='145.375' height='54'/%3e%3cg class='label' style='' transform='translate(-42.6875%2c -12)'%3e%3crect/%3e%3cforeignObject width='85.375' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eDeployment%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-4-flowchart-ReplicaSet-1' data-look='classic' transform='translate(190.703125%2c 139)'%3e%3crect class='basic label-container' style='' x='-68.6875' y='-27' width='137.375' height='54'/%3e%3cg class='label' style='' transform='translate(-38.6875%2c -12)'%3e%3crect/%3e%3cforeignObject width='77.375' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eReplicaSet%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-4-flowchart-P1-3' data-look='classic' transform='translate(52.234375%2c 243)'%3e%3crect class='basic label-container' style='' x='-44.234375' y='-27' width='88.46875' height='54'/%3e%3cg class='label' style='' transform='translate(-14.234375%2c -12)'%3e%3crect/%3e%3cforeignObject width='28.46875' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3ePod%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-4-flowchart-P2-5' data-look='classic' transform='translate(190.703125%2c 243)'%3e%3crect class='basic label-container' style='' x='-44.234375' y='-27' width='88.46875' height='54'/%3e%3cg class='label' style='' transform='translate(-14.234375%2c -12)'%3e%3crect/%3e%3cforeignObject width='28.46875' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3ePod%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-4-flowchart-P3-7' data-look='classic' transform='translate(329.171875%2c 243)'%3e%3crect class='basic label-container' style='' x='-44.234375' y='-27' width='88.46875' height='54'/%3e%3cg class='label' style='' transform='translate(-14.234375%2c -12)'%3e%3crect/%3e%3cforeignObject width='28.46875' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3ePod%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cdefs%3e%3cfilter id='mermaid-4-drop-shadow' height='130%25' width='130%25'%3e%3cfeDropShadow dx='4' dy='4' stdDeviation='0' flood-opacity='0.06' flood-color='black'/%3e%3c/filter%3e%3c/defs%3e%3cdefs%3e%3cfilter id='mermaid-4-drop-shadow-small' height='150%25' width='150%25'%3e%3cfeDropShadow dx='2' dy='2' stdDeviation='0' flood-opacity='0.06' flood-color='black'/%3e%3c/filter%3e%3c/defs%3e%3c/svg%3e)
%3btext-align:center%3b%7d%23mermaid-dark-4%20.edgeLabel%20p%7bbackground-color:hsl(0%2c%200%25%2c%2034.4117647059%25)%3b%7d%23mermaid-dark-4%20.edgeLabel%20rect%7bopacity:0.5%3bbackground-color:hsl(0%2c%200%25%2c%2034.4117647059%25)%3bfill:hsl(0%2c%200%25%2c%2034.4117647059%25)%3b%7d%23mermaid-dark-4%20.labelBkg%7bbackground-color:rgba(87.75%2c%2087.75%2c%2087.75%2c%200.5)%3b%7d%23mermaid-dark-4%20.cluster%20rect%7bfill:hsl(180%2c%201.5873015873%25%2c%2028.3529411765%25)%3bstroke:rgba(255%2c%20255%2c%20255%2c%200.25)%3bstroke-width:1px%3b%7d%23mermaid-dark-4%20.cluster%20text%7bfill:%23F9FFFE%3b%7d%23mermaid-dark-4%20.cluster%20span%7bcolor:%23F9FFFE%3b%7d%23mermaid-dark-4%20.node%20.collapsed-indicator%7bfill:rgba(255%2c%20255%2c%20255%2c%200.25)%3bstroke:none%3bopacity:0.6%3b%7d%23mermaid-dark-4%20.node%20.collapsed-separator%7bstroke:rgba(255%2c%20255%2c%20255%2c%200.25)%3bstroke-width:0.75px%3b%7d%23mermaid-dark-4%20div.mermaidTooltip%7bposition:absolute%3btext-align:center%3bmax-width:200px%3bpadding:2px%3bfont-family:arial%2csans-serif%3bfont-size:12px%3bbackground:hsl(20%2c%201.5873015873%25%2c%2012.3529411765%25)%3bborder:1px%20solid%20rgba(255%2c%20255%2c%20255%2c%200.25)%3bborder-radius:2px%3bpointer-events:none%3bz-index:100%3b%7d%23mermaid-dark-4%20.flowchartTitleText%7btext-anchor:middle%3bfont-size:18px%3bfill:%23ccc%3b%7d%23mermaid-dark-4%20rect.text%7bfill:none%3bstroke-width:0%3b%7d%23mermaid-dark-4%20.icon-shape%2c%23mermaid-dark-4%20.image-shape%7bbackground-color:hsl(0%2c%200%25%2c%2034.4117647059%25)%3btext-align:center%3b%7d%23mermaid-dark-4%20.icon-shape%20p%2c%23mermaid-dark-4%20.image-shape%20p%7bbackground-color:hsl(0%2c%200%25%2c%2034.4117647059%25)%3bpadding:2px%3b%7d%23mermaid-dark-4%20.icon-shape%20.label%20rect%2c%23mermaid-dark-4%20.image-shape%20.label%20rect%7bopacity:0.5%3bbackground-color:hsl(0%2c%200%25%2c%2034.4117647059%25)%3bfill:hsl(0%2c%200%25%2c%2034.4117647059%25)%3b%7d%23mermaid-dark-4%20.label-icon%7bdisplay:inline-block%3bheight:1em%3boverflow:visible%3bvertical-align:-0.125em%3b%7d%23mermaid-dark-4%20.node%20.label-icon%20path%7bfill:currentColor%3bstroke:revert%3bstroke-width:revert%3b%7d%23mermaid-dark-4%20.node%20.neo-node%7bstroke:%23ccc%3b%7d%23mermaid-dark-4%20%5bdata-look='neo'%5d.node%20rect%2c%23mermaid-dark-4%20%5bdata-look='neo'%5d.cluster%20rect%2c%23mermaid-dark-4%20%5bdata-look='neo'%5d.node%20polygon%7bstroke:url(%23mermaid-dark-4-gradient)%3bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-4%20%5bdata-look='neo'%5d.swimlane.cluster%20rect%7bfilter:none%3b%7d%23mermaid-dark-4%20%5bdata-look='neo'%5d.node%20path%7bstroke:url(%23mermaid-dark-4-gradient)%3bstroke-width:1px%3b%7d%23mermaid-dark-4%20%5bdata-look='neo'%5d.node%20.outer-path%7bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-4%20%5bdata-look='neo'%5d.node%20.neo-line%20path%7bstroke:%23ccc%3bfilter:none%3b%7d%23mermaid-dark-4%20%5bdata-look='neo'%5d.node%20circle%7bstroke:url(%23mermaid-dark-4-gradient)%3bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-4%20%5bdata-look='neo'%5d.node%20circle%20.state-start%7bfill:black%3b%7d%23mermaid-dark-4%20%5bdata-look='neo'%5d.icon-shape%20.icon%7bfill:url(%23mermaid-dark-4-gradient)%3bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-4%20%5bdata-look='neo'%5d.icon-shape%20.icon-neo%20path%7bstroke:url(%23mermaid-dark-4-gradient)%3bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-4%20:root%7b--mermaid-font-family:arial%2csans-serif%3b%7d%3c/style%3e%3cg%3e%3cmarker%20id='mermaid-dark-4_flowchart-v2-pointEnd'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='5'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='8'%20markerHeight='8'%20orient='auto'%3e%3cpath%20d='M%200%200%20L%2010%205%20L%200%2010%20z'%20class='arrowMarkerPath'%20style='stroke-width:%201%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-4_flowchart-v2-pointStart'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='4.5'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='8'%20markerHeight='8'%20orient='auto'%3e%3cpath%20d='M%200%205%20L%2010%2010%20L%2010%200%20z'%20class='arrowMarkerPath'%20style='stroke-width:%201%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-4_flowchart-v2-pointEnd-margin'%20class='marker%20flowchart-v2'%20viewBox='0%200%2011.5%2014'%20refX='11.5'%20refY='7'%20markerUnits='userSpaceOnUse'%20markerWidth='10.5'%20markerHeight='14'%20orient='auto'%3e%3cpath%20d='M%200%200%20L%2011.5%207%20L%200%2014%20z'%20class='arrowMarkerPath'%20style='stroke-width:%200%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-4_flowchart-v2-pointStart-margin'%20class='marker%20flowchart-v2'%20viewBox='0%200%2011.5%2014'%20refX='1'%20refY='7'%20markerUnits='userSpaceOnUse'%20markerWidth='11.5'%20markerHeight='14'%20orient='auto'%3e%3cpolygon%20points='0%2c7%2011.5%2c14%2011.5%2c0'%20class='arrowMarkerPath'%20style='stroke-width:%200%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-4_flowchart-v2-circleEnd'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='11'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='11'%20markerHeight='11'%20orient='auto'%3e%3ccircle%20cx='5'%20cy='5'%20r='5'%20class='arrowMarkerPath'%20style='stroke-width:%201%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-4_flowchart-v2-circleStart'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='-1'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='11'%20markerHeight='11'%20orient='auto'%3e%3ccircle%20cx='5'%20cy='5'%20r='5'%20class='arrowMarkerPath'%20style='stroke-width:%201%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-4_flowchart-v2-circleEnd-margin'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refY='5'%20refX='12.25'%20markerUnits='userSpaceOnUse'%20markerWidth='14'%20markerHeight='14'%20orient='auto'%3e%3ccircle%20cx='5'%20cy='5'%20r='5'%20class='arrowMarkerPath'%20style='stroke-width:%200%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-4_flowchart-v2-circleStart-margin'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='-2'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='14'%20markerHeight='14'%20orient='auto'%3e%3ccircle%20cx='5'%20cy='5'%20r='5'%20class='arrowMarkerPath'%20style='stroke-width:%200%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-4_flowchart-v2-crossEnd'%20class='marker%20cross%20flowchart-v2'%20viewBox='0%200%2011%2011'%20refX='12'%20refY='5.2'%20markerUnits='userSpaceOnUse'%20markerWidth='11'%20markerHeight='11'%20orient='auto'%3e%3cpath%20d='M%201%2c1%20l%209%2c9%20M%2010%2c1%20l%20-9%2c9'%20class='arrowMarkerPath'%20style='stroke-width:%202%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-4_flowchart-v2-crossStart'%20class='marker%20cross%20flowchart-v2'%20viewBox='0%200%2011%2011'%20refX='-1'%20refY='5.2'%20markerUnits='userSpaceOnUse'%20markerWidth='11'%20markerHeight='11'%20orient='auto'%3e%3cpath%20d='M%201%2c1%20l%209%2c9%20M%2010%2c1%20l%20-9%2c9'%20class='arrowMarkerPath'%20style='stroke-width:%202%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-4_flowchart-v2-crossEnd-margin'%20class='marker%20cross%20flowchart-v2'%20viewBox='0%200%2015%2015'%20refX='17.7'%20refY='7.5'%20markerUnits='userSpaceOnUse'%20markerWidth='12'%20markerHeight='12'%20orient='auto'%3e%3cpath%20d='M%201%2c1%20L%2014%2c14%20M%201%2c14%20L%2014%2c1'%20class='arrowMarkerPath'%20style='stroke-width:%202.5%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-4_flowchart-v2-crossStart-margin'%20class='marker%20cross%20flowchart-v2'%20viewBox='0%200%2015%2015'%20refX='-3.5'%20refY='7.5'%20markerUnits='userSpaceOnUse'%20markerWidth='12'%20markerHeight='12'%20orient='auto'%3e%3cpath%20d='M%201%2c1%20L%2014%2c14%20M%201%2c14%20L%2014%2c1'%20class='arrowMarkerPath'%20style='stroke-width:%202.5%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cg%20class='root'%3e%3cg%20class='clusters'/%3e%3cg%20class='edgePaths'%3e%3cpath%20d='M190.703%2c62L190.703%2c66.167C190.703%2c70.333%2c190.703%2c78.667%2c190.703%2c86.333C190.703%2c94%2c190.703%2c101%2c190.703%2c104.5L190.703%2c108'%20id='mermaid-dark-4-L_Deployment_ReplicaSet_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_Deployment_ReplicaSet_0'%20data-points='W3sieCI6MTkwLjcwMzEyNSwieSI6NjJ9LHsieCI6MTkwLjcwMzEyNSwieSI6ODd9LHsieCI6MTkwLjcwMzEyNSwieSI6MTEyfV0='%20data-look='classic'%20marker-end='url(%23mermaid-dark-4_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M122.016%2c164.795L110.385%2c169.162C98.755%2c173.53%2c75.495%2c182.265%2c63.865%2c190.132C52.234%2c198%2c52.234%2c205%2c52.234%2c208.5L52.234%2c212'%20id='mermaid-dark-4-L_ReplicaSet_P1_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_ReplicaSet_P1_0'%20data-points='W3sieCI6MTIyLjAxNTYyNSwieSI6MTY0Ljc5NDYyODc1MTk3NDczfSx7IngiOjUyLjIzNDM3NSwieSI6MTkxfSx7IngiOjUyLjIzNDM3NSwieSI6MjE2fV0='%20data-look='classic'%20marker-end='url(%23mermaid-dark-4_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M190.703%2c166L190.703%2c170.167C190.703%2c174.333%2c190.703%2c182.667%2c190.703%2c190.333C190.703%2c198%2c190.703%2c205%2c190.703%2c208.5L190.703%2c212'%20id='mermaid-dark-4-L_ReplicaSet_P2_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_ReplicaSet_P2_0'%20data-points='W3sieCI6MTkwLjcwMzEyNSwieSI6MTY2fSx7IngiOjE5MC43MDMxMjUsInkiOjE5MX0seyJ4IjoxOTAuNzAzMTI1LCJ5IjoyMTZ9XQ=='%20data-look='classic'%20marker-end='url(%23mermaid-dark-4_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M259.391%2c164.795L271.021%2c169.162C282.651%2c173.53%2c305.911%2c182.265%2c317.542%2c190.132C329.172%2c198%2c329.172%2c205%2c329.172%2c208.5L329.172%2c212'%20id='mermaid-dark-4-L_ReplicaSet_P3_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_ReplicaSet_P3_0'%20data-points='W3sieCI6MjU5LjM5MDYyNSwieSI6MTY0Ljc5NDYyODc1MTk3NDczfSx7IngiOjMyOS4xNzE4NzUsInkiOjE5MX0seyJ4IjozMjkuMTcxODc1LCJ5IjoyMTZ9XQ=='%20data-look='classic'%20marker-end='url(%23mermaid-dark-4_flowchart-v2-pointEnd)'/%3e%3c/g%3e%3cg%20class='edgeLabels'%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_Deployment_ReplicaSet_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_ReplicaSet_P1_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_ReplicaSet_P2_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_ReplicaSet_P3_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cg%20class='nodes'%3e%3cg%20class='node%20default'%20id='mermaid-dark-4-flowchart-Deployment-0'%20data-look='classic'%20transform='translate(190.703125%2c%2035)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-72.6875'%20y='-27'%20width='145.375'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-42.6875%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='85.375'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3eDeployment%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-4-flowchart-ReplicaSet-1'%20data-look='classic'%20transform='translate(190.703125%2c%20139)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-68.6875'%20y='-27'%20width='137.375'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-38.6875%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='77.375'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3eReplicaSet%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-4-flowchart-P1-3'%20data-look='classic'%20transform='translate(52.234375%2c%20243)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-44.234375'%20y='-27'%20width='88.46875'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-14.234375%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='28.46875'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3ePod%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-4-flowchart-P2-5'%20data-look='classic'%20transform='translate(190.703125%2c%20243)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-44.234375'%20y='-27'%20width='88.46875'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-14.234375%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='28.46875'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3ePod%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-4-flowchart-P3-7'%20data-look='classic'%20transform='translate(329.171875%2c%20243)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-44.234375'%20y='-27'%20width='88.46875'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-14.234375%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='28.46875'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3ePod%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cdefs%3e%3cfilter%20id='mermaid-dark-4-drop-shadow'%20height='130%25'%20width='130%25'%3e%3cfeDropShadow%20dx='4'%20dy='4'%20stdDeviation='0'%20flood-opacity='0.06'%20flood-color='white'/%3e%3c/filter%3e%3c/defs%3e%3cdefs%3e%3cfilter%20id='mermaid-dark-4-drop-shadow-small'%20height='150%25'%20width='150%25'%3e%3cfeDropShadow%20dx='2'%20dy='2'%20stdDeviation='0'%20flood-opacity='0.06'%20flood-color='white'/%3e%3c/filter%3e%3c/defs%3e%3clinearGradient%20id='mermaid-dark-4-gradient'%20gradientUnits='objectBoundingBox'%20x1='0%25'%20y1='0%25'%20x2='100%25'%20y2='0%25'%3e%3cstop%20offset='0%25'%20stop-color='%23cccccc'%20stop-opacity='1'/%3e%3cstop%20offset='100%25'%20stop-color='hsl(180%2c%200%25%2c%2018.3529411765%25)'%20stop-opacity='1'/%3e%3c/linearGradient%3e%3c/svg%3e)
Deployment 中的 template 是 Pod Template。镜像、标签、资源限制或探针等 模板内容发生变化时,Deployment 会创建新的 ReplicaSet,并逐步替换旧 Pod。
apiVersion: apps/v1
kind: Deployment
metadata:
  name: order-service
  namespace: production
spec:
  replicas: 3
  selector:
    matchLabels:
      app: order-service
  template:
    metadata:
      labels:
        app: order-service
        version: v1
    spec:
      containers:
        - name: order-service
          image: registry.example.com/order-service:1.4.2
          ports:
            - containerPort: 8080
Deployment 依靠 Label 与 Selector 关联 Pod,而不是依赖 Pod 名称。Label 用于 分类和选择;Annotation 用于保存说明、外部系统参数等不参与 Selector 的元数据。
资源之间还可以通过 OwnerReference 表达所有权。Deployment、ReplicaSet 与 Pod 形成所有权链,便于级联删除和垃圾回收。Finalizer 则阻止资源在必要清理完成前 被彻底删除,这些机制也是后续理解 CRD 与 Operator 的基础。
四、Service 与 Ingress 建立稳定访问路径
Pod IP 会变化,Service 为一组符合 Selector 的 Pod 提供稳定入口。Pod 创建、 删除或 Ready 状态变化时,EndpointSlice 会同步更新可接收流量的后端地址。
apiVersion: v1
kind: Service
metadata:
  name: order-service
  namespace: production
spec:
  selector:
    app: order-service
  ports:
    - name: http
      port: 80
      targetPort: 8080
  type: ClusterIP
port: 80 是 Service 对外提供的端口,targetPort: 8080 是应用容器监听的端口。 常见 Service 类型包括:
| 类型 | 访问范围与用途 |
|---|---|
| ClusterIP | 默认类型,只提供集群内部稳定入口 |
| NodePort | 在每个节点暴露固定端口,常作为其他入口方案的底层能力 |
| LoadBalancer | 与云负载均衡集成,对集群外暴露服务 |
CoreDNS 为 Service 提供域名解析。同一 Namespace 的应用通常可以直接访问 http://order-service,跨 Namespace 可使用 order-service.production.svc.cluster.local。应用应使用 Service Name,而不是 记录 Pod IP。
Ingress 负责根据 Host 和 Path 把 HTTP/HTTPS 流量路由到不同 Service。Ingress Resource 只保存规则,真正处理请求的是 Ingress Controller:
%3btext-align:center%3b%7d%23mermaid-5 .edgeLabel p%7bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3b%7d%23mermaid-5 .edgeLabel rect%7bopacity:0.5%3bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bfill:rgba(232%2c232%2c232%2c 0.8)%3b%7d%23mermaid-5 .labelBkg%7bbackground-color:rgba(232%2c 232%2c 232%2c 0.5)%3b%7d%23mermaid-5 .cluster rect%7bfill:%23ffffde%3bstroke:%23aaaa33%3bstroke-width:1px%3b%7d%23mermaid-5 .cluster text%7bfill:%23333%3b%7d%23mermaid-5 .cluster span%7bcolor:%23333%3b%7d%23mermaid-5 .node .collapsed-indicator%7bfill:%23aaaa33%3bstroke:none%3bopacity:0.6%3b%7d%23mermaid-5 .node .collapsed-separator%7bstroke:%23aaaa33%3bstroke-width:0.75px%3b%7d%23mermaid-5 div.mermaidTooltip%7bposition:absolute%3btext-align:center%3bmax-width:200px%3bpadding:2px%3bfont-family:arial%2csans-serif%3bfont-size:12px%3bbackground:hsl(80%2c 100%25%2c 96.2745098039%25)%3bborder:1px solid %23aaaa33%3bborder-radius:2px%3bpointer-events:none%3bz-index:100%3b%7d%23mermaid-5 .flowchartTitleText%7btext-anchor:middle%3bfont-size:18px%3bfill:%23333%3b%7d%23mermaid-5 rect.text%7bfill:none%3bstroke-width:0%3b%7d%23mermaid-5 .icon-shape%2c%23mermaid-5 .image-shape%7bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3btext-align:center%3b%7d%23mermaid-5 .icon-shape p%2c%23mermaid-5 .image-shape p%7bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bpadding:2px%3b%7d%23mermaid-5 .icon-shape .label rect%2c%23mermaid-5 .image-shape .label rect%7bopacity:0.5%3bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bfill:rgba(232%2c232%2c232%2c 0.8)%3b%7d%23mermaid-5 .label-icon%7bdisplay:inline-block%3bheight:1em%3boverflow:visible%3bvertical-align:-0.125em%3b%7d%23mermaid-5 .node .label-icon path%7bfill:currentColor%3bstroke:revert%3bstroke-width:revert%3b%7d%23mermaid-5 .node .neo-node%7bstroke:%239370DB%3b%7d%23mermaid-5 %5bdata-look='neo'%5d.node rect%2c%23mermaid-5 %5bdata-look='neo'%5d.cluster rect%2c%23mermaid-5 %5bdata-look='neo'%5d.node polygon%7bstroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-5 %5bdata-look='neo'%5d.swimlane.cluster rect%7bfilter:none%3b%7d%23mermaid-5 %5bdata-look='neo'%5d.node path%7bstroke:%239370DB%3bstroke-width:1px%3b%7d%23mermaid-5 %5bdata-look='neo'%5d.node .outer-path%7bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-5 %5bdata-look='neo'%5d.node .neo-line path%7bstroke:%239370DB%3bfilter:none%3b%7d%23mermaid-5 %5bdata-look='neo'%5d.node circle%7bstroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-5 %5bdata-look='neo'%5d.node circle .state-start%7bfill:black%3b%7d%23mermaid-5 %5bdata-look='neo'%5d.icon-shape .icon%7bfill:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-5 %5bdata-look='neo'%5d.icon-shape .icon-neo path%7bstroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-5 :root%7b--mermaid-font-family:arial%2csans-serif%3b%7d%3c/style%3e%3cg%3e%3cmarker id='mermaid-5_flowchart-v2-pointEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'%3e%3cpath d='M 0 0 L 10 5 L 0 10 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-5_flowchart-v2-pointStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='4.5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'%3e%3cpath d='M 0 5 L 10 10 L 10 0 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-5_flowchart-v2-pointEnd-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='11.5' refY='7' markerUnits='userSpaceOnUse' markerWidth='10.5' markerHeight='14' orient='auto'%3e%3cpath d='M 0 0 L 11.5 7 L 0 14 z' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-5_flowchart-v2-pointStart-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='1' refY='7' markerUnits='userSpaceOnUse' markerWidth='11.5' markerHeight='14' orient='auto'%3e%3cpolygon points='0%2c7 11.5%2c14 11.5%2c0' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-5_flowchart-v2-circleEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='11' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-5_flowchart-v2-circleStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-1' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-5_flowchart-v2-circleEnd-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refY='5' refX='12.25' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-5_flowchart-v2-circleStart-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-2' refY='5' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-5_flowchart-v2-crossEnd' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='12' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3cpath d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-5_flowchart-v2-crossStart' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='-1' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3cpath d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-5_flowchart-v2-crossEnd-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='17.7' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'%3e%3cpath d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-5_flowchart-v2-crossStart-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='-3.5' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'%3e%3cpath d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cg class='root'%3e%3cg class='clusters'/%3e%3cg class='edgePaths'%3e%3cpath d='M108.906%2c35L113.073%2c35C117.24%2c35%2c125.573%2c35%2c137.314%2c35C149.055%2c35%2c164.203%2c35%2c171.777%2c35L179.352%2c35' id='mermaid-5-L_Client_ELB_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_Client_ELB_0' data-points='W3sieCI6MTA4LjkwNjI1LCJ5IjozNX0seyJ4IjoxMzMuOTA2MjUsInkiOjM1fSx7IngiOjE4My4zNTE1NjI1LCJ5IjozNX1d' data-look='classic' marker-end='url(%23mermaid-5_flowchart-v2-pointEnd)'/%3e%3cpath d='M319.852%2c35L335.06%2c35C350.268%2c35%2c380.685%2c35%2c408.075%2c38.961C435.466%2c42.921%2c459.83%2c50.842%2c472.012%2c54.803L484.194%2c58.763' id='mermaid-5-L_ELB_Controller_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_ELB_Controller_0' data-points='W3sieCI6MzE5Ljg1MTU2MjUsInkiOjM1fSx7IngiOjQxMS4xMDE1NjI1LCJ5IjozNX0seyJ4Ijo0ODcuOTk4MzQ3MzU1NzY5MiwieSI6NjB9XQ==' data-look='classic' marker-end='url(%23mermaid-5_flowchart-v2-pointEnd)'/%3e%3cpath d='M344.297%2c139L355.431%2c139C366.565%2c139%2c388.833%2c139%2c412.15%2c135.039C435.466%2c131.079%2c459.83%2c123.158%2c472.012%2c119.197L484.194%2c115.237' id='mermaid-5-L_Rule_Controller_0' class='edge-thickness-normal edge-pattern-dotted edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_Rule_Controller_0' data-points='W3sieCI6MzQ0LjI5Njg3NSwieSI6MTM5fSx7IngiOjQxMS4xMDE1NjI1LCJ5IjoxMzl9LHsieCI6NDg3Ljk5ODM0NzM1NTc2OTIsInkiOjExNH1d' data-look='classic' marker-end='url(%23mermaid-5_flowchart-v2-pointEnd)'/%3e%3cpath d='M664.188%2c87L668.354%2c87C672.521%2c87%2c680.854%2c87%2c688.521%2c87C696.188%2c87%2c703.188%2c87%2c706.688%2c87L710.188%2c87' id='mermaid-5-L_Controller_Service_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_Controller_Service_0' data-points='W3sieCI6NjY0LjE4NzUsInkiOjg3fSx7IngiOjY4OS4xODc1LCJ5Ijo4N30seyJ4Ijo3MTQuMTg3NSwieSI6ODd9XQ==' data-look='classic' marker-end='url(%23mermaid-5_flowchart-v2-pointEnd)'/%3e%3cpath d='M827.547%2c87L831.714%2c87C835.88%2c87%2c844.214%2c87%2c851.88%2c87C859.547%2c87%2c866.547%2c87%2c870.047%2c87L873.547%2c87' id='mermaid-5-L_Service_Slice_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_Service_Slice_0' data-points='W3sieCI6ODI3LjU0Njg3NSwieSI6ODd9LHsieCI6ODUyLjU0Njg3NSwieSI6ODd9LHsieCI6ODc3LjU0Njg3NSwieSI6ODd9XQ==' data-look='classic' marker-end='url(%23mermaid-5_flowchart-v2-pointEnd)'/%3e%3cpath d='M1035.391%2c87L1039.557%2c87C1043.724%2c87%2c1052.057%2c87%2c1059.724%2c87C1067.391%2c87%2c1074.391%2c87%2c1077.891%2c87L1081.391%2c87' id='mermaid-5-L_Slice_Pod_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_Slice_Pod_0' data-points='W3sieCI6MTAzNS4zOTA2MjUsInkiOjg3fSx7IngiOjEwNjAuMzkwNjI1LCJ5Ijo4N30seyJ4IjoxMDg1LjM5MDYyNSwieSI6ODd9XQ==' data-look='classic' marker-end='url(%23mermaid-5_flowchart-v2-pointEnd)'/%3e%3c/g%3e%3cg class='edgeLabels'%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_Client_ELB_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_ELB_Controller_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel' transform='translate(411.1015625%2c 139)'%3e%3cg class='label' data-id='L_Rule_Controller_0' transform='translate(-41.8046875%2c -12)'%3e%3cforeignObject width='83.609375' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3cp%3eroute config%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_Controller_Service_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_Service_Slice_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_Slice_Pod_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cg class='nodes'%3e%3cg class='node default' id='mermaid-5-flowchart-Client-0' data-look='classic' transform='translate(58.453125%2c 35)'%3e%3crect class='basic label-container' style='' x='-50.453125' y='-27' width='100.90625' height='54'/%3e%3cg class='label' style='' transform='translate(-20.453125%2c -12)'%3e%3crect/%3e%3cforeignObject width='40.90625' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eClient%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-5-flowchart-ELB-1' data-look='classic' transform='translate(251.6015625%2c 35)'%3e%3crect class='basic label-container' style='' x='-68.25' y='-27' width='136.5' height='54'/%3e%3cg class='label' style='' transform='translate(-38.25%2c -12)'%3e%3crect/%3e%3cforeignObject width='76.5' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eCloud ELB%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-5-flowchart-Controller-3' data-look='classic' transform='translate(571.046875%2c 87)'%3e%3crect class='basic label-container' style='' x='-93.140625' y='-27' width='186.28125' height='54'/%3e%3cg class='label' style='' transform='translate(-63.140625%2c -12)'%3e%3crect/%3e%3cforeignObject width='126.28125' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eIngress Controller%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-5-flowchart-Rule-4' data-look='classic' transform='translate(251.6015625%2c 139)'%3e%3crect class='basic label-container' style='' x='-92.6953125' y='-27' width='185.390625' height='54'/%3e%3cg class='label' style='' transform='translate(-62.6953125%2c -12)'%3e%3crect/%3e%3cforeignObject width='125.390625' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eIngress Resource%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-5-flowchart-Service-7' data-look='classic' transform='translate(770.8671875%2c 87)'%3e%3crect class='basic label-container' style='' x='-56.6796875' y='-27' width='113.359375' height='54'/%3e%3cg class='label' style='' transform='translate(-26.6796875%2c -12)'%3e%3crect/%3e%3cforeignObject width='53.359375' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eService%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-5-flowchart-Slice-9' data-look='classic' transform='translate(956.46875%2c 87)'%3e%3crect class='basic label-container' style='' x='-78.921875' y='-27' width='157.84375' height='54'/%3e%3cg class='label' style='' transform='translate(-48.921875%2c -12)'%3e%3crect/%3e%3cforeignObject width='97.84375' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eEndpointSlice%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-5-flowchart-Pod-11' data-look='classic' transform='translate(1154.9765625%2c 87)'%3e%3crect class='basic label-container' style='' x='-69.5859375' y='-27' width='139.171875' height='54'/%3e%3cg class='label' style='' transform='translate(-39.5859375%2c -12)'%3e%3crect/%3e%3cforeignObject width='79.171875' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eReady Pod%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cdefs%3e%3cfilter id='mermaid-5-drop-shadow' height='130%25' width='130%25'%3e%3cfeDropShadow dx='4' dy='4' stdDeviation='0' flood-opacity='0.06' flood-color='black'/%3e%3c/filter%3e%3c/defs%3e%3cdefs%3e%3cfilter id='mermaid-5-drop-shadow-small' height='150%25' width='150%25'%3e%3cfeDropShadow dx='2' dy='2' stdDeviation='0' flood-opacity='0.06' flood-color='black'/%3e%3c/filter%3e%3c/defs%3e%3c/svg%3e)
%3btext-align:center%3b%7d%23mermaid-dark-5%20.edgeLabel%20p%7bbackground-color:hsl(0%2c%200%25%2c%2034.4117647059%25)%3b%7d%23mermaid-dark-5%20.edgeLabel%20rect%7bopacity:0.5%3bbackground-color:hsl(0%2c%200%25%2c%2034.4117647059%25)%3bfill:hsl(0%2c%200%25%2c%2034.4117647059%25)%3b%7d%23mermaid-dark-5%20.labelBkg%7bbackground-color:rgba(87.75%2c%2087.75%2c%2087.75%2c%200.5)%3b%7d%23mermaid-dark-5%20.cluster%20rect%7bfill:hsl(180%2c%201.5873015873%25%2c%2028.3529411765%25)%3bstroke:rgba(255%2c%20255%2c%20255%2c%200.25)%3bstroke-width:1px%3b%7d%23mermaid-dark-5%20.cluster%20text%7bfill:%23F9FFFE%3b%7d%23mermaid-dark-5%20.cluster%20span%7bcolor:%23F9FFFE%3b%7d%23mermaid-dark-5%20.node%20.collapsed-indicator%7bfill:rgba(255%2c%20255%2c%20255%2c%200.25)%3bstroke:none%3bopacity:0.6%3b%7d%23mermaid-dark-5%20.node%20.collapsed-separator%7bstroke:rgba(255%2c%20255%2c%20255%2c%200.25)%3bstroke-width:0.75px%3b%7d%23mermaid-dark-5%20div.mermaidTooltip%7bposition:absolute%3btext-align:center%3bmax-width:200px%3bpadding:2px%3bfont-family:arial%2csans-serif%3bfont-size:12px%3bbackground:hsl(20%2c%201.5873015873%25%2c%2012.3529411765%25)%3bborder:1px%20solid%20rgba(255%2c%20255%2c%20255%2c%200.25)%3bborder-radius:2px%3bpointer-events:none%3bz-index:100%3b%7d%23mermaid-dark-5%20.flowchartTitleText%7btext-anchor:middle%3bfont-size:18px%3bfill:%23ccc%3b%7d%23mermaid-dark-5%20rect.text%7bfill:none%3bstroke-width:0%3b%7d%23mermaid-dark-5%20.icon-shape%2c%23mermaid-dark-5%20.image-shape%7bbackground-color:hsl(0%2c%200%25%2c%2034.4117647059%25)%3btext-align:center%3b%7d%23mermaid-dark-5%20.icon-shape%20p%2c%23mermaid-dark-5%20.image-shape%20p%7bbackground-color:hsl(0%2c%200%25%2c%2034.4117647059%25)%3bpadding:2px%3b%7d%23mermaid-dark-5%20.icon-shape%20.label%20rect%2c%23mermaid-dark-5%20.image-shape%20.label%20rect%7bopacity:0.5%3bbackground-color:hsl(0%2c%200%25%2c%2034.4117647059%25)%3bfill:hsl(0%2c%200%25%2c%2034.4117647059%25)%3b%7d%23mermaid-dark-5%20.label-icon%7bdisplay:inline-block%3bheight:1em%3boverflow:visible%3bvertical-align:-0.125em%3b%7d%23mermaid-dark-5%20.node%20.label-icon%20path%7bfill:currentColor%3bstroke:revert%3bstroke-width:revert%3b%7d%23mermaid-dark-5%20.node%20.neo-node%7bstroke:%23ccc%3b%7d%23mermaid-dark-5%20%5bdata-look='neo'%5d.node%20rect%2c%23mermaid-dark-5%20%5bdata-look='neo'%5d.cluster%20rect%2c%23mermaid-dark-5%20%5bdata-look='neo'%5d.node%20polygon%7bstroke:url(%23mermaid-dark-5-gradient)%3bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-5%20%5bdata-look='neo'%5d.swimlane.cluster%20rect%7bfilter:none%3b%7d%23mermaid-dark-5%20%5bdata-look='neo'%5d.node%20path%7bstroke:url(%23mermaid-dark-5-gradient)%3bstroke-width:1px%3b%7d%23mermaid-dark-5%20%5bdata-look='neo'%5d.node%20.outer-path%7bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-5%20%5bdata-look='neo'%5d.node%20.neo-line%20path%7bstroke:%23ccc%3bfilter:none%3b%7d%23mermaid-dark-5%20%5bdata-look='neo'%5d.node%20circle%7bstroke:url(%23mermaid-dark-5-gradient)%3bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-5%20%5bdata-look='neo'%5d.node%20circle%20.state-start%7bfill:black%3b%7d%23mermaid-dark-5%20%5bdata-look='neo'%5d.icon-shape%20.icon%7bfill:url(%23mermaid-dark-5-gradient)%3bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-5%20%5bdata-look='neo'%5d.icon-shape%20.icon-neo%20path%7bstroke:url(%23mermaid-dark-5-gradient)%3bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-5%20:root%7b--mermaid-font-family:arial%2csans-serif%3b%7d%3c/style%3e%3cg%3e%3cmarker%20id='mermaid-dark-5_flowchart-v2-pointEnd'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='5'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='8'%20markerHeight='8'%20orient='auto'%3e%3cpath%20d='M%200%200%20L%2010%205%20L%200%2010%20z'%20class='arrowMarkerPath'%20style='stroke-width:%201%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-5_flowchart-v2-pointStart'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='4.5'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='8'%20markerHeight='8'%20orient='auto'%3e%3cpath%20d='M%200%205%20L%2010%2010%20L%2010%200%20z'%20class='arrowMarkerPath'%20style='stroke-width:%201%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-5_flowchart-v2-pointEnd-margin'%20class='marker%20flowchart-v2'%20viewBox='0%200%2011.5%2014'%20refX='11.5'%20refY='7'%20markerUnits='userSpaceOnUse'%20markerWidth='10.5'%20markerHeight='14'%20orient='auto'%3e%3cpath%20d='M%200%200%20L%2011.5%207%20L%200%2014%20z'%20class='arrowMarkerPath'%20style='stroke-width:%200%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-5_flowchart-v2-pointStart-margin'%20class='marker%20flowchart-v2'%20viewBox='0%200%2011.5%2014'%20refX='1'%20refY='7'%20markerUnits='userSpaceOnUse'%20markerWidth='11.5'%20markerHeight='14'%20orient='auto'%3e%3cpolygon%20points='0%2c7%2011.5%2c14%2011.5%2c0'%20class='arrowMarkerPath'%20style='stroke-width:%200%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-5_flowchart-v2-circleEnd'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='11'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='11'%20markerHeight='11'%20orient='auto'%3e%3ccircle%20cx='5'%20cy='5'%20r='5'%20class='arrowMarkerPath'%20style='stroke-width:%201%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-5_flowchart-v2-circleStart'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='-1'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='11'%20markerHeight='11'%20orient='auto'%3e%3ccircle%20cx='5'%20cy='5'%20r='5'%20class='arrowMarkerPath'%20style='stroke-width:%201%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-5_flowchart-v2-circleEnd-margin'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refY='5'%20refX='12.25'%20markerUnits='userSpaceOnUse'%20markerWidth='14'%20markerHeight='14'%20orient='auto'%3e%3ccircle%20cx='5'%20cy='5'%20r='5'%20class='arrowMarkerPath'%20style='stroke-width:%200%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-5_flowchart-v2-circleStart-margin'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='-2'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='14'%20markerHeight='14'%20orient='auto'%3e%3ccircle%20cx='5'%20cy='5'%20r='5'%20class='arrowMarkerPath'%20style='stroke-width:%200%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-5_flowchart-v2-crossEnd'%20class='marker%20cross%20flowchart-v2'%20viewBox='0%200%2011%2011'%20refX='12'%20refY='5.2'%20markerUnits='userSpaceOnUse'%20markerWidth='11'%20markerHeight='11'%20orient='auto'%3e%3cpath%20d='M%201%2c1%20l%209%2c9%20M%2010%2c1%20l%20-9%2c9'%20class='arrowMarkerPath'%20style='stroke-width:%202%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-5_flowchart-v2-crossStart'%20class='marker%20cross%20flowchart-v2'%20viewBox='0%200%2011%2011'%20refX='-1'%20refY='5.2'%20markerUnits='userSpaceOnUse'%20markerWidth='11'%20markerHeight='11'%20orient='auto'%3e%3cpath%20d='M%201%2c1%20l%209%2c9%20M%2010%2c1%20l%20-9%2c9'%20class='arrowMarkerPath'%20style='stroke-width:%202%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-5_flowchart-v2-crossEnd-margin'%20class='marker%20cross%20flowchart-v2'%20viewBox='0%200%2015%2015'%20refX='17.7'%20refY='7.5'%20markerUnits='userSpaceOnUse'%20markerWidth='12'%20markerHeight='12'%20orient='auto'%3e%3cpath%20d='M%201%2c1%20L%2014%2c14%20M%201%2c14%20L%2014%2c1'%20class='arrowMarkerPath'%20style='stroke-width:%202.5%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-5_flowchart-v2-crossStart-margin'%20class='marker%20cross%20flowchart-v2'%20viewBox='0%200%2015%2015'%20refX='-3.5'%20refY='7.5'%20markerUnits='userSpaceOnUse'%20markerWidth='12'%20markerHeight='12'%20orient='auto'%3e%3cpath%20d='M%201%2c1%20L%2014%2c14%20M%201%2c14%20L%2014%2c1'%20class='arrowMarkerPath'%20style='stroke-width:%202.5%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cg%20class='root'%3e%3cg%20class='clusters'/%3e%3cg%20class='edgePaths'%3e%3cpath%20d='M108.906%2c35L113.073%2c35C117.24%2c35%2c125.573%2c35%2c137.314%2c35C149.055%2c35%2c164.203%2c35%2c171.777%2c35L179.352%2c35'%20id='mermaid-dark-5-L_Client_ELB_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_Client_ELB_0'%20data-points='W3sieCI6MTA4LjkwNjI1LCJ5IjozNX0seyJ4IjoxMzMuOTA2MjUsInkiOjM1fSx7IngiOjE4My4zNTE1NjI1LCJ5IjozNX1d'%20data-look='classic'%20marker-end='url(%23mermaid-dark-5_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M319.852%2c35L335.06%2c35C350.268%2c35%2c380.685%2c35%2c408.075%2c38.961C435.466%2c42.921%2c459.83%2c50.842%2c472.012%2c54.803L484.194%2c58.763'%20id='mermaid-dark-5-L_ELB_Controller_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_ELB_Controller_0'%20data-points='W3sieCI6MzE5Ljg1MTU2MjUsInkiOjM1fSx7IngiOjQxMS4xMDE1NjI1LCJ5IjozNX0seyJ4Ijo0ODcuOTk4MzQ3MzU1NzY5MiwieSI6NjB9XQ=='%20data-look='classic'%20marker-end='url(%23mermaid-dark-5_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M344.297%2c139L355.431%2c139C366.565%2c139%2c388.833%2c139%2c412.15%2c135.039C435.466%2c131.079%2c459.83%2c123.158%2c472.012%2c119.197L484.194%2c115.237'%20id='mermaid-dark-5-L_Rule_Controller_0'%20class='edge-thickness-normal%20edge-pattern-dotted%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_Rule_Controller_0'%20data-points='W3sieCI6MzQ0LjI5Njg3NSwieSI6MTM5fSx7IngiOjQxMS4xMDE1NjI1LCJ5IjoxMzl9LHsieCI6NDg3Ljk5ODM0NzM1NTc2OTIsInkiOjExNH1d'%20data-look='classic'%20marker-end='url(%23mermaid-dark-5_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M664.188%2c87L668.354%2c87C672.521%2c87%2c680.854%2c87%2c688.521%2c87C696.188%2c87%2c703.188%2c87%2c706.688%2c87L710.188%2c87'%20id='mermaid-dark-5-L_Controller_Service_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_Controller_Service_0'%20data-points='W3sieCI6NjY0LjE4NzUsInkiOjg3fSx7IngiOjY4OS4xODc1LCJ5Ijo4N30seyJ4Ijo3MTQuMTg3NSwieSI6ODd9XQ=='%20data-look='classic'%20marker-end='url(%23mermaid-dark-5_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M827.547%2c87L831.714%2c87C835.88%2c87%2c844.214%2c87%2c851.88%2c87C859.547%2c87%2c866.547%2c87%2c870.047%2c87L873.547%2c87'%20id='mermaid-dark-5-L_Service_Slice_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_Service_Slice_0'%20data-points='W3sieCI6ODI3LjU0Njg3NSwieSI6ODd9LHsieCI6ODUyLjU0Njg3NSwieSI6ODd9LHsieCI6ODc3LjU0Njg3NSwieSI6ODd9XQ=='%20data-look='classic'%20marker-end='url(%23mermaid-dark-5_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M1035.391%2c87L1039.557%2c87C1043.724%2c87%2c1052.057%2c87%2c1059.724%2c87C1067.391%2c87%2c1074.391%2c87%2c1077.891%2c87L1081.391%2c87'%20id='mermaid-dark-5-L_Slice_Pod_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_Slice_Pod_0'%20data-points='W3sieCI6MTAzNS4zOTA2MjUsInkiOjg3fSx7IngiOjEwNjAuMzkwNjI1LCJ5Ijo4N30seyJ4IjoxMDg1LjM5MDYyNSwieSI6ODd9XQ=='%20data-look='classic'%20marker-end='url(%23mermaid-dark-5_flowchart-v2-pointEnd)'/%3e%3c/g%3e%3cg%20class='edgeLabels'%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_Client_ELB_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_ELB_Controller_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%20transform='translate(411.1015625%2c%20139)'%3e%3cg%20class='label'%20data-id='L_Rule_Controller_0'%20transform='translate(-41.8046875%2c%20-12)'%3e%3cforeignObject%20width='83.609375'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3cp%3eroute%20config%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_Controller_Service_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_Service_Slice_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_Slice_Pod_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cg%20class='nodes'%3e%3cg%20class='node%20default'%20id='mermaid-dark-5-flowchart-Client-0'%20data-look='classic'%20transform='translate(58.453125%2c%2035)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-50.453125'%20y='-27'%20width='100.90625'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-20.453125%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='40.90625'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3eClient%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-5-flowchart-ELB-1'%20data-look='classic'%20transform='translate(251.6015625%2c%2035)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-68.25'%20y='-27'%20width='136.5'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-38.25%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='76.5'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3eCloud%20ELB%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-5-flowchart-Controller-3'%20data-look='classic'%20transform='translate(571.046875%2c%2087)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-93.140625'%20y='-27'%20width='186.28125'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-63.140625%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='126.28125'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3eIngress%20Controller%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-5-flowchart-Rule-4'%20data-look='classic'%20transform='translate(251.6015625%2c%20139)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-92.6953125'%20y='-27'%20width='185.390625'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-62.6953125%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='125.390625'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3eIngress%20Resource%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-5-flowchart-Service-7'%20data-look='classic'%20transform='translate(770.8671875%2c%2087)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-56.6796875'%20y='-27'%20width='113.359375'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-26.6796875%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='53.359375'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3eService%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-5-flowchart-Slice-9'%20data-look='classic'%20transform='translate(956.46875%2c%2087)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-78.921875'%20y='-27'%20width='157.84375'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-48.921875%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='97.84375'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3eEndpointSlice%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-5-flowchart-Pod-11'%20data-look='classic'%20transform='translate(1154.9765625%2c%2087)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-69.5859375'%20y='-27'%20width='139.171875'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-39.5859375%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='79.171875'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3eReady%20Pod%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cdefs%3e%3cfilter%20id='mermaid-dark-5-drop-shadow'%20height='130%25'%20width='130%25'%3e%3cfeDropShadow%20dx='4'%20dy='4'%20stdDeviation='0'%20flood-opacity='0.06'%20flood-color='white'/%3e%3c/filter%3e%3c/defs%3e%3cdefs%3e%3cfilter%20id='mermaid-dark-5-drop-shadow-small'%20height='150%25'%20width='150%25'%3e%3cfeDropShadow%20dx='2'%20dy='2'%20stdDeviation='0'%20flood-opacity='0.06'%20flood-color='white'/%3e%3c/filter%3e%3c/defs%3e%3clinearGradient%20id='mermaid-dark-5-gradient'%20gradientUnits='objectBoundingBox'%20x1='0%25'%20y1='0%25'%20x2='100%25'%20y2='0%25'%3e%3cstop%20offset='0%25'%20stop-color='%23cccccc'%20stop-opacity='1'/%3e%3cstop%20offset='100%25'%20stop-color='hsl(180%2c%200%25%2c%2018.3529411765%25)'%20stop-opacity='1'/%3e%3c/linearGradient%3e%3c/svg%3e)
这条链路也划清了边界:云 ELB 提供外部负载入口,Ingress Controller 执行七层 路由,Service 提供稳定服务抽象,Pod 才真正运行应用。
五、配置、Secret 与存储必须和镜像分离
ConfigMap 保存非敏感配置,例如日志级别、超时和功能开关;Secret 保存密码、 Token、证书和密钥。它们都可以作为环境变量或文件挂载到容器中,使同一镜像在 不同环境使用不同配置。
Kubernetes Secret 的价值是把敏感信息独立管理并施加访问控制,并不意味着数据 天然拥有保险箱级安全。生产环境仍需结合 RBAC、etcd 静态加密、KMS、外部 Secret Manager 和最小权限原则。
配置更新是否立即生效取决于注入方式:
- 环境变量只在容器启动时读取,修改后通常需要重建 Pod;
- Volume 挂载的文件可以被更新,但应用是否重新加载取决于自身实现;
- Secret 或 ConfigMap 发生变化,不代表应用状态必然自动刷新。
因此,配置发布经常触发 Rolling Restart。此时镜像版本可以不变,但 Deployment Revision 会变化。
Volume 与持久化边界
容器可写层和 Pod 都是临时的。Volume 为 Pod 内容器提供存储挂载,其中 emptyDir 与 Pod 同生命周期,适合缓存和容器间临时共享,不适合长期数据。
持久存储通过 PV 和 PVC 解耦工作负载与底层磁盘:
%3btext-align:center%3b%7d%23mermaid-6 .edgeLabel p%7bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3b%7d%23mermaid-6 .edgeLabel rect%7bopacity:0.5%3bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bfill:rgba(232%2c232%2c232%2c 0.8)%3b%7d%23mermaid-6 .labelBkg%7bbackground-color:rgba(232%2c 232%2c 232%2c 0.5)%3b%7d%23mermaid-6 .cluster rect%7bfill:%23ffffde%3bstroke:%23aaaa33%3bstroke-width:1px%3b%7d%23mermaid-6 .cluster text%7bfill:%23333%3b%7d%23mermaid-6 .cluster span%7bcolor:%23333%3b%7d%23mermaid-6 .node .collapsed-indicator%7bfill:%23aaaa33%3bstroke:none%3bopacity:0.6%3b%7d%23mermaid-6 .node .collapsed-separator%7bstroke:%23aaaa33%3bstroke-width:0.75px%3b%7d%23mermaid-6 div.mermaidTooltip%7bposition:absolute%3btext-align:center%3bmax-width:200px%3bpadding:2px%3bfont-family:arial%2csans-serif%3bfont-size:12px%3bbackground:hsl(80%2c 100%25%2c 96.2745098039%25)%3bborder:1px solid %23aaaa33%3bborder-radius:2px%3bpointer-events:none%3bz-index:100%3b%7d%23mermaid-6 .flowchartTitleText%7btext-anchor:middle%3bfont-size:18px%3bfill:%23333%3b%7d%23mermaid-6 rect.text%7bfill:none%3bstroke-width:0%3b%7d%23mermaid-6 .icon-shape%2c%23mermaid-6 .image-shape%7bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3btext-align:center%3b%7d%23mermaid-6 .icon-shape p%2c%23mermaid-6 .image-shape p%7bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bpadding:2px%3b%7d%23mermaid-6 .icon-shape .label rect%2c%23mermaid-6 .image-shape .label rect%7bopacity:0.5%3bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bfill:rgba(232%2c232%2c232%2c 0.8)%3b%7d%23mermaid-6 .label-icon%7bdisplay:inline-block%3bheight:1em%3boverflow:visible%3bvertical-align:-0.125em%3b%7d%23mermaid-6 .node .label-icon path%7bfill:currentColor%3bstroke:revert%3bstroke-width:revert%3b%7d%23mermaid-6 .node .neo-node%7bstroke:%239370DB%3b%7d%23mermaid-6 %5bdata-look='neo'%5d.node rect%2c%23mermaid-6 %5bdata-look='neo'%5d.cluster rect%2c%23mermaid-6 %5bdata-look='neo'%5d.node polygon%7bstroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-6 %5bdata-look='neo'%5d.swimlane.cluster rect%7bfilter:none%3b%7d%23mermaid-6 %5bdata-look='neo'%5d.node path%7bstroke:%239370DB%3bstroke-width:1px%3b%7d%23mermaid-6 %5bdata-look='neo'%5d.node .outer-path%7bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-6 %5bdata-look='neo'%5d.node .neo-line path%7bstroke:%239370DB%3bfilter:none%3b%7d%23mermaid-6 %5bdata-look='neo'%5d.node circle%7bstroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-6 %5bdata-look='neo'%5d.node circle .state-start%7bfill:black%3b%7d%23mermaid-6 %5bdata-look='neo'%5d.icon-shape .icon%7bfill:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-6 %5bdata-look='neo'%5d.icon-shape .icon-neo path%7bstroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-6 :root%7b--mermaid-font-family:arial%2csans-serif%3b%7d%3c/style%3e%3cg%3e%3cmarker id='mermaid-6_flowchart-v2-pointEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'%3e%3cpath d='M 0 0 L 10 5 L 0 10 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-6_flowchart-v2-pointStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='4.5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'%3e%3cpath d='M 0 5 L 10 10 L 10 0 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-6_flowchart-v2-pointEnd-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='11.5' refY='7' markerUnits='userSpaceOnUse' markerWidth='10.5' markerHeight='14' orient='auto'%3e%3cpath d='M 0 0 L 11.5 7 L 0 14 z' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-6_flowchart-v2-pointStart-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='1' refY='7' markerUnits='userSpaceOnUse' markerWidth='11.5' markerHeight='14' orient='auto'%3e%3cpolygon points='0%2c7 11.5%2c14 11.5%2c0' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-6_flowchart-v2-circleEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='11' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-6_flowchart-v2-circleStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-1' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-6_flowchart-v2-circleEnd-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refY='5' refX='12.25' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-6_flowchart-v2-circleStart-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-2' refY='5' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-6_flowchart-v2-crossEnd' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='12' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3cpath d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-6_flowchart-v2-crossStart' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='-1' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3cpath d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-6_flowchart-v2-crossEnd-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='17.7' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'%3e%3cpath d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-6_flowchart-v2-crossStart-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='-3.5' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'%3e%3cpath d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cg class='root'%3e%3cg class='clusters'/%3e%3cg class='edgePaths'%3e%3cpath d='M96.469%2c35L100.635%2c35C104.802%2c35%2c113.135%2c35%2c120.802%2c35C128.469%2c35%2c135.469%2c35%2c138.969%2c35L142.469%2c35' id='mermaid-6-L_Pod_PVC_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_Pod_PVC_0' data-points='W3sieCI6OTYuNDY4NzUsInkiOjM1fSx7IngiOjEyMS40Njg3NSwieSI6MzV9LHsieCI6MTQ2LjQ2ODc1LCJ5IjozNX1d' data-look='classic' marker-end='url(%23mermaid-6_flowchart-v2-pointEnd)'/%3e%3cpath d='M371.875%2c35L376.042%2c35C380.208%2c35%2c388.542%2c35%2c396.208%2c35C403.875%2c35%2c410.875%2c35%2c414.375%2c35L417.875%2c35' id='mermaid-6-L_PVC_PV_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_PVC_PV_0' data-points='W3sieCI6MzcxLjg3NSwieSI6MzV9LHsieCI6Mzk2Ljg3NSwieSI6MzV9LHsieCI6NDIxLjg3NSwieSI6MzV9XQ==' data-look='classic' marker-end='url(%23mermaid-6_flowchart-v2-pointEnd)'/%3e%3cpath d='M606.391%2c35L610.557%2c35C614.724%2c35%2c623.057%2c35%2c630.724%2c35C638.391%2c35%2c645.391%2c35%2c648.891%2c35L652.391%2c35' id='mermaid-6-L_PV_Storage_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_PV_Storage_0' data-points='W3sieCI6NjA2LjM5MDYyNSwieSI6MzV9LHsieCI6NjMxLjM5MDYyNSwieSI6MzV9LHsieCI6NjU2LjM5MDYyNSwieSI6MzV9XQ==' data-look='classic' marker-end='url(%23mermaid-6_flowchart-v2-pointEnd)'/%3e%3c/g%3e%3cg class='edgeLabels'%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_Pod_PVC_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_PVC_PV_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_PV_Storage_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cg class='nodes'%3e%3cg class='node default' id='mermaid-6-flowchart-Pod-0' data-look='classic' transform='translate(52.234375%2c 35)'%3e%3crect class='basic label-container' style='' x='-44.234375' y='-27' width='88.46875' height='54'/%3e%3cg class='label' style='' transform='translate(-14.234375%2c -12)'%3e%3crect/%3e%3cforeignObject width='28.46875' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3ePod%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-6-flowchart-PVC-1' data-look='classic' transform='translate(259.171875%2c 35)'%3e%3crect class='basic label-container' style='' x='-112.703125' y='-27' width='225.40625' height='54'/%3e%3cg class='label' style='' transform='translate(-82.703125%2c -12)'%3e%3crect/%3e%3cforeignObject width='165.40625' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3ePersistentVolumeClaim%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-6-flowchart-PV-3' data-look='classic' transform='translate(514.1328125%2c 35)'%3e%3crect class='basic label-container' style='' x='-92.2578125' y='-27' width='184.515625' height='54'/%3e%3cg class='label' style='' transform='translate(-62.2578125%2c -12)'%3e%3crect/%3e%3cforeignObject width='124.515625' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3ePersistentVolume%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-6-flowchart-Storage-5' data-look='classic' transform='translate(759.7578125%2c 35)'%3e%3crect class='basic label-container' style='' x='-103.3671875' y='-27' width='206.734375' height='54'/%3e%3cg class='label' style='' transform='translate(-73.3671875%2c -12)'%3e%3crect/%3e%3cforeignObject width='146.734375' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eCloud Disk / Storage%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cdefs%3e%3cfilter id='mermaid-6-drop-shadow' height='130%25' width='130%25'%3e%3cfeDropShadow dx='4' dy='4' stdDeviation='0' flood-opacity='0.06' flood-color='black'/%3e%3c/filter%3e%3c/defs%3e%3cdefs%3e%3cfilter id='mermaid-6-drop-shadow-small' height='150%25' width='150%25'%3e%3cfeDropShadow dx='2' dy='2' stdDeviation='0' flood-opacity='0.06' flood-color='black'/%3e%3c/filter%3e%3c/defs%3e%3c/svg%3e)
%3btext-align:center%3b%7d%23mermaid-dark-6%20.edgeLabel%20p%7bbackground-color:hsl(0%2c%200%25%2c%2034.4117647059%25)%3b%7d%23mermaid-dark-6%20.edgeLabel%20rect%7bopacity:0.5%3bbackground-color:hsl(0%2c%200%25%2c%2034.4117647059%25)%3bfill:hsl(0%2c%200%25%2c%2034.4117647059%25)%3b%7d%23mermaid-dark-6%20.labelBkg%7bbackground-color:rgba(87.75%2c%2087.75%2c%2087.75%2c%200.5)%3b%7d%23mermaid-dark-6%20.cluster%20rect%7bfill:hsl(180%2c%201.5873015873%25%2c%2028.3529411765%25)%3bstroke:rgba(255%2c%20255%2c%20255%2c%200.25)%3bstroke-width:1px%3b%7d%23mermaid-dark-6%20.cluster%20text%7bfill:%23F9FFFE%3b%7d%23mermaid-dark-6%20.cluster%20span%7bcolor:%23F9FFFE%3b%7d%23mermaid-dark-6%20.node%20.collapsed-indicator%7bfill:rgba(255%2c%20255%2c%20255%2c%200.25)%3bstroke:none%3bopacity:0.6%3b%7d%23mermaid-dark-6%20.node%20.collapsed-separator%7bstroke:rgba(255%2c%20255%2c%20255%2c%200.25)%3bstroke-width:0.75px%3b%7d%23mermaid-dark-6%20div.mermaidTooltip%7bposition:absolute%3btext-align:center%3bmax-width:200px%3bpadding:2px%3bfont-family:arial%2csans-serif%3bfont-size:12px%3bbackground:hsl(20%2c%201.5873015873%25%2c%2012.3529411765%25)%3bborder:1px%20solid%20rgba(255%2c%20255%2c%20255%2c%200.25)%3bborder-radius:2px%3bpointer-events:none%3bz-index:100%3b%7d%23mermaid-dark-6%20.flowchartTitleText%7btext-anchor:middle%3bfont-size:18px%3bfill:%23ccc%3b%7d%23mermaid-dark-6%20rect.text%7bfill:none%3bstroke-width:0%3b%7d%23mermaid-dark-6%20.icon-shape%2c%23mermaid-dark-6%20.image-shape%7bbackground-color:hsl(0%2c%200%25%2c%2034.4117647059%25)%3btext-align:center%3b%7d%23mermaid-dark-6%20.icon-shape%20p%2c%23mermaid-dark-6%20.image-shape%20p%7bbackground-color:hsl(0%2c%200%25%2c%2034.4117647059%25)%3bpadding:2px%3b%7d%23mermaid-dark-6%20.icon-shape%20.label%20rect%2c%23mermaid-dark-6%20.image-shape%20.label%20rect%7bopacity:0.5%3bbackground-color:hsl(0%2c%200%25%2c%2034.4117647059%25)%3bfill:hsl(0%2c%200%25%2c%2034.4117647059%25)%3b%7d%23mermaid-dark-6%20.label-icon%7bdisplay:inline-block%3bheight:1em%3boverflow:visible%3bvertical-align:-0.125em%3b%7d%23mermaid-dark-6%20.node%20.label-icon%20path%7bfill:currentColor%3bstroke:revert%3bstroke-width:revert%3b%7d%23mermaid-dark-6%20.node%20.neo-node%7bstroke:%23ccc%3b%7d%23mermaid-dark-6%20%5bdata-look='neo'%5d.node%20rect%2c%23mermaid-dark-6%20%5bdata-look='neo'%5d.cluster%20rect%2c%23mermaid-dark-6%20%5bdata-look='neo'%5d.node%20polygon%7bstroke:url(%23mermaid-dark-6-gradient)%3bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-6%20%5bdata-look='neo'%5d.swimlane.cluster%20rect%7bfilter:none%3b%7d%23mermaid-dark-6%20%5bdata-look='neo'%5d.node%20path%7bstroke:url(%23mermaid-dark-6-gradient)%3bstroke-width:1px%3b%7d%23mermaid-dark-6%20%5bdata-look='neo'%5d.node%20.outer-path%7bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-6%20%5bdata-look='neo'%5d.node%20.neo-line%20path%7bstroke:%23ccc%3bfilter:none%3b%7d%23mermaid-dark-6%20%5bdata-look='neo'%5d.node%20circle%7bstroke:url(%23mermaid-dark-6-gradient)%3bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-6%20%5bdata-look='neo'%5d.node%20circle%20.state-start%7bfill:black%3b%7d%23mermaid-dark-6%20%5bdata-look='neo'%5d.icon-shape%20.icon%7bfill:url(%23mermaid-dark-6-gradient)%3bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-6%20%5bdata-look='neo'%5d.icon-shape%20.icon-neo%20path%7bstroke:url(%23mermaid-dark-6-gradient)%3bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-6%20:root%7b--mermaid-font-family:arial%2csans-serif%3b%7d%3c/style%3e%3cg%3e%3cmarker%20id='mermaid-dark-6_flowchart-v2-pointEnd'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='5'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='8'%20markerHeight='8'%20orient='auto'%3e%3cpath%20d='M%200%200%20L%2010%205%20L%200%2010%20z'%20class='arrowMarkerPath'%20style='stroke-width:%201%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-6_flowchart-v2-pointStart'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='4.5'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='8'%20markerHeight='8'%20orient='auto'%3e%3cpath%20d='M%200%205%20L%2010%2010%20L%2010%200%20z'%20class='arrowMarkerPath'%20style='stroke-width:%201%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-6_flowchart-v2-pointEnd-margin'%20class='marker%20flowchart-v2'%20viewBox='0%200%2011.5%2014'%20refX='11.5'%20refY='7'%20markerUnits='userSpaceOnUse'%20markerWidth='10.5'%20markerHeight='14'%20orient='auto'%3e%3cpath%20d='M%200%200%20L%2011.5%207%20L%200%2014%20z'%20class='arrowMarkerPath'%20style='stroke-width:%200%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-6_flowchart-v2-pointStart-margin'%20class='marker%20flowchart-v2'%20viewBox='0%200%2011.5%2014'%20refX='1'%20refY='7'%20markerUnits='userSpaceOnUse'%20markerWidth='11.5'%20markerHeight='14'%20orient='auto'%3e%3cpolygon%20points='0%2c7%2011.5%2c14%2011.5%2c0'%20class='arrowMarkerPath'%20style='stroke-width:%200%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-6_flowchart-v2-circleEnd'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='11'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='11'%20markerHeight='11'%20orient='auto'%3e%3ccircle%20cx='5'%20cy='5'%20r='5'%20class='arrowMarkerPath'%20style='stroke-width:%201%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-6_flowchart-v2-circleStart'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='-1'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='11'%20markerHeight='11'%20orient='auto'%3e%3ccircle%20cx='5'%20cy='5'%20r='5'%20class='arrowMarkerPath'%20style='stroke-width:%201%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-6_flowchart-v2-circleEnd-margin'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refY='5'%20refX='12.25'%20markerUnits='userSpaceOnUse'%20markerWidth='14'%20markerHeight='14'%20orient='auto'%3e%3ccircle%20cx='5'%20cy='5'%20r='5'%20class='arrowMarkerPath'%20style='stroke-width:%200%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-6_flowchart-v2-circleStart-margin'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='-2'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='14'%20markerHeight='14'%20orient='auto'%3e%3ccircle%20cx='5'%20cy='5'%20r='5'%20class='arrowMarkerPath'%20style='stroke-width:%200%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-6_flowchart-v2-crossEnd'%20class='marker%20cross%20flowchart-v2'%20viewBox='0%200%2011%2011'%20refX='12'%20refY='5.2'%20markerUnits='userSpaceOnUse'%20markerWidth='11'%20markerHeight='11'%20orient='auto'%3e%3cpath%20d='M%201%2c1%20l%209%2c9%20M%2010%2c1%20l%20-9%2c9'%20class='arrowMarkerPath'%20style='stroke-width:%202%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-6_flowchart-v2-crossStart'%20class='marker%20cross%20flowchart-v2'%20viewBox='0%200%2011%2011'%20refX='-1'%20refY='5.2'%20markerUnits='userSpaceOnUse'%20markerWidth='11'%20markerHeight='11'%20orient='auto'%3e%3cpath%20d='M%201%2c1%20l%209%2c9%20M%2010%2c1%20l%20-9%2c9'%20class='arrowMarkerPath'%20style='stroke-width:%202%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-6_flowchart-v2-crossEnd-margin'%20class='marker%20cross%20flowchart-v2'%20viewBox='0%200%2015%2015'%20refX='17.7'%20refY='7.5'%20markerUnits='userSpaceOnUse'%20markerWidth='12'%20markerHeight='12'%20orient='auto'%3e%3cpath%20d='M%201%2c1%20L%2014%2c14%20M%201%2c14%20L%2014%2c1'%20class='arrowMarkerPath'%20style='stroke-width:%202.5%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-6_flowchart-v2-crossStart-margin'%20class='marker%20cross%20flowchart-v2'%20viewBox='0%200%2015%2015'%20refX='-3.5'%20refY='7.5'%20markerUnits='userSpaceOnUse'%20markerWidth='12'%20markerHeight='12'%20orient='auto'%3e%3cpath%20d='M%201%2c1%20L%2014%2c14%20M%201%2c14%20L%2014%2c1'%20class='arrowMarkerPath'%20style='stroke-width:%202.5%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cg%20class='root'%3e%3cg%20class='clusters'/%3e%3cg%20class='edgePaths'%3e%3cpath%20d='M96.469%2c35L100.635%2c35C104.802%2c35%2c113.135%2c35%2c120.802%2c35C128.469%2c35%2c135.469%2c35%2c138.969%2c35L142.469%2c35'%20id='mermaid-dark-6-L_Pod_PVC_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_Pod_PVC_0'%20data-points='W3sieCI6OTYuNDY4NzUsInkiOjM1fSx7IngiOjEyMS40Njg3NSwieSI6MzV9LHsieCI6MTQ2LjQ2ODc1LCJ5IjozNX1d'%20data-look='classic'%20marker-end='url(%23mermaid-dark-6_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M371.875%2c35L376.042%2c35C380.208%2c35%2c388.542%2c35%2c396.208%2c35C403.875%2c35%2c410.875%2c35%2c414.375%2c35L417.875%2c35'%20id='mermaid-dark-6-L_PVC_PV_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_PVC_PV_0'%20data-points='W3sieCI6MzcxLjg3NSwieSI6MzV9LHsieCI6Mzk2Ljg3NSwieSI6MzV9LHsieCI6NDIxLjg3NSwieSI6MzV9XQ=='%20data-look='classic'%20marker-end='url(%23mermaid-dark-6_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M606.391%2c35L610.557%2c35C614.724%2c35%2c623.057%2c35%2c630.724%2c35C638.391%2c35%2c645.391%2c35%2c648.891%2c35L652.391%2c35'%20id='mermaid-dark-6-L_PV_Storage_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_PV_Storage_0'%20data-points='W3sieCI6NjA2LjM5MDYyNSwieSI6MzV9LHsieCI6NjMxLjM5MDYyNSwieSI6MzV9LHsieCI6NjU2LjM5MDYyNSwieSI6MzV9XQ=='%20data-look='classic'%20marker-end='url(%23mermaid-dark-6_flowchart-v2-pointEnd)'/%3e%3c/g%3e%3cg%20class='edgeLabels'%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_Pod_PVC_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_PVC_PV_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_PV_Storage_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cg%20class='nodes'%3e%3cg%20class='node%20default'%20id='mermaid-dark-6-flowchart-Pod-0'%20data-look='classic'%20transform='translate(52.234375%2c%2035)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-44.234375'%20y='-27'%20width='88.46875'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-14.234375%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='28.46875'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3ePod%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-6-flowchart-PVC-1'%20data-look='classic'%20transform='translate(259.171875%2c%2035)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-112.703125'%20y='-27'%20width='225.40625'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-82.703125%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='165.40625'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3ePersistentVolumeClaim%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-6-flowchart-PV-3'%20data-look='classic'%20transform='translate(514.1328125%2c%2035)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-92.2578125'%20y='-27'%20width='184.515625'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-62.2578125%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='124.515625'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3ePersistentVolume%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-6-flowchart-Storage-5'%20data-look='classic'%20transform='translate(759.7578125%2c%2035)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-103.3671875'%20y='-27'%20width='206.734375'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-73.3671875%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='146.734375'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3eCloud%20Disk%20/%20Storage%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cdefs%3e%3cfilter%20id='mermaid-dark-6-drop-shadow'%20height='130%25'%20width='130%25'%3e%3cfeDropShadow%20dx='4'%20dy='4'%20stdDeviation='0'%20flood-opacity='0.06'%20flood-color='white'/%3e%3c/filter%3e%3c/defs%3e%3cdefs%3e%3cfilter%20id='mermaid-dark-6-drop-shadow-small'%20height='150%25'%20width='150%25'%3e%3cfeDropShadow%20dx='2'%20dy='2'%20stdDeviation='0'%20flood-opacity='0.06'%20flood-color='white'/%3e%3c/filter%3e%3c/defs%3e%3clinearGradient%20id='mermaid-dark-6-gradient'%20gradientUnits='objectBoundingBox'%20x1='0%25'%20y1='0%25'%20x2='100%25'%20y2='0%25'%3e%3cstop%20offset='0%25'%20stop-color='%23cccccc'%20stop-opacity='1'/%3e%3cstop%20offset='100%25'%20stop-color='hsl(180%2c%200%25%2c%2018.3529411765%25)'%20stop-opacity='1'/%3e%3c/linearGradient%3e%3c/svg%3e)
PVC 描述工作负载需要什么存储,PV 表示实际持久存储资源,StorageClass 还可以 支持动态供应。对于数据库等有状态服务,持久卷只能保存数据,备份、复制、恢复和 一致性仍需要应用或托管服务自身保证。
六、资源管理与健康检查决定运行质量
Kubernetes 能调度 Pod,不代表它知道应用需要多少资源或何时能够接收流量。 生产工作负载至少要设计 Resources 和 Probes。
requests 与 limits
resources:
  requests:
    cpu: 500m
    memory: 512Mi
  limits:
    cpu: '1'
memory: 1Girequests是调度和资源保障的主要依据;limits约束容器最多可以使用的资源;- CPU 超限通常导致 Throttling;
- Memory 超限可能导致 OOMKilled。
requests 过低会让节点过度承诺,导致运行时资源争抢;过高则造成 Pod 难以调度 和资源浪费。limits 也不应机械设置,需要结合应用内存模型、并发和负载测试确定。
三类 Probe 解决不同问题
| Probe | 回答的问题 | 失败后的典型行为 |
|---|---|---|
| Startup | 应用是否已经完成启动 | 启动成功前抑制其他探针 |
| Readiness | 当前是否可以接收流量 | 从 Service 后端移除,不一定重启 |
| Liveness | 应用是否陷入不可恢复状态 | kubelet 重启容器 |
startupProbe:
  httpGet:
    path: /health/startup
    port: 8080
  failureThreshold: 30
  periodSeconds: 5

readinessProbe:
  httpGet:
    path: /health/ready
    port: 8080
  periodSeconds: 5

livenessProbe:
  httpGet:
    path: /health/live
    port: 8080
  periodSeconds: 10
Running 只说明容器进程已经启动,不等于 Ready。大型 Java 应用可能仍在 加载配置、建立连接或预热缓存。Readiness Probe 能防止流量过早进入,Startup Probe 则避免慢启动应用被 Liveness Probe 反复杀死。
探针设计必须克制。Liveness 不应依赖偶发抖动的外部服务,否则下游故障可能引发 整个集群大规模重启;Readiness 可以更敏感,但也要防止短暂波动导致所有实例 同时摘流。
七、滚动更新、自愈与优雅终止
Kubernetes 的 Self-Healing 来自多个层次的协作:容器退出时 kubelet 按策略重启; Pod 消失时 ReplicaSet 创建替代者;节点故障后控制面在条件满足时重新调度工作负载。 它不是某一个开关提供的单一能力。
滚动更新依赖 Readiness
Deployment 默认采用 RollingUpdate。假设副本数为 3:
strategy:
  type: RollingUpdate
  rollingUpdate:
    maxSurge: 1
    maxUnavailable: 0
maxSurge: 1 允许更新期间临时增加一个 Pod,maxUnavailable: 0 要求始终保留 三个可用副本。只有新 Pod 通过 Readiness Probe 后,控制器才会逐步移除旧 Pod:
V1 V1 V1
V1 V1 V1 + V2
V1 V1 V2
V1 V2 V2
V2 V2 V2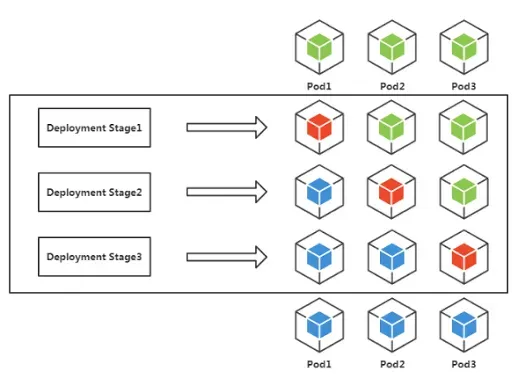
Deployment 会为 Pod Template 变化记录 Revision,可以回滚到旧模板。但回滚镜像 和 Pod 配置并不会自动撤销数据库 Schema、消息格式或外部状态变化,因此发布设计 还必须保证上下游兼容。
Pod 随时可能被替换
Rolling Update、Node Drain、自动伸缩和节点维护都会正常终止 Pod。应用收到 SIGTERM 后,应该停止接收新请求、完成进行中的工作、关闭连接并刷新必要数据。
spec:
  terminationGracePeriodSeconds: 30
  containers:
    - name: order-service
      lifecycle:
        preStop:
          exec:
            command: ['sh', '-c', 'sleep 5']
preStop 可以为摘流或清理提供准备时间,terminationGracePeriodSeconds 定义 优雅退出期限;超时后进程可能被强制终止。具体时长应覆盖业务请求和关闭流程, 而不是照搬固定数值。
八、隔离、伸缩与高可用
Namespace 提供逻辑资源边界,资源身份实际上是 Namespace + Name。但 Namespace 本身不自动提供完整的网络、安全和资源隔离,还需要组合:
- RBAC 控制谁能操作哪些资源;
- NetworkPolicy 限制工作负载间网络访问;
- ResourceQuota 限制 Namespace 的 CPU、Memory、Pod 等总量;
- LimitRange 约束单个 Container 或 Pod 的默认值与范围。
高可用也不是把 replicas 设置为 3 就结束。如果三个副本位于同一个 Node 或 同一个 AZ,单点故障仍可能让它们同时失效。需要通过 Pod Anti-Affinity、Topology Spread Constraints、多个 Node 和多个 AZ 分散故障域,并配置合理的中断预算。
Kubernetes 体系中常见三个伸缩层次:
| 机制 | 调整对象 | 解决的问题 |
|---|---|---|
| HPA | Pod 副本数量 | 根据指标横向增加或减少实例 |
| VPA | Pod requests 等资源规格 | 调整单个实例的资源需求 |
| Cluster Autoscaler | Node 数量 | Pod 因集群容量不足无法调度时扩容节点 |
三者存在联动,配置不当也可能相互干扰。例如 HPA 依赖 CPU 利用率时,requests 会影响指标计算;VPA 修改 requests 又可能改变 HPA 的判断。因此自动伸缩必须建立 在准确资源画像、稳定指标和容量边界之上。
九、一个 Java 服务的完整资源模型
一个生产环境中的 order-service 通常不是单个 YAML,而是一组协作资源:
Namespace:  production
Deployment: order-service,3 个副本
Service:    order-service,ClusterIP
Ingress:    api.example.com/orders
ConfigMap:  非敏感运行配置
Secret:     数据库和外部服务凭证
PVC: 可选的持久存储声明%3btext-align:center%3b%7d%23mermaid-7 .edgeLabel p%7bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3b%7d%23mermaid-7 .edgeLabel rect%7bopacity:0.5%3bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bfill:rgba(232%2c232%2c232%2c 0.8)%3b%7d%23mermaid-7 .labelBkg%7bbackground-color:rgba(232%2c 232%2c 232%2c 0.5)%3b%7d%23mermaid-7 .cluster rect%7bfill:%23ffffde%3bstroke:%23aaaa33%3bstroke-width:1px%3b%7d%23mermaid-7 .cluster text%7bfill:%23333%3b%7d%23mermaid-7 .cluster span%7bcolor:%23333%3b%7d%23mermaid-7 .node .collapsed-indicator%7bfill:%23aaaa33%3bstroke:none%3bopacity:0.6%3b%7d%23mermaid-7 .node .collapsed-separator%7bstroke:%23aaaa33%3bstroke-width:0.75px%3b%7d%23mermaid-7 div.mermaidTooltip%7bposition:absolute%3btext-align:center%3bmax-width:200px%3bpadding:2px%3bfont-family:arial%2csans-serif%3bfont-size:12px%3bbackground:hsl(80%2c 100%25%2c 96.2745098039%25)%3bborder:1px solid %23aaaa33%3bborder-radius:2px%3bpointer-events:none%3bz-index:100%3b%7d%23mermaid-7 .flowchartTitleText%7btext-anchor:middle%3bfont-size:18px%3bfill:%23333%3b%7d%23mermaid-7 rect.text%7bfill:none%3bstroke-width:0%3b%7d%23mermaid-7 .icon-shape%2c%23mermaid-7 .image-shape%7bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3btext-align:center%3b%7d%23mermaid-7 .icon-shape p%2c%23mermaid-7 .image-shape p%7bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bpadding:2px%3b%7d%23mermaid-7 .icon-shape .label rect%2c%23mermaid-7 .image-shape .label rect%7bopacity:0.5%3bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bfill:rgba(232%2c232%2c232%2c 0.8)%3b%7d%23mermaid-7 .label-icon%7bdisplay:inline-block%3bheight:1em%3boverflow:visible%3bvertical-align:-0.125em%3b%7d%23mermaid-7 .node .label-icon path%7bfill:currentColor%3bstroke:revert%3bstroke-width:revert%3b%7d%23mermaid-7 .node .neo-node%7bstroke:%239370DB%3b%7d%23mermaid-7 %5bdata-look='neo'%5d.node rect%2c%23mermaid-7 %5bdata-look='neo'%5d.cluster rect%2c%23mermaid-7 %5bdata-look='neo'%5d.node polygon%7bstroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-7 %5bdata-look='neo'%5d.swimlane.cluster rect%7bfilter:none%3b%7d%23mermaid-7 %5bdata-look='neo'%5d.node path%7bstroke:%239370DB%3bstroke-width:1px%3b%7d%23mermaid-7 %5bdata-look='neo'%5d.node .outer-path%7bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-7 %5bdata-look='neo'%5d.node .neo-line path%7bstroke:%239370DB%3bfilter:none%3b%7d%23mermaid-7 %5bdata-look='neo'%5d.node circle%7bstroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-7 %5bdata-look='neo'%5d.node circle .state-start%7bfill:black%3b%7d%23mermaid-7 %5bdata-look='neo'%5d.icon-shape .icon%7bfill:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-7 %5bdata-look='neo'%5d.icon-shape .icon-neo path%7bstroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-7 :root%7b--mermaid-font-family:arial%2csans-serif%3b%7d%3c/style%3e%3cg%3e%3cmarker id='mermaid-7_flowchart-v2-pointEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'%3e%3cpath d='M 0 0 L 10 5 L 0 10 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-7_flowchart-v2-pointStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='4.5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'%3e%3cpath d='M 0 5 L 10 10 L 10 0 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-7_flowchart-v2-pointEnd-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='11.5' refY='7' markerUnits='userSpaceOnUse' markerWidth='10.5' markerHeight='14' orient='auto'%3e%3cpath d='M 0 0 L 11.5 7 L 0 14 z' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-7_flowchart-v2-pointStart-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='1' refY='7' markerUnits='userSpaceOnUse' markerWidth='11.5' markerHeight='14' orient='auto'%3e%3cpolygon points='0%2c7 11.5%2c14 11.5%2c0' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-7_flowchart-v2-circleEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='11' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-7_flowchart-v2-circleStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-1' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-7_flowchart-v2-circleEnd-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refY='5' refX='12.25' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-7_flowchart-v2-circleStart-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-2' refY='5' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-7_flowchart-v2-crossEnd' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='12' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3cpath d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-7_flowchart-v2-crossStart' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='-1' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3cpath d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-7_flowchart-v2-crossEnd-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='17.7' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'%3e%3cpath d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-7_flowchart-v2-crossStart-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='-3.5' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'%3e%3cpath d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cg class='root'%3e%3cg class='clusters'/%3e%3cg class='edgePaths'%3e%3cpath d='M150.797%2c62L150.797%2c66.167C150.797%2c70.333%2c150.797%2c78.667%2c150.797%2c86.333C150.797%2c94%2c150.797%2c101%2c150.797%2c104.5L150.797%2c108' id='mermaid-7-L_Client_Ingress_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_Client_Ingress_0' data-points='W3sieCI6MTUwLjc5Njg3NSwieSI6NjJ9LHsieCI6MTUwLjc5Njg3NSwieSI6ODd9LHsieCI6MTUwLjc5Njg3NSwieSI6MTEyfV0=' data-look='classic' marker-end='url(%23mermaid-7_flowchart-v2-pointEnd)'/%3e%3cpath d='M150.797%2c166L150.797%2c170.167C150.797%2c174.333%2c150.797%2c182.667%2c150.797%2c190.333C150.797%2c198%2c150.797%2c205%2c150.797%2c208.5L150.797%2c212' id='mermaid-7-L_Ingress_Service_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_Ingress_Service_0' data-points='W3sieCI6MTUwLjc5Njg3NSwieSI6MTY2fSx7IngiOjE1MC43OTY4NzUsInkiOjE5MX0seyJ4IjoxNTAuNzk2ODc1LCJ5IjoyMTZ9XQ==' data-look='classic' marker-end='url(%23mermaid-7_flowchart-v2-pointEnd)'/%3e%3cpath d='M95.807%2c270L87.321%2c274.167C78.835%2c278.333%2c61.863%2c286.667%2c56.175%2c294.472C50.488%2c302.277%2c56.085%2c309.553%2c58.884%2c313.191L61.683%2c316.83' id='mermaid-7-L_Service_P1_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_Service_P1_0' data-points='W3sieCI6OTUuODA3MDkxMzQ2MTUzODQsInkiOjI3MH0seyJ4Ijo0NC44OTA2MjUsInkiOjI5NX0seyJ4Ijo2NC4xMjEzOTQyMzA3NjkyMywieSI6MzIwfV0=' data-look='classic' marker-end='url(%23mermaid-7_flowchart-v2-pointEnd)'/%3e%3cpath d='M150.797%2c270L150.797%2c274.167C150.797%2c278.333%2c150.797%2c286.667%2c174.674%2c297.103C198.552%2c307.539%2c246.306%2c320.078%2c270.184%2c326.348L294.061%2c332.617' id='mermaid-7-L_Service_P2_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_Service_P2_0' data-points='W3sieCI6MTUwLjc5Njg3NSwieSI6MjcwfSx7IngiOjE1MC43OTY4NzUsInkiOjI5NX0seyJ4IjoyOTcuOTI5Njg3NSwieSI6MzMzLjYzMzMxODg2ODU5NDR9XQ==' data-look='classic' marker-end='url(%23mermaid-7_flowchart-v2-pointEnd)'/%3e%3cpath d='M256.375%2c256.195L308.125%2c262.662C359.875%2c269.13%2c463.375%2c282.065%2c518.362%2c292.199C573.349%2c302.334%2c579.824%2c309.668%2c583.061%2c313.334L586.298%2c317.001' id='mermaid-7-L_Service_P3_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_Service_P3_0' data-points='W3sieCI6MjU2LjM3NSwieSI6MjU2LjE5NDc4NzYzNzUzOH0seyJ4Ijo1NjYuODc1LCJ5IjoyOTV9LHsieCI6NTg4Ljk0NTMxMjUsInkiOjMyMH1d' data-look='classic' marker-end='url(%23mermaid-7_flowchart-v2-pointEnd)'/%3e%3cpath d='M306.375%2c256.516L273.779%2c262.93C241.182%2c269.344%2c175.99%2c282.172%2c141.615%2c292.156C107.24%2c302.14%2c103.683%2c309.28%2c101.904%2c312.85L100.126%2c316.42' id='mermaid-7-L_Config_P1_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_Config_P1_0' data-points='W3sieCI6MzA2LjM3NSwieSI6MjU2LjUxNTc1NzEwOTkxNTQ2fSx7IngiOjExMC43OTY4NzUsInkiOjI5NX0seyJ4Ijo5OC4zNDE5NDcxMTUzODQ2MSwieSI6MzIwfV0=' data-look='classic' marker-end='url(%23mermaid-7_flowchart-v2-pointEnd)'/%3e%3cpath d='M375.063%2c270L375.063%2c274.167C375.063%2c278.333%2c375.063%2c286.667%2c373.261%2c294.405C371.46%2c302.143%2c367.857%2c309.286%2c366.056%2c312.857L364.255%2c316.429' id='mermaid-7-L_Config_P2_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_Config_P2_0' data-points='W3sieCI6Mzc1LjA2MjUsInkiOjI3MH0seyJ4IjozNzUuMDYyNSwieSI6Mjk1fSx7IngiOjM2Mi40NTM1NzU3MjExNTM4NywieSI6MzIwfV0=' data-look='classic' marker-end='url(%23mermaid-7_flowchart-v2-pointEnd)'/%3e%3cpath d='M443.75%2c259.863L467.604%2c265.719C491.458%2c271.575%2c539.167%2c283.288%2c564.799%2c292.714C590.432%2c302.14%2c593.989%2c309.28%2c595.768%2c312.85L597.546%2c316.42' id='mermaid-7-L_Config_P3_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_Config_P3_0' data-points='W3sieCI6NDQzLjc1LCJ5IjoyNTkuODYyNzkxMzgzODg5MDN9LHsieCI6NTg2Ljg3NSwieSI6Mjk1fSx7IngiOjU5OS4zMjk5Mjc4ODQ2MTU0LCJ5IjozMjB9XQ==' data-look='classic' marker-end='url(%23mermaid-7_flowchart-v2-pointEnd)'/%3e%3cpath d='M493.75%2c249.639L433.258%2c257.199C372.766%2c264.76%2c251.781%2c279.88%2c188.052%2c291.107C124.323%2c302.334%2c117.848%2c309.668%2c114.611%2c313.334L111.374%2c317.001' id='mermaid-7-L_Secret_P1_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_Secret_P1_0' data-points='W3sieCI6NDkzLjc1LCJ5IjoyNDkuNjM5Mzc4MTIxNTk2NzZ9LHsieCI6MTMwLjc5Njg3NSwieSI6Mjk1fSx7IngiOjEwOC43MjY1NjI1LCJ5IjozMjB9XQ==' data-look='classic' marker-end='url(%23mermaid-7_flowchart-v2-pointEnd)'/%3e%3cpath d='M546.875%2c270L546.875%2c274.167C546.875%2c278.333%2c546.875%2c286.667%2c522.998%2c297.103C499.12%2c307.539%2c451.366%2c320.078%2c427.488%2c326.348L403.611%2c332.617' id='mermaid-7-L_Secret_P2_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_Secret_P2_0' data-points='W3sieCI6NTQ2Ljg3NSwieSI6MjcwfSx7IngiOjU0Ni44NzUsInkiOjI5NX0seyJ4IjozOTkuNzQyMTg3NSwieSI6MzMzLjYzMzMxODg2ODU5NDR9XQ==' data-look='classic' marker-end='url(%23mermaid-7_flowchart-v2-pointEnd)'/%3e%3cpath d='M600%2c269.084L608.797%2c273.404C617.594%2c277.723%2c635.188%2c286.361%2c641.186%2c294.319C647.184%2c302.277%2c641.587%2c309.553%2c638.788%2c313.191L635.989%2c316.83' id='mermaid-7-L_Secret_P3_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_Secret_P3_0' data-points='W3sieCI6NjAwLCJ5IjoyNjkuMDg0MzkwNjc1NzE1NTV9LHsieCI6NjUyLjc4MTI1LCJ5IjoyOTV9LHsieCI6NjMzLjU1MDQ4MDc2OTIzMDcsInkiOjMyMH1d' data-look='classic' marker-end='url(%23mermaid-7_flowchart-v2-pointEnd)'/%3e%3cpath d='M58.929%2c374L54.923%2c378.167C50.916%2c382.333%2c42.903%2c390.667%2c40.26%2c398.378C37.617%2c406.089%2c40.344%2c413.178%2c41.707%2c416.722L43.07%2c420.267' id='mermaid-7-L_P1_RDS_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_P1_RDS_0' data-points='W3sieCI6NTguOTI5MDg2NTM4NDYxNTQsInkiOjM3NH0seyJ4IjozNC44OTA2MjUsInkiOjM5OX0seyJ4Ijo0NC41MDYwMDk2MTUzODQ2MSwieSI6NDI0fV0=' data-look='classic' marker-end='url(%23mermaid-7_flowchart-v2-pointEnd)'/%3e%3cpath d='M297.93%2c358.608L268.408%2c365.34C238.885%2c372.072%2c179.841%2c385.536%2c145.561%2c396.022C111.282%2c406.507%2c101.767%2c414.015%2c97.009%2c417.769L92.251%2c421.522' id='mermaid-7-L_P2_RDS_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_P2_RDS_0' data-points='W3sieCI6Mjk3LjkyOTY4NzUsInkiOjM1OC42MDgyMDg1NzE3MjIyM30seyJ4IjoxMjAuNzk2ODc1LCJ5IjozOTl9LHsieCI6ODkuMTExMTc3ODg0NjE1MzksInkiOjQyNH1d' data-look='classic' marker-end='url(%23mermaid-7_flowchart-v2-pointEnd)'/%3e%3cpath d='M561.875%2c356.663L524.702%2c363.719C487.529%2c370.775%2c413.182%2c384.888%2c337.156%2c399.059C261.129%2c413.231%2c183.423%2c427.461%2c144.569%2c434.577L105.716%2c441.692' id='mermaid-7-L_P3_RDS_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_P3_RDS_0' data-points='W3sieCI6NTYxLjg3NSwieSI6MzU2LjY2Mjk2ODc3MjI4MDA3fSx7IngiOjMzOC44MzU5Mzc1LCJ5IjozOTl9LHsieCI6MTAxLjc4MTI1LCJ5Ijo0NDIuNDEyNzM5MDI4NzUyMjR9XQ==' data-look='classic' marker-end='url(%23mermaid-7_flowchart-v2-pointEnd)'/%3e%3cpath d='M135.797%2c356.663L172.97%2c363.719C210.143%2c370.775%2c284.49%2c384.888%2c359.921%2c398.95C435.353%2c413.013%2c511.869%2c427.026%2c550.127%2c434.032L588.386%2c441.038' id='mermaid-7-L_P1_Kafka_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_P1_Kafka_0' data-points='W3sieCI6MTM1Ljc5Njg3NSwieSI6MzU2LjY2Mjk2ODc3MjI4MDA3fSx7IngiOjM1OC44MzU5Mzc1LCJ5IjozOTl9LHsieCI6NTkyLjMyMDMxMjUsInkiOjQ0MS43NTg4OTM5MzMxNDA3fV0=' data-look='classic' marker-end='url(%23mermaid-7_flowchart-v2-pointEnd)'/%3e%3cpath d='M399.742%2c358.608L429.264%2c365.34C458.786%2c372.072%2c517.831%2c385.536%2c552.11%2c396.022C586.39%2c406.507%2c595.905%2c414.015%2c600.663%2c417.769L605.42%2c421.522' id='mermaid-7-L_P2_Kafka_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_P2_Kafka_0' data-points='W3sieCI6Mzk5Ljc0MjE4NzUsInkiOjM1OC42MDgyMDg1NzE3MjIyM30seyJ4Ijo1NzYuODc1LCJ5IjozOTl9LHsieCI6NjA4LjU2MDY5NzExNTM4NDYsInkiOjQyNH1d' data-look='classic' marker-end='url(%23mermaid-7_flowchart-v2-pointEnd)'/%3e%3cpath d='M638.743%2c374L642.749%2c378.167C646.756%2c382.333%2c654.768%2c390.667%2c657.412%2c398.378C660.055%2c406.089%2c657.328%2c413.178%2c655.965%2c416.722L654.602%2c420.267' id='mermaid-7-L_P3_Kafka_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_P3_Kafka_0' data-points='W3sieCI6NjM4Ljc0Mjc4ODQ2MTUzODUsInkiOjM3NH0seyJ4Ijo2NjIuNzgxMjUsInkiOjM5OX0seyJ4Ijo2NTMuMTY1ODY1Mzg0NjE1NCwieSI6NDI0fV0=' data-look='classic' marker-end='url(%23mermaid-7_flowchart-v2-pointEnd)'/%3e%3c/g%3e%3cg class='edgeLabels'%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_Client_Ingress_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_Ingress_Service_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_Service_P1_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_Service_P2_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_Service_P3_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_Config_P1_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_Config_P2_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_Config_P3_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_Secret_P1_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_Secret_P2_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_Secret_P3_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_P1_RDS_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_P2_RDS_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_P3_RDS_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_P1_Kafka_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_P2_Kafka_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_P3_Kafka_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cg class='nodes'%3e%3cg class='node default' id='mermaid-7-flowchart-Client-0' data-look='classic' transform='translate(150.796875%2c 35)'%3e%3crect class='basic label-container' style='' x='-50.453125' y='-27' width='100.90625' height='54'/%3e%3cg class='label' style='' transform='translate(-20.453125%2c -12)'%3e%3crect/%3e%3cforeignObject width='40.90625' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eClient%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-7-flowchart-Ingress-1' data-look='classic' transform='translate(150.796875%2c 139)'%3e%3crect class='basic label-container' style='' x='-93.140625' y='-27' width='186.28125' height='54'/%3e%3cg class='label' style='' transform='translate(-63.140625%2c -12)'%3e%3crect/%3e%3cforeignObject width='126.28125' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eIngress Controller%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-7-flowchart-Service-3' data-look='classic' transform='translate(150.796875%2c 243)'%3e%3crect class='basic label-container' style='' x='-105.578125' y='-27' width='211.15625' height='54'/%3e%3cg class='label' style='' transform='translate(-75.578125%2c -12)'%3e%3crect/%3e%3cforeignObject width='151.15625' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eorder-service Service%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-7-flowchart-P1-5' data-look='classic' transform='translate(84.890625%2c 347)'%3e%3crect class='basic label-container' style='' x='-50.90625' y='-27' width='101.8125' height='54'/%3e%3cg class='label' style='' transform='translate(-20.90625%2c -12)'%3e%3crect/%3e%3cforeignObject width='41.8125' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3ePod 1%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-7-flowchart-P2-7' data-look='classic' transform='translate(348.8359375%2c 347)'%3e%3crect class='basic label-container' style='' x='-50.90625' y='-27' width='101.8125' height='54'/%3e%3cg class='label' style='' transform='translate(-20.90625%2c -12)'%3e%3crect/%3e%3cforeignObject width='41.8125' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3ePod 2%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-7-flowchart-P3-9' data-look='classic' transform='translate(612.78125%2c 347)'%3e%3crect class='basic label-container' style='' x='-50.90625' y='-27' width='101.8125' height='54'/%3e%3cg class='label' style='' transform='translate(-20.90625%2c -12)'%3e%3crect/%3e%3cforeignObject width='41.8125' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3ePod 3%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-7-flowchart-Config-10' data-look='classic' transform='translate(375.0625%2c 243)'%3e%3crect class='basic label-container' style='' x='-68.6875' y='-27' width='137.375' height='54'/%3e%3cg class='label' style='' transform='translate(-38.6875%2c -12)'%3e%3crect/%3e%3cforeignObject width='77.375' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eConfigMap%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-7-flowchart-Secret-16' data-look='classic' transform='translate(546.875%2c 243)'%3e%3crect class='basic label-container' style='' x='-53.125' y='-27' width='106.25' height='54'/%3e%3cg class='label' style='' transform='translate(-23.125%2c -12)'%3e%3crect/%3e%3cforeignObject width='46.25' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eSecret%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-7-flowchart-RDS-23' data-look='classic' transform='translate(54.890625%2c 451)'%3e%3crect class='basic label-container' style='' x='-46.890625' y='-27' width='93.78125' height='54'/%3e%3cg class='label' style='' transform='translate(-16.890625%2c -12)'%3e%3crect/%3e%3cforeignObject width='33.78125' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eRDS%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-7-flowchart-Kafka-29' data-look='classic' transform='translate(642.78125%2c 451)'%3e%3crect class='basic label-container' style='' x='-50.4609375' y='-27' width='100.921875' height='54'/%3e%3cg class='label' style='' transform='translate(-20.4609375%2c -12)'%3e%3crect/%3e%3cforeignObject width='40.921875' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eKafka%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cdefs%3e%3cfilter id='mermaid-7-drop-shadow' height='130%25' width='130%25'%3e%3cfeDropShadow dx='4' dy='4' stdDeviation='0' flood-opacity='0.06' flood-color='black'/%3e%3c/filter%3e%3c/defs%3e%3cdefs%3e%3cfilter id='mermaid-7-drop-shadow-small' height='150%25' width='150%25'%3e%3cfeDropShadow dx='2' dy='2' stdDeviation='0' flood-opacity='0.06' flood-color='black'/%3e%3c/filter%3e%3c/defs%3e%3c/svg%3e)
%3btext-align:center%3b%7d%23mermaid-dark-7%20.edgeLabel%20p%7bbackground-color:hsl(0%2c%200%25%2c%2034.4117647059%25)%3b%7d%23mermaid-dark-7%20.edgeLabel%20rect%7bopacity:0.5%3bbackground-color:hsl(0%2c%200%25%2c%2034.4117647059%25)%3bfill:hsl(0%2c%200%25%2c%2034.4117647059%25)%3b%7d%23mermaid-dark-7%20.labelBkg%7bbackground-color:rgba(87.75%2c%2087.75%2c%2087.75%2c%200.5)%3b%7d%23mermaid-dark-7%20.cluster%20rect%7bfill:hsl(180%2c%201.5873015873%25%2c%2028.3529411765%25)%3bstroke:rgba(255%2c%20255%2c%20255%2c%200.25)%3bstroke-width:1px%3b%7d%23mermaid-dark-7%20.cluster%20text%7bfill:%23F9FFFE%3b%7d%23mermaid-dark-7%20.cluster%20span%7bcolor:%23F9FFFE%3b%7d%23mermaid-dark-7%20.node%20.collapsed-indicator%7bfill:rgba(255%2c%20255%2c%20255%2c%200.25)%3bstroke:none%3bopacity:0.6%3b%7d%23mermaid-dark-7%20.node%20.collapsed-separator%7bstroke:rgba(255%2c%20255%2c%20255%2c%200.25)%3bstroke-width:0.75px%3b%7d%23mermaid-dark-7%20div.mermaidTooltip%7bposition:absolute%3btext-align:center%3bmax-width:200px%3bpadding:2px%3bfont-family:arial%2csans-serif%3bfont-size:12px%3bbackground:hsl(20%2c%201.5873015873%25%2c%2012.3529411765%25)%3bborder:1px%20solid%20rgba(255%2c%20255%2c%20255%2c%200.25)%3bborder-radius:2px%3bpointer-events:none%3bz-index:100%3b%7d%23mermaid-dark-7%20.flowchartTitleText%7btext-anchor:middle%3bfont-size:18px%3bfill:%23ccc%3b%7d%23mermaid-dark-7%20rect.text%7bfill:none%3bstroke-width:0%3b%7d%23mermaid-dark-7%20.icon-shape%2c%23mermaid-dark-7%20.image-shape%7bbackground-color:hsl(0%2c%200%25%2c%2034.4117647059%25)%3btext-align:center%3b%7d%23mermaid-dark-7%20.icon-shape%20p%2c%23mermaid-dark-7%20.image-shape%20p%7bbackground-color:hsl(0%2c%200%25%2c%2034.4117647059%25)%3bpadding:2px%3b%7d%23mermaid-dark-7%20.icon-shape%20.label%20rect%2c%23mermaid-dark-7%20.image-shape%20.label%20rect%7bopacity:0.5%3bbackground-color:hsl(0%2c%200%25%2c%2034.4117647059%25)%3bfill:hsl(0%2c%200%25%2c%2034.4117647059%25)%3b%7d%23mermaid-dark-7%20.label-icon%7bdisplay:inline-block%3bheight:1em%3boverflow:visible%3bvertical-align:-0.125em%3b%7d%23mermaid-dark-7%20.node%20.label-icon%20path%7bfill:currentColor%3bstroke:revert%3bstroke-width:revert%3b%7d%23mermaid-dark-7%20.node%20.neo-node%7bstroke:%23ccc%3b%7d%23mermaid-dark-7%20%5bdata-look='neo'%5d.node%20rect%2c%23mermaid-dark-7%20%5bdata-look='neo'%5d.cluster%20rect%2c%23mermaid-dark-7%20%5bdata-look='neo'%5d.node%20polygon%7bstroke:url(%23mermaid-dark-7-gradient)%3bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-7%20%5bdata-look='neo'%5d.swimlane.cluster%20rect%7bfilter:none%3b%7d%23mermaid-dark-7%20%5bdata-look='neo'%5d.node%20path%7bstroke:url(%23mermaid-dark-7-gradient)%3bstroke-width:1px%3b%7d%23mermaid-dark-7%20%5bdata-look='neo'%5d.node%20.outer-path%7bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-7%20%5bdata-look='neo'%5d.node%20.neo-line%20path%7bstroke:%23ccc%3bfilter:none%3b%7d%23mermaid-dark-7%20%5bdata-look='neo'%5d.node%20circle%7bstroke:url(%23mermaid-dark-7-gradient)%3bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-7%20%5bdata-look='neo'%5d.node%20circle%20.state-start%7bfill:black%3b%7d%23mermaid-dark-7%20%5bdata-look='neo'%5d.icon-shape%20.icon%7bfill:url(%23mermaid-dark-7-gradient)%3bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-7%20%5bdata-look='neo'%5d.icon-shape%20.icon-neo%20path%7bstroke:url(%23mermaid-dark-7-gradient)%3bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-7%20:root%7b--mermaid-font-family:arial%2csans-serif%3b%7d%3c/style%3e%3cg%3e%3cmarker%20id='mermaid-dark-7_flowchart-v2-pointEnd'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='5'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='8'%20markerHeight='8'%20orient='auto'%3e%3cpath%20d='M%200%200%20L%2010%205%20L%200%2010%20z'%20class='arrowMarkerPath'%20style='stroke-width:%201%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-7_flowchart-v2-pointStart'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='4.5'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='8'%20markerHeight='8'%20orient='auto'%3e%3cpath%20d='M%200%205%20L%2010%2010%20L%2010%200%20z'%20class='arrowMarkerPath'%20style='stroke-width:%201%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-7_flowchart-v2-pointEnd-margin'%20class='marker%20flowchart-v2'%20viewBox='0%200%2011.5%2014'%20refX='11.5'%20refY='7'%20markerUnits='userSpaceOnUse'%20markerWidth='10.5'%20markerHeight='14'%20orient='auto'%3e%3cpath%20d='M%200%200%20L%2011.5%207%20L%200%2014%20z'%20class='arrowMarkerPath'%20style='stroke-width:%200%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-7_flowchart-v2-pointStart-margin'%20class='marker%20flowchart-v2'%20viewBox='0%200%2011.5%2014'%20refX='1'%20refY='7'%20markerUnits='userSpaceOnUse'%20markerWidth='11.5'%20markerHeight='14'%20orient='auto'%3e%3cpolygon%20points='0%2c7%2011.5%2c14%2011.5%2c0'%20class='arrowMarkerPath'%20style='stroke-width:%200%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-7_flowchart-v2-circleEnd'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='11'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='11'%20markerHeight='11'%20orient='auto'%3e%3ccircle%20cx='5'%20cy='5'%20r='5'%20class='arrowMarkerPath'%20style='stroke-width:%201%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-7_flowchart-v2-circleStart'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='-1'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='11'%20markerHeight='11'%20orient='auto'%3e%3ccircle%20cx='5'%20cy='5'%20r='5'%20class='arrowMarkerPath'%20style='stroke-width:%201%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-7_flowchart-v2-circleEnd-margin'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refY='5'%20refX='12.25'%20markerUnits='userSpaceOnUse'%20markerWidth='14'%20markerHeight='14'%20orient='auto'%3e%3ccircle%20cx='5'%20cy='5'%20r='5'%20class='arrowMarkerPath'%20style='stroke-width:%200%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-7_flowchart-v2-circleStart-margin'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='-2'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='14'%20markerHeight='14'%20orient='auto'%3e%3ccircle%20cx='5'%20cy='5'%20r='5'%20class='arrowMarkerPath'%20style='stroke-width:%200%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-7_flowchart-v2-crossEnd'%20class='marker%20cross%20flowchart-v2'%20viewBox='0%200%2011%2011'%20refX='12'%20refY='5.2'%20markerUnits='userSpaceOnUse'%20markerWidth='11'%20markerHeight='11'%20orient='auto'%3e%3cpath%20d='M%201%2c1%20l%209%2c9%20M%2010%2c1%20l%20-9%2c9'%20class='arrowMarkerPath'%20style='stroke-width:%202%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-7_flowchart-v2-crossStart'%20class='marker%20cross%20flowchart-v2'%20viewBox='0%200%2011%2011'%20refX='-1'%20refY='5.2'%20markerUnits='userSpaceOnUse'%20markerWidth='11'%20markerHeight='11'%20orient='auto'%3e%3cpath%20d='M%201%2c1%20l%209%2c9%20M%2010%2c1%20l%20-9%2c9'%20class='arrowMarkerPath'%20style='stroke-width:%202%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-7_flowchart-v2-crossEnd-margin'%20class='marker%20cross%20flowchart-v2'%20viewBox='0%200%2015%2015'%20refX='17.7'%20refY='7.5'%20markerUnits='userSpaceOnUse'%20markerWidth='12'%20markerHeight='12'%20orient='auto'%3e%3cpath%20d='M%201%2c1%20L%2014%2c14%20M%201%2c14%20L%2014%2c1'%20class='arrowMarkerPath'%20style='stroke-width:%202.5%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-7_flowchart-v2-crossStart-margin'%20class='marker%20cross%20flowchart-v2'%20viewBox='0%200%2015%2015'%20refX='-3.5'%20refY='7.5'%20markerUnits='userSpaceOnUse'%20markerWidth='12'%20markerHeight='12'%20orient='auto'%3e%3cpath%20d='M%201%2c1%20L%2014%2c14%20M%201%2c14%20L%2014%2c1'%20class='arrowMarkerPath'%20style='stroke-width:%202.5%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cg%20class='root'%3e%3cg%20class='clusters'/%3e%3cg%20class='edgePaths'%3e%3cpath%20d='M150.797%2c62L150.797%2c66.167C150.797%2c70.333%2c150.797%2c78.667%2c150.797%2c86.333C150.797%2c94%2c150.797%2c101%2c150.797%2c104.5L150.797%2c108'%20id='mermaid-dark-7-L_Client_Ingress_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_Client_Ingress_0'%20data-points='W3sieCI6MTUwLjc5Njg3NSwieSI6NjJ9LHsieCI6MTUwLjc5Njg3NSwieSI6ODd9LHsieCI6MTUwLjc5Njg3NSwieSI6MTEyfV0='%20data-look='classic'%20marker-end='url(%23mermaid-dark-7_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M150.797%2c166L150.797%2c170.167C150.797%2c174.333%2c150.797%2c182.667%2c150.797%2c190.333C150.797%2c198%2c150.797%2c205%2c150.797%2c208.5L150.797%2c212'%20id='mermaid-dark-7-L_Ingress_Service_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_Ingress_Service_0'%20data-points='W3sieCI6MTUwLjc5Njg3NSwieSI6MTY2fSx7IngiOjE1MC43OTY4NzUsInkiOjE5MX0seyJ4IjoxNTAuNzk2ODc1LCJ5IjoyMTZ9XQ=='%20data-look='classic'%20marker-end='url(%23mermaid-dark-7_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M95.807%2c270L87.321%2c274.167C78.835%2c278.333%2c61.863%2c286.667%2c56.175%2c294.472C50.488%2c302.277%2c56.085%2c309.553%2c58.884%2c313.191L61.683%2c316.83'%20id='mermaid-dark-7-L_Service_P1_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_Service_P1_0'%20data-points='W3sieCI6OTUuODA3MDkxMzQ2MTUzODQsInkiOjI3MH0seyJ4Ijo0NC44OTA2MjUsInkiOjI5NX0seyJ4Ijo2NC4xMjEzOTQyMzA3NjkyMywieSI6MzIwfV0='%20data-look='classic'%20marker-end='url(%23mermaid-dark-7_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M150.797%2c270L150.797%2c274.167C150.797%2c278.333%2c150.797%2c286.667%2c174.674%2c297.103C198.552%2c307.539%2c246.306%2c320.078%2c270.184%2c326.348L294.061%2c332.617'%20id='mermaid-dark-7-L_Service_P2_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_Service_P2_0'%20data-points='W3sieCI6MTUwLjc5Njg3NSwieSI6MjcwfSx7IngiOjE1MC43OTY4NzUsInkiOjI5NX0seyJ4IjoyOTcuOTI5Njg3NSwieSI6MzMzLjYzMzMxODg2ODU5NDR9XQ=='%20data-look='classic'%20marker-end='url(%23mermaid-dark-7_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M256.375%2c256.195L308.125%2c262.662C359.875%2c269.13%2c463.375%2c282.065%2c518.362%2c292.199C573.349%2c302.334%2c579.824%2c309.668%2c583.061%2c313.334L586.298%2c317.001'%20id='mermaid-dark-7-L_Service_P3_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_Service_P3_0'%20data-points='W3sieCI6MjU2LjM3NSwieSI6MjU2LjE5NDc4NzYzNzUzOH0seyJ4Ijo1NjYuODc1LCJ5IjoyOTV9LHsieCI6NTg4Ljk0NTMxMjUsInkiOjMyMH1d'%20data-look='classic'%20marker-end='url(%23mermaid-dark-7_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M306.375%2c256.516L273.779%2c262.93C241.182%2c269.344%2c175.99%2c282.172%2c141.615%2c292.156C107.24%2c302.14%2c103.683%2c309.28%2c101.904%2c312.85L100.126%2c316.42'%20id='mermaid-dark-7-L_Config_P1_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_Config_P1_0'%20data-points='W3sieCI6MzA2LjM3NSwieSI6MjU2LjUxNTc1NzEwOTkxNTQ2fSx7IngiOjExMC43OTY4NzUsInkiOjI5NX0seyJ4Ijo5OC4zNDE5NDcxMTUzODQ2MSwieSI6MzIwfV0='%20data-look='classic'%20marker-end='url(%23mermaid-dark-7_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M375.063%2c270L375.063%2c274.167C375.063%2c278.333%2c375.063%2c286.667%2c373.261%2c294.405C371.46%2c302.143%2c367.857%2c309.286%2c366.056%2c312.857L364.255%2c316.429'%20id='mermaid-dark-7-L_Config_P2_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_Config_P2_0'%20data-points='W3sieCI6Mzc1LjA2MjUsInkiOjI3MH0seyJ4IjozNzUuMDYyNSwieSI6Mjk1fSx7IngiOjM2Mi40NTM1NzU3MjExNTM4NywieSI6MzIwfV0='%20data-look='classic'%20marker-end='url(%23mermaid-dark-7_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M443.75%2c259.863L467.604%2c265.719C491.458%2c271.575%2c539.167%2c283.288%2c564.799%2c292.714C590.432%2c302.14%2c593.989%2c309.28%2c595.768%2c312.85L597.546%2c316.42'%20id='mermaid-dark-7-L_Config_P3_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_Config_P3_0'%20data-points='W3sieCI6NDQzLjc1LCJ5IjoyNTkuODYyNzkxMzgzODg5MDN9LHsieCI6NTg2Ljg3NSwieSI6Mjk1fSx7IngiOjU5OS4zMjk5Mjc4ODQ2MTU0LCJ5IjozMjB9XQ=='%20data-look='classic'%20marker-end='url(%23mermaid-dark-7_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M493.75%2c249.639L433.258%2c257.199C372.766%2c264.76%2c251.781%2c279.88%2c188.052%2c291.107C124.323%2c302.334%2c117.848%2c309.668%2c114.611%2c313.334L111.374%2c317.001'%20id='mermaid-dark-7-L_Secret_P1_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_Secret_P1_0'%20data-points='W3sieCI6NDkzLjc1LCJ5IjoyNDkuNjM5Mzc4MTIxNTk2NzZ9LHsieCI6MTMwLjc5Njg3NSwieSI6Mjk1fSx7IngiOjEwOC43MjY1NjI1LCJ5IjozMjB9XQ=='%20data-look='classic'%20marker-end='url(%23mermaid-dark-7_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M546.875%2c270L546.875%2c274.167C546.875%2c278.333%2c546.875%2c286.667%2c522.998%2c297.103C499.12%2c307.539%2c451.366%2c320.078%2c427.488%2c326.348L403.611%2c332.617'%20id='mermaid-dark-7-L_Secret_P2_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_Secret_P2_0'%20data-points='W3sieCI6NTQ2Ljg3NSwieSI6MjcwfSx7IngiOjU0Ni44NzUsInkiOjI5NX0seyJ4IjozOTkuNzQyMTg3NSwieSI6MzMzLjYzMzMxODg2ODU5NDR9XQ=='%20data-look='classic'%20marker-end='url(%23mermaid-dark-7_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M600%2c269.084L608.797%2c273.404C617.594%2c277.723%2c635.188%2c286.361%2c641.186%2c294.319C647.184%2c302.277%2c641.587%2c309.553%2c638.788%2c313.191L635.989%2c316.83'%20id='mermaid-dark-7-L_Secret_P3_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_Secret_P3_0'%20data-points='W3sieCI6NjAwLCJ5IjoyNjkuMDg0MzkwNjc1NzE1NTV9LHsieCI6NjUyLjc4MTI1LCJ5IjoyOTV9LHsieCI6NjMzLjU1MDQ4MDc2OTIzMDcsInkiOjMyMH1d'%20data-look='classic'%20marker-end='url(%23mermaid-dark-7_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M58.929%2c374L54.923%2c378.167C50.916%2c382.333%2c42.903%2c390.667%2c40.26%2c398.378C37.617%2c406.089%2c40.344%2c413.178%2c41.707%2c416.722L43.07%2c420.267'%20id='mermaid-dark-7-L_P1_RDS_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_P1_RDS_0'%20data-points='W3sieCI6NTguOTI5MDg2NTM4NDYxNTQsInkiOjM3NH0seyJ4IjozNC44OTA2MjUsInkiOjM5OX0seyJ4Ijo0NC41MDYwMDk2MTUzODQ2MSwieSI6NDI0fV0='%20data-look='classic'%20marker-end='url(%23mermaid-dark-7_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M297.93%2c358.608L268.408%2c365.34C238.885%2c372.072%2c179.841%2c385.536%2c145.561%2c396.022C111.282%2c406.507%2c101.767%2c414.015%2c97.009%2c417.769L92.251%2c421.522'%20id='mermaid-dark-7-L_P2_RDS_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_P2_RDS_0'%20data-points='W3sieCI6Mjk3LjkyOTY4NzUsInkiOjM1OC42MDgyMDg1NzE3MjIyM30seyJ4IjoxMjAuNzk2ODc1LCJ5IjozOTl9LHsieCI6ODkuMTExMTc3ODg0NjE1MzksInkiOjQyNH1d'%20data-look='classic'%20marker-end='url(%23mermaid-dark-7_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M561.875%2c356.663L524.702%2c363.719C487.529%2c370.775%2c413.182%2c384.888%2c337.156%2c399.059C261.129%2c413.231%2c183.423%2c427.461%2c144.569%2c434.577L105.716%2c441.692'%20id='mermaid-dark-7-L_P3_RDS_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_P3_RDS_0'%20data-points='W3sieCI6NTYxLjg3NSwieSI6MzU2LjY2Mjk2ODc3MjI4MDA3fSx7IngiOjMzOC44MzU5Mzc1LCJ5IjozOTl9LHsieCI6MTAxLjc4MTI1LCJ5Ijo0NDIuNDEyNzM5MDI4NzUyMjR9XQ=='%20data-look='classic'%20marker-end='url(%23mermaid-dark-7_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M135.797%2c356.663L172.97%2c363.719C210.143%2c370.775%2c284.49%2c384.888%2c359.921%2c398.95C435.353%2c413.013%2c511.869%2c427.026%2c550.127%2c434.032L588.386%2c441.038'%20id='mermaid-dark-7-L_P1_Kafka_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_P1_Kafka_0'%20data-points='W3sieCI6MTM1Ljc5Njg3NSwieSI6MzU2LjY2Mjk2ODc3MjI4MDA3fSx7IngiOjM1OC44MzU5Mzc1LCJ5IjozOTl9LHsieCI6NTkyLjMyMDMxMjUsInkiOjQ0MS43NTg4OTM5MzMxNDA3fV0='%20data-look='classic'%20marker-end='url(%23mermaid-dark-7_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M399.742%2c358.608L429.264%2c365.34C458.786%2c372.072%2c517.831%2c385.536%2c552.11%2c396.022C586.39%2c406.507%2c595.905%2c414.015%2c600.663%2c417.769L605.42%2c421.522'%20id='mermaid-dark-7-L_P2_Kafka_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_P2_Kafka_0'%20data-points='W3sieCI6Mzk5Ljc0MjE4NzUsInkiOjM1OC42MDgyMDg1NzE3MjIyM30seyJ4Ijo1NzYuODc1LCJ5IjozOTl9LHsieCI6NjA4LjU2MDY5NzExNTM4NDYsInkiOjQyNH1d'%20data-look='classic'%20marker-end='url(%23mermaid-dark-7_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M638.743%2c374L642.749%2c378.167C646.756%2c382.333%2c654.768%2c390.667%2c657.412%2c398.378C660.055%2c406.089%2c657.328%2c413.178%2c655.965%2c416.722L654.602%2c420.267'%20id='mermaid-dark-7-L_P3_Kafka_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_P3_Kafka_0'%20data-points='W3sieCI6NjM4Ljc0Mjc4ODQ2MTUzODUsInkiOjM3NH0seyJ4Ijo2NjIuNzgxMjUsInkiOjM5OX0seyJ4Ijo2NTMuMTY1ODY1Mzg0NjE1NCwieSI6NDI0fV0='%20data-look='classic'%20marker-end='url(%23mermaid-dark-7_flowchart-v2-pointEnd)'/%3e%3c/g%3e%3cg%20class='edgeLabels'%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_Client_Ingress_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_Ingress_Service_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_Service_P1_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_Service_P2_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_Service_P3_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_Config_P1_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_Config_P2_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_Config_P3_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_Secret_P1_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_Secret_P2_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_Secret_P3_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_P1_RDS_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_P2_RDS_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_P3_RDS_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_P1_Kafka_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_P2_Kafka_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_P3_Kafka_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cg%20class='nodes'%3e%3cg%20class='node%20default'%20id='mermaid-dark-7-flowchart-Client-0'%20data-look='classic'%20transform='translate(150.796875%2c%2035)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-50.453125'%20y='-27'%20width='100.90625'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-20.453125%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='40.90625'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3eClient%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-7-flowchart-Ingress-1'%20data-look='classic'%20transform='translate(150.796875%2c%20139)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-93.140625'%20y='-27'%20width='186.28125'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-63.140625%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='126.28125'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3eIngress%20Controller%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-7-flowchart-Service-3'%20data-look='classic'%20transform='translate(150.796875%2c%20243)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-105.578125'%20y='-27'%20width='211.15625'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-75.578125%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='151.15625'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3eorder-service%20Service%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-7-flowchart-P1-5'%20data-look='classic'%20transform='translate(84.890625%2c%20347)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-50.90625'%20y='-27'%20width='101.8125'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-20.90625%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='41.8125'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3ePod%201%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-7-flowchart-P2-7'%20data-look='classic'%20transform='translate(348.8359375%2c%20347)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-50.90625'%20y='-27'%20width='101.8125'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-20.90625%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='41.8125'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3ePod%202%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-7-flowchart-P3-9'%20data-look='classic'%20transform='translate(612.78125%2c%20347)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-50.90625'%20y='-27'%20width='101.8125'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-20.90625%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='41.8125'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3ePod%203%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-7-flowchart-Config-10'%20data-look='classic'%20transform='translate(375.0625%2c%20243)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-68.6875'%20y='-27'%20width='137.375'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-38.6875%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='77.375'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3eConfigMap%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-7-flowchart-Secret-16'%20data-look='classic'%20transform='translate(546.875%2c%20243)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-53.125'%20y='-27'%20width='106.25'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-23.125%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='46.25'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3eSecret%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-7-flowchart-RDS-23'%20data-look='classic'%20transform='translate(54.890625%2c%20451)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-46.890625'%20y='-27'%20width='93.78125'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-16.890625%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='33.78125'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3eRDS%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-7-flowchart-Kafka-29'%20data-look='classic'%20transform='translate(642.78125%2c%20451)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-50.4609375'%20y='-27'%20width='100.921875'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-20.4609375%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='40.921875'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3eKafka%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cdefs%3e%3cfilter%20id='mermaid-dark-7-drop-shadow'%20height='130%25'%20width='130%25'%3e%3cfeDropShadow%20dx='4'%20dy='4'%20stdDeviation='0'%20flood-opacity='0.06'%20flood-color='white'/%3e%3c/filter%3e%3c/defs%3e%3cdefs%3e%3cfilter%20id='mermaid-dark-7-drop-shadow-small'%20height='150%25'%20width='150%25'%3e%3cfeDropShadow%20dx='2'%20dy='2'%20stdDeviation='0'%20flood-opacity='0.06'%20flood-color='white'/%3e%3c/filter%3e%3c/defs%3e%3clinearGradient%20id='mermaid-dark-7-gradient'%20gradientUnits='objectBoundingBox'%20x1='0%25'%20y1='0%25'%20x2='100%25'%20y2='0%25'%3e%3cstop%20offset='0%25'%20stop-color='%23cccccc'%20stop-opacity='1'/%3e%3cstop%20offset='100%25'%20stop-color='hsl(180%2c%200%25%2c%2018.3529411765%25)'%20stop-opacity='1'/%3e%3c/linearGradient%3e%3c/svg%3e)
从提交 Deployment 到请求抵达业务进程,完整控制链和流量链在这里汇合:
%3btext-align:center%3b%7d%23mermaid-8 .edgeLabel p%7bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3b%7d%23mermaid-8 .edgeLabel rect%7bopacity:0.5%3bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bfill:rgba(232%2c232%2c232%2c 0.8)%3b%7d%23mermaid-8 .labelBkg%7bbackground-color:rgba(232%2c 232%2c 232%2c 0.5)%3b%7d%23mermaid-8 .cluster rect%7bfill:%23ffffde%3bstroke:%23aaaa33%3bstroke-width:1px%3b%7d%23mermaid-8 .cluster text%7bfill:%23333%3b%7d%23mermaid-8 .cluster span%7bcolor:%23333%3b%7d%23mermaid-8 .node .collapsed-indicator%7bfill:%23aaaa33%3bstroke:none%3bopacity:0.6%3b%7d%23mermaid-8 .node .collapsed-separator%7bstroke:%23aaaa33%3bstroke-width:0.75px%3b%7d%23mermaid-8 div.mermaidTooltip%7bposition:absolute%3btext-align:center%3bmax-width:200px%3bpadding:2px%3bfont-family:arial%2csans-serif%3bfont-size:12px%3bbackground:hsl(80%2c 100%25%2c 96.2745098039%25)%3bborder:1px solid %23aaaa33%3bborder-radius:2px%3bpointer-events:none%3bz-index:100%3b%7d%23mermaid-8 .flowchartTitleText%7btext-anchor:middle%3bfont-size:18px%3bfill:%23333%3b%7d%23mermaid-8 rect.text%7bfill:none%3bstroke-width:0%3b%7d%23mermaid-8 .icon-shape%2c%23mermaid-8 .image-shape%7bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3btext-align:center%3b%7d%23mermaid-8 .icon-shape p%2c%23mermaid-8 .image-shape p%7bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bpadding:2px%3b%7d%23mermaid-8 .icon-shape .label rect%2c%23mermaid-8 .image-shape .label rect%7bopacity:0.5%3bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bfill:rgba(232%2c232%2c232%2c 0.8)%3b%7d%23mermaid-8 .label-icon%7bdisplay:inline-block%3bheight:1em%3boverflow:visible%3bvertical-align:-0.125em%3b%7d%23mermaid-8 .node .label-icon path%7bfill:currentColor%3bstroke:revert%3bstroke-width:revert%3b%7d%23mermaid-8 .node .neo-node%7bstroke:%239370DB%3b%7d%23mermaid-8 %5bdata-look='neo'%5d.node rect%2c%23mermaid-8 %5bdata-look='neo'%5d.cluster rect%2c%23mermaid-8 %5bdata-look='neo'%5d.node polygon%7bstroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-8 %5bdata-look='neo'%5d.swimlane.cluster rect%7bfilter:none%3b%7d%23mermaid-8 %5bdata-look='neo'%5d.node path%7bstroke:%239370DB%3bstroke-width:1px%3b%7d%23mermaid-8 %5bdata-look='neo'%5d.node .outer-path%7bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-8 %5bdata-look='neo'%5d.node .neo-line path%7bstroke:%239370DB%3bfilter:none%3b%7d%23mermaid-8 %5bdata-look='neo'%5d.node circle%7bstroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-8 %5bdata-look='neo'%5d.node circle .state-start%7bfill:black%3b%7d%23mermaid-8 %5bdata-look='neo'%5d.icon-shape .icon%7bfill:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-8 %5bdata-look='neo'%5d.icon-shape .icon-neo path%7bstroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b%7d%23mermaid-8 :root%7b--mermaid-font-family:arial%2csans-serif%3b%7d%3c/style%3e%3cg%3e%3cmarker id='mermaid-8_flowchart-v2-pointEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'%3e%3cpath d='M 0 0 L 10 5 L 0 10 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-8_flowchart-v2-pointStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='4.5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'%3e%3cpath d='M 0 5 L 10 10 L 10 0 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-8_flowchart-v2-pointEnd-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='11.5' refY='7' markerUnits='userSpaceOnUse' markerWidth='10.5' markerHeight='14' orient='auto'%3e%3cpath d='M 0 0 L 11.5 7 L 0 14 z' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-8_flowchart-v2-pointStart-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='1' refY='7' markerUnits='userSpaceOnUse' markerWidth='11.5' markerHeight='14' orient='auto'%3e%3cpolygon points='0%2c7 11.5%2c14 11.5%2c0' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-8_flowchart-v2-circleEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='11' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-8_flowchart-v2-circleStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-1' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-8_flowchart-v2-circleEnd-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refY='5' refX='12.25' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-8_flowchart-v2-circleStart-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-2' refY='5' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'%3e%3ccircle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-8_flowchart-v2-crossEnd' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='12' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3cpath d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-8_flowchart-v2-crossStart' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='-1' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'%3e%3cpath d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-8_flowchart-v2-crossEnd-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='17.7' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'%3e%3cpath d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b'/%3e%3c/marker%3e%3cmarker id='mermaid-8_flowchart-v2-crossStart-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='-3.5' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'%3e%3cpath d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b stroke-dasharray: 1%2c 0%3b'/%3e%3c/marker%3e%3cg class='root'%3e%3cg class='clusters'/%3e%3cg class='edgePaths'%3e%3cpath d='M169.375%2c35L173.542%2c35C177.708%2c35%2c186.042%2c35%2c193.708%2c35C201.375%2c35%2c208.375%2c35%2c211.875%2c35L215.375%2c35' id='mermaid-8-L_Helm_API_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_Helm_API_0' data-points='W3sieCI6MTY5LjM3NSwieSI6MzV9LHsieCI6MTk0LjM3NSwieSI6MzV9LHsieCI6MjE5LjM3NSwieSI6MzV9XQ==' data-look='classic' marker-end='url(%23mermaid-8_flowchart-v2-pointEnd)'/%3e%3cpath d='M356.734%2c35L360.901%2c35C365.068%2c35%2c373.401%2c35%2c381.068%2c35C388.734%2c35%2c395.734%2c35%2c399.234%2c35L402.734%2c35' id='mermaid-8-L_API_Deploy_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_API_Deploy_0' data-points='W3sieCI6MzU2LjczNDM3NSwieSI6MzV9LHsieCI6MzgxLjczNDM3NSwieSI6MzV9LHsieCI6NDA2LjczNDM3NSwieSI6MzV9XQ==' data-look='classic' marker-end='url(%23mermaid-8_flowchart-v2-pointEnd)'/%3e%3cpath d='M552.109%2c35L556.276%2c35C560.443%2c35%2c568.776%2c35%2c576.443%2c35C584.109%2c35%2c591.109%2c35%2c594.609%2c35L598.109%2c35' id='mermaid-8-L_Deploy_RS_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_Deploy_RS_0' data-points='W3sieCI6NTUyLjEwOTM3NSwieSI6MzV9LHsieCI6NTc3LjEwOTM3NSwieSI6MzV9LHsieCI6NjAyLjEwOTM3NSwieSI6MzV9XQ==' data-look='classic' marker-end='url(%23mermaid-8_flowchart-v2-pointEnd)'/%3e%3cpath d='M739.484%2c35L743.651%2c35C747.818%2c35%2c756.151%2c35%2c765.332%2c38.766C774.514%2c42.533%2c784.543%2c50.065%2c789.557%2c53.832L794.572%2c57.598' id='mermaid-8-L_RS_Pod_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_RS_Pod_0' data-points='W3sieCI6NzM5LjQ4NDM3NSwieSI6MzV9LHsieCI6NzY0LjQ4NDM3NSwieSI6MzV9LHsieCI6Nzk3Ljc3MDEzMjIxMTUzODUsInkiOjYwfV0=' data-look='classic' marker-end='url(%23mermaid-8_flowchart-v2-pointEnd)'/%3e%3cpath d='M877.953%2c87L882.12%2c87C886.286%2c87%2c894.62%2c87%2c902.286%2c87C909.953%2c87%2c916.953%2c87%2c920.453%2c87L923.953%2c87' id='mermaid-8-L_Pod_Scheduler_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_Pod_Scheduler_0' data-points='W3sieCI6ODc3Ljk1MzEyNSwieSI6ODd9LHsieCI6OTAyLjk1MzEyNSwieSI6ODd9LHsieCI6OTI3Ljk1MzEyNSwieSI6ODd9XQ==' data-look='classic' marker-end='url(%23mermaid-8_flowchart-v2-pointEnd)'/%3e%3cpath d='M1060%2c87L1064.167%2c87C1068.333%2c87%2c1076.667%2c87%2c1084.333%2c87C1092%2c87%2c1099%2c87%2c1102.5%2c87L1106%2c87' id='mermaid-8-L_Scheduler_Node_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_Scheduler_Node_0' data-points='W3sieCI6MTA2MCwieSI6ODd9LHsieCI6MTA4NSwieSI6ODd9LHsieCI6MTExMCwieSI6ODd9XQ==' data-look='classic' marker-end='url(%23mermaid-8_flowchart-v2-pointEnd)'/%3e%3cpath d='M1273.188%2c87L1277.354%2c87C1281.521%2c87%2c1289.854%2c87%2c1297.521%2c87C1305.188%2c87%2c1312.188%2c87%2c1315.688%2c87L1319.188%2c87' id='mermaid-8-L_Node_Runtime_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_Node_Runtime_0' data-points='W3sieCI6MTI3My4xODc1LCJ5Ijo4N30seyJ4IjoxMjk4LjE4NzUsInkiOjg3fSx7IngiOjEzMjMuMTg3NSwieSI6ODd9XQ==' data-look='classic' marker-end='url(%23mermaid-8_flowchart-v2-pointEnd)'/%3e%3cpath d='M1516.594%2c87L1520.76%2c87C1524.927%2c87%2c1533.26%2c87%2c1540.927%2c87C1548.594%2c87%2c1555.594%2c87%2c1559.094%2c87L1562.594%2c87' id='mermaid-8-L_Runtime_App_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_Runtime_App_0' data-points='W3sieCI6MTUxNi41OTM3NSwieSI6ODd9LHsieCI6MTU0MS41OTM3NSwieSI6ODd9LHsieCI6MTU2Ni41OTM3NSwieSI6ODd9XQ==' data-look='classic' marker-end='url(%23mermaid-8_flowchart-v2-pointEnd)'/%3e%3cpath d='M338.508%2c139L345.712%2c139C352.917%2c139%2c367.326%2c139%2c380.772%2c139C394.219%2c139%2c406.703%2c139%2c412.945%2c139L419.188%2c139' id='mermaid-8-L_Client_Ingress_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_Client_Ingress_0' data-points='W3sieCI6MzM4LjUwNzgxMjUsInkiOjEzOX0seyJ4IjozODEuNzM0Mzc1LCJ5IjoxMzl9LHsieCI6NDIzLjE4NzUsInkiOjEzOX1d' data-look='classic' marker-end='url(%23mermaid-8_flowchart-v2-pointEnd)'/%3e%3cpath d='M535.656%2c139L542.565%2c139C549.474%2c139%2c563.292%2c139%2c575.702%2c139C588.112%2c139%2c599.115%2c139%2c604.616%2c139L610.117%2c139' id='mermaid-8-L_Ingress_Service_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_Ingress_Service_0' data-points='W3sieCI6NTM1LjY1NjI1LCJ5IjoxMzl9LHsieCI6NTc3LjEwOTM3NSwieSI6MTM5fSx7IngiOjYxNC4xMTcxODc1LCJ5IjoxMzl9XQ==' data-look='classic' marker-end='url(%23mermaid-8_flowchart-v2-pointEnd)'/%3e%3cpath d='M727.477%2c139L733.645%2c139C739.813%2c139%2c752.148%2c139%2c763.331%2c135.234C774.514%2c131.467%2c784.543%2c123.935%2c789.557%2c120.168L794.572%2c116.402' id='mermaid-8-L_Service_Pod_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_Service_Pod_0' data-points='W3sieCI6NzI3LjQ3NjU2MjUsInkiOjEzOX0seyJ4Ijo3NjQuNDg0Mzc1LCJ5IjoxMzl9LHsieCI6Nzk3Ljc3MDEzMjIxMTUzODUsInkiOjExNH1d' data-look='classic' marker-end='url(%23mermaid-8_flowchart-v2-pointEnd)'/%3e%3c/g%3e%3cg class='edgeLabels'%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_Helm_API_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_API_Deploy_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_Deploy_RS_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_RS_Pod_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_Pod_Scheduler_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_Scheduler_Node_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_Node_Runtime_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_Runtime_App_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_Client_Ingress_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_Ingress_Service_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='edgeLabel'%3e%3cg class='label' data-id='L_Service_Pod_0' transform='translate(0%2c 0)'%3e%3cforeignObject width='0' height='0'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cg class='nodes'%3e%3cg class='node default' id='mermaid-8-flowchart-Helm-0' data-look='classic' transform='translate(88.6875%2c 35)'%3e%3crect class='basic label-container' style='' x='-80.6875' y='-27' width='161.375' height='54'/%3e%3cg class='label' style='' transform='translate(-50.6875%2c -12)'%3e%3crect/%3e%3cforeignObject width='101.375' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3ekubectl / Helm%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-8-flowchart-API-1' data-look='classic' transform='translate(288.0546875%2c 35)'%3e%3crect class='basic label-container' style='' x='-68.6796875' y='-27' width='137.359375' height='54'/%3e%3cg class='label' style='' transform='translate(-38.6796875%2c -12)'%3e%3crect/%3e%3cforeignObject width='77.359375' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eAPI Server%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-8-flowchart-Deploy-3' data-look='classic' transform='translate(479.421875%2c 35)'%3e%3crect class='basic label-container' style='' x='-72.6875' y='-27' width='145.375' height='54'/%3e%3cg class='label' style='' transform='translate(-42.6875%2c -12)'%3e%3crect/%3e%3cforeignObject width='85.375' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eDeployment%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-8-flowchart-RS-5' data-look='classic' transform='translate(670.796875%2c 35)'%3e%3crect class='basic label-container' style='' x='-68.6875' y='-27' width='137.375' height='54'/%3e%3cg class='label' style='' transform='translate(-38.6875%2c -12)'%3e%3crect/%3e%3cforeignObject width='77.375' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eReplicaSet%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-8-flowchart-Pod-7' data-look='classic' transform='translate(833.71875%2c 87)'%3e%3crect class='basic label-container' style='' x='-44.234375' y='-27' width='88.46875' height='54'/%3e%3cg class='label' style='' transform='translate(-14.234375%2c -12)'%3e%3crect/%3e%3cforeignObject width='28.46875' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3ePod%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-8-flowchart-Scheduler-9' data-look='classic' transform='translate(993.9765625%2c 87)'%3e%3crect class='basic label-container' style='' x='-66.0234375' y='-27' width='132.046875' height='54'/%3e%3cg class='label' style='' transform='translate(-36.0234375%2c -12)'%3e%3crect/%3e%3cforeignObject width='72.046875' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eScheduler%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-8-flowchart-Node-11' data-look='classic' transform='translate(1191.59375%2c 87)'%3e%3crect class='basic label-container' style='' x='-81.59375' y='-27' width='163.1875' height='54'/%3e%3cg class='label' style='' transform='translate(-51.59375%2c -12)'%3e%3crect/%3e%3cforeignObject width='103.1875' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eNode / kubelet%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-8-flowchart-Runtime-13' data-look='classic' transform='translate(1419.890625%2c 87)'%3e%3crect class='basic label-container' style='' x='-96.703125' y='-27' width='193.40625' height='54'/%3e%3cg class='label' style='' transform='translate(-66.703125%2c -12)'%3e%3crect/%3e%3cforeignObject width='133.40625' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eContainer Runtime%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-8-flowchart-App-15' data-look='classic' transform='translate(1635.734375%2c 87)'%3e%3crect class='basic label-container' style='' x='-69.140625' y='-27' width='138.28125' height='54'/%3e%3cg class='label' style='' transform='translate(-39.140625%2c -12)'%3e%3crect/%3e%3cforeignObject width='78.28125' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eApplication%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-8-flowchart-Client-16' data-look='classic' transform='translate(288.0546875%2c 139)'%3e%3crect class='basic label-container' style='' x='-50.453125' y='-27' width='100.90625' height='54'/%3e%3cg class='label' style='' transform='translate(-20.453125%2c -12)'%3e%3crect/%3e%3cforeignObject width='40.90625' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eClient%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-8-flowchart-Ingress-17' data-look='classic' transform='translate(479.421875%2c 139)'%3e%3crect class='basic label-container' style='' x='-56.234375' y='-27' width='112.46875' height='54'/%3e%3cg class='label' style='' transform='translate(-26.234375%2c -12)'%3e%3crect/%3e%3cforeignObject width='52.46875' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eIngress%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg class='node default' id='mermaid-8-flowchart-Service-19' data-look='classic' transform='translate(670.796875%2c 139)'%3e%3crect class='basic label-container' style='' x='-56.6796875' y='-27' width='113.359375' height='54'/%3e%3cg class='label' style='' transform='translate(-26.6796875%2c -12)'%3e%3crect/%3e%3cforeignObject width='53.359375' height='24'%3e%3cdiv xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'%3e%3cspan class='nodeLabel'%3e%3cp%3eService%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cdefs%3e%3cfilter id='mermaid-8-drop-shadow' height='130%25' width='130%25'%3e%3cfeDropShadow dx='4' dy='4' stdDeviation='0' flood-opacity='0.06' flood-color='black'/%3e%3c/filter%3e%3c/defs%3e%3cdefs%3e%3cfilter id='mermaid-8-drop-shadow-small' height='150%25' width='150%25'%3e%3cfeDropShadow dx='2' dy='2' stdDeviation='0' flood-opacity='0.06' flood-color='black'/%3e%3c/filter%3e%3c/defs%3e%3c/svg%3e)
%3btext-align:center%3b%7d%23mermaid-dark-8%20.edgeLabel%20p%7bbackground-color:hsl(0%2c%200%25%2c%2034.4117647059%25)%3b%7d%23mermaid-dark-8%20.edgeLabel%20rect%7bopacity:0.5%3bbackground-color:hsl(0%2c%200%25%2c%2034.4117647059%25)%3bfill:hsl(0%2c%200%25%2c%2034.4117647059%25)%3b%7d%23mermaid-dark-8%20.labelBkg%7bbackground-color:rgba(87.75%2c%2087.75%2c%2087.75%2c%200.5)%3b%7d%23mermaid-dark-8%20.cluster%20rect%7bfill:hsl(180%2c%201.5873015873%25%2c%2028.3529411765%25)%3bstroke:rgba(255%2c%20255%2c%20255%2c%200.25)%3bstroke-width:1px%3b%7d%23mermaid-dark-8%20.cluster%20text%7bfill:%23F9FFFE%3b%7d%23mermaid-dark-8%20.cluster%20span%7bcolor:%23F9FFFE%3b%7d%23mermaid-dark-8%20.node%20.collapsed-indicator%7bfill:rgba(255%2c%20255%2c%20255%2c%200.25)%3bstroke:none%3bopacity:0.6%3b%7d%23mermaid-dark-8%20.node%20.collapsed-separator%7bstroke:rgba(255%2c%20255%2c%20255%2c%200.25)%3bstroke-width:0.75px%3b%7d%23mermaid-dark-8%20div.mermaidTooltip%7bposition:absolute%3btext-align:center%3bmax-width:200px%3bpadding:2px%3bfont-family:arial%2csans-serif%3bfont-size:12px%3bbackground:hsl(20%2c%201.5873015873%25%2c%2012.3529411765%25)%3bborder:1px%20solid%20rgba(255%2c%20255%2c%20255%2c%200.25)%3bborder-radius:2px%3bpointer-events:none%3bz-index:100%3b%7d%23mermaid-dark-8%20.flowchartTitleText%7btext-anchor:middle%3bfont-size:18px%3bfill:%23ccc%3b%7d%23mermaid-dark-8%20rect.text%7bfill:none%3bstroke-width:0%3b%7d%23mermaid-dark-8%20.icon-shape%2c%23mermaid-dark-8%20.image-shape%7bbackground-color:hsl(0%2c%200%25%2c%2034.4117647059%25)%3btext-align:center%3b%7d%23mermaid-dark-8%20.icon-shape%20p%2c%23mermaid-dark-8%20.image-shape%20p%7bbackground-color:hsl(0%2c%200%25%2c%2034.4117647059%25)%3bpadding:2px%3b%7d%23mermaid-dark-8%20.icon-shape%20.label%20rect%2c%23mermaid-dark-8%20.image-shape%20.label%20rect%7bopacity:0.5%3bbackground-color:hsl(0%2c%200%25%2c%2034.4117647059%25)%3bfill:hsl(0%2c%200%25%2c%2034.4117647059%25)%3b%7d%23mermaid-dark-8%20.label-icon%7bdisplay:inline-block%3bheight:1em%3boverflow:visible%3bvertical-align:-0.125em%3b%7d%23mermaid-dark-8%20.node%20.label-icon%20path%7bfill:currentColor%3bstroke:revert%3bstroke-width:revert%3b%7d%23mermaid-dark-8%20.node%20.neo-node%7bstroke:%23ccc%3b%7d%23mermaid-dark-8%20%5bdata-look='neo'%5d.node%20rect%2c%23mermaid-dark-8%20%5bdata-look='neo'%5d.cluster%20rect%2c%23mermaid-dark-8%20%5bdata-look='neo'%5d.node%20polygon%7bstroke:url(%23mermaid-dark-8-gradient)%3bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-8%20%5bdata-look='neo'%5d.swimlane.cluster%20rect%7bfilter:none%3b%7d%23mermaid-dark-8%20%5bdata-look='neo'%5d.node%20path%7bstroke:url(%23mermaid-dark-8-gradient)%3bstroke-width:1px%3b%7d%23mermaid-dark-8%20%5bdata-look='neo'%5d.node%20.outer-path%7bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-8%20%5bdata-look='neo'%5d.node%20.neo-line%20path%7bstroke:%23ccc%3bfilter:none%3b%7d%23mermaid-dark-8%20%5bdata-look='neo'%5d.node%20circle%7bstroke:url(%23mermaid-dark-8-gradient)%3bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-8%20%5bdata-look='neo'%5d.node%20circle%20.state-start%7bfill:black%3b%7d%23mermaid-dark-8%20%5bdata-look='neo'%5d.icon-shape%20.icon%7bfill:url(%23mermaid-dark-8-gradient)%3bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-8%20%5bdata-look='neo'%5d.icon-shape%20.icon-neo%20path%7bstroke:url(%23mermaid-dark-8-gradient)%3bfilter:drop-shadow(%201px%202px%202px%20rgba(185%2c185%2c185%2c1))%3b%7d%23mermaid-dark-8%20:root%7b--mermaid-font-family:arial%2csans-serif%3b%7d%3c/style%3e%3cg%3e%3cmarker%20id='mermaid-dark-8_flowchart-v2-pointEnd'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='5'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='8'%20markerHeight='8'%20orient='auto'%3e%3cpath%20d='M%200%200%20L%2010%205%20L%200%2010%20z'%20class='arrowMarkerPath'%20style='stroke-width:%201%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-8_flowchart-v2-pointStart'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='4.5'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='8'%20markerHeight='8'%20orient='auto'%3e%3cpath%20d='M%200%205%20L%2010%2010%20L%2010%200%20z'%20class='arrowMarkerPath'%20style='stroke-width:%201%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-8_flowchart-v2-pointEnd-margin'%20class='marker%20flowchart-v2'%20viewBox='0%200%2011.5%2014'%20refX='11.5'%20refY='7'%20markerUnits='userSpaceOnUse'%20markerWidth='10.5'%20markerHeight='14'%20orient='auto'%3e%3cpath%20d='M%200%200%20L%2011.5%207%20L%200%2014%20z'%20class='arrowMarkerPath'%20style='stroke-width:%200%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-8_flowchart-v2-pointStart-margin'%20class='marker%20flowchart-v2'%20viewBox='0%200%2011.5%2014'%20refX='1'%20refY='7'%20markerUnits='userSpaceOnUse'%20markerWidth='11.5'%20markerHeight='14'%20orient='auto'%3e%3cpolygon%20points='0%2c7%2011.5%2c14%2011.5%2c0'%20class='arrowMarkerPath'%20style='stroke-width:%200%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-8_flowchart-v2-circleEnd'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='11'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='11'%20markerHeight='11'%20orient='auto'%3e%3ccircle%20cx='5'%20cy='5'%20r='5'%20class='arrowMarkerPath'%20style='stroke-width:%201%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-8_flowchart-v2-circleStart'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='-1'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='11'%20markerHeight='11'%20orient='auto'%3e%3ccircle%20cx='5'%20cy='5'%20r='5'%20class='arrowMarkerPath'%20style='stroke-width:%201%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-8_flowchart-v2-circleEnd-margin'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refY='5'%20refX='12.25'%20markerUnits='userSpaceOnUse'%20markerWidth='14'%20markerHeight='14'%20orient='auto'%3e%3ccircle%20cx='5'%20cy='5'%20r='5'%20class='arrowMarkerPath'%20style='stroke-width:%200%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-8_flowchart-v2-circleStart-margin'%20class='marker%20flowchart-v2'%20viewBox='0%200%2010%2010'%20refX='-2'%20refY='5'%20markerUnits='userSpaceOnUse'%20markerWidth='14'%20markerHeight='14'%20orient='auto'%3e%3ccircle%20cx='5'%20cy='5'%20r='5'%20class='arrowMarkerPath'%20style='stroke-width:%200%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-8_flowchart-v2-crossEnd'%20class='marker%20cross%20flowchart-v2'%20viewBox='0%200%2011%2011'%20refX='12'%20refY='5.2'%20markerUnits='userSpaceOnUse'%20markerWidth='11'%20markerHeight='11'%20orient='auto'%3e%3cpath%20d='M%201%2c1%20l%209%2c9%20M%2010%2c1%20l%20-9%2c9'%20class='arrowMarkerPath'%20style='stroke-width:%202%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-8_flowchart-v2-crossStart'%20class='marker%20cross%20flowchart-v2'%20viewBox='0%200%2011%2011'%20refX='-1'%20refY='5.2'%20markerUnits='userSpaceOnUse'%20markerWidth='11'%20markerHeight='11'%20orient='auto'%3e%3cpath%20d='M%201%2c1%20l%209%2c9%20M%2010%2c1%20l%20-9%2c9'%20class='arrowMarkerPath'%20style='stroke-width:%202%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-8_flowchart-v2-crossEnd-margin'%20class='marker%20cross%20flowchart-v2'%20viewBox='0%200%2015%2015'%20refX='17.7'%20refY='7.5'%20markerUnits='userSpaceOnUse'%20markerWidth='12'%20markerHeight='12'%20orient='auto'%3e%3cpath%20d='M%201%2c1%20L%2014%2c14%20M%201%2c14%20L%2014%2c1'%20class='arrowMarkerPath'%20style='stroke-width:%202.5%3b'/%3e%3c/marker%3e%3cmarker%20id='mermaid-dark-8_flowchart-v2-crossStart-margin'%20class='marker%20cross%20flowchart-v2'%20viewBox='0%200%2015%2015'%20refX='-3.5'%20refY='7.5'%20markerUnits='userSpaceOnUse'%20markerWidth='12'%20markerHeight='12'%20orient='auto'%3e%3cpath%20d='M%201%2c1%20L%2014%2c14%20M%201%2c14%20L%2014%2c1'%20class='arrowMarkerPath'%20style='stroke-width:%202.5%3b%20stroke-dasharray:%201%2c%200%3b'/%3e%3c/marker%3e%3cg%20class='root'%3e%3cg%20class='clusters'/%3e%3cg%20class='edgePaths'%3e%3cpath%20d='M169.375%2c35L173.542%2c35C177.708%2c35%2c186.042%2c35%2c193.708%2c35C201.375%2c35%2c208.375%2c35%2c211.875%2c35L215.375%2c35'%20id='mermaid-dark-8-L_Helm_API_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_Helm_API_0'%20data-points='W3sieCI6MTY5LjM3NSwieSI6MzV9LHsieCI6MTk0LjM3NSwieSI6MzV9LHsieCI6MjE5LjM3NSwieSI6MzV9XQ=='%20data-look='classic'%20marker-end='url(%23mermaid-dark-8_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M356.734%2c35L360.901%2c35C365.068%2c35%2c373.401%2c35%2c381.068%2c35C388.734%2c35%2c395.734%2c35%2c399.234%2c35L402.734%2c35'%20id='mermaid-dark-8-L_API_Deploy_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_API_Deploy_0'%20data-points='W3sieCI6MzU2LjczNDM3NSwieSI6MzV9LHsieCI6MzgxLjczNDM3NSwieSI6MzV9LHsieCI6NDA2LjczNDM3NSwieSI6MzV9XQ=='%20data-look='classic'%20marker-end='url(%23mermaid-dark-8_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M552.109%2c35L556.276%2c35C560.443%2c35%2c568.776%2c35%2c576.443%2c35C584.109%2c35%2c591.109%2c35%2c594.609%2c35L598.109%2c35'%20id='mermaid-dark-8-L_Deploy_RS_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_Deploy_RS_0'%20data-points='W3sieCI6NTUyLjEwOTM3NSwieSI6MzV9LHsieCI6NTc3LjEwOTM3NSwieSI6MzV9LHsieCI6NjAyLjEwOTM3NSwieSI6MzV9XQ=='%20data-look='classic'%20marker-end='url(%23mermaid-dark-8_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M739.484%2c35L743.651%2c35C747.818%2c35%2c756.151%2c35%2c765.332%2c38.766C774.514%2c42.533%2c784.543%2c50.065%2c789.557%2c53.832L794.572%2c57.598'%20id='mermaid-dark-8-L_RS_Pod_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_RS_Pod_0'%20data-points='W3sieCI6NzM5LjQ4NDM3NSwieSI6MzV9LHsieCI6NzY0LjQ4NDM3NSwieSI6MzV9LHsieCI6Nzk3Ljc3MDEzMjIxMTUzODUsInkiOjYwfV0='%20data-look='classic'%20marker-end='url(%23mermaid-dark-8_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M877.953%2c87L882.12%2c87C886.286%2c87%2c894.62%2c87%2c902.286%2c87C909.953%2c87%2c916.953%2c87%2c920.453%2c87L923.953%2c87'%20id='mermaid-dark-8-L_Pod_Scheduler_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_Pod_Scheduler_0'%20data-points='W3sieCI6ODc3Ljk1MzEyNSwieSI6ODd9LHsieCI6OTAyLjk1MzEyNSwieSI6ODd9LHsieCI6OTI3Ljk1MzEyNSwieSI6ODd9XQ=='%20data-look='classic'%20marker-end='url(%23mermaid-dark-8_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M1060%2c87L1064.167%2c87C1068.333%2c87%2c1076.667%2c87%2c1084.333%2c87C1092%2c87%2c1099%2c87%2c1102.5%2c87L1106%2c87'%20id='mermaid-dark-8-L_Scheduler_Node_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_Scheduler_Node_0'%20data-points='W3sieCI6MTA2MCwieSI6ODd9LHsieCI6MTA4NSwieSI6ODd9LHsieCI6MTExMCwieSI6ODd9XQ=='%20data-look='classic'%20marker-end='url(%23mermaid-dark-8_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M1273.188%2c87L1277.354%2c87C1281.521%2c87%2c1289.854%2c87%2c1297.521%2c87C1305.188%2c87%2c1312.188%2c87%2c1315.688%2c87L1319.188%2c87'%20id='mermaid-dark-8-L_Node_Runtime_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_Node_Runtime_0'%20data-points='W3sieCI6MTI3My4xODc1LCJ5Ijo4N30seyJ4IjoxMjk4LjE4NzUsInkiOjg3fSx7IngiOjEzMjMuMTg3NSwieSI6ODd9XQ=='%20data-look='classic'%20marker-end='url(%23mermaid-dark-8_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M1516.594%2c87L1520.76%2c87C1524.927%2c87%2c1533.26%2c87%2c1540.927%2c87C1548.594%2c87%2c1555.594%2c87%2c1559.094%2c87L1562.594%2c87'%20id='mermaid-dark-8-L_Runtime_App_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_Runtime_App_0'%20data-points='W3sieCI6MTUxNi41OTM3NSwieSI6ODd9LHsieCI6MTU0MS41OTM3NSwieSI6ODd9LHsieCI6MTU2Ni41OTM3NSwieSI6ODd9XQ=='%20data-look='classic'%20marker-end='url(%23mermaid-dark-8_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M338.508%2c139L345.712%2c139C352.917%2c139%2c367.326%2c139%2c380.772%2c139C394.219%2c139%2c406.703%2c139%2c412.945%2c139L419.188%2c139'%20id='mermaid-dark-8-L_Client_Ingress_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_Client_Ingress_0'%20data-points='W3sieCI6MzM4LjUwNzgxMjUsInkiOjEzOX0seyJ4IjozODEuNzM0Mzc1LCJ5IjoxMzl9LHsieCI6NDIzLjE4NzUsInkiOjEzOX1d'%20data-look='classic'%20marker-end='url(%23mermaid-dark-8_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M535.656%2c139L542.565%2c139C549.474%2c139%2c563.292%2c139%2c575.702%2c139C588.112%2c139%2c599.115%2c139%2c604.616%2c139L610.117%2c139'%20id='mermaid-dark-8-L_Ingress_Service_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_Ingress_Service_0'%20data-points='W3sieCI6NTM1LjY1NjI1LCJ5IjoxMzl9LHsieCI6NTc3LjEwOTM3NSwieSI6MTM5fSx7IngiOjYxNC4xMTcxODc1LCJ5IjoxMzl9XQ=='%20data-look='classic'%20marker-end='url(%23mermaid-dark-8_flowchart-v2-pointEnd)'/%3e%3cpath%20d='M727.477%2c139L733.645%2c139C739.813%2c139%2c752.148%2c139%2c763.331%2c135.234C774.514%2c131.467%2c784.543%2c123.935%2c789.557%2c120.168L794.572%2c116.402'%20id='mermaid-dark-8-L_Service_Pod_0'%20class='edge-thickness-normal%20edge-pattern-solid%20edge-thickness-normal%20edge-pattern-solid%20flowchart-link'%20style='%3b'%20data-edge='true'%20data-et='edge'%20data-id='L_Service_Pod_0'%20data-points='W3sieCI6NzI3LjQ3NjU2MjUsInkiOjEzOX0seyJ4Ijo3NjQuNDg0Mzc1LCJ5IjoxMzl9LHsieCI6Nzk3Ljc3MDEzMjIxMTUzODUsInkiOjExNH1d'%20data-look='classic'%20marker-end='url(%23mermaid-dark-8_flowchart-v2-pointEnd)'/%3e%3c/g%3e%3cg%20class='edgeLabels'%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_Helm_API_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_API_Deploy_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_Deploy_RS_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_RS_Pod_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_Pod_Scheduler_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_Scheduler_Node_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_Node_Runtime_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_Runtime_App_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_Client_Ingress_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_Ingress_Service_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='edgeLabel'%3e%3cg%20class='label'%20data-id='L_Service_Pod_0'%20transform='translate(0%2c%200)'%3e%3cforeignObject%20width='0'%20height='0'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20class='labelBkg'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='edgeLabel'%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cg%20class='nodes'%3e%3cg%20class='node%20default'%20id='mermaid-dark-8-flowchart-Helm-0'%20data-look='classic'%20transform='translate(88.6875%2c%2035)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-80.6875'%20y='-27'%20width='161.375'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-50.6875%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='101.375'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3ekubectl%20/%20Helm%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-8-flowchart-API-1'%20data-look='classic'%20transform='translate(288.0546875%2c%2035)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-68.6796875'%20y='-27'%20width='137.359375'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-38.6796875%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='77.359375'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3eAPI%20Server%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-8-flowchart-Deploy-3'%20data-look='classic'%20transform='translate(479.421875%2c%2035)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-72.6875'%20y='-27'%20width='145.375'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-42.6875%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='85.375'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3eDeployment%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-8-flowchart-RS-5'%20data-look='classic'%20transform='translate(670.796875%2c%2035)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-68.6875'%20y='-27'%20width='137.375'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-38.6875%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='77.375'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3eReplicaSet%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-8-flowchart-Pod-7'%20data-look='classic'%20transform='translate(833.71875%2c%2087)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-44.234375'%20y='-27'%20width='88.46875'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-14.234375%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='28.46875'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3ePod%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-8-flowchart-Scheduler-9'%20data-look='classic'%20transform='translate(993.9765625%2c%2087)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-66.0234375'%20y='-27'%20width='132.046875'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-36.0234375%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='72.046875'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3eScheduler%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-8-flowchart-Node-11'%20data-look='classic'%20transform='translate(1191.59375%2c%2087)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-81.59375'%20y='-27'%20width='163.1875'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-51.59375%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='103.1875'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3eNode%20/%20kubelet%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-8-flowchart-Runtime-13'%20data-look='classic'%20transform='translate(1419.890625%2c%2087)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-96.703125'%20y='-27'%20width='193.40625'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-66.703125%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='133.40625'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3eContainer%20Runtime%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-8-flowchart-App-15'%20data-look='classic'%20transform='translate(1635.734375%2c%2087)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-69.140625'%20y='-27'%20width='138.28125'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-39.140625%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='78.28125'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3eApplication%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-8-flowchart-Client-16'%20data-look='classic'%20transform='translate(288.0546875%2c%20139)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-50.453125'%20y='-27'%20width='100.90625'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-20.453125%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='40.90625'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3eClient%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-8-flowchart-Ingress-17'%20data-look='classic'%20transform='translate(479.421875%2c%20139)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-56.234375'%20y='-27'%20width='112.46875'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-26.234375%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='52.46875'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3eIngress%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3cg%20class='node%20default'%20id='mermaid-dark-8-flowchart-Service-19'%20data-look='classic'%20transform='translate(670.796875%2c%20139)'%3e%3crect%20class='basic%20label-container'%20style=''%20x='-56.6796875'%20y='-27'%20width='113.359375'%20height='54'/%3e%3cg%20class='label'%20style=''%20transform='translate(-26.6796875%2c%20-12)'%3e%3crect/%3e%3cforeignObject%20width='53.359375'%20height='24'%3e%3cdiv%20xmlns='http://www.w3.org/1999/xhtml'%20style='display:%20table-cell%3b%20white-space:%20nowrap%3b%20line-height:%201.5%3b%20max-width:%20200px%3b%20text-align:%20center%3b'%3e%3cspan%20class='nodeLabel'%3e%3cp%3eService%3c/p%3e%3c/span%3e%3c/div%3e%3c/foreignObject%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/g%3e%3cdefs%3e%3cfilter%20id='mermaid-dark-8-drop-shadow'%20height='130%25'%20width='130%25'%3e%3cfeDropShadow%20dx='4'%20dy='4'%20stdDeviation='0'%20flood-opacity='0.06'%20flood-color='white'/%3e%3c/filter%3e%3c/defs%3e%3cdefs%3e%3cfilter%20id='mermaid-dark-8-drop-shadow-small'%20height='150%25'%20width='150%25'%3e%3cfeDropShadow%20dx='2'%20dy='2'%20stdDeviation='0'%20flood-opacity='0.06'%20flood-color='white'/%3e%3c/filter%3e%3c/defs%3e%3clinearGradient%20id='mermaid-dark-8-gradient'%20gradientUnits='objectBoundingBox'%20x1='0%25'%20y1='0%25'%20x2='100%25'%20y2='0%25'%3e%3cstop%20offset='0%25'%20stop-color='%23cccccc'%20stop-opacity='1'/%3e%3cstop%20offset='100%25'%20stop-color='hsl(180%2c%200%25%2c%2018.3529411765%25)'%20stop-opacity='1'/%3e%3c/linearGradient%3e%3c/svg%3e)
第一条链描述应用如何被创建和维持,第二条链描述请求如何到达应用。理解两条链 分别经过哪些资源和组件,是排查 Kubernetes 问题最有效的起点。
CCE 是华为云提供的托管 Kubernetes 服务。Pod、Deployment、Service、ConfigMap、 Secret 和 StatefulSet 等仍然是 Kubernetes 标准资源;CCE 主要负责托管控制面, 并集成 VPC、ELB、云存储、监控和集群生命周期能力。正确的学习顺序是先理解标准 资源与控制机制,再理解云平台如何托管和扩展它们。
总结
Kubernetes 不是一个简单的容器启动工具,而是一套围绕声明式资源模型建立的 分布式应用编排与状态协调系统:
Desired State
      ↓
API Resource
      ↓
Controller / Scheduler / kubelet
      ↓
Actual State
      ↓
持续观察与协调
Pod 是最基本的调度与运行单元;Deployment、StatefulSet、DaemonSet 和 Job 管理 不同生命周期的工作负载;Service 与 Ingress 建立稳定访问路径;ConfigMap、Secret 和 Volume 分离配置与状态;Resources、Probes、滚动更新和优雅终止共同决定应用的 运行质量。
真正掌握 Kubernetes,意味着能够从一个资源的 spec 出发,沿着控制器和所有权 关系找到实际 Pod,再沿着 Service、EndpointSlice 与 Ingress 还原请求路径。 当这两条链路清晰之后,大部分部署、流量和故障问题都会拥有明确的排查方向。