

大语言模型最自然的输出形式是文本。例如,让模型分析一条故障日志,它可能返回:
这是一个数据库连接异常,严重程度较高,建议检查连接池和数据库服务状态。如果结果只是展示给人阅读,自然语言通常已经足够。但当模型参与软件系统时,程序更需要一个稳定的数据结构:
{
  "category": "DATABASE",
  "severity": "HIGH",
  "summary": "数据库连接异常"
}
有了明确的数据结构,业务代码才能可靠地继续处理:
if result.severity == Severity.HIGH:
    create_alarm()

if result.category == FaultCategory.DATABASE:
    route_to_database_team()
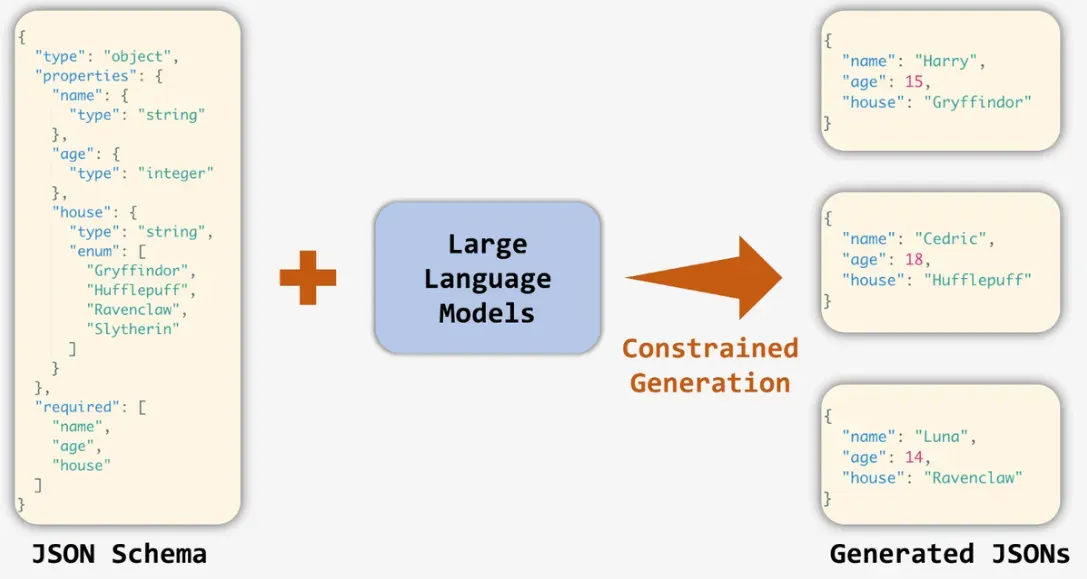
Structured Outputs 和 Schema 约束解决的核心问题是:如何让模型输出不仅能被人看懂,也能被程序稳定地解析、校验和消费。
为什么不能只在 Prompt 中约定 JSON
最简单的做法是在 Prompt 中告诉模型:
请严格按照下面的 JSON 格式返回:

{
  "category": "...",
  "severity": "...",
  "summary": "..."
}
模型大多数时候会生成类似的结果,但“看起来像 JSON”不等于“满足业务契约”。模型可能增加额外字段:
{
  "category": "DATABASE",
  "severity": "HIGH",
  "summary": "数据库连接异常",
  "suggestion": "检查连接池"
}
也可能修改字段名:
{
  "category": "DATABASE",
  "level": "HIGH",
  "summary": "数据库连接异常"
}
甚至返回不符合业务枚举的值:
{
  "category": "DATABASE",
  "severity": "严重",
  "summary": "数据库连接异常"
}
这些结果对人类来说都不难理解,但程序无法稳定处理。Prompt 可以描述格式,却不是类型系统,也不能代替正式的数据契约。
JSON Mode 与 Structured Outputs
JSON Mode 和 Structured Outputs 很容易混淆,但两者解决的问题不同:
| 能力 | JSON Mode | Structured Outputs |
|---|---|---|
| 输出合法 JSON | 是 | 是 |
| 约束字段名称 | 否 | 是 |
| 约束字段类型 | 否 | 是 |
| 约束枚举值 | 否 | 是 |
| 约束必要字段 | 否 | 是 |
| 适合作为严格业务数据 | 一般 | 更适合 |
JSON Mode 主要保证输出能够被当作 JSON 解析;Structured Outputs 进一步要求输出满足指定的 JSON Schema。下游程序需要可靠消费模型结果时,应优先考虑 Structured Outputs。
%3btext-align:center%3b}%23mermaid-0 .edgeLabel p{background-color:rgba(232%2c232%2c232%2c 0.8)%3b}%23mermaid-0 .edgeLabel rect{opacity:0.5%3bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bfill:rgba(232%2c232%2c232%2c 0.8)%3b}%23mermaid-0 .labelBkg{background-color:rgba(232%2c 232%2c 232%2c 0.5)%3b}%23mermaid-0 .cluster rect{fill:%23ffffde%3bstroke:%23aaaa33%3bstroke-width:1px%3b}%23mermaid-0 .cluster text{fill:%23333%3b}%23mermaid-0 .cluster span{color:%23333%3b}%23mermaid-0 .node .collapsed-indicator{fill:%23aaaa33%3bstroke:none%3bopacity:0.6%3b}%23mermaid-0 .node .collapsed-separator{stroke:%23aaaa33%3bstroke-width:0.75px%3b}%23mermaid-0 div.mermaidTooltip{position:absolute%3btext-align:center%3bmax-width:200px%3bpadding:2px%3bfont-family:arial%2csans-serif%3bfont-size:12px%3bbackground:hsl(80%2c 100%%2c 96.2745098039%)%3bborder:1px solid %23aaaa33%3bborder-radius:2px%3bpointer-events:none%3bz-index:100%3b}%23mermaid-0 .flowchartTitleText{text-anchor:middle%3bfont-size:18px%3bfill:%23333%3b}%23mermaid-0 rect.text{fill:none%3bstroke-width:0%3b}%23mermaid-0 .icon-shape%2c%23mermaid-0 .image-shape{background-color:rgba(232%2c232%2c232%2c 0.8)%3btext-align:center%3b}%23mermaid-0 .icon-shape p%2c%23mermaid-0 .image-shape p{background-color:rgba(232%2c232%2c232%2c 0.8)%3bpadding:2px%3b}%23mermaid-0 .icon-shape .label rect%2c%23mermaid-0 .image-shape .label rect{opacity:0.5%3bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bfill:rgba(232%2c232%2c232%2c 0.8)%3b}%23mermaid-0 .label-icon{display:inline-block%3bheight:1em%3boverflow:visible%3bvertical-align:-0.125em%3b}%23mermaid-0 .node .label-icon path{fill:currentColor%3bstroke:revert%3bstroke-width:revert%3b}%23mermaid-0 .node .neo-node{stroke:%239370DB%3b}%23mermaid-0 [data-look='neo'].node rect%2c%23mermaid-0 [data-look='neo'].cluster rect%2c%23mermaid-0 [data-look='neo'].node polygon{stroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b}%23mermaid-0 [data-look='neo'].swimlane.cluster rect{filter:none%3b}%23mermaid-0 [data-look='neo'].node path{stroke:%239370DB%3bstroke-width:1px%3b}%23mermaid-0 [data-look='neo'].node .outer-path{filter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b}%23mermaid-0 [data-look='neo'].node .neo-line path{stroke:%239370DB%3bfilter:none%3b}%23mermaid-0 [data-look='neo'].node circle{stroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b}%23mermaid-0 [data-look='neo'].node circle .state-start{fill:black%3b}%23mermaid-0 [data-look='neo'].icon-shape .icon{fill:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b}%23mermaid-0 [data-look='neo'].icon-shape .icon-neo path{stroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b}%23mermaid-0 :root{--mermaid-font-family:arial%2csans-serif%3b}</style><g><marker id='mermaid-0_flowchart-v2-pointEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'><path d='M 0 0 L 10 5 L 0 10 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-0_flowchart-v2-pointStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='4.5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'><path d='M 0 5 L 10 10 L 10 0 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-0_flowchart-v2-pointEnd-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='11.5' refY='7' markerUnits='userSpaceOnUse' markerWidth='10.5' markerHeight='14' orient='auto'><path d='M 0 0 L 11.5 7 L 0 14 z' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-0_flowchart-v2-pointStart-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='1' refY='7' markerUnits='userSpaceOnUse' markerWidth='11.5' markerHeight='14' orient='auto'><polygon points='0%2c7 11.5%2c14 11.5%2c0' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-0_flowchart-v2-circleEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='11' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-0_flowchart-v2-circleStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-1' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-0_flowchart-v2-circleEnd-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refY='5' refX='12.25' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-0_flowchart-v2-circleStart-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-2' refY='5' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-0_flowchart-v2-crossEnd' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='12' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><path d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-0_flowchart-v2-crossStart' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='-1' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><path d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-0_flowchart-v2-crossEnd-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='17.7' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'><path d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b'/></marker><marker id='mermaid-0_flowchart-v2-crossStart-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='-3.5' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'><path d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b stroke-dasharray: 1%2c 0%3b'/></marker><g class='root'><g class='clusters'/><g class='edgePaths'><path d='M116%2c139L120.167%2c139C124.333%2c139%2c132.667%2c139%2c140.333%2c139C148%2c139%2c155%2c139%2c158.5%2c139L162%2c139' id='mermaid-0-L_A_B_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_A_B_0' data-points='W3sieCI6MTE2LCJ5IjoxMzl9LHsieCI6MTQxLCJ5IjoxMzl9LHsieCI6MTY2LCJ5IjoxMzl9XQ==' data-look='classic' marker-end='url(%23mermaid-0_flowchart-v2-pointEnd)'/><path d='M250%2c139L254.167%2c139C258.333%2c139%2c266.667%2c139%2c274.333%2c139C282%2c139%2c289%2c139%2c292.5%2c139L296%2c139' id='mermaid-0-L_B_C_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_B_C_0' data-points='W3sieCI6MjUwLCJ5IjoxMzl9LHsieCI6Mjc1LCJ5IjoxMzl9LHsieCI6MzAwLCJ5IjoxMzl9XQ==' data-look='classic' marker-end='url(%23mermaid-0_flowchart-v2-pointEnd)'/><path d='M380.539%2c117.539L399.474%2c103.783C418.409%2c90.026%2c456.279%2c62.513%2c498.464%2c48.757C540.648%2c35%2c587.148%2c35%2c610.398%2c35L633.648%2c35' id='mermaid-0-L_C_D_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_C_D_0' data-points='W3sieCI6MzgwLjUzOTIxMjg5NzEwNzYzLCJ5IjoxMTcuNTM5MjEyODk3MTA3NjN9LHsieCI6NDk0LjE0ODQzNzUsInkiOjM1fSx7IngiOjYzNy42NDg0Mzc1LCJ5IjozNX1d' data-look='classic' marker-end='url(%23mermaid-0_flowchart-v2-pointEnd)'/><path d='M402%2c139L417.358%2c139C432.716%2c139%2c463.432%2c139%2c500.113%2c139C536.794%2c139%2c579.44%2c139%2c600.763%2c139L622.086%2c139' id='mermaid-0-L_C_E_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_C_E_0' data-points='W3sieCI6NDAyLCJ5IjoxMzl9LHsieCI6NDk0LjE0ODQzNzUsInkiOjEzOX0seyJ4Ijo2MjYuMDg1OTM3NSwieSI6MTM5fV0=' data-look='classic' marker-end='url(%23mermaid-0_flowchart-v2-pointEnd)'/><path d='M380.539%2c160.461L399.474%2c174.217C418.409%2c187.974%2c456.279%2c215.487%2c489.905%2c229.243C523.531%2c243%2c552.914%2c243%2c567.605%2c243L582.297%2c243' id='mermaid-0-L_C_F_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_C_F_0' data-points='W3sieCI6MzgwLjUzOTIxMjg5NzEwNzYzLCJ5IjoxNjAuNDYwNzg3MTAyODkyMzd9LHsieCI6NDk0LjE0ODQzNzUsInkiOjI0M30seyJ4Ijo1ODYuMjk2ODc1LCJ5IjoyNDN9XQ==' data-look='classic' marker-end='url(%23mermaid-0_flowchart-v2-pointEnd)'/><path d='M797%2c243L801.167%2c243C805.333%2c243%2c813.667%2c243%2c821.333%2c243C829%2c243%2c836%2c243%2c839.5%2c243L843%2c243' id='mermaid-0-L_F_G_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_F_G_0' data-points='W3sieCI6Nzk3LCJ5IjoyNDN9LHsieCI6ODIyLCJ5IjoyNDN9LHsieCI6ODQ3LCJ5IjoyNDN9XQ==' data-look='classic' marker-end='url(%23mermaid-0_flowchart-v2-pointEnd)'/><path d='M955%2c243L959.167%2c243C963.333%2c243%2c971.667%2c243%2c979.333%2c243C987%2c243%2c994%2c243%2c997.5%2c243L1001%2c243' id='mermaid-0-L_G_H_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_G_H_0' data-points='W3sieCI6OTU1LCJ5IjoyNDN9LHsieCI6OTgwLCJ5IjoyNDN9LHsieCI6MTAwNSwieSI6MjQzfV0=' data-look='classic' marker-end='url(%23mermaid-0_flowchart-v2-pointEnd)'/></g><g class='edgeLabels'><g class='edgeLabel'><g class='label' data-id='L_A_B_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_B_C_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel' transform='translate(494.1484375%2c 35)'><g class='label' data-id='L_C_D_0' transform='translate(-24%2c -12)'><foreignObject width='48' height='24'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'><p>普通文本</p></span></div></foreignObject></g></g><g class='edgeLabel' transform='translate(494.1484375%2c 139)'><g class='label' data-id='L_C_E_0' transform='translate(-43.5703125%2c -12)'><foreignObject width='87.140625' height='24'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'><p>JSON Mode</p></span></div></foreignObject></g></g><g class='edgeLabel' transform='translate(494.1484375%2c 243)'><g class='label' data-id='L_C_F_0' transform='translate(-67.1484375%2c -12)'><foreignObject width='134.296875' height='24'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'><p>Structured Outputs</p></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_F_G_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_G_H_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g></g><g class='nodes'><g class='node default' id='mermaid-0-flowchart-A-0' data-look='classic' transform='translate(62%2c 139)'><rect class='basic label-container' style='' x='-54' y='-27' width='108' height='54'/><g class='label' style='' transform='translate(-24%2c -12)'><rect/><foreignObject width='48' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>用户输入</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-0-flowchart-B-1' data-look='classic' transform='translate(208%2c 139)'><rect class='basic label-container' style='' x='-42' y='-27' width='84' height='54'/><g class='label' style='' transform='translate(-12%2c -12)'><rect/><foreignObject width='24' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>模型</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-0-flowchart-C-3' data-look='classic' transform='translate(351%2c 139)'><polygon points='51%2c0 102%2c-51 51%2c-102 0%2c-51' class='label-container' transform='translate(-50.5%2c 51)'/><g class='label' style='' transform='translate(-24%2c -12)'><rect/><foreignObject width='48' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>输出方式</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-0-flowchart-D-5' data-look='classic' transform='translate(691.6484375%2c 35)'><rect class='basic label-container' style='' x='-54' y='-27' width='108' height='54'/><g class='label' style='' transform='translate(-24%2c -12)'><rect/><foreignObject width='48' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>自然语言</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-0-flowchart-E-7' data-look='classic' transform='translate(691.6484375%2c 139)'><rect class='basic label-container' style='' x='-65.5625' y='-27' width='131.125' height='54'/><g class='label' style='' transform='translate(-35.5625%2c -12)'><rect/><foreignObject width='71.125' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>合法 JSON</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-0-flowchart-F-9' data-look='classic' transform='translate(691.6484375%2c 243)'><rect class='basic label-container' style='' x='-105.3515625' y='-27' width='210.703125' height='54'/><g class='label' style='' transform='translate(-75.3515625%2c -12)'><rect/><foreignObject width='150.703125' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>符合 Schema 的 JSON</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-0-flowchart-G-11' data-look='classic' transform='translate(901%2c 243)'><rect class='basic label-container' style='' x='-54' y='-27' width='108' height='54'/><g class='label' style='' transform='translate(-24%2c -12)'><rect/><foreignObject width='48' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>类型对象</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-0-flowchart-H-13' data-look='classic' transform='translate(1059%2c 243)'><rect class='basic label-container' style='' x='-54' y='-27' width='108' height='54'/><g class='label' style='' transform='translate(-24%2c -12)'><rect/><foreignObject width='48' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>业务代码</p></span></div></foreignObject></g></g></g></g></g><defs><filter id='mermaid-0-drop-shadow' height='130%' width='130%'><feDropShadow dx='4' dy='4' stdDeviation='0' flood-opacity='0.06' flood-color='black'/></filter></defs><defs><filter id='mermaid-0-drop-shadow-small' height='150%' width='150%'><feDropShadow dx='2' dy='2' stdDeviation='0' flood-opacity='0.06' flood-color='black'/></filter></defs></svg>)
%3btext-align:center%3b}%23mermaid-dark-0 .edgeLabel p{background-color:hsl(0%2c 0%%2c 34.4117647059%)%3b}%23mermaid-dark-0 .edgeLabel rect{opacity:0.5%3bbackground-color:hsl(0%2c 0%%2c 34.4117647059%)%3bfill:hsl(0%2c 0%%2c 34.4117647059%)%3b}%23mermaid-dark-0 .labelBkg{background-color:rgba(87.75%2c 87.75%2c 87.75%2c 0.5)%3b}%23mermaid-dark-0 .cluster rect{fill:hsl(180%2c 1.5873015873%%2c 28.3529411765%)%3bstroke:rgba(255%2c 255%2c 255%2c 0.25)%3bstroke-width:1px%3b}%23mermaid-dark-0 .cluster text{fill:%23F9FFFE%3b}%23mermaid-dark-0 .cluster span{color:%23F9FFFE%3b}%23mermaid-dark-0 .node .collapsed-indicator{fill:rgba(255%2c 255%2c 255%2c 0.25)%3bstroke:none%3bopacity:0.6%3b}%23mermaid-dark-0 .node .collapsed-separator{stroke:rgba(255%2c 255%2c 255%2c 0.25)%3bstroke-width:0.75px%3b}%23mermaid-dark-0 div.mermaidTooltip{position:absolute%3btext-align:center%3bmax-width:200px%3bpadding:2px%3bfont-family:arial%2csans-serif%3bfont-size:12px%3bbackground:hsl(20%2c 1.5873015873%%2c 12.3529411765%)%3bborder:1px solid rgba(255%2c 255%2c 255%2c 0.25)%3bborder-radius:2px%3bpointer-events:none%3bz-index:100%3b}%23mermaid-dark-0 .flowchartTitleText{text-anchor:middle%3bfont-size:18px%3bfill:%23ccc%3b}%23mermaid-dark-0 rect.text{fill:none%3bstroke-width:0%3b}%23mermaid-dark-0 .icon-shape%2c%23mermaid-dark-0 .image-shape{background-color:hsl(0%2c 0%%2c 34.4117647059%)%3btext-align:center%3b}%23mermaid-dark-0 .icon-shape p%2c%23mermaid-dark-0 .image-shape p{background-color:hsl(0%2c 0%%2c 34.4117647059%)%3bpadding:2px%3b}%23mermaid-dark-0 .icon-shape .label rect%2c%23mermaid-dark-0 .image-shape .label rect{opacity:0.5%3bbackground-color:hsl(0%2c 0%%2c 34.4117647059%)%3bfill:hsl(0%2c 0%%2c 34.4117647059%)%3b}%23mermaid-dark-0 .label-icon{display:inline-block%3bheight:1em%3boverflow:visible%3bvertical-align:-0.125em%3b}%23mermaid-dark-0 .node .label-icon path{fill:currentColor%3bstroke:revert%3bstroke-width:revert%3b}%23mermaid-dark-0 .node .neo-node{stroke:%23ccc%3b}%23mermaid-dark-0 [data-look='neo'].node rect%2c%23mermaid-dark-0 [data-look='neo'].cluster rect%2c%23mermaid-dark-0 [data-look='neo'].node polygon{stroke:url(%23mermaid-dark-0-gradient)%3bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b}%23mermaid-dark-0 [data-look='neo'].swimlane.cluster rect{filter:none%3b}%23mermaid-dark-0 [data-look='neo'].node path{stroke:url(%23mermaid-dark-0-gradient)%3bstroke-width:1px%3b}%23mermaid-dark-0 [data-look='neo'].node .outer-path{filter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b}%23mermaid-dark-0 [data-look='neo'].node .neo-line path{stroke:%23ccc%3bfilter:none%3b}%23mermaid-dark-0 [data-look='neo'].node circle{stroke:url(%23mermaid-dark-0-gradient)%3bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b}%23mermaid-dark-0 [data-look='neo'].node circle .state-start{fill:black%3b}%23mermaid-dark-0 [data-look='neo'].icon-shape .icon{fill:url(%23mermaid-dark-0-gradient)%3bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b}%23mermaid-dark-0 [data-look='neo'].icon-shape .icon-neo path{stroke:url(%23mermaid-dark-0-gradient)%3bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b}%23mermaid-dark-0 :root{--mermaid-font-family:arial%2csans-serif%3b}</style><g><marker id='mermaid-dark-0_flowchart-v2-pointEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'><path d='M 0 0 L 10 5 L 0 10 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-0_flowchart-v2-pointStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='4.5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'><path d='M 0 5 L 10 10 L 10 0 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-0_flowchart-v2-pointEnd-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='11.5' refY='7' markerUnits='userSpaceOnUse' markerWidth='10.5' markerHeight='14' orient='auto'><path d='M 0 0 L 11.5 7 L 0 14 z' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-0_flowchart-v2-pointStart-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='1' refY='7' markerUnits='userSpaceOnUse' markerWidth='11.5' markerHeight='14' orient='auto'><polygon points='0%2c7 11.5%2c14 11.5%2c0' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-0_flowchart-v2-circleEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='11' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-0_flowchart-v2-circleStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-1' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-0_flowchart-v2-circleEnd-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refY='5' refX='12.25' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-0_flowchart-v2-circleStart-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-2' refY='5' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-0_flowchart-v2-crossEnd' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='12' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><path d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-0_flowchart-v2-crossStart' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='-1' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><path d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-0_flowchart-v2-crossEnd-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='17.7' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'><path d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b'/></marker><marker id='mermaid-dark-0_flowchart-v2-crossStart-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='-3.5' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'><path d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b stroke-dasharray: 1%2c 0%3b'/></marker><g class='root'><g class='clusters'/><g class='edgePaths'><path d='M116%2c139L120.167%2c139C124.333%2c139%2c132.667%2c139%2c140.333%2c139C148%2c139%2c155%2c139%2c158.5%2c139L162%2c139' id='mermaid-dark-0-L_A_B_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_A_B_0' data-points='W3sieCI6MTE2LCJ5IjoxMzl9LHsieCI6MTQxLCJ5IjoxMzl9LHsieCI6MTY2LCJ5IjoxMzl9XQ==' data-look='classic' marker-end='url(%23mermaid-dark-0_flowchart-v2-pointEnd)'/><path d='M250%2c139L254.167%2c139C258.333%2c139%2c266.667%2c139%2c274.333%2c139C282%2c139%2c289%2c139%2c292.5%2c139L296%2c139' id='mermaid-dark-0-L_B_C_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_B_C_0' data-points='W3sieCI6MjUwLCJ5IjoxMzl9LHsieCI6Mjc1LCJ5IjoxMzl9LHsieCI6MzAwLCJ5IjoxMzl9XQ==' data-look='classic' marker-end='url(%23mermaid-dark-0_flowchart-v2-pointEnd)'/><path d='M380.539%2c117.539L399.474%2c103.783C418.409%2c90.026%2c456.279%2c62.513%2c498.464%2c48.757C540.648%2c35%2c587.148%2c35%2c610.398%2c35L633.648%2c35' id='mermaid-dark-0-L_C_D_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_C_D_0' data-points='W3sieCI6MzgwLjUzOTIxMjg5NzEwNzYzLCJ5IjoxMTcuNTM5MjEyODk3MTA3NjN9LHsieCI6NDk0LjE0ODQzNzUsInkiOjM1fSx7IngiOjYzNy42NDg0Mzc1LCJ5IjozNX1d' data-look='classic' marker-end='url(%23mermaid-dark-0_flowchart-v2-pointEnd)'/><path d='M402%2c139L417.358%2c139C432.716%2c139%2c463.432%2c139%2c500.113%2c139C536.794%2c139%2c579.44%2c139%2c600.763%2c139L622.086%2c139' id='mermaid-dark-0-L_C_E_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_C_E_0' data-points='W3sieCI6NDAyLCJ5IjoxMzl9LHsieCI6NDk0LjE0ODQzNzUsInkiOjEzOX0seyJ4Ijo2MjYuMDg1OTM3NSwieSI6MTM5fV0=' data-look='classic' marker-end='url(%23mermaid-dark-0_flowchart-v2-pointEnd)'/><path d='M380.539%2c160.461L399.474%2c174.217C418.409%2c187.974%2c456.279%2c215.487%2c489.905%2c229.243C523.531%2c243%2c552.914%2c243%2c567.605%2c243L582.297%2c243' id='mermaid-dark-0-L_C_F_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_C_F_0' data-points='W3sieCI6MzgwLjUzOTIxMjg5NzEwNzYzLCJ5IjoxNjAuNDYwNzg3MTAyODkyMzd9LHsieCI6NDk0LjE0ODQzNzUsInkiOjI0M30seyJ4Ijo1ODYuMjk2ODc1LCJ5IjoyNDN9XQ==' data-look='classic' marker-end='url(%23mermaid-dark-0_flowchart-v2-pointEnd)'/><path d='M797%2c243L801.167%2c243C805.333%2c243%2c813.667%2c243%2c821.333%2c243C829%2c243%2c836%2c243%2c839.5%2c243L843%2c243' id='mermaid-dark-0-L_F_G_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_F_G_0' data-points='W3sieCI6Nzk3LCJ5IjoyNDN9LHsieCI6ODIyLCJ5IjoyNDN9LHsieCI6ODQ3LCJ5IjoyNDN9XQ==' data-look='classic' marker-end='url(%23mermaid-dark-0_flowchart-v2-pointEnd)'/><path d='M955%2c243L959.167%2c243C963.333%2c243%2c971.667%2c243%2c979.333%2c243C987%2c243%2c994%2c243%2c997.5%2c243L1001%2c243' id='mermaid-dark-0-L_G_H_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_G_H_0' data-points='W3sieCI6OTU1LCJ5IjoyNDN9LHsieCI6OTgwLCJ5IjoyNDN9LHsieCI6MTAwNSwieSI6MjQzfV0=' data-look='classic' marker-end='url(%23mermaid-dark-0_flowchart-v2-pointEnd)'/></g><g class='edgeLabels'><g class='edgeLabel'><g class='label' data-id='L_A_B_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_B_C_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel' transform='translate(494.1484375%2c 35)'><g class='label' data-id='L_C_D_0' transform='translate(-24%2c -12)'><foreignObject width='48' height='24'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'><p>普通文本</p></span></div></foreignObject></g></g><g class='edgeLabel' transform='translate(494.1484375%2c 139)'><g class='label' data-id='L_C_E_0' transform='translate(-43.5703125%2c -12)'><foreignObject width='87.140625' height='24'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'><p>JSON Mode</p></span></div></foreignObject></g></g><g class='edgeLabel' transform='translate(494.1484375%2c 243)'><g class='label' data-id='L_C_F_0' transform='translate(-67.1484375%2c -12)'><foreignObject width='134.296875' height='24'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'><p>Structured Outputs</p></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_F_G_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_G_H_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g></g><g class='nodes'><g class='node default' id='mermaid-dark-0-flowchart-A-0' data-look='classic' transform='translate(62%2c 139)'><rect class='basic label-container' style='' x='-54' y='-27' width='108' height='54'/><g class='label' style='' transform='translate(-24%2c -12)'><rect/><foreignObject width='48' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>用户输入</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-dark-0-flowchart-B-1' data-look='classic' transform='translate(208%2c 139)'><rect class='basic label-container' style='' x='-42' y='-27' width='84' height='54'/><g class='label' style='' transform='translate(-12%2c -12)'><rect/><foreignObject width='24' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>模型</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-dark-0-flowchart-C-3' data-look='classic' transform='translate(351%2c 139)'><polygon points='51%2c0 102%2c-51 51%2c-102 0%2c-51' class='label-container' transform='translate(-50.5%2c 51)'/><g class='label' style='' transform='translate(-24%2c -12)'><rect/><foreignObject width='48' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>输出方式</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-dark-0-flowchart-D-5' data-look='classic' transform='translate(691.6484375%2c 35)'><rect class='basic label-container' style='' x='-54' y='-27' width='108' height='54'/><g class='label' style='' transform='translate(-24%2c -12)'><rect/><foreignObject width='48' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>自然语言</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-dark-0-flowchart-E-7' data-look='classic' transform='translate(691.6484375%2c 139)'><rect class='basic label-container' style='' x='-65.5625' y='-27' width='131.125' height='54'/><g class='label' style='' transform='translate(-35.5625%2c -12)'><rect/><foreignObject width='71.125' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>合法 JSON</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-dark-0-flowchart-F-9' data-look='classic' transform='translate(691.6484375%2c 243)'><rect class='basic label-container' style='' x='-105.3515625' y='-27' width='210.703125' height='54'/><g class='label' style='' transform='translate(-75.3515625%2c -12)'><rect/><foreignObject width='150.703125' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>符合 Schema 的 JSON</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-dark-0-flowchart-G-11' data-look='classic' transform='translate(901%2c 243)'><rect class='basic label-container' style='' x='-54' y='-27' width='108' height='54'/><g class='label' style='' transform='translate(-24%2c -12)'><rect/><foreignObject width='48' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>类型对象</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-dark-0-flowchart-H-13' data-look='classic' transform='translate(1059%2c 243)'><rect class='basic label-container' style='' x='-54' y='-27' width='108' height='54'/><g class='label' style='' transform='translate(-24%2c -12)'><rect/><foreignObject width='48' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>业务代码</p></span></div></foreignObject></g></g></g></g></g><defs><filter id='mermaid-dark-0-drop-shadow' height='130%' width='130%'><feDropShadow dx='4' dy='4' stdDeviation='0' flood-opacity='0.06' flood-color='white'/></filter></defs><defs><filter id='mermaid-dark-0-drop-shadow-small' height='150%' width='150%'><feDropShadow dx='2' dy='2' stdDeviation='0' flood-opacity='0.06' flood-color='white'/></filter></defs><linearGradient id='mermaid-dark-0-gradient' gradientUnits='objectBoundingBox' x1='0%' y1='0%' x2='100%' y2='0%'><stop offset='0%' stop-color='%23cccccc' stop-opacity='1'/><stop offset='100%' stop-color='hsl(180%2c 0%%2c 18.3529411765%)' stop-opacity='1'/></linearGradient></svg>)
用 Schema 定义数据契约
Schema 是描述数据结构的正式规则。下面这个 Schema 定义了故障类别、严重程度和摘要:
{
  "type": "object",
  "properties": {
    "category": {
      "type": "string",
      "enum": ["DATABASE", "NETWORK", "APPLICATION", "UNKNOWN"]
    },
    "severity": {
      "type": "string",
      "enum": ["LOW", "MEDIUM", "HIGH"]
    },
    "summary": {
      "type": "string"
    }
  },
  "required": ["category", "severity", "summary"],
  "additionalProperties": false
}
它表达了几条明确规则:
- 最外层必须是对象;
- 三个字段都必须存在;
category和severity只能从指定枚举中选择;summary必须是字符串;- 不允许出现未定义字段。
OpenAI Structured Outputs 支持 JSON Schema 的一个子集,包括常见的字符串、数字、整数、布尔值、对象、数组、枚举和 anyOf 等结构。设计 Schema 时应以官方当前支持范围为准。
使用 Pydantic 定义模型
Python 项目通常不需要手工维护大段 JSON Schema。Pydantic 可以同时承担 Python 类型定义和 Schema 生成两项工作:
pip install openai pydanticfrom enum import Enum
from pydantic import BaseModel
class FaultCategory(str, Enum):
DATABASE = "DATABASE"
NETWORK = "NETWORK"
APPLICATION = "APPLICATION"
UNKNOWN = "UNKNOWN"
class Severity(str, Enum):
LOW = "LOW"
MEDIUM = "MEDIUM"
HIGH = "HIGH"
class FaultAnalysis(BaseModel):
category: FaultCategory
severity: Severity
summary: strFaultAnalysis 是一个普通业务数据模型,同时也能生成对应的 JSON Schema:
print(FaultAnalysis.model_json_schema())这样可以避免分别维护 Python DTO 和 JSON Schema,减少两套定义逐渐不一致的问题。
优先使用明确的类型
下面这种定义虽然属于结构化输出,但约束很弱:
class Result(BaseModel):
    result: dict
模型仍然可以在 result 中生成任意结构。更好的 Schema 应尽可能表达业务语义:
class FaultAnalysis(BaseModel):
    category: FaultCategory
    severity: Severity
    summary: str
设计时可以遵循几个原则:
- 有限集合优先使用 Enum,不要使用不受约束的字符串;
- 字段名称应表达业务含义,避免
type、value、data这类模糊名称; - 一个字段只承担一种语义;
- 不要为了“通用”而大量使用
dict和动态 Map; - 避免过深嵌套和不必要的 Union;
- 将 Schema 当作接口协议,尽量保持稳定。
嵌套对象和数组
Structured Outputs 也适合代码审查、信息抽取等复杂结果:
from enum import Enum

from pydantic import BaseModel


class RiskLevel(str, Enum):
    LOW = "LOW"
    MEDIUM = "MEDIUM"
    HIGH = "HIGH"


class CodeIssue(BaseModel):
    line: int
    problem: str
    suggestion: str
    risk: RiskLevel


class CodeReviewResult(BaseModel):
    summary: str
    issues: list[CodeIssue]
前端或后续服务可以直接遍历 result.issues,而不需要从一段自然语言中重新提取问题列表。
信息抽取场景也可以把数组作为对象字段:
class Task(BaseModel):
    title: str
    owner: str
    deadline: str


class MeetingResult(BaseModel):
    tasks: list[Task]
可空字段与额外字段
如果字段业务上可以没有值,通常应让字段存在但允许为 null:
class UserInfo(BaseModel):
    name: str
    email: str | None
对应结果是:
{
  "name": "Alice",
  "email": null
}
这比直接省略字段更稳定,因为下游程序始终知道 email 字段存在,只是值可能为空。
对象 Schema 还应禁止随意添加字段:
"additionalProperties": false如果业务需要新增 root_cause 或 suggestion,应当显式升级 Schema,而不是允许模型自由扩展。
使用 Responses API 获取类型对象
OpenAI Python SDK 可以通过 client.responses.parse() 接收 Pydantic 模型,并将符合 Schema 的结果解析为 Python 对象。
from enum import Enum

from openai import OpenAI
from pydantic import BaseModel


class FaultCategory(str, Enum):
    DATABASE = "DATABASE"
    NETWORK = "NETWORK"
    APPLICATION = "APPLICATION"
    UNKNOWN = "UNKNOWN"


class Severity(str, Enum):
    LOW = "LOW"
    MEDIUM = "MEDIUM"
    HIGH = "HIGH"


class FaultAnalysis(BaseModel):
    category: FaultCategory
    severity: Severity
    summary: str


client = OpenAI()

response = client.responses.parse(
    model="gpt-5.4",
    instructions="""
    你是系统故障分析组件。
    根据日志判断故障类别和严重程度。
    """,
    input="""
    java.sql.SQLTransientConnectionException:
    HikariPool-1 - Connection is not available,
    request timed out after 30000ms.
    """,
    text_format=FaultAnalysis,
)

result = response.output_parsed

if result is None:
    raise RuntimeError("模型没有返回可解析的结构化结果")

print(result.category)
print(result.severity)
print(result.summary)
可能得到:
FaultCategory.DATABASE
Severity.HIGH
数据库连接池无法获取可用连接,请求在 30 秒后超时。
output_text 与 output_parsed
普通文本调用经常读取:
response.output_text它表示模型输出的文本,本质上仍然是字符串。Structured Outputs 更应关注:
response.output_parsed它表示 SDK 已经按照 text_format 完成解析的 Python 对象。使用 output_parsed 可以保留 Pydantic 的类型校验,也能让业务代码更清晰。
%3btext-align:center%3b}%23mermaid-1 .edgeLabel p{background-color:rgba(232%2c232%2c232%2c 0.8)%3b}%23mermaid-1 .edgeLabel rect{opacity:0.5%3bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bfill:rgba(232%2c232%2c232%2c 0.8)%3b}%23mermaid-1 .labelBkg{background-color:rgba(232%2c 232%2c 232%2c 0.5)%3b}%23mermaid-1 .cluster rect{fill:%23ffffde%3bstroke:%23aaaa33%3bstroke-width:1px%3b}%23mermaid-1 .cluster text{fill:%23333%3b}%23mermaid-1 .cluster span{color:%23333%3b}%23mermaid-1 .node .collapsed-indicator{fill:%23aaaa33%3bstroke:none%3bopacity:0.6%3b}%23mermaid-1 .node .collapsed-separator{stroke:%23aaaa33%3bstroke-width:0.75px%3b}%23mermaid-1 div.mermaidTooltip{position:absolute%3btext-align:center%3bmax-width:200px%3bpadding:2px%3bfont-family:arial%2csans-serif%3bfont-size:12px%3bbackground:hsl(80%2c 100%%2c 96.2745098039%)%3bborder:1px solid %23aaaa33%3bborder-radius:2px%3bpointer-events:none%3bz-index:100%3b}%23mermaid-1 .flowchartTitleText{text-anchor:middle%3bfont-size:18px%3bfill:%23333%3b}%23mermaid-1 rect.text{fill:none%3bstroke-width:0%3b}%23mermaid-1 .icon-shape%2c%23mermaid-1 .image-shape{background-color:rgba(232%2c232%2c232%2c 0.8)%3btext-align:center%3b}%23mermaid-1 .icon-shape p%2c%23mermaid-1 .image-shape p{background-color:rgba(232%2c232%2c232%2c 0.8)%3bpadding:2px%3b}%23mermaid-1 .icon-shape .label rect%2c%23mermaid-1 .image-shape .label rect{opacity:0.5%3bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bfill:rgba(232%2c232%2c232%2c 0.8)%3b}%23mermaid-1 .label-icon{display:inline-block%3bheight:1em%3boverflow:visible%3bvertical-align:-0.125em%3b}%23mermaid-1 .node .label-icon path{fill:currentColor%3bstroke:revert%3bstroke-width:revert%3b}%23mermaid-1 .node .neo-node{stroke:%239370DB%3b}%23mermaid-1 [data-look='neo'].node rect%2c%23mermaid-1 [data-look='neo'].cluster rect%2c%23mermaid-1 [data-look='neo'].node polygon{stroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b}%23mermaid-1 [data-look='neo'].swimlane.cluster rect{filter:none%3b}%23mermaid-1 [data-look='neo'].node path{stroke:%239370DB%3bstroke-width:1px%3b}%23mermaid-1 [data-look='neo'].node .outer-path{filter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b}%23mermaid-1 [data-look='neo'].node .neo-line path{stroke:%239370DB%3bfilter:none%3b}%23mermaid-1 [data-look='neo'].node circle{stroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b}%23mermaid-1 [data-look='neo'].node circle .state-start{fill:black%3b}%23mermaid-1 [data-look='neo'].icon-shape .icon{fill:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b}%23mermaid-1 [data-look='neo'].icon-shape .icon-neo path{stroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b}%23mermaid-1 :root{--mermaid-font-family:arial%2csans-serif%3b}</style><g><marker id='mermaid-1_flowchart-v2-pointEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'><path d='M 0 0 L 10 5 L 0 10 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-1_flowchart-v2-pointStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='4.5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'><path d='M 0 5 L 10 10 L 10 0 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-1_flowchart-v2-pointEnd-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='11.5' refY='7' markerUnits='userSpaceOnUse' markerWidth='10.5' markerHeight='14' orient='auto'><path d='M 0 0 L 11.5 7 L 0 14 z' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-1_flowchart-v2-pointStart-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='1' refY='7' markerUnits='userSpaceOnUse' markerWidth='11.5' markerHeight='14' orient='auto'><polygon points='0%2c7 11.5%2c14 11.5%2c0' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-1_flowchart-v2-circleEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='11' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-1_flowchart-v2-circleStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-1' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-1_flowchart-v2-circleEnd-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refY='5' refX='12.25' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-1_flowchart-v2-circleStart-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-2' refY='5' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-1_flowchart-v2-crossEnd' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='12' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><path d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-1_flowchart-v2-crossStart' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='-1' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><path d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-1_flowchart-v2-crossEnd-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='17.7' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'><path d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b'/></marker><marker id='mermaid-1_flowchart-v2-crossStart-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='-3.5' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'><path d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b stroke-dasharray: 1%2c 0%3b'/></marker><g class='root'><g class='clusters'/><g class='edgePaths'><path d='M177.391%2c35L183.557%2c35C189.724%2c35%2c202.057%2c35%2c213.724%2c35C225.391%2c35%2c236.391%2c35%2c241.891%2c35L247.391%2c35' id='mermaid-1-L_A_B_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_A_B_0' data-points='W3sieCI6MTc3LjM5MDYyNSwieSI6MzV9LHsieCI6MjE0LjM5MDYyNSwieSI6MzV9LHsieCI6MjUxLjM5MDYyNSwieSI6MzV9XQ==' data-look='classic' marker-end='url(%23mermaid-1_flowchart-v2-pointEnd)'/><path d='M417.203%2c35L421.37%2c35C425.536%2c35%2c433.87%2c35%2c446.224%2c38.881C458.579%2c42.762%2c474.955%2c50.524%2c483.143%2c54.406L491.331%2c58.287' id='mermaid-1-L_B_C_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_B_C_0' data-points='W3sieCI6NDE3LjIwMzEyNSwieSI6MzV9LHsieCI6NDQyLjIwMzEyNSwieSI6MzV9LHsieCI6NDk0Ljk0NTAxMjAxOTIzMDgsInkiOjYwfV0=' data-look='classic' marker-end='url(%23mermaid-1_flowchart-v2-pointEnd)'/><path d='M388.297%2c139L397.281%2c139C406.266%2c139%2c424.234%2c139%2c441.407%2c135.119C458.579%2c131.238%2c474.955%2c123.476%2c483.143%2c119.594L491.331%2c115.713' id='mermaid-1-L_D_C_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_D_C_0' data-points='W3sieCI6Mzg4LjI5Njg3NSwieSI6MTM5fSx7IngiOjQ0Mi4yMDMxMjUsInkiOjEzOX0seyJ4Ijo0OTQuOTQ1MDEyMDE5MjMwOCwieSI6MTE0fV0=' data-look='classic' marker-end='url(%23mermaid-1_flowchart-v2-pointEnd)'/><path d='M636.609%2c87L640.776%2c87C644.943%2c87%2c653.276%2c87%2c660.943%2c87C668.609%2c87%2c675.609%2c87%2c679.109%2c87L682.609%2c87' id='mermaid-1-L_C_E_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_C_E_0' data-points='W3sieCI6NjM2LjYwOTM3NSwieSI6ODd9LHsieCI6NjYxLjYwOTM3NSwieSI6ODd9LHsieCI6Njg2LjYwOTM3NSwieSI6ODd9XQ==' data-look='classic' marker-end='url(%23mermaid-1_flowchart-v2-pointEnd)'/><path d='M897.313%2c87L906.591%2c87C915.87%2c87%2c934.427%2c87%2c952.318%2c87C970.208%2c87%2c987.432%2c87%2c996.044%2c87L1004.656%2c87' id='mermaid-1-L_E_F_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_E_F_0' data-points='W3sieCI6ODk3LjMxMjUsInkiOjg3fSx7IngiOjk1Mi45ODQzNzUsInkiOjg3fSx7IngiOjEwMDguNjU2MjUsInkiOjg3fV0=' data-look='classic' marker-end='url(%23mermaid-1_flowchart-v2-pointEnd)'/><path d='M1170.969%2c87L1175.135%2c87C1179.302%2c87%2c1187.635%2c87%2c1195.302%2c87C1202.969%2c87%2c1209.969%2c87%2c1213.469%2c87L1216.969%2c87' id='mermaid-1-L_F_G_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_F_G_0' data-points='W3sieCI6MTE3MC45Njg3NSwieSI6ODd9LHsieCI6MTE5NS45Njg3NSwieSI6ODd9LHsieCI6MTIyMC45Njg3NSwieSI6ODd9XQ==' data-look='classic' marker-end='url(%23mermaid-1_flowchart-v2-pointEnd)'/></g><g class='edgeLabels'><g class='edgeLabel' transform='translate(214.390625%2c 35)'><g class='label' data-id='L_A_B_0' transform='translate(-12%2c -12)'><foreignObject width='24' height='24'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'><p>生成</p></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_B_C_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_D_C_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_C_E_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel' transform='translate(952.984375%2c 87)'><g class='label' data-id='L_E_F_0' transform='translate(-30.671875%2c -12)'><foreignObject width='61.34375' height='24'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'><p>SDK 解析</p></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_F_G_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g></g><g class='nodes'><g class='node default' id='mermaid-1-flowchart-A-0' data-look='classic' transform='translate(92.6953125%2c 35)'><rect class='basic label-container' style='' x='-84.6953125' y='-27' width='169.390625' height='54'/><g class='label' style='' transform='translate(-54.6953125%2c -12)'><rect/><foreignObject width='109.390625' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>Pydantic Model</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-1-flowchart-B-1' data-look='classic' transform='translate(334.296875%2c 35)'><rect class='basic label-container' style='' x='-82.90625' y='-27' width='165.8125' height='54'/><g class='label' style='' transform='translate(-52.90625%2c -12)'><rect/><foreignObject width='105.8125' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>JSON Schema</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-1-flowchart-C-3' data-look='classic' transform='translate(551.90625%2c 87)'><rect class='basic label-container' style='' x='-84.703125' y='-27' width='169.40625' height='54'/><g class='label' style='' transform='translate(-54.703125%2c -12)'><rect/><foreignObject width='109.40625' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>Responses API</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-1-flowchart-D-4' data-look='classic' transform='translate(334.296875%2c 139)'><rect class='basic label-container' style='' x='-54' y='-27' width='108' height='54'/><g class='label' style='' transform='translate(-24%2c -12)'><rect/><foreignObject width='48' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>用户输入</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-1-flowchart-E-7' data-look='classic' transform='translate(791.9609375%2c 87)'><rect class='basic label-container' style='' x='-105.3515625' y='-27' width='210.703125' height='54'/><g class='label' style='' transform='translate(-75.3515625%2c -12)'><rect/><foreignObject width='150.703125' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>符合 Schema 的 JSON</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-1-flowchart-F-9' data-look='classic' transform='translate(1089.8125%2c 87)'><rect class='basic label-container' style='' x='-81.15625' y='-27' width='162.3125' height='54'/><g class='label' style='' transform='translate(-51.15625%2c -12)'><rect/><foreignObject width='102.3125' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>output_parsed</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-1-flowchart-G-11' data-look='classic' transform='translate(1302.1015625%2c 87)'><rect class='basic label-container' style='' x='-81.1328125' y='-27' width='162.265625' height='54'/><g class='label' style='' transform='translate(-51.1328125%2c -12)'><rect/><foreignObject width='102.265625' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>Python 类型对象</p></span></div></foreignObject></g></g></g></g></g><defs><filter id='mermaid-1-drop-shadow' height='130%' width='130%'><feDropShadow dx='4' dy='4' stdDeviation='0' flood-opacity='0.06' flood-color='black'/></filter></defs><defs><filter id='mermaid-1-drop-shadow-small' height='150%' width='150%'><feDropShadow dx='2' dy='2' stdDeviation='0' flood-opacity='0.06' flood-color='black'/></filter></defs></svg>)
%3btext-align:center%3b}%23mermaid-dark-1 .edgeLabel p{background-color:hsl(0%2c 0%%2c 34.4117647059%)%3b}%23mermaid-dark-1 .edgeLabel rect{opacity:0.5%3bbackground-color:hsl(0%2c 0%%2c 34.4117647059%)%3bfill:hsl(0%2c 0%%2c 34.4117647059%)%3b}%23mermaid-dark-1 .labelBkg{background-color:rgba(87.75%2c 87.75%2c 87.75%2c 0.5)%3b}%23mermaid-dark-1 .cluster rect{fill:hsl(180%2c 1.5873015873%%2c 28.3529411765%)%3bstroke:rgba(255%2c 255%2c 255%2c 0.25)%3bstroke-width:1px%3b}%23mermaid-dark-1 .cluster text{fill:%23F9FFFE%3b}%23mermaid-dark-1 .cluster span{color:%23F9FFFE%3b}%23mermaid-dark-1 .node .collapsed-indicator{fill:rgba(255%2c 255%2c 255%2c 0.25)%3bstroke:none%3bopacity:0.6%3b}%23mermaid-dark-1 .node .collapsed-separator{stroke:rgba(255%2c 255%2c 255%2c 0.25)%3bstroke-width:0.75px%3b}%23mermaid-dark-1 div.mermaidTooltip{position:absolute%3btext-align:center%3bmax-width:200px%3bpadding:2px%3bfont-family:arial%2csans-serif%3bfont-size:12px%3bbackground:hsl(20%2c 1.5873015873%%2c 12.3529411765%)%3bborder:1px solid rgba(255%2c 255%2c 255%2c 0.25)%3bborder-radius:2px%3bpointer-events:none%3bz-index:100%3b}%23mermaid-dark-1 .flowchartTitleText{text-anchor:middle%3bfont-size:18px%3bfill:%23ccc%3b}%23mermaid-dark-1 rect.text{fill:none%3bstroke-width:0%3b}%23mermaid-dark-1 .icon-shape%2c%23mermaid-dark-1 .image-shape{background-color:hsl(0%2c 0%%2c 34.4117647059%)%3btext-align:center%3b}%23mermaid-dark-1 .icon-shape p%2c%23mermaid-dark-1 .image-shape p{background-color:hsl(0%2c 0%%2c 34.4117647059%)%3bpadding:2px%3b}%23mermaid-dark-1 .icon-shape .label rect%2c%23mermaid-dark-1 .image-shape .label rect{opacity:0.5%3bbackground-color:hsl(0%2c 0%%2c 34.4117647059%)%3bfill:hsl(0%2c 0%%2c 34.4117647059%)%3b}%23mermaid-dark-1 .label-icon{display:inline-block%3bheight:1em%3boverflow:visible%3bvertical-align:-0.125em%3b}%23mermaid-dark-1 .node .label-icon path{fill:currentColor%3bstroke:revert%3bstroke-width:revert%3b}%23mermaid-dark-1 .node .neo-node{stroke:%23ccc%3b}%23mermaid-dark-1 [data-look='neo'].node rect%2c%23mermaid-dark-1 [data-look='neo'].cluster rect%2c%23mermaid-dark-1 [data-look='neo'].node polygon{stroke:url(%23mermaid-dark-1-gradient)%3bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b}%23mermaid-dark-1 [data-look='neo'].swimlane.cluster rect{filter:none%3b}%23mermaid-dark-1 [data-look='neo'].node path{stroke:url(%23mermaid-dark-1-gradient)%3bstroke-width:1px%3b}%23mermaid-dark-1 [data-look='neo'].node .outer-path{filter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b}%23mermaid-dark-1 [data-look='neo'].node .neo-line path{stroke:%23ccc%3bfilter:none%3b}%23mermaid-dark-1 [data-look='neo'].node circle{stroke:url(%23mermaid-dark-1-gradient)%3bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b}%23mermaid-dark-1 [data-look='neo'].node circle .state-start{fill:black%3b}%23mermaid-dark-1 [data-look='neo'].icon-shape .icon{fill:url(%23mermaid-dark-1-gradient)%3bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b}%23mermaid-dark-1 [data-look='neo'].icon-shape .icon-neo path{stroke:url(%23mermaid-dark-1-gradient)%3bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b}%23mermaid-dark-1 :root{--mermaid-font-family:arial%2csans-serif%3b}</style><g><marker id='mermaid-dark-1_flowchart-v2-pointEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'><path d='M 0 0 L 10 5 L 0 10 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-1_flowchart-v2-pointStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='4.5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'><path d='M 0 5 L 10 10 L 10 0 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-1_flowchart-v2-pointEnd-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='11.5' refY='7' markerUnits='userSpaceOnUse' markerWidth='10.5' markerHeight='14' orient='auto'><path d='M 0 0 L 11.5 7 L 0 14 z' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-1_flowchart-v2-pointStart-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='1' refY='7' markerUnits='userSpaceOnUse' markerWidth='11.5' markerHeight='14' orient='auto'><polygon points='0%2c7 11.5%2c14 11.5%2c0' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-1_flowchart-v2-circleEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='11' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-1_flowchart-v2-circleStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-1' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-1_flowchart-v2-circleEnd-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refY='5' refX='12.25' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-1_flowchart-v2-circleStart-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-2' refY='5' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-1_flowchart-v2-crossEnd' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='12' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><path d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-1_flowchart-v2-crossStart' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='-1' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><path d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-1_flowchart-v2-crossEnd-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='17.7' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'><path d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b'/></marker><marker id='mermaid-dark-1_flowchart-v2-crossStart-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='-3.5' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'><path d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b stroke-dasharray: 1%2c 0%3b'/></marker><g class='root'><g class='clusters'/><g class='edgePaths'><path d='M177.391%2c35L183.557%2c35C189.724%2c35%2c202.057%2c35%2c213.724%2c35C225.391%2c35%2c236.391%2c35%2c241.891%2c35L247.391%2c35' id='mermaid-dark-1-L_A_B_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_A_B_0' data-points='W3sieCI6MTc3LjM5MDYyNSwieSI6MzV9LHsieCI6MjE0LjM5MDYyNSwieSI6MzV9LHsieCI6MjUxLjM5MDYyNSwieSI6MzV9XQ==' data-look='classic' marker-end='url(%23mermaid-dark-1_flowchart-v2-pointEnd)'/><path d='M417.203%2c35L421.37%2c35C425.536%2c35%2c433.87%2c35%2c446.224%2c38.881C458.579%2c42.762%2c474.955%2c50.524%2c483.143%2c54.406L491.331%2c58.287' id='mermaid-dark-1-L_B_C_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_B_C_0' data-points='W3sieCI6NDE3LjIwMzEyNSwieSI6MzV9LHsieCI6NDQyLjIwMzEyNSwieSI6MzV9LHsieCI6NDk0Ljk0NTAxMjAxOTIzMDgsInkiOjYwfV0=' data-look='classic' marker-end='url(%23mermaid-dark-1_flowchart-v2-pointEnd)'/><path d='M388.297%2c139L397.281%2c139C406.266%2c139%2c424.234%2c139%2c441.407%2c135.119C458.579%2c131.238%2c474.955%2c123.476%2c483.143%2c119.594L491.331%2c115.713' id='mermaid-dark-1-L_D_C_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_D_C_0' data-points='W3sieCI6Mzg4LjI5Njg3NSwieSI6MTM5fSx7IngiOjQ0Mi4yMDMxMjUsInkiOjEzOX0seyJ4Ijo0OTQuOTQ1MDEyMDE5MjMwOCwieSI6MTE0fV0=' data-look='classic' marker-end='url(%23mermaid-dark-1_flowchart-v2-pointEnd)'/><path d='M636.609%2c87L640.776%2c87C644.943%2c87%2c653.276%2c87%2c660.943%2c87C668.609%2c87%2c675.609%2c87%2c679.109%2c87L682.609%2c87' id='mermaid-dark-1-L_C_E_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_C_E_0' data-points='W3sieCI6NjM2LjYwOTM3NSwieSI6ODd9LHsieCI6NjYxLjYwOTM3NSwieSI6ODd9LHsieCI6Njg2LjYwOTM3NSwieSI6ODd9XQ==' data-look='classic' marker-end='url(%23mermaid-dark-1_flowchart-v2-pointEnd)'/><path d='M897.313%2c87L906.591%2c87C915.87%2c87%2c934.427%2c87%2c952.318%2c87C970.208%2c87%2c987.432%2c87%2c996.044%2c87L1004.656%2c87' id='mermaid-dark-1-L_E_F_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_E_F_0' data-points='W3sieCI6ODk3LjMxMjUsInkiOjg3fSx7IngiOjk1Mi45ODQzNzUsInkiOjg3fSx7IngiOjEwMDguNjU2MjUsInkiOjg3fV0=' data-look='classic' marker-end='url(%23mermaid-dark-1_flowchart-v2-pointEnd)'/><path d='M1170.969%2c87L1175.135%2c87C1179.302%2c87%2c1187.635%2c87%2c1195.302%2c87C1202.969%2c87%2c1209.969%2c87%2c1213.469%2c87L1216.969%2c87' id='mermaid-dark-1-L_F_G_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_F_G_0' data-points='W3sieCI6MTE3MC45Njg3NSwieSI6ODd9LHsieCI6MTE5NS45Njg3NSwieSI6ODd9LHsieCI6MTIyMC45Njg3NSwieSI6ODd9XQ==' data-look='classic' marker-end='url(%23mermaid-dark-1_flowchart-v2-pointEnd)'/></g><g class='edgeLabels'><g class='edgeLabel' transform='translate(214.390625%2c 35)'><g class='label' data-id='L_A_B_0' transform='translate(-12%2c -12)'><foreignObject width='24' height='24'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'><p>生成</p></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_B_C_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_D_C_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_C_E_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel' transform='translate(952.984375%2c 87)'><g class='label' data-id='L_E_F_0' transform='translate(-30.671875%2c -12)'><foreignObject width='61.34375' height='24'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'><p>SDK 解析</p></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_F_G_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g></g><g class='nodes'><g class='node default' id='mermaid-dark-1-flowchart-A-0' data-look='classic' transform='translate(92.6953125%2c 35)'><rect class='basic label-container' style='' x='-84.6953125' y='-27' width='169.390625' height='54'/><g class='label' style='' transform='translate(-54.6953125%2c -12)'><rect/><foreignObject width='109.390625' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>Pydantic Model</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-dark-1-flowchart-B-1' data-look='classic' transform='translate(334.296875%2c 35)'><rect class='basic label-container' style='' x='-82.90625' y='-27' width='165.8125' height='54'/><g class='label' style='' transform='translate(-52.90625%2c -12)'><rect/><foreignObject width='105.8125' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>JSON Schema</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-dark-1-flowchart-C-3' data-look='classic' transform='translate(551.90625%2c 87)'><rect class='basic label-container' style='' x='-84.703125' y='-27' width='169.40625' height='54'/><g class='label' style='' transform='translate(-54.703125%2c -12)'><rect/><foreignObject width='109.40625' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>Responses API</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-dark-1-flowchart-D-4' data-look='classic' transform='translate(334.296875%2c 139)'><rect class='basic label-container' style='' x='-54' y='-27' width='108' height='54'/><g class='label' style='' transform='translate(-24%2c -12)'><rect/><foreignObject width='48' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>用户输入</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-dark-1-flowchart-E-7' data-look='classic' transform='translate(791.9609375%2c 87)'><rect class='basic label-container' style='' x='-105.3515625' y='-27' width='210.703125' height='54'/><g class='label' style='' transform='translate(-75.3515625%2c -12)'><rect/><foreignObject width='150.703125' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>符合 Schema 的 JSON</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-dark-1-flowchart-F-9' data-look='classic' transform='translate(1089.8125%2c 87)'><rect class='basic label-container' style='' x='-81.15625' y='-27' width='162.3125' height='54'/><g class='label' style='' transform='translate(-51.15625%2c -12)'><rect/><foreignObject width='102.3125' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>output_parsed</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-dark-1-flowchart-G-11' data-look='classic' transform='translate(1302.1015625%2c 87)'><rect class='basic label-container' style='' x='-81.1328125' y='-27' width='162.265625' height='54'/><g class='label' style='' transform='translate(-51.1328125%2c -12)'><rect/><foreignObject width='102.265625' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>Python 类型对象</p></span></div></foreignObject></g></g></g></g></g><defs><filter id='mermaid-dark-1-drop-shadow' height='130%' width='130%'><feDropShadow dx='4' dy='4' stdDeviation='0' flood-opacity='0.06' flood-color='white'/></filter></defs><defs><filter id='mermaid-dark-1-drop-shadow-small' height='150%' width='150%'><feDropShadow dx='2' dy='2' stdDeviation='0' flood-opacity='0.06' flood-color='white'/></filter></defs><linearGradient id='mermaid-dark-1-gradient' gradientUnits='objectBoundingBox' x1='0%' y1='0%' x2='100%' y2='0%'><stop offset='0%' stop-color='%23cccccc' stop-opacity='1'/><stop offset='100%' stop-color='hsl(180%2c 0%%2c 18.3529411765%)' stop-opacity='1'/></linearGradient></svg>)
直接使用 JSON Schema
不使用 Pydantic 时,也可以直接向 Responses API 提供原始 JSON Schema:
from openai import OpenAI

client = OpenAI()

response = client.responses.create(
    model="gpt-5.4",
    input="分析日志:数据库连接池已耗尽。",
    text={
        "format": {
            "type": "json_schema",
            "name": "fault_analysis",
            "strict": True,
            "schema": {
                "type": "object",
                "properties": {
                    "category": {
                        "type": "string",
                        "enum": [
                            "DATABASE",
                            "NETWORK",
                            "APPLICATION",
                            "UNKNOWN",
                        ],
                    },
                    "severity": {
                        "type": "string",
                        "enum": ["LOW", "MEDIUM", "HIGH"],
                    },
                    "summary": {
                        "type": "string",
                    },
                },
                "required": ["category", "severity", "summary"],
                "additionalProperties": False,
            },
        }
    },
)

print(response.output_text)
这种方式更接近底层 API 协议,也适用于不使用 Pydantic 的语言或项目。Python 项目通常优先选择 Pydantic,以保持类型定义和模型输出契约一致。
Schema 只能保证结构正确
Structured Outputs 可以保证下面的数据符合 Schema:
{
  "category": "NETWORK",
  "severity": "HIGH",
  "summary": "数据库连接失败"
}
但它不能保证 NETWORK 是正确分类。这个结果结构完全合法,业务判断却可能有误。
因此系统需要区分不同层次的约束:
| 约束层 | 负责的问题 |
|---|---|
| Instructions | 告诉模型如何理解和判断 |
| Schema | 保证字段、类型和枚举合法 |
| Business Validation | 判断内容是否符合业务规则 |
| Permission | 决定是否允许执行操作 |
Schema 决定“怎么输出”,Instructions 决定“怎么判断”。两者不能互相替代。
%3btext-align:center%3b}%23mermaid-2 .edgeLabel p{background-color:rgba(232%2c232%2c232%2c 0.8)%3b}%23mermaid-2 .edgeLabel rect{opacity:0.5%3bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bfill:rgba(232%2c232%2c232%2c 0.8)%3b}%23mermaid-2 .labelBkg{background-color:rgba(232%2c 232%2c 232%2c 0.5)%3b}%23mermaid-2 .cluster rect{fill:%23ffffde%3bstroke:%23aaaa33%3bstroke-width:1px%3b}%23mermaid-2 .cluster text{fill:%23333%3b}%23mermaid-2 .cluster span{color:%23333%3b}%23mermaid-2 .node .collapsed-indicator{fill:%23aaaa33%3bstroke:none%3bopacity:0.6%3b}%23mermaid-2 .node .collapsed-separator{stroke:%23aaaa33%3bstroke-width:0.75px%3b}%23mermaid-2 div.mermaidTooltip{position:absolute%3btext-align:center%3bmax-width:200px%3bpadding:2px%3bfont-family:arial%2csans-serif%3bfont-size:12px%3bbackground:hsl(80%2c 100%%2c 96.2745098039%)%3bborder:1px solid %23aaaa33%3bborder-radius:2px%3bpointer-events:none%3bz-index:100%3b}%23mermaid-2 .flowchartTitleText{text-anchor:middle%3bfont-size:18px%3bfill:%23333%3b}%23mermaid-2 rect.text{fill:none%3bstroke-width:0%3b}%23mermaid-2 .icon-shape%2c%23mermaid-2 .image-shape{background-color:rgba(232%2c232%2c232%2c 0.8)%3btext-align:center%3b}%23mermaid-2 .icon-shape p%2c%23mermaid-2 .image-shape p{background-color:rgba(232%2c232%2c232%2c 0.8)%3bpadding:2px%3b}%23mermaid-2 .icon-shape .label rect%2c%23mermaid-2 .image-shape .label rect{opacity:0.5%3bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bfill:rgba(232%2c232%2c232%2c 0.8)%3b}%23mermaid-2 .label-icon{display:inline-block%3bheight:1em%3boverflow:visible%3bvertical-align:-0.125em%3b}%23mermaid-2 .node .label-icon path{fill:currentColor%3bstroke:revert%3bstroke-width:revert%3b}%23mermaid-2 .node .neo-node{stroke:%239370DB%3b}%23mermaid-2 [data-look='neo'].node rect%2c%23mermaid-2 [data-look='neo'].cluster rect%2c%23mermaid-2 [data-look='neo'].node polygon{stroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b}%23mermaid-2 [data-look='neo'].swimlane.cluster rect{filter:none%3b}%23mermaid-2 [data-look='neo'].node path{stroke:%239370DB%3bstroke-width:1px%3b}%23mermaid-2 [data-look='neo'].node .outer-path{filter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b}%23mermaid-2 [data-look='neo'].node .neo-line path{stroke:%239370DB%3bfilter:none%3b}%23mermaid-2 [data-look='neo'].node circle{stroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b}%23mermaid-2 [data-look='neo'].node circle .state-start{fill:black%3b}%23mermaid-2 [data-look='neo'].icon-shape .icon{fill:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b}%23mermaid-2 [data-look='neo'].icon-shape .icon-neo path{stroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b}%23mermaid-2 :root{--mermaid-font-family:arial%2csans-serif%3b}</style><g><marker id='mermaid-2_flowchart-v2-pointEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'><path d='M 0 0 L 10 5 L 0 10 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-2_flowchart-v2-pointStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='4.5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'><path d='M 0 5 L 10 10 L 10 0 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-2_flowchart-v2-pointEnd-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='11.5' refY='7' markerUnits='userSpaceOnUse' markerWidth='10.5' markerHeight='14' orient='auto'><path d='M 0 0 L 11.5 7 L 0 14 z' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-2_flowchart-v2-pointStart-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='1' refY='7' markerUnits='userSpaceOnUse' markerWidth='11.5' markerHeight='14' orient='auto'><polygon points='0%2c7 11.5%2c14 11.5%2c0' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-2_flowchart-v2-circleEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='11' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-2_flowchart-v2-circleStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-1' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-2_flowchart-v2-circleEnd-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refY='5' refX='12.25' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-2_flowchart-v2-circleStart-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-2' refY='5' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-2_flowchart-v2-crossEnd' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='12' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><path d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-2_flowchart-v2-crossStart' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='-1' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><path d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-2_flowchart-v2-crossEnd-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='17.7' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'><path d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b'/></marker><marker id='mermaid-2_flowchart-v2-crossStart-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='-3.5' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'><path d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b stroke-dasharray: 1%2c 0%3b'/></marker><g class='root'><g class='clusters'/><g class='edgePaths'><path d='M116%2c35L120.167%2c35C124.333%2c35%2c132.667%2c35%2c140.333%2c35C148%2c35%2c155%2c35%2c158.5%2c35L162%2c35' id='mermaid-2-L_A_B_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_A_B_0' data-points='W3sieCI6MTE2LCJ5IjozNX0seyJ4IjoxNDEsInkiOjM1fSx7IngiOjE2NiwieSI6MzV9XQ==' data-look='classic' marker-end='url(%23mermaid-2_flowchart-v2-pointEnd)'/><path d='M360.266%2c35L364.432%2c35C368.599%2c35%2c376.932%2c35%2c384.599%2c35C392.266%2c35%2c399.266%2c35%2c402.766%2c35L406.266%2c35' id='mermaid-2-L_B_C_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_B_C_0' data-points='W3sieCI6MzYwLjI2NTYyNSwieSI6MzV9LHsieCI6Mzg1LjI2NTYyNSwieSI6MzV9LHsieCI6NDEwLjI2NTYyNSwieSI6MzV9XQ==' data-look='classic' marker-end='url(%23mermaid-2_flowchart-v2-pointEnd)'/><path d='M581.406%2c35L585.573%2c35C589.74%2c35%2c598.073%2c35%2c605.74%2c35C613.406%2c35%2c620.406%2c35%2c623.906%2c35L627.406%2c35' id='mermaid-2-L_C_D_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_C_D_0' data-points='W3sieCI6NTgxLjQwNjI1LCJ5IjozNX0seyJ4Ijo2MDYuNDA2MjUsInkiOjM1fSx7IngiOjYzMS40MDYyNSwieSI6MzV9XQ==' data-look='classic' marker-end='url(%23mermaid-2_flowchart-v2-pointEnd)'/><path d='M829.859%2c35L834.026%2c35C838.193%2c35%2c846.526%2c35%2c854.193%2c35C861.859%2c35%2c868.859%2c35%2c872.359%2c35L875.859%2c35' id='mermaid-2-L_D_E_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_D_E_0' data-points='W3sieCI6ODI5Ljg1OTM3NSwieSI6MzV9LHsieCI6ODU0Ljg1OTM3NSwieSI6MzV9LHsieCI6ODc5Ljg1OTM3NSwieSI6MzV9XQ==' data-look='classic' marker-end='url(%23mermaid-2_flowchart-v2-pointEnd)'/><path d='M987.859%2c35L992.026%2c35C996.193%2c35%2c1004.526%2c35%2c1012.193%2c35C1019.859%2c35%2c1026.859%2c35%2c1030.359%2c35L1033.859%2c35' id='mermaid-2-L_E_F_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_E_F_0' data-points='W3sieCI6OTg3Ljg1OTM3NSwieSI6MzV9LHsieCI6MTAxMi44NTkzNzUsInkiOjM1fSx7IngiOjEwMzcuODU5Mzc1LCJ5IjozNX1d' data-look='classic' marker-end='url(%23mermaid-2_flowchart-v2-pointEnd)'/></g><g class='edgeLabels'><g class='edgeLabel'><g class='label' data-id='L_A_B_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_B_C_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_C_D_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_D_E_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_E_F_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g></g><g class='nodes'><g class='node default' id='mermaid-2-flowchart-A-0' data-look='classic' transform='translate(62%2c 35)'><rect class='basic label-container' style='' x='-54' y='-27' width='108' height='54'/><g class='label' style='' transform='translate(-24%2c -12)'><rect/><foreignObject width='48' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>模型输入</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-2-flowchart-B-1' data-look='classic' transform='translate(263.1328125%2c 35)'><rect class='basic label-container' style='' x='-97.1328125' y='-27' width='194.265625' height='54'/><g class='label' style='' transform='translate(-67.1328125%2c -12)'><rect/><foreignObject width='134.265625' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>Instructions 约束判断</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-2-flowchart-C-3' data-look='classic' transform='translate(495.8359375%2c 35)'><rect class='basic label-container' style='' x='-85.5703125' y='-27' width='171.140625' height='54'/><g class='label' style='' transform='translate(-55.5703125%2c -12)'><rect/><foreignObject width='111.140625' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>Schema 约束结构</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-2-flowchart-D-5' data-look='classic' transform='translate(730.6328125%2c 35)'><rect class='basic label-container' style='' x='-99.2265625' y='-27' width='198.453125' height='54'/><g class='label' style='' transform='translate(-69.2265625%2c -12)'><rect/><foreignObject width='138.453125' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>Business Validation</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-2-flowchart-E-7' data-look='classic' transform='translate(933.859375%2c 35)'><rect class='basic label-container' style='' x='-54' y='-27' width='108' height='54'/><g class='label' style='' transform='translate(-24%2c -12)'><rect/><foreignObject width='48' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>权限检查</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-2-flowchart-F-9' data-look='classic' transform='translate(1091.859375%2c 35)'><rect class='basic label-container' style='' x='-54' y='-27' width='108' height='54'/><g class='label' style='' transform='translate(-24%2c -12)'><rect/><foreignObject width='48' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>业务结果</p></span></div></foreignObject></g></g></g></g></g><defs><filter id='mermaid-2-drop-shadow' height='130%' width='130%'><feDropShadow dx='4' dy='4' stdDeviation='0' flood-opacity='0.06' flood-color='black'/></filter></defs><defs><filter id='mermaid-2-drop-shadow-small' height='150%' width='150%'><feDropShadow dx='2' dy='2' stdDeviation='0' flood-opacity='0.06' flood-color='black'/></filter></defs></svg>)
%3btext-align:center%3b}%23mermaid-dark-2 .edgeLabel p{background-color:hsl(0%2c 0%%2c 34.4117647059%)%3b}%23mermaid-dark-2 .edgeLabel rect{opacity:0.5%3bbackground-color:hsl(0%2c 0%%2c 34.4117647059%)%3bfill:hsl(0%2c 0%%2c 34.4117647059%)%3b}%23mermaid-dark-2 .labelBkg{background-color:rgba(87.75%2c 87.75%2c 87.75%2c 0.5)%3b}%23mermaid-dark-2 .cluster rect{fill:hsl(180%2c 1.5873015873%%2c 28.3529411765%)%3bstroke:rgba(255%2c 255%2c 255%2c 0.25)%3bstroke-width:1px%3b}%23mermaid-dark-2 .cluster text{fill:%23F9FFFE%3b}%23mermaid-dark-2 .cluster span{color:%23F9FFFE%3b}%23mermaid-dark-2 .node .collapsed-indicator{fill:rgba(255%2c 255%2c 255%2c 0.25)%3bstroke:none%3bopacity:0.6%3b}%23mermaid-dark-2 .node .collapsed-separator{stroke:rgba(255%2c 255%2c 255%2c 0.25)%3bstroke-width:0.75px%3b}%23mermaid-dark-2 div.mermaidTooltip{position:absolute%3btext-align:center%3bmax-width:200px%3bpadding:2px%3bfont-family:arial%2csans-serif%3bfont-size:12px%3bbackground:hsl(20%2c 1.5873015873%%2c 12.3529411765%)%3bborder:1px solid rgba(255%2c 255%2c 255%2c 0.25)%3bborder-radius:2px%3bpointer-events:none%3bz-index:100%3b}%23mermaid-dark-2 .flowchartTitleText{text-anchor:middle%3bfont-size:18px%3bfill:%23ccc%3b}%23mermaid-dark-2 rect.text{fill:none%3bstroke-width:0%3b}%23mermaid-dark-2 .icon-shape%2c%23mermaid-dark-2 .image-shape{background-color:hsl(0%2c 0%%2c 34.4117647059%)%3btext-align:center%3b}%23mermaid-dark-2 .icon-shape p%2c%23mermaid-dark-2 .image-shape p{background-color:hsl(0%2c 0%%2c 34.4117647059%)%3bpadding:2px%3b}%23mermaid-dark-2 .icon-shape .label rect%2c%23mermaid-dark-2 .image-shape .label rect{opacity:0.5%3bbackground-color:hsl(0%2c 0%%2c 34.4117647059%)%3bfill:hsl(0%2c 0%%2c 34.4117647059%)%3b}%23mermaid-dark-2 .label-icon{display:inline-block%3bheight:1em%3boverflow:visible%3bvertical-align:-0.125em%3b}%23mermaid-dark-2 .node .label-icon path{fill:currentColor%3bstroke:revert%3bstroke-width:revert%3b}%23mermaid-dark-2 .node .neo-node{stroke:%23ccc%3b}%23mermaid-dark-2 [data-look='neo'].node rect%2c%23mermaid-dark-2 [data-look='neo'].cluster rect%2c%23mermaid-dark-2 [data-look='neo'].node polygon{stroke:url(%23mermaid-dark-2-gradient)%3bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b}%23mermaid-dark-2 [data-look='neo'].swimlane.cluster rect{filter:none%3b}%23mermaid-dark-2 [data-look='neo'].node path{stroke:url(%23mermaid-dark-2-gradient)%3bstroke-width:1px%3b}%23mermaid-dark-2 [data-look='neo'].node .outer-path{filter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b}%23mermaid-dark-2 [data-look='neo'].node .neo-line path{stroke:%23ccc%3bfilter:none%3b}%23mermaid-dark-2 [data-look='neo'].node circle{stroke:url(%23mermaid-dark-2-gradient)%3bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b}%23mermaid-dark-2 [data-look='neo'].node circle .state-start{fill:black%3b}%23mermaid-dark-2 [data-look='neo'].icon-shape .icon{fill:url(%23mermaid-dark-2-gradient)%3bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b}%23mermaid-dark-2 [data-look='neo'].icon-shape .icon-neo path{stroke:url(%23mermaid-dark-2-gradient)%3bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b}%23mermaid-dark-2 :root{--mermaid-font-family:arial%2csans-serif%3b}</style><g><marker id='mermaid-dark-2_flowchart-v2-pointEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'><path d='M 0 0 L 10 5 L 0 10 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-2_flowchart-v2-pointStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='4.5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'><path d='M 0 5 L 10 10 L 10 0 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-2_flowchart-v2-pointEnd-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='11.5' refY='7' markerUnits='userSpaceOnUse' markerWidth='10.5' markerHeight='14' orient='auto'><path d='M 0 0 L 11.5 7 L 0 14 z' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-2_flowchart-v2-pointStart-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='1' refY='7' markerUnits='userSpaceOnUse' markerWidth='11.5' markerHeight='14' orient='auto'><polygon points='0%2c7 11.5%2c14 11.5%2c0' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-2_flowchart-v2-circleEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='11' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-2_flowchart-v2-circleStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-1' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-2_flowchart-v2-circleEnd-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refY='5' refX='12.25' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-2_flowchart-v2-circleStart-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-2' refY='5' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-2_flowchart-v2-crossEnd' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='12' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><path d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-2_flowchart-v2-crossStart' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='-1' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><path d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-2_flowchart-v2-crossEnd-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='17.7' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'><path d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b'/></marker><marker id='mermaid-dark-2_flowchart-v2-crossStart-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='-3.5' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'><path d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b stroke-dasharray: 1%2c 0%3b'/></marker><g class='root'><g class='clusters'/><g class='edgePaths'><path d='M116%2c35L120.167%2c35C124.333%2c35%2c132.667%2c35%2c140.333%2c35C148%2c35%2c155%2c35%2c158.5%2c35L162%2c35' id='mermaid-dark-2-L_A_B_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_A_B_0' data-points='W3sieCI6MTE2LCJ5IjozNX0seyJ4IjoxNDEsInkiOjM1fSx7IngiOjE2NiwieSI6MzV9XQ==' data-look='classic' marker-end='url(%23mermaid-dark-2_flowchart-v2-pointEnd)'/><path d='M360.266%2c35L364.432%2c35C368.599%2c35%2c376.932%2c35%2c384.599%2c35C392.266%2c35%2c399.266%2c35%2c402.766%2c35L406.266%2c35' id='mermaid-dark-2-L_B_C_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_B_C_0' data-points='W3sieCI6MzYwLjI2NTYyNSwieSI6MzV9LHsieCI6Mzg1LjI2NTYyNSwieSI6MzV9LHsieCI6NDEwLjI2NTYyNSwieSI6MzV9XQ==' data-look='classic' marker-end='url(%23mermaid-dark-2_flowchart-v2-pointEnd)'/><path d='M581.406%2c35L585.573%2c35C589.74%2c35%2c598.073%2c35%2c605.74%2c35C613.406%2c35%2c620.406%2c35%2c623.906%2c35L627.406%2c35' id='mermaid-dark-2-L_C_D_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_C_D_0' data-points='W3sieCI6NTgxLjQwNjI1LCJ5IjozNX0seyJ4Ijo2MDYuNDA2MjUsInkiOjM1fSx7IngiOjYzMS40MDYyNSwieSI6MzV9XQ==' data-look='classic' marker-end='url(%23mermaid-dark-2_flowchart-v2-pointEnd)'/><path d='M829.859%2c35L834.026%2c35C838.193%2c35%2c846.526%2c35%2c854.193%2c35C861.859%2c35%2c868.859%2c35%2c872.359%2c35L875.859%2c35' id='mermaid-dark-2-L_D_E_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_D_E_0' data-points='W3sieCI6ODI5Ljg1OTM3NSwieSI6MzV9LHsieCI6ODU0Ljg1OTM3NSwieSI6MzV9LHsieCI6ODc5Ljg1OTM3NSwieSI6MzV9XQ==' data-look='classic' marker-end='url(%23mermaid-dark-2_flowchart-v2-pointEnd)'/><path d='M987.859%2c35L992.026%2c35C996.193%2c35%2c1004.526%2c35%2c1012.193%2c35C1019.859%2c35%2c1026.859%2c35%2c1030.359%2c35L1033.859%2c35' id='mermaid-dark-2-L_E_F_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_E_F_0' data-points='W3sieCI6OTg3Ljg1OTM3NSwieSI6MzV9LHsieCI6MTAxMi44NTkzNzUsInkiOjM1fSx7IngiOjEwMzcuODU5Mzc1LCJ5IjozNX1d' data-look='classic' marker-end='url(%23mermaid-dark-2_flowchart-v2-pointEnd)'/></g><g class='edgeLabels'><g class='edgeLabel'><g class='label' data-id='L_A_B_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_B_C_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_C_D_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_D_E_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_E_F_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g></g><g class='nodes'><g class='node default' id='mermaid-dark-2-flowchart-A-0' data-look='classic' transform='translate(62%2c 35)'><rect class='basic label-container' style='' x='-54' y='-27' width='108' height='54'/><g class='label' style='' transform='translate(-24%2c -12)'><rect/><foreignObject width='48' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>模型输入</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-dark-2-flowchart-B-1' data-look='classic' transform='translate(263.1328125%2c 35)'><rect class='basic label-container' style='' x='-97.1328125' y='-27' width='194.265625' height='54'/><g class='label' style='' transform='translate(-67.1328125%2c -12)'><rect/><foreignObject width='134.265625' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>Instructions 约束判断</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-dark-2-flowchart-C-3' data-look='classic' transform='translate(495.8359375%2c 35)'><rect class='basic label-container' style='' x='-85.5703125' y='-27' width='171.140625' height='54'/><g class='label' style='' transform='translate(-55.5703125%2c -12)'><rect/><foreignObject width='111.140625' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>Schema 约束结构</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-dark-2-flowchart-D-5' data-look='classic' transform='translate(730.6328125%2c 35)'><rect class='basic label-container' style='' x='-99.2265625' y='-27' width='198.453125' height='54'/><g class='label' style='' transform='translate(-69.2265625%2c -12)'><rect/><foreignObject width='138.453125' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>Business Validation</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-dark-2-flowchart-E-7' data-look='classic' transform='translate(933.859375%2c 35)'><rect class='basic label-container' style='' x='-54' y='-27' width='108' height='54'/><g class='label' style='' transform='translate(-24%2c -12)'><rect/><foreignObject width='48' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>权限检查</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-dark-2-flowchart-F-9' data-look='classic' transform='translate(1091.859375%2c 35)'><rect class='basic label-container' style='' x='-54' y='-27' width='108' height='54'/><g class='label' style='' transform='translate(-24%2c -12)'><rect/><foreignObject width='48' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>业务结果</p></span></div></foreignObject></g></g></g></g></g><defs><filter id='mermaid-dark-2-drop-shadow' height='130%' width='130%'><feDropShadow dx='4' dy='4' stdDeviation='0' flood-opacity='0.06' flood-color='white'/></filter></defs><defs><filter id='mermaid-dark-2-drop-shadow-small' height='150%' width='150%'><feDropShadow dx='2' dy='2' stdDeviation='0' flood-opacity='0.06' flood-color='white'/></filter></defs><linearGradient id='mermaid-dark-2-gradient' gradientUnits='objectBoundingBox' x1='0%' y1='0%' x2='100%' y2='0%'><stop offset='0%' stop-color='%23cccccc' stop-opacity='1'/><stop offset='100%' stop-color='hsl(180%2c 0%%2c 18.3529411765%)' stop-opacity='1'/></linearGradient></svg>)
在 Instructions 中定义业务语义
枚举只能限制取值范围,无法解释每个枚举代表什么。严重程度规则仍需要写进 Instructions:
SYSTEM_INSTRUCTIONS = """
你是系统故障分类组件。

LOW:
不影响核心业务,仅产生轻微告警。

MEDIUM:
影响部分功能,但存在降级或重试机制。

HIGH:
造成核心业务不可用、数据无法访问,
或大量请求持续失败。
"""
一个稳定的模型服务通常依赖三部分共同约束:
Instructions + Schema + Business Validation不让模型直接授权高风险操作
下面的设计即使结构正确,也很危险:
class RiskResult(BaseModel):
    should_delete_user: bool


if result.should_delete_user:
    delete_user()
Structured Outputs 只能保证 should_delete_user 是布尔值,不能保证模型判断一定正确。对于删除数据、转账、修改权限、发布内容和执行运维命令等操作,模型结果只能作为决策输入,不能作为最终授权。
%3btext-align:center%3b}%23mermaid-3 .edgeLabel p{background-color:rgba(232%2c232%2c232%2c 0.8)%3b}%23mermaid-3 .edgeLabel rect{opacity:0.5%3bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bfill:rgba(232%2c232%2c232%2c 0.8)%3b}%23mermaid-3 .labelBkg{background-color:rgba(232%2c 232%2c 232%2c 0.5)%3b}%23mermaid-3 .cluster rect{fill:%23ffffde%3bstroke:%23aaaa33%3bstroke-width:1px%3b}%23mermaid-3 .cluster text{fill:%23333%3b}%23mermaid-3 .cluster span{color:%23333%3b}%23mermaid-3 .node .collapsed-indicator{fill:%23aaaa33%3bstroke:none%3bopacity:0.6%3b}%23mermaid-3 .node .collapsed-separator{stroke:%23aaaa33%3bstroke-width:0.75px%3b}%23mermaid-3 div.mermaidTooltip{position:absolute%3btext-align:center%3bmax-width:200px%3bpadding:2px%3bfont-family:arial%2csans-serif%3bfont-size:12px%3bbackground:hsl(80%2c 100%%2c 96.2745098039%)%3bborder:1px solid %23aaaa33%3bborder-radius:2px%3bpointer-events:none%3bz-index:100%3b}%23mermaid-3 .flowchartTitleText{text-anchor:middle%3bfont-size:18px%3bfill:%23333%3b}%23mermaid-3 rect.text{fill:none%3bstroke-width:0%3b}%23mermaid-3 .icon-shape%2c%23mermaid-3 .image-shape{background-color:rgba(232%2c232%2c232%2c 0.8)%3btext-align:center%3b}%23mermaid-3 .icon-shape p%2c%23mermaid-3 .image-shape p{background-color:rgba(232%2c232%2c232%2c 0.8)%3bpadding:2px%3b}%23mermaid-3 .icon-shape .label rect%2c%23mermaid-3 .image-shape .label rect{opacity:0.5%3bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bfill:rgba(232%2c232%2c232%2c 0.8)%3b}%23mermaid-3 .label-icon{display:inline-block%3bheight:1em%3boverflow:visible%3bvertical-align:-0.125em%3b}%23mermaid-3 .node .label-icon path{fill:currentColor%3bstroke:revert%3bstroke-width:revert%3b}%23mermaid-3 .node .neo-node{stroke:%239370DB%3b}%23mermaid-3 [data-look='neo'].node rect%2c%23mermaid-3 [data-look='neo'].cluster rect%2c%23mermaid-3 [data-look='neo'].node polygon{stroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b}%23mermaid-3 [data-look='neo'].swimlane.cluster rect{filter:none%3b}%23mermaid-3 [data-look='neo'].node path{stroke:%239370DB%3bstroke-width:1px%3b}%23mermaid-3 [data-look='neo'].node .outer-path{filter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b}%23mermaid-3 [data-look='neo'].node .neo-line path{stroke:%239370DB%3bfilter:none%3b}%23mermaid-3 [data-look='neo'].node circle{stroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b}%23mermaid-3 [data-look='neo'].node circle .state-start{fill:black%3b}%23mermaid-3 [data-look='neo'].icon-shape .icon{fill:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b}%23mermaid-3 [data-look='neo'].icon-shape .icon-neo path{stroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b}%23mermaid-3 :root{--mermaid-font-family:arial%2csans-serif%3b}</style><g><marker id='mermaid-3_flowchart-v2-pointEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'><path d='M 0 0 L 10 5 L 0 10 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-3_flowchart-v2-pointStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='4.5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'><path d='M 0 5 L 10 10 L 10 0 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-3_flowchart-v2-pointEnd-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='11.5' refY='7' markerUnits='userSpaceOnUse' markerWidth='10.5' markerHeight='14' orient='auto'><path d='M 0 0 L 11.5 7 L 0 14 z' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-3_flowchart-v2-pointStart-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='1' refY='7' markerUnits='userSpaceOnUse' markerWidth='11.5' markerHeight='14' orient='auto'><polygon points='0%2c7 11.5%2c14 11.5%2c0' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-3_flowchart-v2-circleEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='11' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-3_flowchart-v2-circleStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-1' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-3_flowchart-v2-circleEnd-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refY='5' refX='12.25' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-3_flowchart-v2-circleStart-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-2' refY='5' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-3_flowchart-v2-crossEnd' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='12' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><path d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-3_flowchart-v2-crossStart' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='-1' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><path d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-3_flowchart-v2-crossEnd-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='17.7' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'><path d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b'/></marker><marker id='mermaid-3_flowchart-v2-crossStart-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='-3.5' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'><path d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b stroke-dasharray: 1%2c 0%3b'/></marker><g class='root'><g class='clusters'/><g class='edgePaths'><path d='M116%2c69.453L120.167%2c69.453C124.333%2c69.453%2c132.667%2c69.453%2c140.333%2c69.453C148%2c69.453%2c155%2c69.453%2c158.5%2c69.453L162%2c69.453' id='mermaid-3-L_A_B_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_A_B_0' data-points='W3sieCI6MTE2LCJ5Ijo2OS40NTMxMjV9LHsieCI6MTQxLCJ5Ijo2OS40NTMxMjV9LHsieCI6MTY2LCJ5Ijo2OS40NTMxMjV9XQ==' data-look='classic' marker-end='url(%23mermaid-3_flowchart-v2-pointEnd)'/><path d='M298%2c69.453L302.167%2c69.453C306.333%2c69.453%2c314.667%2c69.453%2c322.333%2c69.453C330%2c69.453%2c337%2c69.453%2c340.5%2c69.453L344%2c69.453' id='mermaid-3-L_B_C_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_B_C_0' data-points='W3sieCI6Mjk4LCJ5Ijo2OS40NTMxMjV9LHsieCI6MzIzLCJ5Ijo2OS40NTMxMjV9LHsieCI6MzQ4LCJ5Ijo2OS40NTMxMjV9XQ==' data-look='classic' marker-end='url(%23mermaid-3_flowchart-v2-pointEnd)'/><path d='M456%2c69.453L460.167%2c69.453C464.333%2c69.453%2c472.667%2c69.453%2c480.333%2c69.453C488%2c69.453%2c495%2c69.453%2c498.5%2c69.453L502%2c69.453' id='mermaid-3-L_C_D_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_C_D_0' data-points='W3sieCI6NDU2LCJ5Ijo2OS40NTMxMjV9LHsieCI6NDgxLCJ5Ijo2OS40NTMxMjV9LHsieCI6NTA2LCJ5Ijo2OS40NTMxMjV9XQ==' data-look='classic' marker-end='url(%23mermaid-3_flowchart-v2-pointEnd)'/><path d='M611.342%2c87.018L619.436%2c90.257C627.53%2c93.496%2c643.718%2c99.975%2c656.312%2c103.214C668.906%2c106.453%2c677.906%2c106.453%2c682.406%2c106.453L686.906%2c106.453' id='mermaid-3-L_D_E_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_D_E_0' data-points='W3sieCI6NjExLjM0MTg1NjUxNzgwMzMsInkiOjg3LjAxNzUxODQ4MjE5NjczfSx7IngiOjY1OS45MDYyNSwieSI6MTA2LjQ1MzEyNX0seyJ4Ijo2OTAuOTA2MjUsInkiOjEwNi40NTMxMjV9XQ==' data-look='classic' marker-end='url(%23mermaid-3_flowchart-v2-pointEnd)'/><path d='M611.342%2c51.889L619.436%2c48.649C627.53%2c45.41%2c643.718%2c38.932%2c668.979%2c35.692C694.24%2c32.453%2c728.573%2c32.453%2c761.906%2c32.453C795.24%2c32.453%2c827.573%2c32.453%2c847.323%2c34.432C867.072%2c36.411%2c874.239%2c40.368%2c877.822%2c42.347L881.405%2c44.325' id='mermaid-3-L_D_F_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_D_F_0' data-points='W3sieCI6NjExLjM0MTg1NjUxNzgwMzMsInkiOjUxLjg4ODczMTUxNzgwMzI2fSx7IngiOjY1OS45MDYyNSwieSI6MzIuNDUzMTI1fSx7IngiOjc2Mi45MDYyNSwieSI6MzIuNDUzMTI1fSx7IngiOjg1OS45MDYyNSwieSI6MzIuNDUzMTI1fSx7IngiOjg4NC45MDYyNSwieSI6NDYuMjU5MDk1MTQ5MjUzNzN9XQ==' data-look='classic' marker-end='url(%23mermaid-3_flowchart-v2-pointEnd)'/><path d='M834.906%2c106.453L839.073%2c106.453C843.24%2c106.453%2c851.573%2c106.453%2c859.323%2c104.474C867.072%2c102.496%2c874.239%2c98.538%2c877.822%2c96.56L881.405%2c94.581' id='mermaid-3-L_E_F_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_E_F_0' data-points='W3sieCI6ODM0LjkwNjI1LCJ5IjoxMDYuNDUzMTI1fSx7IngiOjg1OS45MDYyNSwieSI6MTA2LjQ1MzEyNX0seyJ4Ijo4ODQuOTA2MjUsInkiOjkyLjY0NzE1NDg1MDc0NjI2fV0=' data-look='classic' marker-end='url(%23mermaid-3_flowchart-v2-pointEnd)'/></g><g class='edgeLabels'><g class='edgeLabel'><g class='label' data-id='L_A_B_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_B_C_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_C_D_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel' transform='translate(659.90625%2c 106.453125)'><g class='label' data-id='L_D_E_0' transform='translate(-6%2c -12)'><foreignObject width='12' height='24'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'><p>是</p></span></div></foreignObject></g></g><g class='edgeLabel' transform='translate(762.90625%2c 32.453125)'><g class='label' data-id='L_D_F_0' transform='translate(-6%2c -12)'><foreignObject width='12' height='24'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'><p>否</p></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_E_F_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g></g><g class='nodes'><g class='node default' id='mermaid-3-flowchart-A-0' data-look='classic' transform='translate(62%2c 69.453125)'><rect class='basic label-container' style='' x='-54' y='-27' width='108' height='54'/><g class='label' style='' transform='translate(-24%2c -12)'><rect/><foreignObject width='48' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>模型建议</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-3-flowchart-B-1' data-look='classic' transform='translate(232%2c 69.453125)'><rect class='basic label-container' style='' x='-66' y='-27' width='132' height='54'/><g class='label' style='' transform='translate(-36%2c -12)'><rect/><foreignObject width='72' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>业务规则校验</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-3-flowchart-C-3' data-look='classic' transform='translate(402%2c 69.453125)'><rect class='basic label-container' style='' x='-54' y='-27' width='108' height='54'/><g class='label' style='' transform='translate(-24%2c -12)'><rect/><foreignObject width='48' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>权限检查</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-3-flowchart-D-5' data-look='classic' transform='translate(567.453125%2c 69.453125)'><polygon points='61.453125%2c0 122.90625%2c-61.453125 61.453125%2c-122.90625 0%2c-61.453125' class='label-container' transform='translate(-60.953125%2c 61.453125)'/><g class='label' style='' transform='translate(-34.453125%2c -12)'><rect/><foreignObject width='68.90625' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>高风险操作%3f</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-3-flowchart-E-7' data-look='classic' transform='translate(762.90625%2c 106.453125)'><rect class='basic label-container' style='' x='-72' y='-27' width='144' height='54'/><g class='label' style='' transform='translate(-42%2c -12)'><rect/><foreignObject width='84' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>人工确认或审批</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-3-flowchart-F-9' data-look='classic' transform='translate(926.90625%2c 69.453125)'><rect class='basic label-container' style='' x='-42' y='-27' width='84' height='54'/><g class='label' style='' transform='translate(-12%2c -12)'><rect/><foreignObject width='24' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>执行</p></span></div></foreignObject></g></g></g></g></g><defs><filter id='mermaid-3-drop-shadow' height='130%' width='130%'><feDropShadow dx='4' dy='4' stdDeviation='0' flood-opacity='0.06' flood-color='black'/></filter></defs><defs><filter id='mermaid-3-drop-shadow-small' height='150%' width='150%'><feDropShadow dx='2' dy='2' stdDeviation='0' flood-opacity='0.06' flood-color='black'/></filter></defs></svg>)
%3btext-align:center%3b}%23mermaid-dark-3 .edgeLabel p{background-color:hsl(0%2c 0%%2c 34.4117647059%)%3b}%23mermaid-dark-3 .edgeLabel rect{opacity:0.5%3bbackground-color:hsl(0%2c 0%%2c 34.4117647059%)%3bfill:hsl(0%2c 0%%2c 34.4117647059%)%3b}%23mermaid-dark-3 .labelBkg{background-color:rgba(87.75%2c 87.75%2c 87.75%2c 0.5)%3b}%23mermaid-dark-3 .cluster rect{fill:hsl(180%2c 1.5873015873%%2c 28.3529411765%)%3bstroke:rgba(255%2c 255%2c 255%2c 0.25)%3bstroke-width:1px%3b}%23mermaid-dark-3 .cluster text{fill:%23F9FFFE%3b}%23mermaid-dark-3 .cluster span{color:%23F9FFFE%3b}%23mermaid-dark-3 .node .collapsed-indicator{fill:rgba(255%2c 255%2c 255%2c 0.25)%3bstroke:none%3bopacity:0.6%3b}%23mermaid-dark-3 .node .collapsed-separator{stroke:rgba(255%2c 255%2c 255%2c 0.25)%3bstroke-width:0.75px%3b}%23mermaid-dark-3 div.mermaidTooltip{position:absolute%3btext-align:center%3bmax-width:200px%3bpadding:2px%3bfont-family:arial%2csans-serif%3bfont-size:12px%3bbackground:hsl(20%2c 1.5873015873%%2c 12.3529411765%)%3bborder:1px solid rgba(255%2c 255%2c 255%2c 0.25)%3bborder-radius:2px%3bpointer-events:none%3bz-index:100%3b}%23mermaid-dark-3 .flowchartTitleText{text-anchor:middle%3bfont-size:18px%3bfill:%23ccc%3b}%23mermaid-dark-3 rect.text{fill:none%3bstroke-width:0%3b}%23mermaid-dark-3 .icon-shape%2c%23mermaid-dark-3 .image-shape{background-color:hsl(0%2c 0%%2c 34.4117647059%)%3btext-align:center%3b}%23mermaid-dark-3 .icon-shape p%2c%23mermaid-dark-3 .image-shape p{background-color:hsl(0%2c 0%%2c 34.4117647059%)%3bpadding:2px%3b}%23mermaid-dark-3 .icon-shape .label rect%2c%23mermaid-dark-3 .image-shape .label rect{opacity:0.5%3bbackground-color:hsl(0%2c 0%%2c 34.4117647059%)%3bfill:hsl(0%2c 0%%2c 34.4117647059%)%3b}%23mermaid-dark-3 .label-icon{display:inline-block%3bheight:1em%3boverflow:visible%3bvertical-align:-0.125em%3b}%23mermaid-dark-3 .node .label-icon path{fill:currentColor%3bstroke:revert%3bstroke-width:revert%3b}%23mermaid-dark-3 .node .neo-node{stroke:%23ccc%3b}%23mermaid-dark-3 [data-look='neo'].node rect%2c%23mermaid-dark-3 [data-look='neo'].cluster rect%2c%23mermaid-dark-3 [data-look='neo'].node polygon{stroke:url(%23mermaid-dark-3-gradient)%3bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b}%23mermaid-dark-3 [data-look='neo'].swimlane.cluster rect{filter:none%3b}%23mermaid-dark-3 [data-look='neo'].node path{stroke:url(%23mermaid-dark-3-gradient)%3bstroke-width:1px%3b}%23mermaid-dark-3 [data-look='neo'].node .outer-path{filter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b}%23mermaid-dark-3 [data-look='neo'].node .neo-line path{stroke:%23ccc%3bfilter:none%3b}%23mermaid-dark-3 [data-look='neo'].node circle{stroke:url(%23mermaid-dark-3-gradient)%3bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b}%23mermaid-dark-3 [data-look='neo'].node circle .state-start{fill:black%3b}%23mermaid-dark-3 [data-look='neo'].icon-shape .icon{fill:url(%23mermaid-dark-3-gradient)%3bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b}%23mermaid-dark-3 [data-look='neo'].icon-shape .icon-neo path{stroke:url(%23mermaid-dark-3-gradient)%3bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b}%23mermaid-dark-3 :root{--mermaid-font-family:arial%2csans-serif%3b}</style><g><marker id='mermaid-dark-3_flowchart-v2-pointEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'><path d='M 0 0 L 10 5 L 0 10 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-3_flowchart-v2-pointStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='4.5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'><path d='M 0 5 L 10 10 L 10 0 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-3_flowchart-v2-pointEnd-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='11.5' refY='7' markerUnits='userSpaceOnUse' markerWidth='10.5' markerHeight='14' orient='auto'><path d='M 0 0 L 11.5 7 L 0 14 z' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-3_flowchart-v2-pointStart-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='1' refY='7' markerUnits='userSpaceOnUse' markerWidth='11.5' markerHeight='14' orient='auto'><polygon points='0%2c7 11.5%2c14 11.5%2c0' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-3_flowchart-v2-circleEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='11' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-3_flowchart-v2-circleStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-1' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-3_flowchart-v2-circleEnd-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refY='5' refX='12.25' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-3_flowchart-v2-circleStart-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-2' refY='5' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-3_flowchart-v2-crossEnd' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='12' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><path d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-3_flowchart-v2-crossStart' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='-1' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><path d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-3_flowchart-v2-crossEnd-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='17.7' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'><path d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b'/></marker><marker id='mermaid-dark-3_flowchart-v2-crossStart-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='-3.5' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'><path d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b stroke-dasharray: 1%2c 0%3b'/></marker><g class='root'><g class='clusters'/><g class='edgePaths'><path d='M116%2c69.453L120.167%2c69.453C124.333%2c69.453%2c132.667%2c69.453%2c140.333%2c69.453C148%2c69.453%2c155%2c69.453%2c158.5%2c69.453L162%2c69.453' id='mermaid-dark-3-L_A_B_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_A_B_0' data-points='W3sieCI6MTE2LCJ5Ijo2OS40NTMxMjV9LHsieCI6MTQxLCJ5Ijo2OS40NTMxMjV9LHsieCI6MTY2LCJ5Ijo2OS40NTMxMjV9XQ==' data-look='classic' marker-end='url(%23mermaid-dark-3_flowchart-v2-pointEnd)'/><path d='M298%2c69.453L302.167%2c69.453C306.333%2c69.453%2c314.667%2c69.453%2c322.333%2c69.453C330%2c69.453%2c337%2c69.453%2c340.5%2c69.453L344%2c69.453' id='mermaid-dark-3-L_B_C_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_B_C_0' data-points='W3sieCI6Mjk4LCJ5Ijo2OS40NTMxMjV9LHsieCI6MzIzLCJ5Ijo2OS40NTMxMjV9LHsieCI6MzQ4LCJ5Ijo2OS40NTMxMjV9XQ==' data-look='classic' marker-end='url(%23mermaid-dark-3_flowchart-v2-pointEnd)'/><path d='M456%2c69.453L460.167%2c69.453C464.333%2c69.453%2c472.667%2c69.453%2c480.333%2c69.453C488%2c69.453%2c495%2c69.453%2c498.5%2c69.453L502%2c69.453' id='mermaid-dark-3-L_C_D_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_C_D_0' data-points='W3sieCI6NDU2LCJ5Ijo2OS40NTMxMjV9LHsieCI6NDgxLCJ5Ijo2OS40NTMxMjV9LHsieCI6NTA2LCJ5Ijo2OS40NTMxMjV9XQ==' data-look='classic' marker-end='url(%23mermaid-dark-3_flowchart-v2-pointEnd)'/><path d='M611.342%2c87.018L619.436%2c90.257C627.53%2c93.496%2c643.718%2c99.975%2c656.312%2c103.214C668.906%2c106.453%2c677.906%2c106.453%2c682.406%2c106.453L686.906%2c106.453' id='mermaid-dark-3-L_D_E_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_D_E_0' data-points='W3sieCI6NjExLjM0MTg1NjUxNzgwMzMsInkiOjg3LjAxNzUxODQ4MjE5NjczfSx7IngiOjY1OS45MDYyNSwieSI6MTA2LjQ1MzEyNX0seyJ4Ijo2OTAuOTA2MjUsInkiOjEwNi40NTMxMjV9XQ==' data-look='classic' marker-end='url(%23mermaid-dark-3_flowchart-v2-pointEnd)'/><path d='M611.342%2c51.889L619.436%2c48.649C627.53%2c45.41%2c643.718%2c38.932%2c668.979%2c35.692C694.24%2c32.453%2c728.573%2c32.453%2c761.906%2c32.453C795.24%2c32.453%2c827.573%2c32.453%2c847.323%2c34.432C867.072%2c36.411%2c874.239%2c40.368%2c877.822%2c42.347L881.405%2c44.325' id='mermaid-dark-3-L_D_F_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_D_F_0' data-points='W3sieCI6NjExLjM0MTg1NjUxNzgwMzMsInkiOjUxLjg4ODczMTUxNzgwMzI2fSx7IngiOjY1OS45MDYyNSwieSI6MzIuNDUzMTI1fSx7IngiOjc2Mi45MDYyNSwieSI6MzIuNDUzMTI1fSx7IngiOjg1OS45MDYyNSwieSI6MzIuNDUzMTI1fSx7IngiOjg4NC45MDYyNSwieSI6NDYuMjU5MDk1MTQ5MjUzNzN9XQ==' data-look='classic' marker-end='url(%23mermaid-dark-3_flowchart-v2-pointEnd)'/><path d='M834.906%2c106.453L839.073%2c106.453C843.24%2c106.453%2c851.573%2c106.453%2c859.323%2c104.474C867.072%2c102.496%2c874.239%2c98.538%2c877.822%2c96.56L881.405%2c94.581' id='mermaid-dark-3-L_E_F_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_E_F_0' data-points='W3sieCI6ODM0LjkwNjI1LCJ5IjoxMDYuNDUzMTI1fSx7IngiOjg1OS45MDYyNSwieSI6MTA2LjQ1MzEyNX0seyJ4Ijo4ODQuOTA2MjUsInkiOjkyLjY0NzE1NDg1MDc0NjI2fV0=' data-look='classic' marker-end='url(%23mermaid-dark-3_flowchart-v2-pointEnd)'/></g><g class='edgeLabels'><g class='edgeLabel'><g class='label' data-id='L_A_B_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_B_C_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_C_D_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel' transform='translate(659.90625%2c 106.453125)'><g class='label' data-id='L_D_E_0' transform='translate(-6%2c -12)'><foreignObject width='12' height='24'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'><p>是</p></span></div></foreignObject></g></g><g class='edgeLabel' transform='translate(762.90625%2c 32.453125)'><g class='label' data-id='L_D_F_0' transform='translate(-6%2c -12)'><foreignObject width='12' height='24'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'><p>否</p></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_E_F_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g></g><g class='nodes'><g class='node default' id='mermaid-dark-3-flowchart-A-0' data-look='classic' transform='translate(62%2c 69.453125)'><rect class='basic label-container' style='' x='-54' y='-27' width='108' height='54'/><g class='label' style='' transform='translate(-24%2c -12)'><rect/><foreignObject width='48' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>模型建议</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-dark-3-flowchart-B-1' data-look='classic' transform='translate(232%2c 69.453125)'><rect class='basic label-container' style='' x='-66' y='-27' width='132' height='54'/><g class='label' style='' transform='translate(-36%2c -12)'><rect/><foreignObject width='72' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>业务规则校验</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-dark-3-flowchart-C-3' data-look='classic' transform='translate(402%2c 69.453125)'><rect class='basic label-container' style='' x='-54' y='-27' width='108' height='54'/><g class='label' style='' transform='translate(-24%2c -12)'><rect/><foreignObject width='48' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>权限检查</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-dark-3-flowchart-D-5' data-look='classic' transform='translate(567.453125%2c 69.453125)'><polygon points='61.453125%2c0 122.90625%2c-61.453125 61.453125%2c-122.90625 0%2c-61.453125' class='label-container' transform='translate(-60.953125%2c 61.453125)'/><g class='label' style='' transform='translate(-34.453125%2c -12)'><rect/><foreignObject width='68.90625' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>高风险操作%3f</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-dark-3-flowchart-E-7' data-look='classic' transform='translate(762.90625%2c 106.453125)'><rect class='basic label-container' style='' x='-72' y='-27' width='144' height='54'/><g class='label' style='' transform='translate(-42%2c -12)'><rect/><foreignObject width='84' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>人工确认或审批</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-dark-3-flowchart-F-9' data-look='classic' transform='translate(926.90625%2c 69.453125)'><rect class='basic label-container' style='' x='-42' y='-27' width='84' height='54'/><g class='label' style='' transform='translate(-12%2c -12)'><rect/><foreignObject width='24' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>执行</p></span></div></foreignObject></g></g></g></g></g><defs><filter id='mermaid-dark-3-drop-shadow' height='130%' width='130%'><feDropShadow dx='4' dy='4' stdDeviation='0' flood-opacity='0.06' flood-color='white'/></filter></defs><defs><filter id='mermaid-dark-3-drop-shadow-small' height='150%' width='150%'><feDropShadow dx='2' dy='2' stdDeviation='0' flood-opacity='0.06' flood-color='white'/></filter></defs><linearGradient id='mermaid-dark-3-gradient' gradientUnits='objectBoundingBox' x1='0%' y1='0%' x2='100%' y2='0%'><stop offset='0%' stop-color='%23cccccc' stop-opacity='1'/><stop offset='100%' stop-color='hsl(180%2c 0%%2c 18.3529411765%)' stop-opacity='1'/></linearGradient></svg>)
工程化封装与异常处理
真实项目不应把 client.responses.parse() 散落在业务代码中。可以建立独立的模型服务层:
from openai import OpenAI


class FaultAnalysisService:
    def __init__(self) -> None:
        self.client = OpenAI()
        self.model = "gpt-5.4"

    def analyze(self, log: str) -> FaultAnalysis:
        response = self.client.responses.parse(
            model=self.model,
            instructions="""
            你是系统故障分析组件。

            DATABASE:数据库连接、SQL、事务和连接池问题。
            NETWORK:DNS、TCP、HTTP 和网络连通性问题。
            APPLICATION:应用代码和运行时异常。
            UNKNOWN:无法明确分类的问题。
            """,
            input=log,
            text_format=FaultAnalysis,
        )

        result = response.output_parsed

        if result is None:
            raise RuntimeError("模型未返回有效的结构化结果")

        return result
业务代码只需要处理类型对象:
service = FaultAnalysisService()
result = service.analyze(log)

if result.category == FaultCategory.DATABASE:
    route_to_database_team()
处理拒绝和失败
应用不能假设 output_parsed 永远存在。模型可能拒绝请求,API 也可能发生网络、鉴权、频率限制或服务端错误。
生产系统至少应区分:
- 正常结构化输出;
- 模型拒绝;
- 输出解析或校验失败;
- 请求超时与网络异常;
- 频率限制;
- 鉴权或参数错误;
- 服务端错误。
基础封装可以先保护调用边界:
from pydantic import ValidationError


def analyze_fault(log: str) -> FaultAnalysis:
    try:
        response = client.responses.parse(
            model="gpt-5.4",
            input=log,
            text_format=FaultAnalysis,
        )

        result = response.output_parsed
        if result is None:
            raise RuntimeError("模型没有返回结构化结果")

        return result

    except ValidationError as exc:
        raise RuntimeError("模型输出校验失败") from exc
实际项目还应按照 SDK 的具体异常类型分别处理,不要用一个宽泛的异常分支吞掉全部错误。对于拒绝响应,可以进一步检查 response.output 中的对应输出项。
映射到业务 DTO
AI 层对象不一定应该贯穿整个系统。可以在边界处把它转换成业务 DTO:
def convert_to_alarm(analysis: FaultAnalysis) -> AlarmCommand:
    return AlarmCommand(
        type=analysis.category.value,
        level=analysis.severity.value,
        description=analysis.summary,
    )
整体链路变成:
%3btext-align:center%3b}%23mermaid-4 .edgeLabel p{background-color:rgba(232%2c232%2c232%2c 0.8)%3b}%23mermaid-4 .edgeLabel rect{opacity:0.5%3bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bfill:rgba(232%2c232%2c232%2c 0.8)%3b}%23mermaid-4 .labelBkg{background-color:rgba(232%2c 232%2c 232%2c 0.5)%3b}%23mermaid-4 .cluster rect{fill:%23ffffde%3bstroke:%23aaaa33%3bstroke-width:1px%3b}%23mermaid-4 .cluster text{fill:%23333%3b}%23mermaid-4 .cluster span{color:%23333%3b}%23mermaid-4 .node .collapsed-indicator{fill:%23aaaa33%3bstroke:none%3bopacity:0.6%3b}%23mermaid-4 .node .collapsed-separator{stroke:%23aaaa33%3bstroke-width:0.75px%3b}%23mermaid-4 div.mermaidTooltip{position:absolute%3btext-align:center%3bmax-width:200px%3bpadding:2px%3bfont-family:arial%2csans-serif%3bfont-size:12px%3bbackground:hsl(80%2c 100%%2c 96.2745098039%)%3bborder:1px solid %23aaaa33%3bborder-radius:2px%3bpointer-events:none%3bz-index:100%3b}%23mermaid-4 .flowchartTitleText{text-anchor:middle%3bfont-size:18px%3bfill:%23333%3b}%23mermaid-4 rect.text{fill:none%3bstroke-width:0%3b}%23mermaid-4 .icon-shape%2c%23mermaid-4 .image-shape{background-color:rgba(232%2c232%2c232%2c 0.8)%3btext-align:center%3b}%23mermaid-4 .icon-shape p%2c%23mermaid-4 .image-shape p{background-color:rgba(232%2c232%2c232%2c 0.8)%3bpadding:2px%3b}%23mermaid-4 .icon-shape .label rect%2c%23mermaid-4 .image-shape .label rect{opacity:0.5%3bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bfill:rgba(232%2c232%2c232%2c 0.8)%3b}%23mermaid-4 .label-icon{display:inline-block%3bheight:1em%3boverflow:visible%3bvertical-align:-0.125em%3b}%23mermaid-4 .node .label-icon path{fill:currentColor%3bstroke:revert%3bstroke-width:revert%3b}%23mermaid-4 .node .neo-node{stroke:%239370DB%3b}%23mermaid-4 [data-look='neo'].node rect%2c%23mermaid-4 [data-look='neo'].cluster rect%2c%23mermaid-4 [data-look='neo'].node polygon{stroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b}%23mermaid-4 [data-look='neo'].swimlane.cluster rect{filter:none%3b}%23mermaid-4 [data-look='neo'].node path{stroke:%239370DB%3bstroke-width:1px%3b}%23mermaid-4 [data-look='neo'].node .outer-path{filter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b}%23mermaid-4 [data-look='neo'].node .neo-line path{stroke:%239370DB%3bfilter:none%3b}%23mermaid-4 [data-look='neo'].node circle{stroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b}%23mermaid-4 [data-look='neo'].node circle .state-start{fill:black%3b}%23mermaid-4 [data-look='neo'].icon-shape .icon{fill:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b}%23mermaid-4 [data-look='neo'].icon-shape .icon-neo path{stroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b}%23mermaid-4 :root{--mermaid-font-family:arial%2csans-serif%3b}</style><g><marker id='mermaid-4_flowchart-v2-pointEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'><path d='M 0 0 L 10 5 L 0 10 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-4_flowchart-v2-pointStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='4.5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'><path d='M 0 5 L 10 10 L 10 0 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-4_flowchart-v2-pointEnd-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='11.5' refY='7' markerUnits='userSpaceOnUse' markerWidth='10.5' markerHeight='14' orient='auto'><path d='M 0 0 L 11.5 7 L 0 14 z' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-4_flowchart-v2-pointStart-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='1' refY='7' markerUnits='userSpaceOnUse' markerWidth='11.5' markerHeight='14' orient='auto'><polygon points='0%2c7 11.5%2c14 11.5%2c0' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-4_flowchart-v2-circleEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='11' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-4_flowchart-v2-circleStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-1' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-4_flowchart-v2-circleEnd-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refY='5' refX='12.25' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-4_flowchart-v2-circleStart-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-2' refY='5' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-4_flowchart-v2-crossEnd' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='12' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><path d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-4_flowchart-v2-crossStart' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='-1' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><path d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-4_flowchart-v2-crossEnd-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='17.7' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'><path d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b'/></marker><marker id='mermaid-4_flowchart-v2-crossStart-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='-3.5' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'><path d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b stroke-dasharray: 1%2c 0%3b'/></marker><g class='root'><g class='clusters'/><g class='edgePaths'><path d='M151.609%2c35L155.776%2c35C159.943%2c35%2c168.276%2c35%2c175.943%2c35C183.609%2c35%2c190.609%2c35%2c194.109%2c35L197.609%2c35' id='mermaid-4-L_A_B_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_A_B_0' data-points='W3sieCI6MTUxLjYwOTM3NSwieSI6MzV9LHsieCI6MTc2LjYwOTM3NSwieSI6MzV9LHsieCI6MjAxLjYwOTM3NSwieSI6MzV9XQ==' data-look='classic' marker-end='url(%23mermaid-4_flowchart-v2-pointEnd)'/><path d='M383.453%2c35L387.62%2c35C391.786%2c35%2c400.12%2c35%2c407.786%2c35C415.453%2c35%2c422.453%2c35%2c425.953%2c35L429.453%2c35' id='mermaid-4-L_B_C_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_B_C_0' data-points='W3sieCI6MzgzLjQ1MzEyNSwieSI6MzV9LHsieCI6NDA4LjQ1MzEyNSwieSI6MzV9LHsieCI6NDMzLjQ1MzEyNSwieSI6MzV9XQ==' data-look='classic' marker-end='url(%23mermaid-4_flowchart-v2-pointEnd)'/><path d='M631.906%2c35L636.073%2c35C640.24%2c35%2c648.573%2c35%2c656.24%2c35C663.906%2c35%2c670.906%2c35%2c674.406%2c35L677.906%2c35' id='mermaid-4-L_C_D_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_C_D_0' data-points='W3sieCI6NjMxLjkwNjI1LCJ5IjozNX0seyJ4Ijo2NTYuOTA2MjUsInkiOjM1fSx7IngiOjY4MS45MDYyNSwieSI6MzV9XQ==' data-look='classic' marker-end='url(%23mermaid-4_flowchart-v2-pointEnd)'/><path d='M844.766%2c35L848.932%2c35C853.099%2c35%2c861.432%2c35%2c869.099%2c35C876.766%2c35%2c883.766%2c35%2c887.266%2c35L890.766%2c35' id='mermaid-4-L_D_E_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_D_E_0' data-points='W3sieCI6ODQ0Ljc2NTYyNSwieSI6MzV9LHsieCI6ODY5Ljc2NTYyNSwieSI6MzV9LHsieCI6ODk0Ljc2NTYyNSwieSI6MzV9XQ==' data-look='classic' marker-end='url(%23mermaid-4_flowchart-v2-pointEnd)'/></g><g class='edgeLabels'><g class='edgeLabel'><g class='label' data-id='L_A_B_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_B_C_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_C_D_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_D_E_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g></g><g class='nodes'><g class='node default' id='mermaid-4-flowchart-A-0' data-look='classic' transform='translate(79.8046875%2c 35)'><rect class='basic label-container' style='' x='-71.8046875' y='-27' width='143.609375' height='54'/><g class='label' style='' transform='translate(-41.8046875%2c -12)'><rect/><foreignObject width='83.609375' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>LLM Output</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-4-flowchart-B-1' data-look='classic' transform='translate(292.53125%2c 35)'><rect class='basic label-container' style='' x='-90.921875' y='-27' width='181.84375' height='54'/><g class='label' style='' transform='translate(-60.921875%2c -12)'><rect/><foreignObject width='121.84375' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>Structured Model</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-4-flowchart-C-3' data-look='classic' transform='translate(532.6796875%2c 35)'><rect class='basic label-container' style='' x='-99.2265625' y='-27' width='198.453125' height='54'/><g class='label' style='' transform='translate(-69.2265625%2c -12)'><rect/><foreignObject width='138.453125' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>Business Validation</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-4-flowchart-D-5' data-look='classic' transform='translate(763.3359375%2c 35)'><rect class='basic label-container' style='' x='-81.4296875' y='-27' width='162.859375' height='54'/><g class='label' style='' transform='translate(-51.4296875%2c -12)'><rect/><foreignObject width='102.859375' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>Business DTO</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-4-flowchart-E-7' data-look='classic' transform='translate(948.765625%2c 35)'><rect class='basic label-container' style='' x='-54' y='-27' width='108' height='54'/><g class='label' style='' transform='translate(-24%2c -12)'><rect/><foreignObject width='48' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>业务执行</p></span></div></foreignObject></g></g></g></g></g><defs><filter id='mermaid-4-drop-shadow' height='130%' width='130%'><feDropShadow dx='4' dy='4' stdDeviation='0' flood-opacity='0.06' flood-color='black'/></filter></defs><defs><filter id='mermaid-4-drop-shadow-small' height='150%' width='150%'><feDropShadow dx='2' dy='2' stdDeviation='0' flood-opacity='0.06' flood-color='black'/></filter></defs></svg>)
%3btext-align:center%3b}%23mermaid-dark-4 .edgeLabel p{background-color:hsl(0%2c 0%%2c 34.4117647059%)%3b}%23mermaid-dark-4 .edgeLabel rect{opacity:0.5%3bbackground-color:hsl(0%2c 0%%2c 34.4117647059%)%3bfill:hsl(0%2c 0%%2c 34.4117647059%)%3b}%23mermaid-dark-4 .labelBkg{background-color:rgba(87.75%2c 87.75%2c 87.75%2c 0.5)%3b}%23mermaid-dark-4 .cluster rect{fill:hsl(180%2c 1.5873015873%%2c 28.3529411765%)%3bstroke:rgba(255%2c 255%2c 255%2c 0.25)%3bstroke-width:1px%3b}%23mermaid-dark-4 .cluster text{fill:%23F9FFFE%3b}%23mermaid-dark-4 .cluster span{color:%23F9FFFE%3b}%23mermaid-dark-4 .node .collapsed-indicator{fill:rgba(255%2c 255%2c 255%2c 0.25)%3bstroke:none%3bopacity:0.6%3b}%23mermaid-dark-4 .node .collapsed-separator{stroke:rgba(255%2c 255%2c 255%2c 0.25)%3bstroke-width:0.75px%3b}%23mermaid-dark-4 div.mermaidTooltip{position:absolute%3btext-align:center%3bmax-width:200px%3bpadding:2px%3bfont-family:arial%2csans-serif%3bfont-size:12px%3bbackground:hsl(20%2c 1.5873015873%%2c 12.3529411765%)%3bborder:1px solid rgba(255%2c 255%2c 255%2c 0.25)%3bborder-radius:2px%3bpointer-events:none%3bz-index:100%3b}%23mermaid-dark-4 .flowchartTitleText{text-anchor:middle%3bfont-size:18px%3bfill:%23ccc%3b}%23mermaid-dark-4 rect.text{fill:none%3bstroke-width:0%3b}%23mermaid-dark-4 .icon-shape%2c%23mermaid-dark-4 .image-shape{background-color:hsl(0%2c 0%%2c 34.4117647059%)%3btext-align:center%3b}%23mermaid-dark-4 .icon-shape p%2c%23mermaid-dark-4 .image-shape p{background-color:hsl(0%2c 0%%2c 34.4117647059%)%3bpadding:2px%3b}%23mermaid-dark-4 .icon-shape .label rect%2c%23mermaid-dark-4 .image-shape .label rect{opacity:0.5%3bbackground-color:hsl(0%2c 0%%2c 34.4117647059%)%3bfill:hsl(0%2c 0%%2c 34.4117647059%)%3b}%23mermaid-dark-4 .label-icon{display:inline-block%3bheight:1em%3boverflow:visible%3bvertical-align:-0.125em%3b}%23mermaid-dark-4 .node .label-icon path{fill:currentColor%3bstroke:revert%3bstroke-width:revert%3b}%23mermaid-dark-4 .node .neo-node{stroke:%23ccc%3b}%23mermaid-dark-4 [data-look='neo'].node rect%2c%23mermaid-dark-4 [data-look='neo'].cluster rect%2c%23mermaid-dark-4 [data-look='neo'].node polygon{stroke:url(%23mermaid-dark-4-gradient)%3bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b}%23mermaid-dark-4 [data-look='neo'].swimlane.cluster rect{filter:none%3b}%23mermaid-dark-4 [data-look='neo'].node path{stroke:url(%23mermaid-dark-4-gradient)%3bstroke-width:1px%3b}%23mermaid-dark-4 [data-look='neo'].node .outer-path{filter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b}%23mermaid-dark-4 [data-look='neo'].node .neo-line path{stroke:%23ccc%3bfilter:none%3b}%23mermaid-dark-4 [data-look='neo'].node circle{stroke:url(%23mermaid-dark-4-gradient)%3bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b}%23mermaid-dark-4 [data-look='neo'].node circle .state-start{fill:black%3b}%23mermaid-dark-4 [data-look='neo'].icon-shape .icon{fill:url(%23mermaid-dark-4-gradient)%3bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b}%23mermaid-dark-4 [data-look='neo'].icon-shape .icon-neo path{stroke:url(%23mermaid-dark-4-gradient)%3bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b}%23mermaid-dark-4 :root{--mermaid-font-family:arial%2csans-serif%3b}</style><g><marker id='mermaid-dark-4_flowchart-v2-pointEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'><path d='M 0 0 L 10 5 L 0 10 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-4_flowchart-v2-pointStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='4.5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'><path d='M 0 5 L 10 10 L 10 0 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-4_flowchart-v2-pointEnd-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='11.5' refY='7' markerUnits='userSpaceOnUse' markerWidth='10.5' markerHeight='14' orient='auto'><path d='M 0 0 L 11.5 7 L 0 14 z' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-4_flowchart-v2-pointStart-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='1' refY='7' markerUnits='userSpaceOnUse' markerWidth='11.5' markerHeight='14' orient='auto'><polygon points='0%2c7 11.5%2c14 11.5%2c0' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-4_flowchart-v2-circleEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='11' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-4_flowchart-v2-circleStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-1' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-4_flowchart-v2-circleEnd-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refY='5' refX='12.25' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-4_flowchart-v2-circleStart-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-2' refY='5' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-4_flowchart-v2-crossEnd' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='12' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><path d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-4_flowchart-v2-crossStart' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='-1' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><path d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-4_flowchart-v2-crossEnd-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='17.7' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'><path d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b'/></marker><marker id='mermaid-dark-4_flowchart-v2-crossStart-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='-3.5' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'><path d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b stroke-dasharray: 1%2c 0%3b'/></marker><g class='root'><g class='clusters'/><g class='edgePaths'><path d='M151.609%2c35L155.776%2c35C159.943%2c35%2c168.276%2c35%2c175.943%2c35C183.609%2c35%2c190.609%2c35%2c194.109%2c35L197.609%2c35' id='mermaid-dark-4-L_A_B_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_A_B_0' data-points='W3sieCI6MTUxLjYwOTM3NSwieSI6MzV9LHsieCI6MTc2LjYwOTM3NSwieSI6MzV9LHsieCI6MjAxLjYwOTM3NSwieSI6MzV9XQ==' data-look='classic' marker-end='url(%23mermaid-dark-4_flowchart-v2-pointEnd)'/><path d='M383.453%2c35L387.62%2c35C391.786%2c35%2c400.12%2c35%2c407.786%2c35C415.453%2c35%2c422.453%2c35%2c425.953%2c35L429.453%2c35' id='mermaid-dark-4-L_B_C_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_B_C_0' data-points='W3sieCI6MzgzLjQ1MzEyNSwieSI6MzV9LHsieCI6NDA4LjQ1MzEyNSwieSI6MzV9LHsieCI6NDMzLjQ1MzEyNSwieSI6MzV9XQ==' data-look='classic' marker-end='url(%23mermaid-dark-4_flowchart-v2-pointEnd)'/><path d='M631.906%2c35L636.073%2c35C640.24%2c35%2c648.573%2c35%2c656.24%2c35C663.906%2c35%2c670.906%2c35%2c674.406%2c35L677.906%2c35' id='mermaid-dark-4-L_C_D_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_C_D_0' data-points='W3sieCI6NjMxLjkwNjI1LCJ5IjozNX0seyJ4Ijo2NTYuOTA2MjUsInkiOjM1fSx7IngiOjY4MS45MDYyNSwieSI6MzV9XQ==' data-look='classic' marker-end='url(%23mermaid-dark-4_flowchart-v2-pointEnd)'/><path d='M844.766%2c35L848.932%2c35C853.099%2c35%2c861.432%2c35%2c869.099%2c35C876.766%2c35%2c883.766%2c35%2c887.266%2c35L890.766%2c35' id='mermaid-dark-4-L_D_E_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_D_E_0' data-points='W3sieCI6ODQ0Ljc2NTYyNSwieSI6MzV9LHsieCI6ODY5Ljc2NTYyNSwieSI6MzV9LHsieCI6ODk0Ljc2NTYyNSwieSI6MzV9XQ==' data-look='classic' marker-end='url(%23mermaid-dark-4_flowchart-v2-pointEnd)'/></g><g class='edgeLabels'><g class='edgeLabel'><g class='label' data-id='L_A_B_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_B_C_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_C_D_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_D_E_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g></g><g class='nodes'><g class='node default' id='mermaid-dark-4-flowchart-A-0' data-look='classic' transform='translate(79.8046875%2c 35)'><rect class='basic label-container' style='' x='-71.8046875' y='-27' width='143.609375' height='54'/><g class='label' style='' transform='translate(-41.8046875%2c -12)'><rect/><foreignObject width='83.609375' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>LLM Output</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-dark-4-flowchart-B-1' data-look='classic' transform='translate(292.53125%2c 35)'><rect class='basic label-container' style='' x='-90.921875' y='-27' width='181.84375' height='54'/><g class='label' style='' transform='translate(-60.921875%2c -12)'><rect/><foreignObject width='121.84375' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>Structured Model</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-dark-4-flowchart-C-3' data-look='classic' transform='translate(532.6796875%2c 35)'><rect class='basic label-container' style='' x='-99.2265625' y='-27' width='198.453125' height='54'/><g class='label' style='' transform='translate(-69.2265625%2c -12)'><rect/><foreignObject width='138.453125' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>Business Validation</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-dark-4-flowchart-D-5' data-look='classic' transform='translate(763.3359375%2c 35)'><rect class='basic label-container' style='' x='-81.4296875' y='-27' width='162.859375' height='54'/><g class='label' style='' transform='translate(-51.4296875%2c -12)'><rect/><foreignObject width='102.859375' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>Business DTO</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-dark-4-flowchart-E-7' data-look='classic' transform='translate(948.765625%2c 35)'><rect class='basic label-container' style='' x='-54' y='-27' width='108' height='54'/><g class='label' style='' transform='translate(-24%2c -12)'><rect/><foreignObject width='48' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>业务执行</p></span></div></foreignObject></g></g></g></g></g><defs><filter id='mermaid-dark-4-drop-shadow' height='130%' width='130%'><feDropShadow dx='4' dy='4' stdDeviation='0' flood-opacity='0.06' flood-color='white'/></filter></defs><defs><filter id='mermaid-dark-4-drop-shadow-small' height='150%' width='150%'><feDropShadow dx='2' dy='2' stdDeviation='0' flood-opacity='0.06' flood-color='white'/></filter></defs><linearGradient id='mermaid-dark-4-gradient' gradientUnits='objectBoundingBox' x1='0%' y1='0%' x2='100%' y2='0%'><stop offset='0%' stop-color='%23cccccc' stop-opacity='1'/><stop offset='100%' stop-color='hsl(180%2c 0%%2c 18.3529411765%)' stop-opacity='1'/></linearGradient></svg>)
这种边界可以防止 AI 层模型和核心业务过度耦合,也方便以后替换模型或修改提示词。
管理 Schema 版本
当结构化输出被多个模块消费以后,Schema 就成为接口协议。增加必填字段可能影响所有下游消费者,因此可以像传统 API 一样管理版本:
class FaultAnalysisV1(BaseModel):
    category: FaultCategory
    severity: Severity
    summary: str


class FaultAnalysisV2(BaseModel):
    category: FaultCategory
    severity: Severity
    summary: str
    root_cause: str
    suggestion: str
Prompt 是模型行为配置,Schema 是程序接口,两者生命周期并不相同。不要因为调整 Prompt 就频繁改变 Schema。
完整示例:工单智能分类
假设系统需要从用户工单中提取类别、严重程度、摘要、处理团队以及是否需要人工介入。
先定义类型:
from enum import Enum

from pydantic import BaseModel


class TicketCategory(str, Enum):
    DATABASE = "DATABASE"
    NETWORK = "NETWORK"
    APPLICATION = "APPLICATION"
    ACCOUNT = "ACCOUNT"
    UNKNOWN = "UNKNOWN"


class Severity(str, Enum):
    LOW = "LOW"
    MEDIUM = "MEDIUM"
    HIGH = "HIGH"


class Team(str, Enum):
    DBA = "DBA"
    NETWORK = "NETWORK"
    BACKEND = "BACKEND"
    SUPPORT = "SUPPORT"


class TicketAnalysis(BaseModel):
    category: TicketCategory
    severity: Severity
    summary: str
    need_manual_review: bool
    team: Team
然后建立模型服务:
from openai import OpenAI


class TicketClassifier:
    def __init__(self) -> None:
        self.client = OpenAI()
        self.model = "gpt-5.4"

    def classify(self, content: str) -> TicketAnalysis:
        response = self.client.responses.parse(
            model=self.model,
            instructions="""
            你是企业技术支持工单分类组件。

            DATABASE:SQL、数据库连接、连接池、性能和事务问题。
            NETWORK:DNS、HTTP、TCP、路由和网络连通性问题。
            APPLICATION:后端服务代码、运行时异常和应用逻辑错误。
            ACCOUNT:用户、账号、登录和权限问题。
            UNKNOWN:无法确定类别。

            LOW:不影响主要业务。
            MEDIUM:影响部分用户或部分功能。
            HIGH:大量请求失败、核心功能不可用,或存在持续影响。
            """,
            input=content,
            text_format=TicketAnalysis,
        )

        result = response.output_parsed
        if result is None:
            raise RuntimeError("工单分类失败")

        return result
业务代码调用:
classifier = TicketClassifier()

result = classifier.classify(
    """
    应用今天下午开始大量报错,数据库连接经常超时,
    重启服务后只能恢复几分钟,随后又出现同样问题。
    """
)

if result.need_manual_review:
    create_manual_ticket()

if result.team == Team.DBA:
    assign_to_dba()

if result.severity == Severity.HIGH:
    create_high_priority_alarm()
模型返回的不再是一段需要重新解析的文字,而是可以直接交给业务校验层处理的 TicketAnalysis 对象。
Structured Outputs 与 Function Calling
Structured Outputs 和 Function Calling 都会使用 Schema,但职责不同。
| 能力 | 解决的问题 | 示例 |
|---|---|---|
| Structured Outputs | 模型最终返回什么结构的数据 | 返回工单分类结果 |
| Function Calling | 模型需要调用什么函数及传入哪些参数 | 调用 create_ticket(...) |
如果目标是让模型最终返回可供程序消费的数据,使用 Structured Outputs;如果目标是让模型连接应用功能、数据库或外部工具,使用 Function Calling。
%3btext-align:center%3b}%23mermaid-5 .edgeLabel p{background-color:rgba(232%2c232%2c232%2c 0.8)%3b}%23mermaid-5 .edgeLabel rect{opacity:0.5%3bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bfill:rgba(232%2c232%2c232%2c 0.8)%3b}%23mermaid-5 .labelBkg{background-color:rgba(232%2c 232%2c 232%2c 0.5)%3b}%23mermaid-5 .cluster rect{fill:%23ffffde%3bstroke:%23aaaa33%3bstroke-width:1px%3b}%23mermaid-5 .cluster text{fill:%23333%3b}%23mermaid-5 .cluster span{color:%23333%3b}%23mermaid-5 .node .collapsed-indicator{fill:%23aaaa33%3bstroke:none%3bopacity:0.6%3b}%23mermaid-5 .node .collapsed-separator{stroke:%23aaaa33%3bstroke-width:0.75px%3b}%23mermaid-5 div.mermaidTooltip{position:absolute%3btext-align:center%3bmax-width:200px%3bpadding:2px%3bfont-family:arial%2csans-serif%3bfont-size:12px%3bbackground:hsl(80%2c 100%%2c 96.2745098039%)%3bborder:1px solid %23aaaa33%3bborder-radius:2px%3bpointer-events:none%3bz-index:100%3b}%23mermaid-5 .flowchartTitleText{text-anchor:middle%3bfont-size:18px%3bfill:%23333%3b}%23mermaid-5 rect.text{fill:none%3bstroke-width:0%3b}%23mermaid-5 .icon-shape%2c%23mermaid-5 .image-shape{background-color:rgba(232%2c232%2c232%2c 0.8)%3btext-align:center%3b}%23mermaid-5 .icon-shape p%2c%23mermaid-5 .image-shape p{background-color:rgba(232%2c232%2c232%2c 0.8)%3bpadding:2px%3b}%23mermaid-5 .icon-shape .label rect%2c%23mermaid-5 .image-shape .label rect{opacity:0.5%3bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bfill:rgba(232%2c232%2c232%2c 0.8)%3b}%23mermaid-5 .label-icon{display:inline-block%3bheight:1em%3boverflow:visible%3bvertical-align:-0.125em%3b}%23mermaid-5 .node .label-icon path{fill:currentColor%3bstroke:revert%3bstroke-width:revert%3b}%23mermaid-5 .node .neo-node{stroke:%239370DB%3b}%23mermaid-5 [data-look='neo'].node rect%2c%23mermaid-5 [data-look='neo'].cluster rect%2c%23mermaid-5 [data-look='neo'].node polygon{stroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b}%23mermaid-5 [data-look='neo'].swimlane.cluster rect{filter:none%3b}%23mermaid-5 [data-look='neo'].node path{stroke:%239370DB%3bstroke-width:1px%3b}%23mermaid-5 [data-look='neo'].node .outer-path{filter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b}%23mermaid-5 [data-look='neo'].node .neo-line path{stroke:%239370DB%3bfilter:none%3b}%23mermaid-5 [data-look='neo'].node circle{stroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b}%23mermaid-5 [data-look='neo'].node circle .state-start{fill:black%3b}%23mermaid-5 [data-look='neo'].icon-shape .icon{fill:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b}%23mermaid-5 [data-look='neo'].icon-shape .icon-neo path{stroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b}%23mermaid-5 :root{--mermaid-font-family:arial%2csans-serif%3b}</style><g><marker id='mermaid-5_flowchart-v2-pointEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'><path d='M 0 0 L 10 5 L 0 10 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-5_flowchart-v2-pointStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='4.5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'><path d='M 0 5 L 10 10 L 10 0 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-5_flowchart-v2-pointEnd-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='11.5' refY='7' markerUnits='userSpaceOnUse' markerWidth='10.5' markerHeight='14' orient='auto'><path d='M 0 0 L 11.5 7 L 0 14 z' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-5_flowchart-v2-pointStart-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='1' refY='7' markerUnits='userSpaceOnUse' markerWidth='11.5' markerHeight='14' orient='auto'><polygon points='0%2c7 11.5%2c14 11.5%2c0' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-5_flowchart-v2-circleEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='11' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-5_flowchart-v2-circleStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-1' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-5_flowchart-v2-circleEnd-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refY='5' refX='12.25' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-5_flowchart-v2-circleStart-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-2' refY='5' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-5_flowchart-v2-crossEnd' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='12' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><path d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-5_flowchart-v2-crossStart' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='-1' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><path d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-5_flowchart-v2-crossEnd-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='17.7' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'><path d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b'/></marker><marker id='mermaid-5_flowchart-v2-crossStart-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='-3.5' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'><path d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b stroke-dasharray: 1%2c 0%3b'/></marker><g class='root'><g class='clusters'/><g class='edgePaths'><path d='M222.406%2c62L222.406%2c66.167C222.406%2c70.333%2c222.406%2c78.667%2c222.406%2c86.333C222.406%2c94%2c222.406%2c101%2c222.406%2c104.5L222.406%2c108' id='mermaid-5-L_A_B_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_A_B_0' data-points='W3sieCI6MjIyLjQwNjI1LCJ5Ijo2Mn0seyJ4IjoyMjIuNDA2MjUsInkiOjg3fSx7IngiOjIyMi40MDYyNSwieSI6MTEyfV0=' data-look='classic' marker-end='url(%23mermaid-5_flowchart-v2-pointEnd)'/><path d='M189.001%2c201.501L175.026%2c213.235C161.05%2c224.969%2c133.099%2c248.438%2c119.124%2c265.672C105.148%2c282.906%2c105.148%2c293.906%2c105.148%2c299.406L105.148%2c304.906' id='mermaid-5-L_B_C_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_B_C_0' data-points='W3sieCI6MTg5LjAwMTA4NzA4OTM4NDY3LCJ5IjoyMDEuNTAxMDg3MDg5Mzg0Njd9LHsieCI6MTA1LjE0ODQzNzUsInkiOjI3MS45MDYyNX0seyJ4IjoxMDUuMTQ4NDM3NSwieSI6MzA4LjkwNjI1fV0=' data-look='classic' marker-end='url(%23mermaid-5_flowchart-v2-pointEnd)'/><path d='M255.811%2c201.501L269.787%2c213.235C283.762%2c224.969%2c311.713%2c248.438%2c325.689%2c265.672C339.664%2c282.906%2c339.664%2c293.906%2c339.664%2c299.406L339.664%2c304.906' id='mermaid-5-L_B_D_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_B_D_0' data-points='W3sieCI6MjU1LjgxMTQxMjkxMDYxNTMzLCJ5IjoyMDEuNTAxMDg3MDg5Mzg0Njd9LHsieCI6MzM5LjY2NDA2MjUsInkiOjI3MS45MDYyNX0seyJ4IjozMzkuNjY0MDYyNSwieSI6MzA4LjkwNjI1fV0=' data-look='classic' marker-end='url(%23mermaid-5_flowchart-v2-pointEnd)'/><path d='M105.148%2c362.906L105.148%2c367.073C105.148%2c371.24%2c105.148%2c379.573%2c105.148%2c387.24C105.148%2c394.906%2c105.148%2c401.906%2c105.148%2c405.406L105.148%2c408.906' id='mermaid-5-L_C_E_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_C_E_0' data-points='W3sieCI6MTA1LjE0ODQzNzUsInkiOjM2Mi45MDYyNX0seyJ4IjoxMDUuMTQ4NDM3NSwieSI6Mzg3LjkwNjI1fSx7IngiOjEwNS4xNDg0Mzc1LCJ5Ijo0MTIuOTA2MjV9XQ==' data-look='classic' marker-end='url(%23mermaid-5_flowchart-v2-pointEnd)'/><path d='M339.664%2c362.906L339.664%2c367.073C339.664%2c371.24%2c339.664%2c379.573%2c339.664%2c387.24C339.664%2c394.906%2c339.664%2c401.906%2c339.664%2c405.406L339.664%2c408.906' id='mermaid-5-L_D_F_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_D_F_0' data-points='W3sieCI6MzM5LjY2NDA2MjUsInkiOjM2Mi45MDYyNX0seyJ4IjozMzkuNjY0MDYyNSwieSI6Mzg3LjkwNjI1fSx7IngiOjMzOS42NjQwNjI1LCJ5Ijo0MTIuOTA2MjV9XQ==' data-look='classic' marker-end='url(%23mermaid-5_flowchart-v2-pointEnd)'/></g><g class='edgeLabels'><g class='edgeLabel'><g class='label' data-id='L_A_B_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel' transform='translate(105.1484375%2c 271.90625)'><g class='label' data-id='L_B_C_0' transform='translate(-42%2c -12)'><foreignObject width='84' height='24'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'><p>返回结构化结果</p></span></div></foreignObject></g></g><g class='edgeLabel' transform='translate(339.6640625%2c 271.90625)'><g class='label' data-id='L_B_D_0' transform='translate(-36%2c -12)'><foreignObject width='72' height='24'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'><p>调用程序能力</p></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_C_E_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_D_F_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g></g><g class='nodes'><g class='node default' id='mermaid-5-flowchart-A-0' data-look='classic' transform='translate(222.40625%2c 35)'><rect class='basic label-container' style='' x='-54' y='-27' width='108' height='54'/><g class='label' style='' transform='translate(-24%2c -12)'><rect/><foreignObject width='48' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>用户请求</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-5-flowchart-B-1' data-look='classic' transform='translate(222.40625%2c 173.453125)'><polygon points='61.453125%2c0 122.90625%2c-61.453125 61.453125%2c-122.90625 0%2c-61.453125' class='label-container' transform='translate(-60.953125%2c 61.453125)'/><g class='label' style='' transform='translate(-34.453125%2c -12)'><rect/><foreignObject width='68.90625' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>目标是什么%3f</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-5-flowchart-C-3' data-look='classic' transform='translate(105.1484375%2c 335.90625)'><rect class='basic label-container' style='' x='-97.1484375' y='-27' width='194.296875' height='54'/><g class='label' style='' transform='translate(-67.1484375%2c -12)'><rect/><foreignObject width='134.296875' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>Structured Outputs</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-5-flowchart-D-5' data-look='classic' transform='translate(339.6640625%2c 335.90625)'><rect class='basic label-container' style='' x='-87.3671875' y='-27' width='174.734375' height='54'/><g class='label' style='' transform='translate(-57.3671875%2c -12)'><rect/><foreignObject width='114.734375' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>Function Calling</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-5-flowchart-E-7' data-look='classic' transform='translate(105.1484375%2c 439.90625)'><rect class='basic label-container' style='' x='-78' y='-27' width='156' height='54'/><g class='label' style='' transform='translate(-48%2c -12)'><rect/><foreignObject width='96' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>业务代码消费数据</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-5-flowchart-F-9' data-look='classic' transform='translate(339.6640625%2c 439.90625)'><rect class='basic label-container' style='' x='-84' y='-27' width='168' height='54'/><g class='label' style='' transform='translate(-54%2c -12)'><rect/><foreignObject width='108' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>应用校验并执行工具</p></span></div></foreignObject></g></g></g></g></g><defs><filter id='mermaid-5-drop-shadow' height='130%' width='130%'><feDropShadow dx='4' dy='4' stdDeviation='0' flood-opacity='0.06' flood-color='black'/></filter></defs><defs><filter id='mermaid-5-drop-shadow-small' height='150%' width='150%'><feDropShadow dx='2' dy='2' stdDeviation='0' flood-opacity='0.06' flood-color='black'/></filter></defs></svg>)
%3btext-align:center%3b}%23mermaid-dark-5 .edgeLabel p{background-color:hsl(0%2c 0%%2c 34.4117647059%)%3b}%23mermaid-dark-5 .edgeLabel rect{opacity:0.5%3bbackground-color:hsl(0%2c 0%%2c 34.4117647059%)%3bfill:hsl(0%2c 0%%2c 34.4117647059%)%3b}%23mermaid-dark-5 .labelBkg{background-color:rgba(87.75%2c 87.75%2c 87.75%2c 0.5)%3b}%23mermaid-dark-5 .cluster rect{fill:hsl(180%2c 1.5873015873%%2c 28.3529411765%)%3bstroke:rgba(255%2c 255%2c 255%2c 0.25)%3bstroke-width:1px%3b}%23mermaid-dark-5 .cluster text{fill:%23F9FFFE%3b}%23mermaid-dark-5 .cluster span{color:%23F9FFFE%3b}%23mermaid-dark-5 .node .collapsed-indicator{fill:rgba(255%2c 255%2c 255%2c 0.25)%3bstroke:none%3bopacity:0.6%3b}%23mermaid-dark-5 .node .collapsed-separator{stroke:rgba(255%2c 255%2c 255%2c 0.25)%3bstroke-width:0.75px%3b}%23mermaid-dark-5 div.mermaidTooltip{position:absolute%3btext-align:center%3bmax-width:200px%3bpadding:2px%3bfont-family:arial%2csans-serif%3bfont-size:12px%3bbackground:hsl(20%2c 1.5873015873%%2c 12.3529411765%)%3bborder:1px solid rgba(255%2c 255%2c 255%2c 0.25)%3bborder-radius:2px%3bpointer-events:none%3bz-index:100%3b}%23mermaid-dark-5 .flowchartTitleText{text-anchor:middle%3bfont-size:18px%3bfill:%23ccc%3b}%23mermaid-dark-5 rect.text{fill:none%3bstroke-width:0%3b}%23mermaid-dark-5 .icon-shape%2c%23mermaid-dark-5 .image-shape{background-color:hsl(0%2c 0%%2c 34.4117647059%)%3btext-align:center%3b}%23mermaid-dark-5 .icon-shape p%2c%23mermaid-dark-5 .image-shape p{background-color:hsl(0%2c 0%%2c 34.4117647059%)%3bpadding:2px%3b}%23mermaid-dark-5 .icon-shape .label rect%2c%23mermaid-dark-5 .image-shape .label rect{opacity:0.5%3bbackground-color:hsl(0%2c 0%%2c 34.4117647059%)%3bfill:hsl(0%2c 0%%2c 34.4117647059%)%3b}%23mermaid-dark-5 .label-icon{display:inline-block%3bheight:1em%3boverflow:visible%3bvertical-align:-0.125em%3b}%23mermaid-dark-5 .node .label-icon path{fill:currentColor%3bstroke:revert%3bstroke-width:revert%3b}%23mermaid-dark-5 .node .neo-node{stroke:%23ccc%3b}%23mermaid-dark-5 [data-look='neo'].node rect%2c%23mermaid-dark-5 [data-look='neo'].cluster rect%2c%23mermaid-dark-5 [data-look='neo'].node polygon{stroke:url(%23mermaid-dark-5-gradient)%3bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b}%23mermaid-dark-5 [data-look='neo'].swimlane.cluster rect{filter:none%3b}%23mermaid-dark-5 [data-look='neo'].node path{stroke:url(%23mermaid-dark-5-gradient)%3bstroke-width:1px%3b}%23mermaid-dark-5 [data-look='neo'].node .outer-path{filter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b}%23mermaid-dark-5 [data-look='neo'].node .neo-line path{stroke:%23ccc%3bfilter:none%3b}%23mermaid-dark-5 [data-look='neo'].node circle{stroke:url(%23mermaid-dark-5-gradient)%3bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b}%23mermaid-dark-5 [data-look='neo'].node circle .state-start{fill:black%3b}%23mermaid-dark-5 [data-look='neo'].icon-shape .icon{fill:url(%23mermaid-dark-5-gradient)%3bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b}%23mermaid-dark-5 [data-look='neo'].icon-shape .icon-neo path{stroke:url(%23mermaid-dark-5-gradient)%3bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b}%23mermaid-dark-5 :root{--mermaid-font-family:arial%2csans-serif%3b}</style><g><marker id='mermaid-dark-5_flowchart-v2-pointEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'><path d='M 0 0 L 10 5 L 0 10 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-5_flowchart-v2-pointStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='4.5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'><path d='M 0 5 L 10 10 L 10 0 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-5_flowchart-v2-pointEnd-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='11.5' refY='7' markerUnits='userSpaceOnUse' markerWidth='10.5' markerHeight='14' orient='auto'><path d='M 0 0 L 11.5 7 L 0 14 z' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-5_flowchart-v2-pointStart-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='1' refY='7' markerUnits='userSpaceOnUse' markerWidth='11.5' markerHeight='14' orient='auto'><polygon points='0%2c7 11.5%2c14 11.5%2c0' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-5_flowchart-v2-circleEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='11' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-5_flowchart-v2-circleStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-1' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-5_flowchart-v2-circleEnd-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refY='5' refX='12.25' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-5_flowchart-v2-circleStart-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-2' refY='5' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-5_flowchart-v2-crossEnd' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='12' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><path d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-5_flowchart-v2-crossStart' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='-1' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><path d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-5_flowchart-v2-crossEnd-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='17.7' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'><path d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b'/></marker><marker id='mermaid-dark-5_flowchart-v2-crossStart-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='-3.5' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'><path d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b stroke-dasharray: 1%2c 0%3b'/></marker><g class='root'><g class='clusters'/><g class='edgePaths'><path d='M222.406%2c62L222.406%2c66.167C222.406%2c70.333%2c222.406%2c78.667%2c222.406%2c86.333C222.406%2c94%2c222.406%2c101%2c222.406%2c104.5L222.406%2c108' id='mermaid-dark-5-L_A_B_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_A_B_0' data-points='W3sieCI6MjIyLjQwNjI1LCJ5Ijo2Mn0seyJ4IjoyMjIuNDA2MjUsInkiOjg3fSx7IngiOjIyMi40MDYyNSwieSI6MTEyfV0=' data-look='classic' marker-end='url(%23mermaid-dark-5_flowchart-v2-pointEnd)'/><path d='M189.001%2c201.501L175.026%2c213.235C161.05%2c224.969%2c133.099%2c248.438%2c119.124%2c265.672C105.148%2c282.906%2c105.148%2c293.906%2c105.148%2c299.406L105.148%2c304.906' id='mermaid-dark-5-L_B_C_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_B_C_0' data-points='W3sieCI6MTg5LjAwMTA4NzA4OTM4NDY3LCJ5IjoyMDEuNTAxMDg3MDg5Mzg0Njd9LHsieCI6MTA1LjE0ODQzNzUsInkiOjI3MS45MDYyNX0seyJ4IjoxMDUuMTQ4NDM3NSwieSI6MzA4LjkwNjI1fV0=' data-look='classic' marker-end='url(%23mermaid-dark-5_flowchart-v2-pointEnd)'/><path d='M255.811%2c201.501L269.787%2c213.235C283.762%2c224.969%2c311.713%2c248.438%2c325.689%2c265.672C339.664%2c282.906%2c339.664%2c293.906%2c339.664%2c299.406L339.664%2c304.906' id='mermaid-dark-5-L_B_D_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_B_D_0' data-points='W3sieCI6MjU1LjgxMTQxMjkxMDYxNTMzLCJ5IjoyMDEuNTAxMDg3MDg5Mzg0Njd9LHsieCI6MzM5LjY2NDA2MjUsInkiOjI3MS45MDYyNX0seyJ4IjozMzkuNjY0MDYyNSwieSI6MzA4LjkwNjI1fV0=' data-look='classic' marker-end='url(%23mermaid-dark-5_flowchart-v2-pointEnd)'/><path d='M105.148%2c362.906L105.148%2c367.073C105.148%2c371.24%2c105.148%2c379.573%2c105.148%2c387.24C105.148%2c394.906%2c105.148%2c401.906%2c105.148%2c405.406L105.148%2c408.906' id='mermaid-dark-5-L_C_E_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_C_E_0' data-points='W3sieCI6MTA1LjE0ODQzNzUsInkiOjM2Mi45MDYyNX0seyJ4IjoxMDUuMTQ4NDM3NSwieSI6Mzg3LjkwNjI1fSx7IngiOjEwNS4xNDg0Mzc1LCJ5Ijo0MTIuOTA2MjV9XQ==' data-look='classic' marker-end='url(%23mermaid-dark-5_flowchart-v2-pointEnd)'/><path d='M339.664%2c362.906L339.664%2c367.073C339.664%2c371.24%2c339.664%2c379.573%2c339.664%2c387.24C339.664%2c394.906%2c339.664%2c401.906%2c339.664%2c405.406L339.664%2c408.906' id='mermaid-dark-5-L_D_F_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_D_F_0' data-points='W3sieCI6MzM5LjY2NDA2MjUsInkiOjM2Mi45MDYyNX0seyJ4IjozMzkuNjY0MDYyNSwieSI6Mzg3LjkwNjI1fSx7IngiOjMzOS42NjQwNjI1LCJ5Ijo0MTIuOTA2MjV9XQ==' data-look='classic' marker-end='url(%23mermaid-dark-5_flowchart-v2-pointEnd)'/></g><g class='edgeLabels'><g class='edgeLabel'><g class='label' data-id='L_A_B_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel' transform='translate(105.1484375%2c 271.90625)'><g class='label' data-id='L_B_C_0' transform='translate(-42%2c -12)'><foreignObject width='84' height='24'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'><p>返回结构化结果</p></span></div></foreignObject></g></g><g class='edgeLabel' transform='translate(339.6640625%2c 271.90625)'><g class='label' data-id='L_B_D_0' transform='translate(-36%2c -12)'><foreignObject width='72' height='24'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'><p>调用程序能力</p></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_C_E_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_D_F_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g></g><g class='nodes'><g class='node default' id='mermaid-dark-5-flowchart-A-0' data-look='classic' transform='translate(222.40625%2c 35)'><rect class='basic label-container' style='' x='-54' y='-27' width='108' height='54'/><g class='label' style='' transform='translate(-24%2c -12)'><rect/><foreignObject width='48' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>用户请求</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-dark-5-flowchart-B-1' data-look='classic' transform='translate(222.40625%2c 173.453125)'><polygon points='61.453125%2c0 122.90625%2c-61.453125 61.453125%2c-122.90625 0%2c-61.453125' class='label-container' transform='translate(-60.953125%2c 61.453125)'/><g class='label' style='' transform='translate(-34.453125%2c -12)'><rect/><foreignObject width='68.90625' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>目标是什么%3f</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-dark-5-flowchart-C-3' data-look='classic' transform='translate(105.1484375%2c 335.90625)'><rect class='basic label-container' style='' x='-97.1484375' y='-27' width='194.296875' height='54'/><g class='label' style='' transform='translate(-67.1484375%2c -12)'><rect/><foreignObject width='134.296875' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>Structured Outputs</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-dark-5-flowchart-D-5' data-look='classic' transform='translate(339.6640625%2c 335.90625)'><rect class='basic label-container' style='' x='-87.3671875' y='-27' width='174.734375' height='54'/><g class='label' style='' transform='translate(-57.3671875%2c -12)'><rect/><foreignObject width='114.734375' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>Function Calling</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-dark-5-flowchart-E-7' data-look='classic' transform='translate(105.1484375%2c 439.90625)'><rect class='basic label-container' style='' x='-78' y='-27' width='156' height='54'/><g class='label' style='' transform='translate(-48%2c -12)'><rect/><foreignObject width='96' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>业务代码消费数据</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-dark-5-flowchart-F-9' data-look='classic' transform='translate(339.6640625%2c 439.90625)'><rect class='basic label-container' style='' x='-84' y='-27' width='168' height='54'/><g class='label' style='' transform='translate(-54%2c -12)'><rect/><foreignObject width='108' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>应用校验并执行工具</p></span></div></foreignObject></g></g></g></g></g><defs><filter id='mermaid-dark-5-drop-shadow' height='130%' width='130%'><feDropShadow dx='4' dy='4' stdDeviation='0' flood-opacity='0.06' flood-color='white'/></filter></defs><defs><filter id='mermaid-dark-5-drop-shadow-small' height='150%' width='150%'><feDropShadow dx='2' dy='2' stdDeviation='0' flood-opacity='0.06' flood-color='white'/></filter></defs><linearGradient id='mermaid-dark-5-gradient' gradientUnits='objectBoundingBox' x1='0%' y1='0%' x2='100%' y2='0%'><stop offset='0%' stop-color='%23cccccc' stop-opacity='1'/><stop offset='100%' stop-color='hsl(180%2c 0%%2c 18.3529411765%)' stop-opacity='1'/></linearGradient></svg>)
两种能力也可以组合:模型先通过 Function Calling 请求查询数据,应用执行工具后,再让模型以 Structured Outputs 返回最终结果。
总结
仅在 Prompt 中写“请严格返回 JSON”,无法建立可靠的数据契约。Structured Outputs 的价值在于把概率性的自然语言输出约束为具有确定结构的数据对象。
在 Python 项目中,一条清晰的实践路径是:
%3btext-align:center%3b}%23mermaid-6 .edgeLabel p{background-color:rgba(232%2c232%2c232%2c 0.8)%3b}%23mermaid-6 .edgeLabel rect{opacity:0.5%3bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bfill:rgba(232%2c232%2c232%2c 0.8)%3b}%23mermaid-6 .labelBkg{background-color:rgba(232%2c 232%2c 232%2c 0.5)%3b}%23mermaid-6 .cluster rect{fill:%23ffffde%3bstroke:%23aaaa33%3bstroke-width:1px%3b}%23mermaid-6 .cluster text{fill:%23333%3b}%23mermaid-6 .cluster span{color:%23333%3b}%23mermaid-6 .node .collapsed-indicator{fill:%23aaaa33%3bstroke:none%3bopacity:0.6%3b}%23mermaid-6 .node .collapsed-separator{stroke:%23aaaa33%3bstroke-width:0.75px%3b}%23mermaid-6 div.mermaidTooltip{position:absolute%3btext-align:center%3bmax-width:200px%3bpadding:2px%3bfont-family:arial%2csans-serif%3bfont-size:12px%3bbackground:hsl(80%2c 100%%2c 96.2745098039%)%3bborder:1px solid %23aaaa33%3bborder-radius:2px%3bpointer-events:none%3bz-index:100%3b}%23mermaid-6 .flowchartTitleText{text-anchor:middle%3bfont-size:18px%3bfill:%23333%3b}%23mermaid-6 rect.text{fill:none%3bstroke-width:0%3b}%23mermaid-6 .icon-shape%2c%23mermaid-6 .image-shape{background-color:rgba(232%2c232%2c232%2c 0.8)%3btext-align:center%3b}%23mermaid-6 .icon-shape p%2c%23mermaid-6 .image-shape p{background-color:rgba(232%2c232%2c232%2c 0.8)%3bpadding:2px%3b}%23mermaid-6 .icon-shape .label rect%2c%23mermaid-6 .image-shape .label rect{opacity:0.5%3bbackground-color:rgba(232%2c232%2c232%2c 0.8)%3bfill:rgba(232%2c232%2c232%2c 0.8)%3b}%23mermaid-6 .label-icon{display:inline-block%3bheight:1em%3boverflow:visible%3bvertical-align:-0.125em%3b}%23mermaid-6 .node .label-icon path{fill:currentColor%3bstroke:revert%3bstroke-width:revert%3b}%23mermaid-6 .node .neo-node{stroke:%239370DB%3b}%23mermaid-6 [data-look='neo'].node rect%2c%23mermaid-6 [data-look='neo'].cluster rect%2c%23mermaid-6 [data-look='neo'].node polygon{stroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b}%23mermaid-6 [data-look='neo'].swimlane.cluster rect{filter:none%3b}%23mermaid-6 [data-look='neo'].node path{stroke:%239370DB%3bstroke-width:1px%3b}%23mermaid-6 [data-look='neo'].node .outer-path{filter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b}%23mermaid-6 [data-look='neo'].node .neo-line path{stroke:%239370DB%3bfilter:none%3b}%23mermaid-6 [data-look='neo'].node circle{stroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b}%23mermaid-6 [data-look='neo'].node circle .state-start{fill:black%3b}%23mermaid-6 [data-look='neo'].icon-shape .icon{fill:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b}%23mermaid-6 [data-look='neo'].icon-shape .icon-neo path{stroke:%239370DB%3bfilter:drop-shadow(1px 2px 2px rgba(185%2c 185%2c 185%2c 1))%3b}%23mermaid-6 :root{--mermaid-font-family:arial%2csans-serif%3b}</style><g><marker id='mermaid-6_flowchart-v2-pointEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'><path d='M 0 0 L 10 5 L 0 10 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-6_flowchart-v2-pointStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='4.5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'><path d='M 0 5 L 10 10 L 10 0 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-6_flowchart-v2-pointEnd-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='11.5' refY='7' markerUnits='userSpaceOnUse' markerWidth='10.5' markerHeight='14' orient='auto'><path d='M 0 0 L 11.5 7 L 0 14 z' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-6_flowchart-v2-pointStart-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='1' refY='7' markerUnits='userSpaceOnUse' markerWidth='11.5' markerHeight='14' orient='auto'><polygon points='0%2c7 11.5%2c14 11.5%2c0' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-6_flowchart-v2-circleEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='11' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-6_flowchart-v2-circleStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-1' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-6_flowchart-v2-circleEnd-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refY='5' refX='12.25' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-6_flowchart-v2-circleStart-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-2' refY='5' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-6_flowchart-v2-crossEnd' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='12' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><path d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-6_flowchart-v2-crossStart' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='-1' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><path d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-6_flowchart-v2-crossEnd-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='17.7' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'><path d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b'/></marker><marker id='mermaid-6_flowchart-v2-crossStart-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='-3.5' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'><path d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b stroke-dasharray: 1%2c 0%3b'/></marker><g class='root'><g class='clusters'/><g class='edgePaths'><path d='M177.391%2c35L181.557%2c35C185.724%2c35%2c194.057%2c35%2c201.724%2c35C209.391%2c35%2c216.391%2c35%2c219.891%2c35L223.391%2c35' id='mermaid-6-L_A_B_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_A_B_0' data-points='W3sieCI6MTc3LjM5MDYyNSwieSI6MzV9LHsieCI6MjAyLjM5MDYyNSwieSI6MzV9LHsieCI6MjI3LjM5MDYyNSwieSI6MzV9XQ==' data-look='classic' marker-end='url(%23mermaid-6_flowchart-v2-pointEnd)'/><path d='M396.797%2c35L400.964%2c35C405.13%2c35%2c413.464%2c35%2c421.13%2c35C428.797%2c35%2c435.797%2c35%2c439.297%2c35L442.797%2c35' id='mermaid-6-L_B_C_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_B_C_0' data-points='W3sieCI6Mzk2Ljc5Njg3NSwieSI6MzV9LHsieCI6NDIxLjc5Njg3NSwieSI6MzV9LHsieCI6NDQ2Ljc5Njg3NSwieSI6MzV9XQ==' data-look='classic' marker-end='url(%23mermaid-6_flowchart-v2-pointEnd)'/><path d='M633.094%2c35L637.26%2c35C641.427%2c35%2c649.76%2c35%2c657.427%2c35C665.094%2c35%2c672.094%2c35%2c675.594%2c35L679.094%2c35' id='mermaid-6-L_C_D_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_C_D_0' data-points='W3sieCI6NjMzLjA5Mzc1LCJ5IjozNX0seyJ4Ijo2NTguMDkzNzUsInkiOjM1fSx7IngiOjY4My4wOTM3NSwieSI6MzV9XQ==' data-look='classic' marker-end='url(%23mermaid-6_flowchart-v2-pointEnd)'/><path d='M881.547%2c35L885.714%2c35C889.88%2c35%2c898.214%2c35%2c905.88%2c35C913.547%2c35%2c920.547%2c35%2c924.047%2c35L927.547%2c35' id='mermaid-6-L_D_E_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_D_E_0' data-points='W3sieCI6ODgxLjU0Njg3NSwieSI6MzV9LHsieCI6OTA2LjU0Njg3NSwieSI6MzV9LHsieCI6OTMxLjU0Njg3NSwieSI6MzV9XQ==' data-look='classic' marker-end='url(%23mermaid-6_flowchart-v2-pointEnd)'/><path d='M1094.406%2c35L1098.573%2c35C1102.74%2c35%2c1111.073%2c35%2c1118.74%2c35C1126.406%2c35%2c1133.406%2c35%2c1136.906%2c35L1140.406%2c35' id='mermaid-6-L_E_F_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_E_F_0' data-points='W3sieCI6MTA5NC40MDYyNSwieSI6MzV9LHsieCI6MTExOS40MDYyNSwieSI6MzV9LHsieCI6MTE0NC40MDYyNSwieSI6MzV9XQ==' data-look='classic' marker-end='url(%23mermaid-6_flowchart-v2-pointEnd)'/></g><g class='edgeLabels'><g class='edgeLabel'><g class='label' data-id='L_A_B_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_B_C_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_C_D_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_D_E_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_E_F_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g></g><g class='nodes'><g class='node default' id='mermaid-6-flowchart-A-0' data-look='classic' transform='translate(92.6953125%2c 35)'><rect class='basic label-container' style='' x='-84.6953125' y='-27' width='169.390625' height='54'/><g class='label' style='' transform='translate(-54.6953125%2c -12)'><rect/><foreignObject width='109.390625' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>Pydantic Model</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-6-flowchart-B-1' data-look='classic' transform='translate(312.09375%2c 35)'><rect class='basic label-container' style='' x='-84.703125' y='-27' width='169.40625' height='54'/><g class='label' style='' transform='translate(-54.703125%2c -12)'><rect/><foreignObject width='109.40625' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>Responses API</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-6-flowchart-C-3' data-look='classic' transform='translate(539.9453125%2c 35)'><rect class='basic label-container' style='' x='-93.1484375' y='-27' width='186.296875' height='54'/><g class='label' style='' transform='translate(-63.1484375%2c -12)'><rect/><foreignObject width='126.296875' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>Structured Output</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-6-flowchart-D-5' data-look='classic' transform='translate(782.3203125%2c 35)'><rect class='basic label-container' style='' x='-99.2265625' y='-27' width='198.453125' height='54'/><g class='label' style='' transform='translate(-69.2265625%2c -12)'><rect/><foreignObject width='138.453125' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>Business Validation</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-6-flowchart-E-7' data-look='classic' transform='translate(1012.9765625%2c 35)'><rect class='basic label-container' style='' x='-81.4296875' y='-27' width='162.859375' height='54'/><g class='label' style='' transform='translate(-51.4296875%2c -12)'><rect/><foreignObject width='102.859375' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>Business DTO</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-6-flowchart-F-9' data-look='classic' transform='translate(1198.40625%2c 35)'><rect class='basic label-container' style='' x='-54' y='-27' width='108' height='54'/><g class='label' style='' transform='translate(-24%2c -12)'><rect/><foreignObject width='48' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>业务处理</p></span></div></foreignObject></g></g></g></g></g><defs><filter id='mermaid-6-drop-shadow' height='130%' width='130%'><feDropShadow dx='4' dy='4' stdDeviation='0' flood-opacity='0.06' flood-color='black'/></filter></defs><defs><filter id='mermaid-6-drop-shadow-small' height='150%' width='150%'><feDropShadow dx='2' dy='2' stdDeviation='0' flood-opacity='0.06' flood-color='black'/></filter></defs></svg>)
%3btext-align:center%3b}%23mermaid-dark-6 .edgeLabel p{background-color:hsl(0%2c 0%%2c 34.4117647059%)%3b}%23mermaid-dark-6 .edgeLabel rect{opacity:0.5%3bbackground-color:hsl(0%2c 0%%2c 34.4117647059%)%3bfill:hsl(0%2c 0%%2c 34.4117647059%)%3b}%23mermaid-dark-6 .labelBkg{background-color:rgba(87.75%2c 87.75%2c 87.75%2c 0.5)%3b}%23mermaid-dark-6 .cluster rect{fill:hsl(180%2c 1.5873015873%%2c 28.3529411765%)%3bstroke:rgba(255%2c 255%2c 255%2c 0.25)%3bstroke-width:1px%3b}%23mermaid-dark-6 .cluster text{fill:%23F9FFFE%3b}%23mermaid-dark-6 .cluster span{color:%23F9FFFE%3b}%23mermaid-dark-6 .node .collapsed-indicator{fill:rgba(255%2c 255%2c 255%2c 0.25)%3bstroke:none%3bopacity:0.6%3b}%23mermaid-dark-6 .node .collapsed-separator{stroke:rgba(255%2c 255%2c 255%2c 0.25)%3bstroke-width:0.75px%3b}%23mermaid-dark-6 div.mermaidTooltip{position:absolute%3btext-align:center%3bmax-width:200px%3bpadding:2px%3bfont-family:arial%2csans-serif%3bfont-size:12px%3bbackground:hsl(20%2c 1.5873015873%%2c 12.3529411765%)%3bborder:1px solid rgba(255%2c 255%2c 255%2c 0.25)%3bborder-radius:2px%3bpointer-events:none%3bz-index:100%3b}%23mermaid-dark-6 .flowchartTitleText{text-anchor:middle%3bfont-size:18px%3bfill:%23ccc%3b}%23mermaid-dark-6 rect.text{fill:none%3bstroke-width:0%3b}%23mermaid-dark-6 .icon-shape%2c%23mermaid-dark-6 .image-shape{background-color:hsl(0%2c 0%%2c 34.4117647059%)%3btext-align:center%3b}%23mermaid-dark-6 .icon-shape p%2c%23mermaid-dark-6 .image-shape p{background-color:hsl(0%2c 0%%2c 34.4117647059%)%3bpadding:2px%3b}%23mermaid-dark-6 .icon-shape .label rect%2c%23mermaid-dark-6 .image-shape .label rect{opacity:0.5%3bbackground-color:hsl(0%2c 0%%2c 34.4117647059%)%3bfill:hsl(0%2c 0%%2c 34.4117647059%)%3b}%23mermaid-dark-6 .label-icon{display:inline-block%3bheight:1em%3boverflow:visible%3bvertical-align:-0.125em%3b}%23mermaid-dark-6 .node .label-icon path{fill:currentColor%3bstroke:revert%3bstroke-width:revert%3b}%23mermaid-dark-6 .node .neo-node{stroke:%23ccc%3b}%23mermaid-dark-6 [data-look='neo'].node rect%2c%23mermaid-dark-6 [data-look='neo'].cluster rect%2c%23mermaid-dark-6 [data-look='neo'].node polygon{stroke:url(%23mermaid-dark-6-gradient)%3bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b}%23mermaid-dark-6 [data-look='neo'].swimlane.cluster rect{filter:none%3b}%23mermaid-dark-6 [data-look='neo'].node path{stroke:url(%23mermaid-dark-6-gradient)%3bstroke-width:1px%3b}%23mermaid-dark-6 [data-look='neo'].node .outer-path{filter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b}%23mermaid-dark-6 [data-look='neo'].node .neo-line path{stroke:%23ccc%3bfilter:none%3b}%23mermaid-dark-6 [data-look='neo'].node circle{stroke:url(%23mermaid-dark-6-gradient)%3bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b}%23mermaid-dark-6 [data-look='neo'].node circle .state-start{fill:black%3b}%23mermaid-dark-6 [data-look='neo'].icon-shape .icon{fill:url(%23mermaid-dark-6-gradient)%3bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b}%23mermaid-dark-6 [data-look='neo'].icon-shape .icon-neo path{stroke:url(%23mermaid-dark-6-gradient)%3bfilter:drop-shadow( 1px 2px 2px rgba(185%2c185%2c185%2c1))%3b}%23mermaid-dark-6 :root{--mermaid-font-family:arial%2csans-serif%3b}</style><g><marker id='mermaid-dark-6_flowchart-v2-pointEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'><path d='M 0 0 L 10 5 L 0 10 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-6_flowchart-v2-pointStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='4.5' refY='5' markerUnits='userSpaceOnUse' markerWidth='8' markerHeight='8' orient='auto'><path d='M 0 5 L 10 10 L 10 0 z' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-6_flowchart-v2-pointEnd-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='11.5' refY='7' markerUnits='userSpaceOnUse' markerWidth='10.5' markerHeight='14' orient='auto'><path d='M 0 0 L 11.5 7 L 0 14 z' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-6_flowchart-v2-pointStart-margin' class='marker flowchart-v2' viewBox='0 0 11.5 14' refX='1' refY='7' markerUnits='userSpaceOnUse' markerWidth='11.5' markerHeight='14' orient='auto'><polygon points='0%2c7 11.5%2c14 11.5%2c0' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-6_flowchart-v2-circleEnd' class='marker flowchart-v2' viewBox='0 0 10 10' refX='11' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-6_flowchart-v2-circleStart' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-1' refY='5' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 1%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-6_flowchart-v2-circleEnd-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refY='5' refX='12.25' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-6_flowchart-v2-circleStart-margin' class='marker flowchart-v2' viewBox='0 0 10 10' refX='-2' refY='5' markerUnits='userSpaceOnUse' markerWidth='14' markerHeight='14' orient='auto'><circle cx='5' cy='5' r='5' class='arrowMarkerPath' style='stroke-width: 0%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-6_flowchart-v2-crossEnd' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='12' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><path d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-6_flowchart-v2-crossStart' class='marker cross flowchart-v2' viewBox='0 0 11 11' refX='-1' refY='5.2' markerUnits='userSpaceOnUse' markerWidth='11' markerHeight='11' orient='auto'><path d='M 1%2c1 l 9%2c9 M 10%2c1 l -9%2c9' class='arrowMarkerPath' style='stroke-width: 2%3b stroke-dasharray: 1%2c 0%3b'/></marker><marker id='mermaid-dark-6_flowchart-v2-crossEnd-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='17.7' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'><path d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b'/></marker><marker id='mermaid-dark-6_flowchart-v2-crossStart-margin' class='marker cross flowchart-v2' viewBox='0 0 15 15' refX='-3.5' refY='7.5' markerUnits='userSpaceOnUse' markerWidth='12' markerHeight='12' orient='auto'><path d='M 1%2c1 L 14%2c14 M 1%2c14 L 14%2c1' class='arrowMarkerPath' style='stroke-width: 2.5%3b stroke-dasharray: 1%2c 0%3b'/></marker><g class='root'><g class='clusters'/><g class='edgePaths'><path d='M177.391%2c35L181.557%2c35C185.724%2c35%2c194.057%2c35%2c201.724%2c35C209.391%2c35%2c216.391%2c35%2c219.891%2c35L223.391%2c35' id='mermaid-dark-6-L_A_B_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_A_B_0' data-points='W3sieCI6MTc3LjM5MDYyNSwieSI6MzV9LHsieCI6MjAyLjM5MDYyNSwieSI6MzV9LHsieCI6MjI3LjM5MDYyNSwieSI6MzV9XQ==' data-look='classic' marker-end='url(%23mermaid-dark-6_flowchart-v2-pointEnd)'/><path d='M396.797%2c35L400.964%2c35C405.13%2c35%2c413.464%2c35%2c421.13%2c35C428.797%2c35%2c435.797%2c35%2c439.297%2c35L442.797%2c35' id='mermaid-dark-6-L_B_C_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_B_C_0' data-points='W3sieCI6Mzk2Ljc5Njg3NSwieSI6MzV9LHsieCI6NDIxLjc5Njg3NSwieSI6MzV9LHsieCI6NDQ2Ljc5Njg3NSwieSI6MzV9XQ==' data-look='classic' marker-end='url(%23mermaid-dark-6_flowchart-v2-pointEnd)'/><path d='M633.094%2c35L637.26%2c35C641.427%2c35%2c649.76%2c35%2c657.427%2c35C665.094%2c35%2c672.094%2c35%2c675.594%2c35L679.094%2c35' id='mermaid-dark-6-L_C_D_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_C_D_0' data-points='W3sieCI6NjMzLjA5Mzc1LCJ5IjozNX0seyJ4Ijo2NTguMDkzNzUsInkiOjM1fSx7IngiOjY4My4wOTM3NSwieSI6MzV9XQ==' data-look='classic' marker-end='url(%23mermaid-dark-6_flowchart-v2-pointEnd)'/><path d='M881.547%2c35L885.714%2c35C889.88%2c35%2c898.214%2c35%2c905.88%2c35C913.547%2c35%2c920.547%2c35%2c924.047%2c35L927.547%2c35' id='mermaid-dark-6-L_D_E_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_D_E_0' data-points='W3sieCI6ODgxLjU0Njg3NSwieSI6MzV9LHsieCI6OTA2LjU0Njg3NSwieSI6MzV9LHsieCI6OTMxLjU0Njg3NSwieSI6MzV9XQ==' data-look='classic' marker-end='url(%23mermaid-dark-6_flowchart-v2-pointEnd)'/><path d='M1094.406%2c35L1098.573%2c35C1102.74%2c35%2c1111.073%2c35%2c1118.74%2c35C1126.406%2c35%2c1133.406%2c35%2c1136.906%2c35L1140.406%2c35' id='mermaid-dark-6-L_E_F_0' class='edge-thickness-normal edge-pattern-solid edge-thickness-normal edge-pattern-solid flowchart-link' style='%3b' data-edge='true' data-et='edge' data-id='L_E_F_0' data-points='W3sieCI6MTA5NC40MDYyNSwieSI6MzV9LHsieCI6MTExOS40MDYyNSwieSI6MzV9LHsieCI6MTE0NC40MDYyNSwieSI6MzV9XQ==' data-look='classic' marker-end='url(%23mermaid-dark-6_flowchart-v2-pointEnd)'/></g><g class='edgeLabels'><g class='edgeLabel'><g class='label' data-id='L_A_B_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_B_C_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_C_D_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_D_E_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g><g class='edgeLabel'><g class='label' data-id='L_E_F_0' transform='translate(0%2c 0)'><foreignObject width='0' height='0'><div xmlns='http://www.w3.org/1999/xhtml' class='labelBkg' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='edgeLabel'></span></div></foreignObject></g></g></g><g class='nodes'><g class='node default' id='mermaid-dark-6-flowchart-A-0' data-look='classic' transform='translate(92.6953125%2c 35)'><rect class='basic label-container' style='' x='-84.6953125' y='-27' width='169.390625' height='54'/><g class='label' style='' transform='translate(-54.6953125%2c -12)'><rect/><foreignObject width='109.390625' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>Pydantic Model</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-dark-6-flowchart-B-1' data-look='classic' transform='translate(312.09375%2c 35)'><rect class='basic label-container' style='' x='-84.703125' y='-27' width='169.40625' height='54'/><g class='label' style='' transform='translate(-54.703125%2c -12)'><rect/><foreignObject width='109.40625' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>Responses API</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-dark-6-flowchart-C-3' data-look='classic' transform='translate(539.9453125%2c 35)'><rect class='basic label-container' style='' x='-93.1484375' y='-27' width='186.296875' height='54'/><g class='label' style='' transform='translate(-63.1484375%2c -12)'><rect/><foreignObject width='126.296875' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>Structured Output</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-dark-6-flowchart-D-5' data-look='classic' transform='translate(782.3203125%2c 35)'><rect class='basic label-container' style='' x='-99.2265625' y='-27' width='198.453125' height='54'/><g class='label' style='' transform='translate(-69.2265625%2c -12)'><rect/><foreignObject width='138.453125' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>Business Validation</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-dark-6-flowchart-E-7' data-look='classic' transform='translate(1012.9765625%2c 35)'><rect class='basic label-container' style='' x='-81.4296875' y='-27' width='162.859375' height='54'/><g class='label' style='' transform='translate(-51.4296875%2c -12)'><rect/><foreignObject width='102.859375' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>Business DTO</p></span></div></foreignObject></g></g><g class='node default' id='mermaid-dark-6-flowchart-F-9' data-look='classic' transform='translate(1198.40625%2c 35)'><rect class='basic label-container' style='' x='-54' y='-27' width='108' height='54'/><g class='label' style='' transform='translate(-24%2c -12)'><rect/><foreignObject width='48' height='24'><div xmlns='http://www.w3.org/1999/xhtml' style='display: table-cell%3b white-space: nowrap%3b line-height: 1.5%3b max-width: 200px%3b text-align: center%3b'><span class='nodeLabel'><p>业务处理</p></span></div></foreignObject></g></g></g></g></g><defs><filter id='mermaid-dark-6-drop-shadow' height='130%' width='130%'><feDropShadow dx='4' dy='4' stdDeviation='0' flood-opacity='0.06' flood-color='white'/></filter></defs><defs><filter id='mermaid-dark-6-drop-shadow-small' height='150%' width='150%'><feDropShadow dx='2' dy='2' stdDeviation='0' flood-opacity='0.06' flood-color='white'/></filter></defs><linearGradient id='mermaid-dark-6-gradient' gradientUnits='objectBoundingBox' x1='0%' y1='0%' x2='100%' y2='0%'><stop offset='0%' stop-color='%23cccccc' stop-opacity='1'/><stop offset='100%' stop-color='hsl(180%2c 0%%2c 18.3529411765%)' stop-opacity='1'/></linearGradient></svg>)
其中:
- Pydantic Model 定义字段、类型、枚举和嵌套关系;
- Instructions 定义分类和判断规则;
- Structured Outputs 保证返回结构符合 Schema;
- Business Validation 校验内容是否合理;
- 权限系统决定操作是否允许执行。
Schema 提升的是接口可靠性,并不能保证模型的业务判断永远正确。只有把模型放进传统的软件工程边界中,结构化输出才会真正成为稳定、可维护的系统能力。